

Kini frikë nga operacionet që sjellin buffers…
Në shembullin e një kërkese të vogël do të shqyrtojmë disa qasje universale për optimizimin e kërkesave në PostgreSQL. T’i përdorni apo jo, varet nga ju, por ia vlen t’i njihni.
Në disa versione të mëvonshme të PG, situata mund të ndryshojë me “zgjuarsinë” në rritje të planifikuesit, por për 9.4/9.6 ajo duket afërsisht njësoj si në shembujt këtu.
Do të marr një kërkesë krejt reale:
SELECT
  TRUE
FROM
  "Документ" d
INNER JOIN
  "ДокументРасширение" doc_ex
    USING("@Документ")
INNER JOIN
  "ТипДокумента" t_doc ON
    t_doc."@ТипДокумента" = d."ТипДокумента"
WHERE
  (d."Лицо3" = 19091 or d."Сотрудник" = 19091) AND
  d."$Черновик" IS NULL AND
  d."Удален" IS NOT TRUE AND
  doc_ex."Состояние"[1] IS TRUE AND
  t_doc."ТипДокумента" = 'ПланРабот'
LIMIT 1;
Për emrat e tabelave dhe fushaveMund të kesh qëndrime të ndryshme ndaj emrave “rusë” të fushave dhe tabelave, por kjo është çështje shijeje. Meqë nuk ka zhvillues të huaj, ndërsa PostgreSQL na lejon t’u japim emra qoftë edhe me hieroglife, nëse ato vendosen në thonjëza, ne preferojmë t’i emërtojmë objektet qartë dhe pa mëdyshje, që të mos ketë interpretime të ndryshme.
Le të shohim planin që rezultoi:
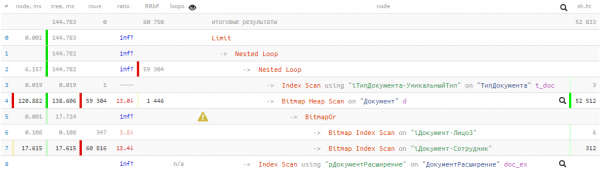
144 ms dhe pothuajse 53K buffers — domethënë më shumë se 400 MB të dhëna! Dhe do të kemi fat nëse të gjitha ndodhen në cache në momentin e kërkesës sonë, përndryshe ajo do të zgjasë disa herë më shumë gjatë leximit nga disku.
Algoritmi është mbi të gjitha!
Për të optimizuar disi çdo kërkesë, së pari duhet të kuptojmë se çfarë duhet të bëjë ajo në të vërtetë.
Le ta lëmë për momentin jashtë kornizës së këtij artikulli projektimin e vetë strukturës së DB-së dhe të biem dakord që ne mundemi relativisht “lirë” të rishkruajmë kërkesën dhe/ose të aplikojmë në bazë disa indekse.
Pra, kërkesa:
— kontrollon ekzistencën e të paktën një dokumenti
— në gjendjen që na duhet dhe të një lloji të caktuar
— ku autori ose ekzekutuesi është punonjësi që na duhet
JOIN + LIMIT 1
Shumë shpesh për zhvilluesin është më e lehtë të shkruajë një kërkesë ku fillimisht bëhet bashkimi i një numri të madh tabelash, e më pas nga i gjithë ky grup mbetet vetëm një rresht i vetëm. Por ajo që është më e thjeshtë për zhvilluesin nuk do të thotë se është më efikase për DB-në.
Në rastin tonë tabelat ishin vetëm 3 — e çfarë efekti…
Le të heqim fillimisht lidhjen me tabelën “ТипДокумента” dhe, njëkohësisht, t’i sugjerojmë bazës se te ne vlera e llojit është unike (ne e dimë këtë, por planifikuesi ende nuk e ka kuptuar):
WITH T AS (
  SELECT
    "@ТипДокумента"
  FROM
    "ТипДокумента"
  WHERE
    "ТипДокумента" = 'ПланРабот'
  LIMIT 1
)
...
WHERE
  d."ТипДокумента" = (TABLE T)
...
Po, nëse tabela/CTE përbëhet nga një fushë e vetme e një regjistrimi të vetëm, atëherë në PG mund të shkruhet edhe kështu, në vend të
d."ТипДокумента" = (SELECT "@ТипДокумента" FROM T LIMIT 1)Llogaritje «dembele» në pyetjet PostgreSQL
BitmapOr kundrejt UNION
Në disa raste, Bitmap Heap Scan mund të na kushtojë shumë shtrenjtë — për shembull, në situatën tonë, kur mjaft regjistrime përmbushin kushtin e kërkuar. E morëm atë për shkak të kushtit OR, i cili u shndërrua në një operacion BitmapOrnë plan.
Le të kthehemi te detyra fillestare — duhet të gjejmë regjistrimin që përputhet me cilindo nga kushtet — pra nuk ka pse të kërkojmë të gjitha 59K regjistrimet sipas të dy kushteve. Ka një mënyrë për të përpunuar një kusht, ndërsa te i dyti të kalojmë vetëm nëse sipas të parit nuk u gjet asgjë. Na ndihmon kjo strukturë:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
LIMIT 1 «i jashtëm» garanton që kërkimi të përfundojë sapo të gjendet regjistrimi i parë. Dhe nëse ai gjendet që në bllokun e parë, blloku i dytë nuk do të ekzekutohet (never executed në plan).
I «fshehim nën CASE» kushtet komplekse
Në pyetjen fillestare ka një pikë shumë të pakëndshme — kontrolli i gjendjes sipas tabelës së lidhur «ДокументРасширение». Pavarësisht vërtetësisë së kushteve të tjera në shprehje (për shembull, d.«Удален» IS NOT TRUE), kjo lidhje kryhet gjithmonë dhe «kushton burime». Sa më shumë apo më pak burime do të shpenzohen varet nga vëllimi i kësaj tabele.
Por pyetja mund të modifikohet në mënyrë që kërkimi i regjistrimit të lidhur të ndodhë vetëm kur kjo është vërtet e nevojshme:
SELECT
  ...
FROM
  "Документ" d
WHERE
  ... /*index cond*/ AND
  CASE
    WHEN "$Черновик" IS NULL AND "Удален" IS NOT TRUE THEN (
      SELECT
        "Состояние"[1] IS TRUE
      FROM
        "ДокументРасширение"
      WHERE
        "@Документ" = d."@Документ"
    )
  END
Meqë nga tabela e lidhur neve nuk na nevojitet asnjë fushë për rezultatin, atëherë kemi mundësinë ta kthejmë JOIN në një kusht me nënpyetje.
Fushat e indeksueshme i lëmë «jashtë» CASE, kushtet e thjeshta nga regjistrimi i vendosim në bllokun WHEN — dhe tani pyetja «e rëndë» ekzekutohet vetëm kur kalohet te THEN.
Mbiemri im është «Përmbledhje»
Le të ndërtojmë pyetjen përfundimtare me të gjithë mekanizmat e përshkruar më sipër:
WITH T AS (
  SELECT
    "@ТипДокумента"
  FROM
    "ТипДокумента"
  WHERE
    "ТипДокумента" = 'ПланРабот'
)
  (
    SELECT
      TRUE
    FROM
      "Документ" d
    WHERE
      ("Лицо3", "ТипДокумента") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Черновик" IS NULL AND "Удален" IS NOT TRUE THEN (
          SELECT
            "Состояние"[1] IS TRUE
          FROM
            "ДокументРасширение"
          WHERE
            "@Документ" = d."@Документ"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Документ" d
    WHERE
      ("ТипДокумента", "Сотрудник") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Черновик" IS NULL AND "Удален" IS NOT TRUE THEN (
          SELECT
            "Состояние"[1] IS TRUE
          FROM
            "ДокументРасширение"
          WHERE
            "@Документ" = d."@Документ"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Po e përshtatim [pod] me indekset
Një sy i stërvitur do të vërë re se kushtet e indeksueshme në nën-blloqet e UNION ndryshojnë paksa — kjo sepse në tabelë tashmë kemi indekse të përshtatshme. Po të mos i kishim, do të vlente t’i krijonim: Документ(Лицо3, ТипДокумента) dhe Документ(ТипДокумента, Сотрудник).
Për renditjen e fushave në kushtet ROWNga këndvështrimi i planifikuesit, sigurisht, mund të shkruhet edhe (A, B) = (constA, constB), dhe (B, A) = (constB, constA). Por kur shkruhet në rendin e ndjekur nga fushat në indeks, një kërkesë e tillë është thjesht më e lehtë për t’u debug-uar më pas.
Çfarë ka në plan?
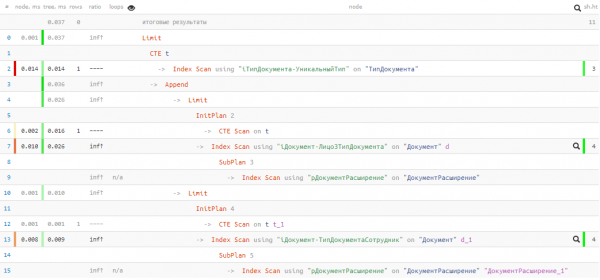
Fatkeqësisht, nuk patëm fat dhe në bllokun e parë të UNION nuk u gjet asgjë, prandaj i dyti gjithsesi u ekzekutua. Por edhe kështu — vetëm 0.037ms dhe 11 buffers!
E përshpejtuam kërkesën dhe ulëm “qarkullimin” e të dhënave në memorie me disa mijëra herë, duke përdorur metoda mjaft të thjeshta — rezultat shumë i mirë për pak copy-paste. 🙂
Burimi: habr.com
