

Ky artikulli është i dyti në temën e kompresionit të shpejtë të të dhënave. Në artikullin e parë u përshkrua një kompresor që punon me shpejtësi 10GB/s për çdo bërthamë procesori (kompresim minimal, RTT-Min).
Ky kompresor është tashmë i implementuar në pajisjet e dubluesve kriminalistikë për kompresionin me shpejtësi të kopjeve të mediave të informacionit dhe përforcimin e qëndrueshmërisë së kriptografisë, gjithashtu ai mund të përdoret për kompresionin e imazheve të makinave virtuale dhe skedarëve swap të memorjes RAM gjatë ruajtjes së tyre në disqe SSD me shpejtësi të lartë.
Në artikullin e parë gjithashtu u njoftua zhvillimi i një algoritmi kompresioni për kompresionin e kopjeve rezervë të HDD dhe SSD (kompresim mesatar, RTT-Mid) me parametra të përmirësuar ndjeshëm për kompresionin e të dhënave. Deri në këtë moment, ky kompresor është plotësisht i gatshëm dhe ky artikull është pikërisht për të.
Kompresori që implementon algoritmin RTT-Mid siguron një shkallë kompresimi krahasuese me arkivuesit standardë si WinRar, 7-Zip, që punojnë në modin e shpejtë. Ndërkohë, shpejtësia e tij është të paktën një rend më e lartë.
Shpejtësia e paketimit/demonstrimit të të dhënave është një parametrik kritik që përcakton fushën e aplikimit të teknologjive të kompresionit. Vështirë se ndokujt do t'i vije në mendje të kompresojë një terabajt të dhënash me shpejtësi 10-15 Megabajt në sekondë (kjo është shpejtësia e arkivuesve në modalitetin standard të kompresionit), sepse do të duhen pothuajse njëzet orë me ngarkesë të plotë të procesorit...
Nga ana tjetër, të njëjtin terabajt mund ta kopjojmë me shpejtësi rreth 2-3 Gigabajt në sekondë për rreth dhjetë minuta.
Prandaj, kompresimi i informacionit me volum të madh është i rëndësishëm nëse realizohet me shpejtësi jo më të ulët se shpejtësia e vërtetë e hyrjes/jeshjes. Për sistemet moderne, kjo është të paktën 100 Megabajt në sekondë.
Këto shpejtësi kompjuterët modernë mund t'i ofrojnë vetëm në modus «fast». Pra, në këtë modus aktual do të bëjmë krahasimin e algoritmit RTT-Mid me arkivuesit tradicionalë.
Testimi krahasues i algoritmit të ri të kompresionit
Kompresori RTT-Mid punoi si pjesë e një programi testimi. Në aplikacionin e vërtetë «të punës» ai punon në mënyrë dukshëm më shpejt, duke shfrytëzuar në mënyrë të përshtatshme shumëputhshmërinë dhe duke përdorur një kompilator «normal», e jo C#.
Duke përdoren kompresorë të ndryshëm në testin e krahasimit dhe lloje të ndryshme të të dhënave kompresohen ndryshe, për objektivitetin e testit u përdor metoda e matjes "temperaturës mesatare në spital"...
U krijua një skedar i dump-it sektor për sektor të diskut logjik me sistemin operativ Windows 10, kjo është përzierja më natyrale e strukturave të ndryshme të të dhënave që ndodhen në çdo kompjuter. Kompresimi i këtij skedari do të lejojë krahasimin e shpejtësisë dhe shkallës së kompresimit të algoritmit të ri me kompresorët më të avancuar të përdorur në arkivatorët modernë.
Ja ky skedar dump-i:
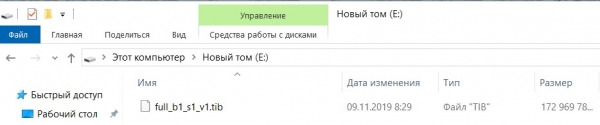
Skedari dump u kompresua me kompresorët RTT-Mid, 7-zip, WinRar. Kompresori WinRar dhe 7-zip u vendosën në shpejtësinë maksimale të punës.
Kompresori po punon 7-zip:
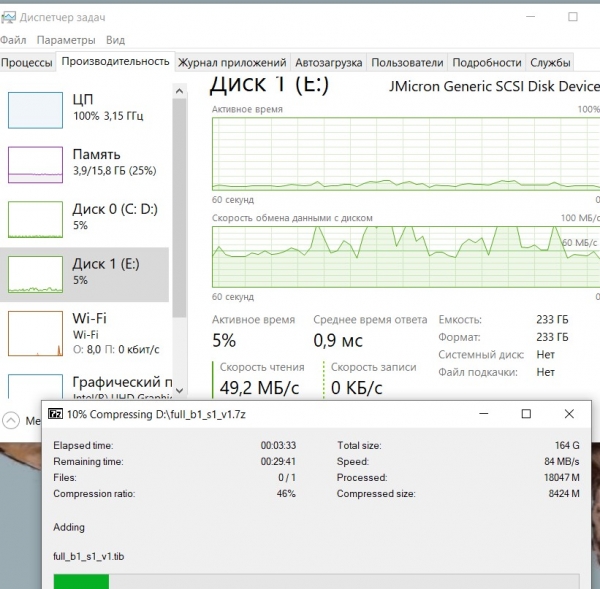
Ai ngarkon procesorin në 100%, ndërkohë që shpejtësia mesatare e leximit të dump-it origjinal është rreth 60 MegaByte/sec.
Kompresori po punon WinRar:
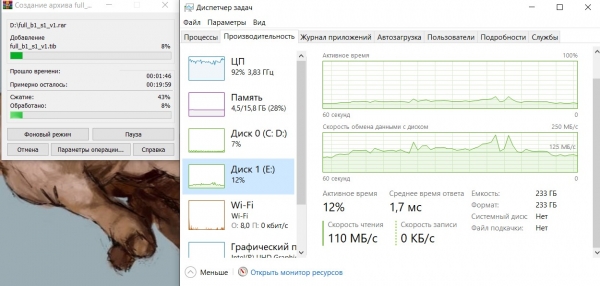
Situata është e ngjashme, ngarkesa e procesorit është praktikisht 100%, shpejtësia mesatare e leximit të dump-it është rreth 125 MegaByte/sec.
Ashtu si në rastin e mëparshëm, shpejtësia e punës së arkivatorit është e kufizuar nga mundësitë e procesorit.
Tani po punon programi testues i kompresorit RTT-Mid:
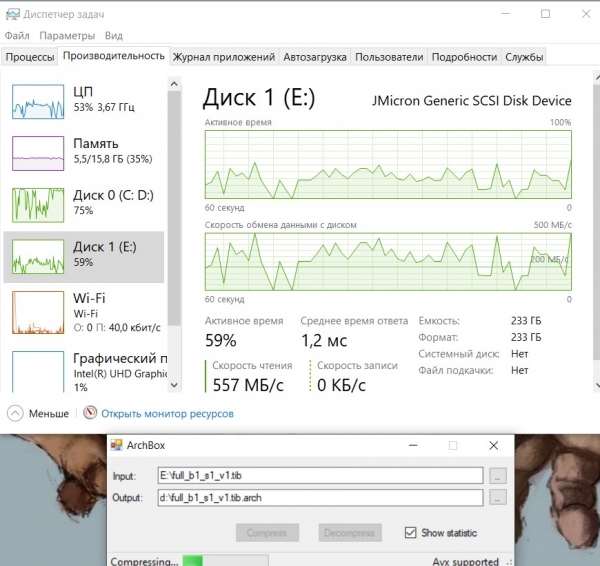
Screenshot-i tregon se procesori është ngarkuar në 50% dhe është i papunë pjesën tjetër të kohës, sepse nuk ka ku të shkarkohen të dhënat e kompresuara. Disku i shkarkimit të të dhënave (Disku 0) është ngarkuar praktikisht plotësisht. Shpejtësia e leximit të të dhënave (Disku 1) hipet ndjeshëm, por mesatarisht më shumë se 200 MegaByte/sec.
Shpejtësia e punës së kompresorit është në këtë rast e kufizuar nga mundësitë e shkarkimit të të dhënave të kompresuara në Diskun 0.
Tani shkalla e kompresimit të arkivave të marra:
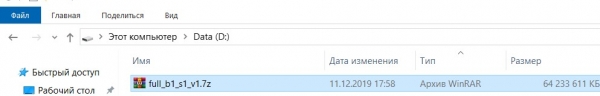
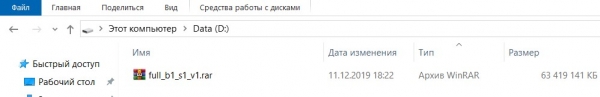
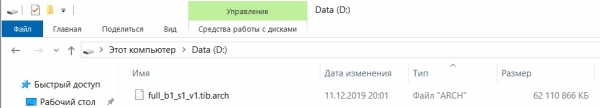
Duket se kompresori RTT-Mid ia doli më mirë se të tjerët në kompresion, arkivi i krijuar prej tij është 1.3 GigaByte më i vogël se arkivi WinRar dhe 2.1 GigaByte më i vogël se arkivi 7z.
Koha e shpenzuar për krijimin e arkivit:
- 7-zip – 26 minuta 10 sekonda;
- WinRar – 17 minuta 40 sekonda;
- RTT-Mid – 7 minuta 30 sekonda.
Pra, madje edhe programi testues, i pa optimizuar, duke përdorur algoritmin RTT-Mid, arriti të krijonte arkivin më shumë se dyfish më shpejt, ndërkohë që arkivi doli të ishte ndjeshëm më i vogël se ai i konkurentëve...
Ata që nuk besojnë screenshot-et, mund të verifikojnë saktësinë e tyre vetë. Programi testues është në dispozicion në , shkarko dhe kontrollo.
Por vetëm në procesorët me mbështetje AVX-2, pa mbështetje për këto instrukcione, kompresori nuk funksionon, dhe mos e testoni algoritmin në procesorët e vjetër AMD, ata janë të ngadalshëm në ekzekutimin e komandave AVX…
Metoda e përdorur për kompresimin
Algoritmi përdor metodën e indeksimit të fragmenteve të përsëritura të tekstit në granularity byte. Kjo metodë kompresimi është e njohur prej kohësh, por nuk është përdorur, pasi operacioni i kërkimit të përputhjeve ishte shumë i shtrenjtë në burime dhe kërkonte më shumë kohë se ndërtimi i një fjalori. Pra, algoritmi RTT-Mid është një shembull klasik i lëvizjes "mbrapa në të ardhmen"…
Në kompresorin RTT përdoret një skaner unik për kërkimin e përputhjeve, i cili lejon të përshpejtojë procesin e kompresimit. Skaneri është prodhim i vetë, është "kënaqësia ime...", "ka një çmim të konsiderueshëm, sepse është krejtësisht i punuar me dorë" (është shkruar në assembler).
Skaneri për kërkimin e përputhjeve është realizuar sipas një skeme probabilistike me dy nivele, fillimisht skanohet prania e "shenjës" së përputhjes, dhe vetëm pas identifikimit të "shenjës" në këtë vend, fillon procedura e zbuluar të përputhjes reale.
Deri në dritaren e kërkimit të përputhjeve ka një madhësi të paparashikueshme, e cila varet nga niveli i entropisë në bllokun e të dhënave që po përpunohet. Për të dhënat krejtësisht të rastësishme (të pa kompresueshme) ajo ka madhësi megabajt, për të dhënat që kanë përsëritje gjithmonë ka një madhësi më të madhe se megabajti.
Por shumë formate moderne të të dhënave janë të pa kompresueshme dhe "të kesh" një skaner të kërkimit të rëndë mbi to është e kotë dhe shpërdoruese, prandaj skaneri përdor dy mënyra funksionimi. Fillimisht kërkohen pjesët e tekstit fillestar me mundësi përsëritjeje, ky operacion kryhet po ashtu me një metodë probabilistike dhe realizohet shumë shpejt (me shpejtësi 4-6 GigaBajt/s). Pastaj, pjesët me mundësi përputhjeje trajtohen nga skaneri kryesor.
Kompresimi indeksor nuk është shumë efikas, duhet të zëvendësohen fragmentet e përsëritura me indekse, dhe matrica indeksore zvogëlon dukshëm koeficientin e kompresimit.
Për të rritur shkallën e kompresimit, indeksohen jo vetëm përputhjet e plota të zinxhirëve të bajtave, por edhe ato të pjesshme, kur në zinxhir ka bajta që përputhen dhe nuk përputhen. Për këtë, në formatin e indeksit është përfshirë një fushë maskë përputhjesh që tregon për bajtat e përputhura të dy blokëve. Për një kompresim edhe më të madh, përdoret indeksimi me mbivendosje të disa bllokëve që përputhen pjesërisht me blokun aktual.
Të gjitha këto lejuan që kompresori RTT-Mid të arrijë një shkallë kompresimi të krahasueshme me kompresorët që funksionojnë me metodën e fjalorit, por që punon shumë më shpejt.
Shkalla e punës së algoritmit të ri të kompresimit
Nëse kompresori punon me përdorim monopol të memorjes cache (për një rrjedhë kërkohet 4 MegaByte), shpejtësia e punës luhatet në диапазонin 700-2000 MegaByte/s në një bërthamë procesori në varësi të llojit të të dhënave që kompresohen dhe pak varion nga frekuenca e punës së procesorit.
Në realizimin shumëfrymor të kompresorit, shkallëzimi efektiv përcaktohet nga vëllimi i memorjes cache të nivelit të tretë. Për shembull, duke pasur «në bord» 9 MegaByte memorje cache, nuk ka kuptim të nisni më shumë se dy rrjedha kompresimi, shpejtësia nuk do të rritet nga kjo. Por me cache prej 20 MegaByte, tashmë mund të nisni pesë rrjedha kompresimi.
Gjithashtu, një parametr tjetër të rëndësishëm që përcakton shpejtësinë e punës së kompresorit është latenca e memorjes operative. Algoritmi përdor kërkesa rastësore për të dhënat, një pjesë e të cilave nuk kapin memorjen cache (rreth 10%) dhe ai duhet të presë për të dhënat nga memorja operative, gjë që zvogëlon shpejtësinë e punës.
Shpejtësinë e kompresorit e ndikon gjithashtu puna e sistemit të hyrjes/daljes së të dhënave. Kërkesat për të dhëna nga hyrja/dalja bllokojnë kërkesat për të dhënat nga CPU, gjë që gjithashtu zvogëlon shpejtësinë e kompresimit. Ky problem është i rëndësishëm për laptopët dhe desktopët, serverësh ai është më pak i rëndësishëm falë një bloku më të avancuar të menaxhimit të aksesit në autobusin sistemor dhe memorjes operative me shumë kanale.
Në të gjithë tekstin e artikullit flitet për kompresimin, dekompresimi mbetet jashtë kësaj artiçtike pasi aty "gjithçka është në rregull". Dekompresimi kryhet ndjeshëm më shpejt dhe kufizohet nga shpejtësia e hyrjes/daljes. Një bërthamë fizike në një rrjedhë lehtë siguron shpejtësi zhbllokimi në nivelin 3-4 Gigabajt/sekund.
Kjo lidhet me mungesën në procesin e zhbllokimit të operacionit të kërkimit të përputhjeve, i cili "han" burimet kryesore të procesorit dhe caches gjatë kompresimit.
Besueshmëria e ruajtjes së të dhënave të kompresuara
Siç nënkuptohet nga emri i gjithë klasës së mjeteve softuerike që përdorin kompresimin e të dhënave (arkivatorët), ato janë të destinuara për ruajtjen e informacionit për një periudhë të gjatë, jo vite, por shekuj e mijëra vjet…
Gjatë ruajtjes, mbajtësit e informacionit humbin një pjesë të të dhënave, ja një shembull:
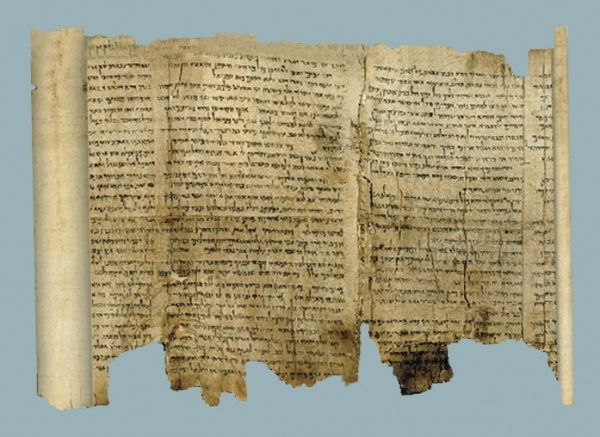
Ky mbajtës informacioni "analogjik" është një mijë vjeçar, disa fragmente janë humbur, por në përgjithësi informacioni është "lexueshëm"...
Asnjë nga prodhuesit përgjegjës të sistemeve moderne të ruajtjes dixhitale dhe mbajtësve dixhitalë të tyre nuk jep garanci për ruajtjen e plotë të të dhënave për më shumë se 75 vjet.
Dhe kjo është një problem, por një problem i shtyrë, për ta zgjidhur do të jenë pasardhësit tanë...
Sistemet e ruajtjes së të dhënave dixhitale mund të humbin të dhëna jo vetëm pas 75 vjetësh, gabimet në të dhëna mund të shfaqen në çdo kohë, madje gjatë regjistrimit të tyre, këto shpërndajje përpiqen t'i minimizojnë duke përdorur tepricën dhe duke korrigjuar përmes sistemeve të korrigjimit të gabimeve. Tepërca dhe sistemet e korrigjimit mund të rikuperojnë informacionin e humbur jo gjithmonë dhe, nëse e bëjnë, nuk ka garanci se operacioni i rikuperimit ka shkuar siç duhet.
Dhe kjo është gjithashtu një problem i madh, por jo i shtyrë, por aktual.
Kompressorët modernë të përdorur për arkivimin e të dhënave dixhitale janë ndërtuar mbi variante të ndryshme të metodës së fjalorit dhe për këto arkiva humbja e një fragmenti të informacionit do të ishte një ngjarje fatale, madje ekziston një term i vendosur për një situatë të tillë - "arkiv i dëmtuar"...
Besnik i ulët i ruajtjes së informacionit në arkivat me kompresim me fjalor është i lidhur me strukturën e të dhënave të kompresuara. Informacioni në një arkiv të tillë nuk përmban tekstin origjinal, aty ruhen numrat e regjistrimeve në fjalor, ndërsa fjalori modifikohet në mënyrë dinamike nga teksti aktual që kompresohet. Në rast humbjeje ose deformimi të një fragmenti të arkivës, të gjitha regjistrimet e ardhshme të arkivës nuk mund të identifikohen as nga përmbajtja, as nga gjatësia e regjistrimit në fjalor, pasi nuk kuptohet se çfarë i korrespondon numri i regjistrimit të fjalorit.
Rikuperimi i informacionit nga një arkiv të tillë "të prishur" është i pamundur.
Algoritmi RTT është ndërtuar mbi një metodë më të besueshme për ruajtjen e të dhënave të kompresuara. Në të përdoret një metodë indekse për mbajtjen e fragmenteve të përsëritura. Ky qasje ndaj kompresimit lejon minimizimin e pasojave të deformimit të informacionit në mbajtës, dhe në shumë raste korrigjon automatikisht deformimet që kanë lindur gjatë ruajtjes së informacionit.
Kjo lidhet me faktin se një skedar arkivor në rastin e kompresimit me indekse përmban dy fusha:
- fusha e tekstit origjinal me pjesët e përsëritura të fshira nga ai;
- fusha e indekseve.
Fusha e indekseve, e cila është kritikisht e rëndësishme për rikuperimin e informacionit, nuk është e madhe dhe mund të dyfishohet për besueshmërinë e ruajtjes së të dhënave. Prandaj, edhe nëse humbet një fragment i tekstit origjinal ose i matrit, gjithë informacioni tjetër do të rikuperohet pa probleme, si në imazhin me një mbajtës "analog" të informacionit.
Disavantazhet e algoritmit
Asnjë virtyt nuk vjen pa disavantazhe. Metoda e indekseve të kompresimit nuk kompreson sekuenca përsëritëse të gjatë të vogël. Kjo lidhet me kufizimet e metodës së indekseve. Indekset kanë një madhësi prej të paktën 3 byte dhe mund të jenë deri në 12 byte. Nëse ndodh një përsëritje me një madhësi më të vogël se ajo që përshkruan indeksi, atëherë ajo nuk merret parasysh, pavarësisht sa shpesh këto përsëritje identifikohen në skedarin që kompresohet.
Metoda tradicionale e kompresionit, e cila përdor fjalor, kompreson efektivisht përsëritjet e shkurtra dhe për këtë arin një koeficient më të lartë kompresimi sesa kompresimi indeksohet. Megjithatë, kjo arrihet në kurriz të ngarkesës së lartë të procesorit qendror, për të filluar të kompresojë të dhënat më efektivisht se metoda indeksuese, metoda fjalor duhet të reduktojë shpejtësinë e përpunimit të të dhënave deri në 10-20 megabajt për sekondë në instalime reale të llogaritjes kur CPU është plotësisht i ngarkuar.
Këto shpejtësi të ulëta janë të papranueshme për sistemet moderne të ruajtjes së të dhënave dhe përfaqësojnë më shumë një interes «akademik» sesa praktik.
Shkalla e kompresionit të informacionit do të rritet ndjeshëm në modifikimin e ardhshëm të algoritmit RTT (RTT-Max), i cili është në zhvillim.
Pra, si gjithmonë, vazhdimi vijon...
Burimi: habr.com
