

Përshëndetje, habrovcanë. Sot fillojnë mësimet në grupin e parë të kursit . Për këtë arsye, duam të flasim me ju për webinarin e hapur që u mbajt për këtë kurs.
Në diskutuar për sfidat që kanë hasur bazat e të dhënave SQL në epokën e cloud dhe Kubernetes. Po ashtu, shqyrtuam si bazat e të dhënave SQL përshtaten dhe transformohen nën ndikimin e këtyre sfidave.
Webinari u drejtua nga , Menaxher i Praktikës së Dërgimit Cloud në EPAM Systems.
Kur pemët ishin të vogla...
Së pari, le të kujtojmë se si filloi zgjedhja e DBMS në fund të shekullit të kaluar. Megjithatë, kjo nuk do të jetë e vështirë, sepse zgjedhja e DBMS në atë kohë fillonte dhe përfundonte Oracle.
Në fund të viteve '90 - fillimi të viteve 2000, nuk kishte shumë zgjedhje, në thelb, për sa i përket DB të shkallëzueshme industriale. Po, ekzistonin IBM DB2, Sybase dhe disa baza të tjera të dhënash që shfaqeshin dhe zhdukeshin, por në tërësi ato nuk ishin aq të dukshme përballë Oracle. Si rezultat, aftësitë e inxhinierëve të asaj kohe ishin në një farë forme të lidhura me atë zgjedhje të vetme që ekzistonte.
Dhe një Oracle DBA duhet të dinte se si:
- të instalonte Oracle Server nga distribuimi;
- të konfiguronte Oracle Server:
- init.ora;
- listener.ora;
të krijonte:
- hapësira tabelash;
- skemat;
- përdoruesit;
të kryente kopje rezervë dhe rikuperim;
të bënte monitorim;
të luftonte me kërkesat jo optimale.
Në këtë mënyrë, nga Oracle DBA nuk kërkohej shumë:
- të dinte të zgjidhte DBMS-in optimal ose një teknologji tjetër për ruajtjen dhe përpunimin e të dhënave;
- të sigurojë disponueshmërinë e lartë dhe shkallëzimin horizontal (kjo nuk ishte gjithmonë një çështje për DBA);
- të njihte mirë fushën përkatëse, infrastrukturën, arkitekturën aplikative, sistemin operativ;
- të realizonte ngarkimin dhe shkarkimin e të dhënave, migrimin e të dhënave midis DB të ndryshme.
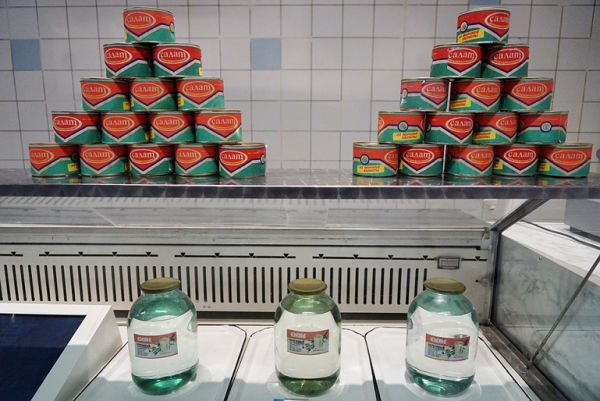
Në tërësi, kur flasim për zgjedhjen në atë kohë, ajo përngjason me zgjedhjen në një dyqan sovjetik në fund të viteve '80:
Koha jonë
Që nga atëherë, sigurisht, pemët janë rritur, bota ka ndryshuar, dhe gjërat janë bërë siç janë:
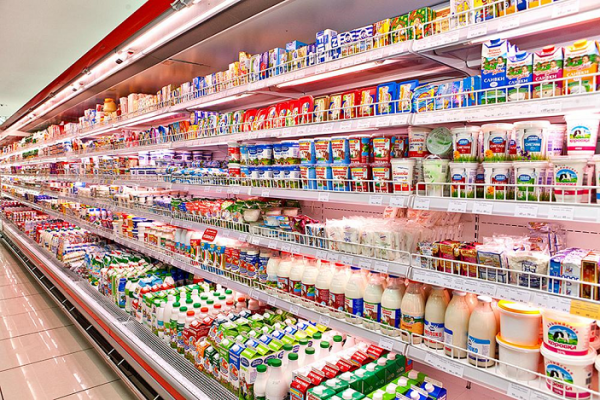
Tregu i DBMS është ndryshuar gjithashtu, gjë që është shumë e dukshme nga raporti i fundit i kompanisë Gartner:
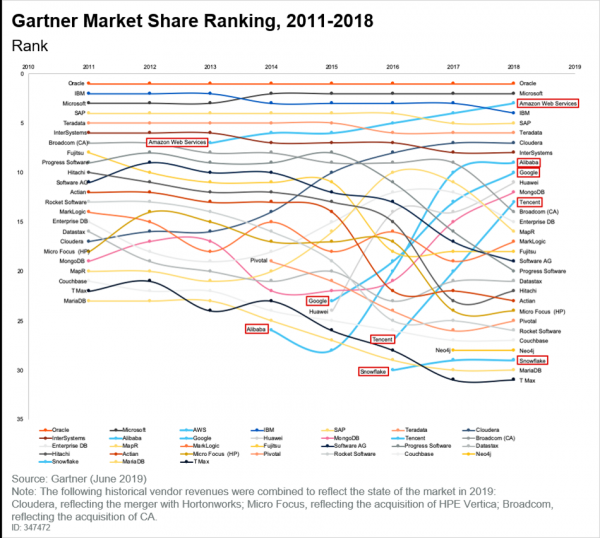
Dhe këtu nuk mund të mos përmendet se një nişë e re është zënë nga cloud, të cilat po rriten në popullaritet. Nëse e lexoni të njëjtin raport të kompanisë Gartner, do të shihni këto përfundime:
- Shumë klientë janë në rrugën për të transferuar aplikacionet në cloud.
- Teknologjitë e reja shfaqen së pari në cloud dhe nuk është e sigurt se ato ndonjëherë do të kalojnë në një infrastrukturë jo-cloud.
- Modeli i çmimit sipas parimit pay-as-you-go është bërë i zakonshëm. Të gjithë dëshirojnë të paguajnë vetëm për atë që përdorin, dhe kjo tashmë nuk është vetëm një trend, por një konstatim i faktit.
Çfarë ndodhi tani?
Sot të gjithë jemi në cloud. Dhe pyetjet që kemi janë pyetje zgjedhjeje. Dhe ajo zgjedhje është e madhe, edhe nëse flasim vetëm për zgjedhjen e teknologjive DBMS në formatin On-premises. Po ashtu kemi shërbime të menaxhuara dhe SaaS. Kështu, zgjedhja vetëm sa komplikohet çdo vit.
Përveç pyetjeve të zgjedhjes, veprojnë gjithashtu faktorët kufizues:
- çmimi. Shumë teknologji ende kushtojnë para;
- aftësitë. Nëse flasim për softuerin e lirë, atëherë lind pyetja e aftësive, pasi softueri falas kërkon nga njerëzit, që e implementojnë dhe e përdorin, kompetencë të mjaftueshme;
- funksionaliteti. Jo të gjitha shërbimet që janë në cloud dhe janë ndërtuar, le të themi, edhe mbi bazën e Postgres, kanë ato karakteristika që ka Postgres On-premises. Ky është një faktor thelbësor që duhet të dihet dhe kuptohet. Për më tepër, ky faktor merr një rëndësi edhe më të madhe se njohuria e ndonjë mundësie të fshehtë të një DBMS të veçantë.
Çfarë presin tani nga DA/DE:
- një kuptim të mirë të fushës dhe arkitekturës aplikative;
- aftësinë për të zgjedhur teknologjinë e përshtatshme DBMS duke marrë parasysh detyrën e vendosur;
- aftësinë për të zgjedhur metodën optimale të implementimit të teknologjisë së zgjedhur në kontekstin e kufizimeve të disponueshme;
- aftësinë për të realizuar transferimin dhe migrimin e të dhënave;
- aftësinë për të implementuar dhe përdorur zgjidhjet e zgjedhura.
Shembulli në vijim në GCP demonstron se si ndodh zgjedhja e teknologjisë së punës me të dhëna në varësi të strukturës së tyre:
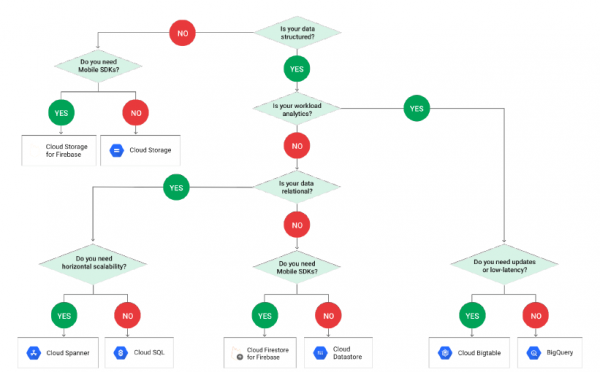
Vini re se në skemë mungon PostgreSQL, dhe kjo është për shkak se ai fshihet pas terminologjisë Cloud SQL. Dhe kur hyjmë në Cloud SQL, na nevojitet përsëri të bëjmë zgjedhje:
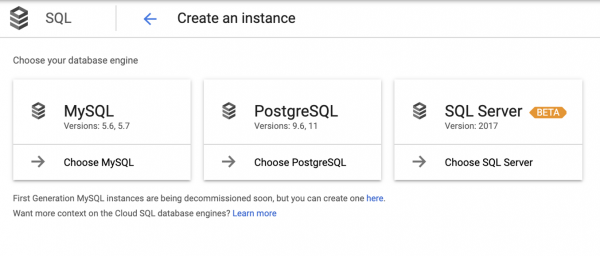
Duhet të theksohet se kjo zgjedhje nuk është gjithmonë e kuptueshme, prandaj zhvilluesit e aplikacioneve shpesh udhëhiqen nga intuicioni.
Pra, në përfundim:
- Sa më shumë që kalon koha, bëhet më aktual çështja e zgjedhjes. Edhe nëse shohim vetëm GCP, shërbimet e menaxhuara dhe SaaS, ndonjë përmendje e RDBMS shfaqet vetëm në hapin e katërt (dhe aty është Spanner pranë). Përveç kësaj, zgjedhja e PostgreSQL shfaqet gjithashtu vetëm në hapin e pestë, ku përmenden edhe MySQL dhe SQL Server, domethënë ka shumë mundësi, por duhet të zgjedhim.
- Nuk duhet harruar as kufizimet përballë joshjeve. Kryesisht, të gjithë duan Spanner, por ai është i shtrenjtë. Si rezultat, një kërkesë tipike duket kështu: «Na bëni, ju lutem, Spanner por me çmimin e Cloud SQL, ju jeni profesionistë!》
Çfarë duhet bërë?
Pa pretenduar të jem i fundit në autoritet, le të themi këto:
Duhet të ndryshojmë qasjen në mësim:
- të mësosh si mësuan më parë DBA, nuk ka kuptim;
- njohuritë për një produkt tani janë të pamjaftueshme;
- dhe të njohësh dhjetëra në nivelin e njërit — është e pamundur.
Duhet të dish jo vetëm se çfarë është produkti, por:
- rastin e përdorimit të tij;
- metoda të ndryshme të implementimit;
- avantazhet dhe disavantazhet e çdo metode;
- produkte të ngjashme dhe alternativë, për të bërë një zgjedhje të qartë dhe optimale dhe jo gjithmonë në favor të produktit të njohur.
Dhe gjithashtu duhet të dish si të migrosh të dhënat dhe të kuptosh parimet e bazës së integrimit me ETL.
Rasti real
Në të kaluarën e afërt, ishte e nevojshme të krijohej një backend për një aplikacion mobil. Në momentin që filluam punën mbi të, backend-i tashmë ishte zhvilluar dhe i gatshëm për implementim, dhe ekipi i zhvilluesve kishte shpenzuar rreth dy vjet në këtë projekt. Ndërkohë, ishin vendosur këto detyra:
- të ndërtosh CI/CD;
- të bësh një rishikim të arkitekturës;
- të nisësh gjithçka në përdorim.
Aplikacioni ishte mikro-shërbim, dhe kodi në Python/Django ishte zhvilluar nga zero dhe menjëherë në GCP. Sa i përket audiencës, supozohej se do të ishin dy rajone — SHBA dhe BE, dhe trafiku shpërndaheshin përmes Global Load balancer. Të gjitha Workloads dhe ngarkesa llogaritëse punonin në Google Kubernetes Engine.
Sa i përket të dhënave, ishin 3 struktura:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
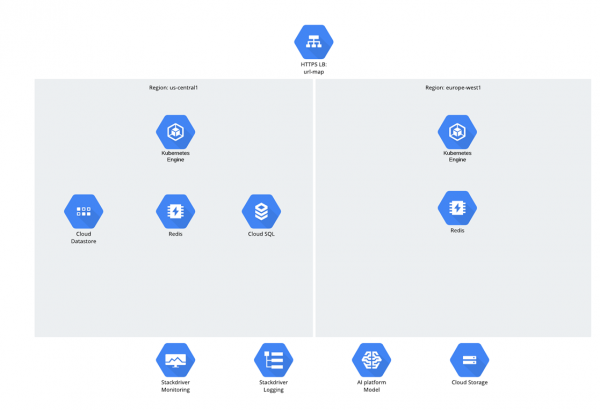
Mund të lindë pyetja, pse u zgjodh Cloud SQL? Duke folur me të vërtetë, një pyetje e tillë nënkupton një pauzë të pakëndshme — krijohet një ndjesi se njerëzit filluan të ndihen të turpëruar për bazat e të dhënave relacional, por megjithatë ata vazhdojnë t'i përdorin aktivisht ;-).
Sa i përket rastit tonë, Cloud SQL u zgjodh për këto arsye:
- Si e përmendur, aplikacioni u zhvillua me Django, dhe ai ka një model që shfaq të dhënat e qëndrueshme nga baza e të dhënave SQL në objekte Python (Django ORM).
- Korniza mbështeste një listë të përfunduar të DBMS-ve:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Përkatësisht, PostgreSQL u zgjodh nga ky listë më shumë intuitivisht (nuk është si të zgjidhje Oracle, vallë).
Çfarë mungonte:
- aplikacioni ishte zbatuar vetëm në 2 rajone, dhe tani kishte një plan për një të tretë (Azinë);
- DB u ndodhte në rajonin e Amerikës Veriore (Iowa);
- nga ana e klientit kishte shqetësime lidhur me vonesat në akses nga Evropa dhe Azia dhe ndërprerjet në shërbim në rast të papërputhjes së DB.
Megjithëse Django vetë mund të punojë me disa DB paralelisht dhe t'i ndajë ato sipas leximit dhe shkrimit, shkrimet në aplikacion nuk ishin aq të shumta (më shumë se 90% — lexim). Dhe në përgjithësi, nëse ishte e mundur të bëhej një read-replica e bazës kryesore në Evropë dhe Azi, do të ishte një mundësi kompromisi për zgjidhje. Por çfarë ka kaq të komplikuar këtu?
Komplikimi ishte se klienti nuk dëshironte të hiqte dorë nga shërbimet e menaxhuara dhe Cloud SQL. Dhe mundësitë e Cloud SQL në atë moment ishin të kufizuara. Cloud SQL mbështet Disponueshmëri të Lartë (HA) dhe Read Replica (RR), por e njëjta RR mbështetet vetëm në një rajon. Duke krijuar një DB në rajonin amerikan, nuk është e mundur të bësh një read-replica në rajonin evropian me mjetet e Cloud SQL, megjithëse PostgreSQL vetë nuk e pengon këtë. Korrespondenca me punonjësit e Google nuk çoi në asgjë dhe përfundoi me premtime në stilin "ne e dimë problemin dhe po punojmë mbi të, një ditë do të zgjidhet."
Nëse i rendisim mundësitë e Cloud SQL në pikë, do të duket më në këtë mënyrë:
1. Disponueshmëri e Lartë (HA):
- në kuadër të një rajoni;
- nëpërmjet riprodhimit të diskut;
- nuk përdoren mekanizmat PostgreSQL;
- mundësi për menaxhim automatik dhe manual — failover/failback;
- në kalimin e DB, nuk është e disponueshme për disa minuta.
2. Read Replica (RR):
- në kuadër të një rajoni;
- hot standby;
- riprodhimi streaming i PostgreSQL.
Më tej, siç është zakonshme, kur zgjidhni një teknologji gjithmonë përballeni me ndonjë kufizime:
- klienti nuk dëshironte të krijonte entitete dhe të përdorte IaaS, përveç nëpërmjet GKE;
- klienti nuk dëshironte të zbuste një self service PostgreSQL/MySQL;
- Të paktën, Google Spanner do të ishte një zgjidhje e mirë, po sikur të mos ishte çmimi i tij. Megjithatë, Django ORM nuk mund të punojë me të, por është një gjë e mirë.
Duke marrë parasysh situatën, nga klienti erdhi një pyetje për të vështirë: «A mund të bëni diçka të ngjashme që të jetë si Google Spanner, por të funksionojë edhe me Django ORM?»
Zgjidhja e mundshme № 0
E para që më erdhi në mendje ishte:
- të mbeteshim brenda CloudSQL;
- nuk do të ketë replikim të integruar midis rajoneve në asnjë formë;
- të përpiqemi të lidhnim një replikë me Cloud SQL ekzistues nga PostgreSQL;
- të nisnim një instancë PostgreSQL diku dhe siç duhet, por të mos e prekim master-in.
Për fat të keq, doli që nuk mund ta bënim këtë, pasi nuk kishte akses në host (ai ishte në një projekt tjetër) – pg_hba dhe kështu me radhë, dhe gjithashtu nuk kishte akses si superuser.
Zgjidhja e mundshme № 1
Pas më shumë reflektimesh dhe duke marrë parasysh rrethanat e mëparshme, mendimi ynë ndërrua pak:
- ende përpiqemi të mbetemi brenda CloudSQL, por kalojmë në MySQL, pasi Cloud SQL nga MySQL ka një master të jashtëm, i cili:
– shërben si proxy për MySQL-in e jashtëm;
– duket si një instancë MySQL;
– është krijuar për migrimin e të dhënave nga re të tjera ose On-premises.
Duke qenë se konfigurimi i replikimit të MySQL nuk kërkon qasje në host, në parim gjithçka funksiononte, por shumë në mënyrë të paqëndrueshme dhe të pak rahat. Dhe kur shkuam më tutje, gjithçka u bë akoma më e frikshme, pasi ne po zhvillonim të gjithë strukturën me terraform, dhe është ndjerë se master i jashtëm nuk mbështetet nga terraform. Po, Google ka CLI, por për një arsye tjetër gjithçka punonte në rast se, ndonjëherë krijohet, ndonjëherë jo. Ndoshta sepse CLI është menduar për migrimin e të dhënave nga jashtë, e jo për replikat.
Në fakt, këtu u bë e qartë se Cloud SQL nuk është aspak i përshtatshëm. Siç thonë, bëmë gjithçka që mundëm.
Zgjidhja e mundshme № 2
Duke qenë se nuk arritëm të mbetemi brenda Cloud SQL, përpiqem të formuloj kërkesat për një zgjidhje kompromisi. Kërkesat janë si më poshtë:
- punimi në Kubernetes, përdorimi maksimal i burimeve dhe mundësive të Kubernetes (DCS,…) dhe GCP (LB,…);
- mungesa e një bari nga shumë gjëra të panevojshme në re si HA proxy;
- mundësia për të nisur një HA PostgreSQL ose MySQL në rajonin kryesor; në rajonet e tjera – një HA nga RR i rajonit kryesor plus kopjen e saj (për besueshmëri);
- multi master (nuk do të doja të lidhesha me të, por nuk ishte shumë thelbësore)
.
Si rezultat i këtyre kërkesave, në horizont më në fund u shfaq njëmundësi të përshtatshme për DBMS dhe lidhjen e saj:
- MySQL Galera;
- CockroachDB;
- mjetet PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
Teknologjia MySQL Galera është zhvilluar nga kompania Codership dhe është një plugin për InnoDB. Karakteristikat:
- multi master;
- repikim sinkron;
- lexim nga çdo nyje;
- shkrim në çdo nyje;
- mekanizëm të integruar HA;
- ka Helm chart nga Bitnami.
CockroachDB
Sipas përshkrimit, kjo është diçka për t'u habitur dhe përfaqëson një projekt open source, e shkruar në Go. Pjesëmarrësi kryesor — Cockroach Labs (të themeluar nga ish-punonjës të Google). Ky DBMS relational është krijuar për t'u shpërndarë (me shkallëzim horizontal "nga kutia") dhe për të qenë rezistent ndaj dështimeve. Autorët e saj nga kompania kanë përcaktuar qëllimin "të kombinojnë pasurinë e funksionalitetit SQL me disponueshmërinë horizontale, të zakonshme për zgjidhjet NoSQL."
Si një bonus i këndshëm — mbështetje për protokollin e lidhjes PostgreSQL.
Pgpool
Ky është një shtresë mbi PostgreSQL, në të vërtetë, një entitet i ri që merr të gjitha lidhjet dhe i proceson ato. Ka një balancues ngarkese dhe analist të vetin, dhe licencohet nën licencën BSD. Oferon mundësi të gjera, por duket disi frikësuese, pasi prania e një entiteti të ri mund të shkaktojë disa aventura të tjera.
Patroni
Ky ishte i fundit në të cilin u përqendrua shikimi dhe, siç u duk, jo pa arsye. Patroni — një utilitar open source, që në thelb është një daemon në Python, i cili lejon menaxhimin automatik të grupeve PostgreSQL me lloje të ndryshme replikimi dhe kalimin automatik të roleve. Kjo rezultoi shumë interesante, pasi integron mirë me Kubernetes dhe nuk sjell asnjë entitet të ri.
Çfarë u zgjodh në fund
Zgjedhja ishte e vështirë:
- CockroachDB — zjarr, por i rrezikshëm;
- MySQL Galera — gjithashtu e mirë, përdoret në shumë vende, por MySQL;
- Pgpool — shumë entitete të tepërta, integrimi me re dhe K8s është i dobët;
- Patroni — integrim të shkëlqyer me K8s, pa entitete të tepërta, integrohet mirë me GCP LB.
Pra, zgjedhja ra mbi Patroni.
Përfundimet
Ka ardhur koha për të përmbledhur përfundimet. Po, bota e infrastrukturës IT ka ndryshuar ndjeshëm, dhe kjo është vetëm fillimi. Dhe nëse më parë re siç ishin vetëm një lloj tjetër infrastrukture, tani gjërat janë ndryshe. Jo vetëm kaq, inovacionet në re po shfaqen vazhdimisht, do të vazhdojnë të shfaqen dhe, ndoshta, do të shfaqen vetëm në re dhe më pas, nga startup-et, do të transferohen në On-premises.
Sa SQL, SQL do të vazhdojë të jetë një e përhershme. Kjo do të thotë se duhet të njihni PostgreSQL dhe MySQL dhe të jeni në gjendje t'i përdorni ato, por është edhe më e rëndësishme të dini si t'i aplikoni ato saktë.
Burimi: habr.com
