

Vazhdojmë serinë e artikujve, që i kushtohen hulumtimit të mënyrave të panjohura për të përmirësuar performancën e kërkesave "të dukshëm të thjeshta" në PostgreSQL:
Mos mendoni se nuk e dua kaq shumë JOIN… 🙂
Por shpesh herë, pa të, kërkesa rezulton ndjeshëm më e shpejtë sesa me të. Prandaj sot do të provojmë të heqim krejtësisht JOIN-in burimor — me ndihmën e fjalorit.
Duke filluar nga PostgreSQL 12, disa nga situatat e përshkruara më poshtë mund të përsëriten nd sedikit ndryshe për shkak të . Ky sjellje mund të kthehet në të kaluarën duke përcaktuar çelësin
MATERIALIZED.
Shumë "fakte" mbi fjalorin e kufizuar
Le të marrim një detyrë shumë reale - duhet të nxjerrim një listë ose detyrave aktive me dërguesit:
25.01 | Ivanov I.I. | Përgatit një përshkrim të algoritmit të ri.
22.01 | Ivanov I.I. | Shkruaj një artikull në Habr: jeta pa JOIN.
20.01 | Petrov P.P. | Ndihmo në optimizimin e kërkesës.
18.01 | Ivanov I.I. | Shkruaj një artikull në Habr: JOIN me llogaritjen e shpërndarjes së të dhënave.
16.01 | Petrov P.P. | Ndihmo në optimizimin e kërkesës.
Në një botë abstrakte, autorët e detyrave do të duhet të shpërndaheshin në mënyrë të barabartë mes të gjithë punonjësve tanë, por në realitet detyrat vijnë, zakonisht, nga një numër mjaft të kufizuar njerëzish — "nga menaxhimi" lart në hierarki ose "nga bashkëpunëtorët" nga departamentet përkatëse (analistët, dizajnerët, marketingu, ...).
Le të pranojmë se në organizatën tonë, nga 1000 persona, vetëm 20 autorë (zakonisht edhe më pak) i vendosin detyrat për çdo ekzekutor të veçantë dhe , për të përshpejtuar kërkesën "tradicionale".
Skripti-gjenerator
-- punonjësit
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- detyrat me shpërndarje të specifikuar
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Do të tregojmë 100 detyrat e fundit për një ekzekutor të caktuar:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 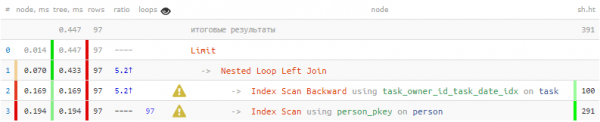
Kështu që 1/3 e gjithë kohës dhe 3/4 e leximeve të dhënat e faqeve janë bërë vetëm për të kërkuar autorin 100 herë — për çdo detyrë të shfaqur. Por ne e dimë se nga kjo qind ka vetëm 20 të ndryshëm — a mund të përdorim këtë njohuri?
fjalori hstore
Le të përdorim për të gjeneruar "fjalorin" çelës-vlerë:
CREATE EXTENSION hstoreNë fjalor mjafton të vendosim ID-në e autorit dhe emrin e tij, kështu që më pas të mund të nxjerrim sipas këtij çelësi:
-- formojmë zgjedhjen e synuar
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- formojmë fjalorin për vlerat unike
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- marrim vlerat e lidhura të fjalorit
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> çelës
FROM
T; 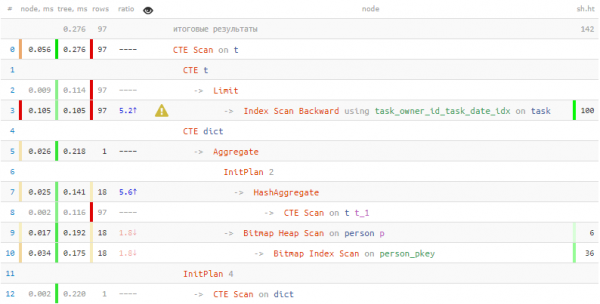
Për të marrë informacion në lidhje me personat ë shpenzuar në 2 herë më pak kohë dhe 7 herë më pak të dhëna të lexuara! Përveç "shkollimit", këto rezultate na ndihmuan t'i arrijmë gjithashtu nxjerrjen masive të regjistrimeve nga tabela në një kalim të vetëm duke përdorur = ANY(ARRAY(...)).
Regjistrimet e tabelës: serializimi dhe deserializimi
Por çfarë të bëjmë, nëse na nevojitet të ruajmë në fjalor jo një fushë tekstuale, por një regjistrim të plotë? Në këtë rast, na ndihmon aftësia e PostgreSQL për të punuar me regjistrimin e tabelës si një vlerë unike:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magia #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magia #2
FROM
  T;
Le të shqyrtojmë çfarë ndodhi këtu:
- Ne morëm p si alias për regjistrimin e plotë të tabelës person dhe i grumbulluam ato në një array.
- Ky kjo array regjistrimesh u transformua në një array me vargje tekstual (person[]::text[]), për ta vendosur në një fjalor hstore si një array vlerash.
- Kur marim regjistrimin e lidhur, ne e nxorëm atë nga fjalori me çelës si një varg tekstual.
- Tekstin ne duhet ta kthejmë në një vlerë të tipit tabelë person (për çdo tabelë krijohet automatikisht një tip i emërtuar njësoj).
- Kemi "shtruar" regjistrimin e tipizuar në kolona me ndihmën e
(...).*.
fjalorit json.
Por një truk si ai që aplikuam më sipër, nuk do të funksionojë, nëse nuk ka një tip tabelar të përshtatshëm për të bërë 'transformimin'. Një situatë e ngjashme do të ndodhë, edhe nëse për burim të dhënash për serializimin përpiqemi të përdorim një string CTE, dhe jo një tabelë "të vërtetë"..
Në këtë rast do na ndihmojnë :
...
, p AS ( -- kjo është tani CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- tani është tani json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- dhe brenda json për çdo rresht
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) -–> author_id::text)::json -- e nxorrëm nga fjalori si json
      ) AS j(name text, birth_date date) -- populluam strukturën që na nevojitej
  ) j;
Duhet theksuar se kur përshkruajmë strukturën e synuar mund të përmendim jo të gjithë fushat e rreshtit origjinal, vetëm ato që na nevojiten vërtet. Nëse kemi një tabelë "të natyrshme", atëherë është më mirë të përdorim funksionin json_populate_record..
Qaccessi në fjalor ndodh ende njëherë, por kostot për json-[de]serializim janë mjaft të mëdha,prandaj një mënyrë e tillë është e arsyeshme të përdoret vetëm në disa raste, kur skanimi "i sinqertë" CTE tregon vetveten më të dobët.
Testojmë performancën.
Kështu që, ne kemi dy mënyra për të serializuar të dhënat në fjalor — hstore / json_object.Përveç kësaj, vetë array-t e çelësave dhe vlerave mund të prodhohen gjithashtu në dy mënyra, me transformim të brendshëm ose të jashtëm në tekst: array_agg(i::text) / array_agg(i)::text[]..
Le të kontrollojmë efikasitetin e llojeve të ndryshme të serializimit në një shembull të pastër sintetik — serializojmë një numër të ndryshëm çelesh.:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Skema e vlerësimit: serializimi.
ME T SI AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 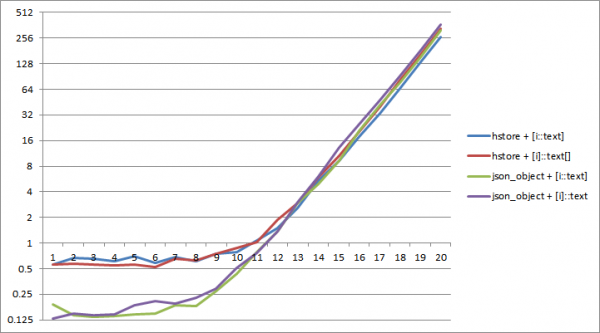
Në PostgreSQL 11, deri në madhësinë e fjalorit prej 2^12 çelesh. serializimi në json kërkon më pak kohë.. Në këtë rast, kombinimi më efikas është json_object dhe konvertimi "i brendshëm" i llojeve. array_agg(i::text).
Tani le të provojmë të lexojmë vlerën e çdo çelësi 8 herë — sepse nëse nuk i qasje fjalorit, përse është ai i nevojshëm?
Skripti vlerësues: leximi nga fjalori.
ME T SI AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              ME T SI FJALOR AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 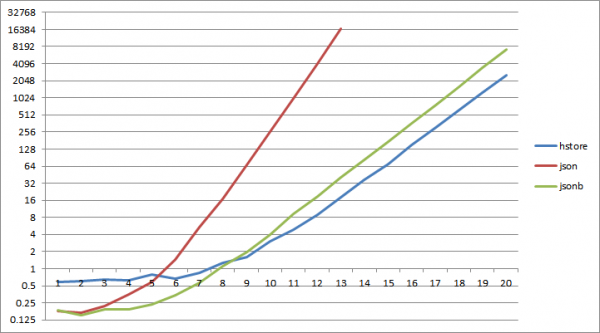
Dhe… tashmë rreth në 2^6 çelësa leximi nga json-fjalori fillon të humbasë ndjeshëm. leximit nga hstore, për jsonb të njëjtën gjë ndodh në 2^9.
Përfundimet përfundimtare:
- nëse nevojitet JOIN me shënime të shumta të përsëritura — është më mirë të përdorim "fjalorizimin" e tabelës.
- nëse fjalori juaj është parashikueshëm i vogël dhe do të lexoni pak prej tij — mund të përdorni json[b].
- në të gjitha rastet e tjera hstore + array_agg(i::text) do të jetë më efikase.
Burimi: habr.com
