

Juaj të njiheni me raportin e Alexey Lesovski nga Data Egret "Bazat e monitorimit të PostgreSQL"
Në këtë raport, Alexey Lesovski do të flasë për momentet kryesore të statistikave të PostgreSQL, çfarë do të thonë ato dhe pse duhet të jenë pjesë e monitorimit; për grafikët që duhet të jenë në monitorim, si t'i shtoni dhe si t'i interpretoni. Raporti do të jetë i dobishëm për administratorët e bazave të të dhënave, administratorët e sistemeve dhe zhvilluesit që janë të interesuar për zgjidhjen e problemeve me Postgres.
Unë quhem Alexey Lesovski, përfaqësoj kompaninë Data Egret.
Pak fjalë për veten. Dikur, dikur isha administrator sistemi.
Kam administruar lloje të ndryshme Linux, kam bërë gjëra të ndryshme që lidhen me Linux, pra, virtualizim, monitorim, kam punuar me proksi etj. Por në një moment fillova të merrem më shumë me bazat e të dhënave, PostgreSQL. Më pëlqeu shumë. Dhe në një moment fillova të kaloj pjesën më të madhe të kohës time të punës në PostgreSQL. Kështu gradualisht u bëra DBA i PostgreSQL.
Dhe gjatë gjithë karrierës sime, kam qenë gjithmonë i interesuar për temat e statistikave, monitorimit, marrjes së telemetrisë. Kur isha administrator sistemi, merresha ngushtë me Zabbix. Dhe shkrova një grumbull të vogël skriptesh si . Ai ishte mjaft popullor në kohën e tij. Aty ishte e mundur të monitoroheshin shumë gjëra të rëndësishme, jo vetëm Linux, por edhe komponentë të ndryshëm.
Tani merrem me PostgreSQL. Po shkruaj një gjë tjetër që lejon punën me statistikat e PostgreSQL. E quajtur (artikulli në habrë — ).
Një hyrje e shkurtër. Çfarë situatash hasin klientët tanë? Duke ndodhur një aksident që lidhet me bazën e të dhënave. Dhe kur është rikuperuar baza e të dhënave, shefi i departamentit ose shefi i zhvillimit thotë: "Miq, duhet ta monitorojmë bazën e të dhënave, sepse ndodhi diçka e keqe dhe duhet që në të ardhmen të mos ndodhin gjëra të tilla". Dhe këtu fillon një proces interesant i zgjedhjes së sistemit të monitorimit ose adaptimit të një sistemi monitorimi ekzistues, në mënyrë që të mund të monitorojmë bazën tonë të të dhënave - PostgreSQL, MySQL ose ndonjë tjetër. Dhe kolegët fillojnë të propozojnë: "Kam dëgjuar se ekziston një bazë e tillë të dhënash. Le të përdorim atë". Kolegët fillojnë të diskutojnë mes tyre. Në fund, përfundojmë duke zgjedhur një ndonjë bazë të dhënash, por monitorimi i PostgreSQL në të është mjaft i dobët dhe gjithmonë detyrohemi të bëjmë disa rregullime. Të marrim disa depo nga GitHub, t'i klonojmë, të adaptojmë skriptet, t'i konfigurojmë sërish. Dhe në fund, kjo përfundon në një punë manuale.
Prandaj, në këtë referat do të përpiqem t'ju jap disa dije se si të zgjidhni monitorimin jo vetëm për PostgreSQL, por edhe për bazat e të dhënave. Dhe të jap ato dije që do t'ju lejojnë të përmirësoni monitorimin tuaj, në mënyrë që të merrni ndonjë përfitim prej tij, që të mund të monitoroni bazën tuaj të të dhënave në mënyrë të dobishme, për të paralajmëruar në kohë për situatat emergjente që mund të ndodhin.
Dhe idetë që do të jenë në këtë referat, mund t'i adaptoni drejtpërdrejt për çdo bazë të dhënash, qoftë kjo DBMS ose noSQL. Pra, këtu nuk është vetëm PostgreSQL, por do të ketë shumë receta se si ta bëni këtë në PostgreSQL. Do të ketë shembuj të pyetjeve, shembuj të entiteteve që ekzistojnë në PostgreSQL për monitorim. Dhe nëse DBMS juaj ka gjëra të tilla që lejojnë t'i futni ato në monitorim, ju gjithashtu mund t'i adaptoni, t'i shtoni dhe do të ishte mirë.
 Në referat nuk do të
flas për mënyrën se si të dorëzoni dhe ruani metrikat. Nuk do të flas për përpunimin post-datë dhe ofrimin e tyre për përdoruesin. Dhe nuk do të flas për alarmin.
Gjatë rrugëtimit, do të tregoj foto të ndryshme të monitorimeve ekzistuese dhe do t'i kritikoj ato. Sidoqoftë, do të përpiqem të mos përmend markat, për të mos krijuar reklamë ose anti-reklamë për këto produkte. Prandaj, të gjitha përputhjet janë të rastit dhe mbeten në imagjinatën tuaj.
Fillimisht, le të sqarojmë se çfarë është monitorimi. Monitorimi është një gjë shumë e rëndësishme që duhet të kemi. Të gjithë e kuptojnë këtë. Por, në të njëjtën kohë, monitorimi nuk është një produkt biznesi dhe nuk ndikon drejtpërdrejt në fitimin e kompanisë, prandaj zakonisht i jepet kohë monitoringut në mënyrë të mbetur. Nëse kemi kohë, merremi me monitorimin, nëse nuk kemi kohë, OK, do ta vendosim në backlog dhe ndonjëherë do të kthehemi te këto detyra.
Prandaj, nga praktika jonë, kur shkojmë te klientët, monitorimi shpesh është i pabërë mirë dhe nuk ka disa gjëra interesante që do të na ndihmonin ta bënim punën më të mirë me bazën e të dhënave. Prandaj, monitorimi duhet gjithmonë të përmirësohet.
Baza e të dhënave janë gjëra kaq të komplikuara që gjithashtu duhet të monitorohen, sepse bazat e të dhënave janë magazina informacioni. Dhe informata është shumë e rëndësishme për kompaninë, nuk duhet të humbasë kurrë. Por, në të njëjtën kohë, bazat e të dhënave janë pjesë shumë komplekse të softuerit. Ato përbëhen nga një numër të madh komponentësh. Dhe shumë nga këta komponentë duhet të monitorohen.
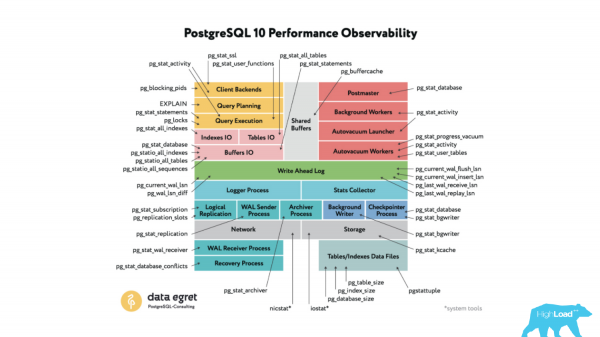 Nëse flasim konkretisht për PostgreSQL, mund ta paraqesim atë si një skemë që përbëhet nga një numër të madh komponentësh. Këta komponentë bashkëpunojnë me njëri-tjetrin. Dhe në të njëjtën kohë, në PostgreSQL ka, ashtu të quajturën, nën-sistemi i Stats Collector, i cili lejon grumbullimin e statistikave mbi punën e këtyre nën-sistemeve dhe ofron një ndërfaqe për administratorin ose përdoruesin për të parë këto statistika.
Këto statistika paraqiten në formën e një grupi funksionesh dhe pamjesh (views). Ato mund të quhen gjithashtu tabelat. Pra, me ndihmën e një klienti të zakonshëm psql, mund të lidheni me bazën e të dhënave, të bëni një select në këto funksione dhe pamje, dhe të merrni tashmë disa numra konkretë mbi punën e nën-sistemeve të PostgreSQL.
Mund t'i shtoni këta numra në sistemin tuaj të preferuar të monitorimit, të vizatoni grafika, të shtoni funksione dhe të merrni analitikë në perspektivë afatgjatë.
Por këtë raport nuk do të shqyrtoj të gjitha këto funksione në mënyrë të përgjithshme, sepse do të ishte një ditë e tërë. Do të përmend vetëm dy, tre ose katër aspekte dhe do të flas se si ato ndihmojnë në përmirësimin e monitorimit.
Dhe kur flasim për monitorimin e bazës, çfarë duhet të monitorsh? Së pari, duhet të monitorohet disponueshmëria, sepse baza është një shërbim që ofron akses në të dhëna për klientët, dhe ne duhet të monitorojmë disponueshmërinë, si dhe disa karakteristika të cilësisë dhe sasisë së saj.
Po ashtu, duhet të monitorojmë klientët që lidhen me bazën tonë, sepse ata mund të jenë si klientë normalë, ashtu edhe klientë të dëmshëm që mund t’i shkaktojnë dëm të dhënave. Edhe ata duhet të monitorohen dhe të ndiqen aktivitetet e tyre.
Kur klientët lidhen me bazën e të dhënave, është e qartë se ata fillojnë të punojnë me të dhënat tona, prandaj na duhet të monitorojmë gjithashtu se si klientët punojnë me të dhënat: me cilat tabela, në masë të vogël me cilat indekse. Kështu, na nevojitet të vlerësojmë ngarkesën (workload) që krijohet nga klientët tanë.
Por ngarkesa përbëhet, natyrisht, nga kërkesat. Aplikacionet lidhen me bazën, i drejtohen të dhënave përmes kërkesave, prandaj është e rëndësishme të vlerësohet se cilat kërkesa kemi në bazën e të dhënave, të monitorohet adekuatësia e tyre, që të mos jenë të shkruara keq, që disa opsione duhet të rishkruhen për t'u realizuar më shpejt dhe me më shumë performancë.
Dhe pasi flasim për bazën e të dhënave, baza e të dhënave gjithmonë ka procese në sfond. Proceset në sfond ndihmojnë në mbajtjen e performancës së bazës së të dhënave në një nivel të mirë, prandaj për funksionimin e tyre kërkojnë një sasi të caktuar burimesh për vete. Në të njëjtën kohë, ato mund të përputhen me burimet e kërkesave të klientëve, prandaj një punë e etur për burimet e proceseve në sfond mund të ndikojë drejtpërdrejt në performancën e kërkesave të klientëve. Prandaj, ato gjithashtu duhet të monitorohen dhe të ndiqen, për të siguruar që nuk ka asnjë përçarje në proceset në sfond.
Dhe gjithë kjo lidhur me monitorimin e bazës së të dhënave mbetet në metrikat sistematike. Por duke pasur parasysh se më shumë se gjithçka infrastruktura jonë po kalon në cloud, metrikat sistematike të një host-i të veçantë gjithmonë kalojnë në plan të dytë. Megjithatë, në bazat e të dhënave ato ende janë të rëndësishme dhe monitorimi i metrikave sistematike, sigurisht, është gjithashtu i nevojshëm.
Me metrikat sistematike është më shumë se mëse mirë, të gjitha sistemet moderne të monitorimit tashmë mbështesin këto metrika, por në përgjithësi, disa komponente megjithatë na mungojnë dhe disa gjëra duhen shtuar. Për to unë do të flas gjithashtu, disa slajde do të jenë për to.
Pika e parë e planit është disponibiliteti. Çfarë është disponibiliteti? Disponibiliteti në kupim të qytetarëve është aftësia e bazës për të shërbyer lidhjet, dmth. baza është aktive, si një shërbim, pranon lidhje nga klientët. Dhe ky disponibilitet mund të vlerësohet me disa karakteristika. Këto karakteristika është shumë e përshtatshme t'i vendosim në dashboard.
Të gjithë e dinë se çfarë janë dashboardet. Është kur shikon një herë ekranin, në të cilin është përmbledhur informacioni i nevojshëm. Dhe ju mund ta përcaktoni menjëherë – a ka një problem në bazë apo jo.
Për pasojë, disponibiliteti i bazës së të dhënave dhe karakteristikat e tjera kyçe gjithmonë duhet të vendosen në dashboard, në mënyrë që kjo informacion të jetë për dorë, të jetë gjithmonë afër jush. Disa detaje të tjera, të cilat ndihmojnë gjatë hetimeve të incidenteve, gjatë hetimeve të situatave emergjente, ato tashmë duhet t'i vendosen në dashboardet e dyta, ose të fshihen në linke drilldown, të cilat çojnë në sisteme monitorimi të jashtme.
Një shembull i një sistemi të njohur të monitorimit. Ky është një sistem shumë i mrekullueshëm monitorimi. Ai mbledh shumë të dhëna, por sipas mendimit tim, ka një koncept të çuditshëm të dashboardeve. Aty ka një lidhje 'krijo dashboard'. Por kur krijoni një dashboard, krijoni një listë, e cila përbëhet nga dy kolona, një listë grafike. Dhe kur ju nevojitet të shihni diçka, filloni të klikoni me mouse, të rrotulloni, të kërkoni grafikun e duhur. Dhe kjo kërkon kohë, domethënë, për dashboarde si të tilla, nuk ka. Ka vetëm lista grafikësh.
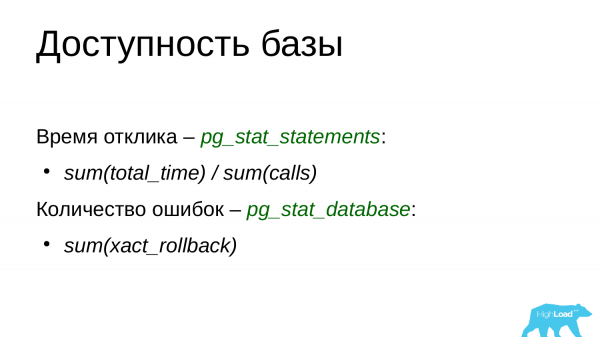
Çfarë duhet të shtojmë në këto panel? Mund të fillojmë me një karakteristikë si koha e përgjigjes. Në PostgreSQL ekziston një pamje pg_stat_statements. Sipas parazgjedhjes ajo është e çaktivizuar, por kjo është një nga pamjet sistemore të rëndësishme që gjithmonë duhet aktivizuar dhe përdorur. Ajo ruan informacion mbi të gjitha pyetjet e ekzekutuara që janë kryer në bazën e të dhënave.
Si përfundim, ne mund të mbështetemi në faktin se mund të marrim kohën e përgjithshme të ekzekutimit të të gjitha pyetjeve dhe ta ndajmë me numrin e pyetjeve duke përdorur fushat e përmendura më sipër. Por kjo është vetëm një mesatare. Ne mund të mbështetemi në fusha të tjera - koha minimale e ekzekutimit të pyetjeve, e maksimumi dhe median. Madje, mund të krijojmë perçentilë, në PostgreSQL ekzistojnë funksione për këtë. Dhe mund të marrim disa numra që karakterizojnë kohën e përgjigjes së bazës sonë për pyetjet e ekzekutuara tashmë, pra ne nuk ekzekutojmë një pyetje fals 'select 1' dhe shohim kohën e përgjigjes, por analizojmë kohën e përgjigjeve nga pyetjet e kryera dhe e paraqesim si një numër të veçantë ose krejmë një grafik rreth saj.
Po ashtu është e rëndësishme të ndjekim numrin e gabimeve që gjenerohen nga sistemi në këtë moment. Dhe për këtë mund të përdorim pamjen pg_stat_database. Ne orientoheni në fushën xact_rollback. Kjo fushë tregon jo vetëm numrin e rollbakeve që ndodhin në bazë, por merr parasysh edhe numrin e gabimeve. Në mënyrë konvencionale, ne mund ta paraqesim këtë numër në panelin tonë dhe të shohim sa gabime kemi në këtë moment. Nëse ka shumë gabime, këto janë një shenjë e mirë për të shqyrtuar skedarët e logëve dhe të shohim se çfarë janë këto gabime dhe pse ndodhin, dhe pastaj të investigojmë dhe t’i zgjidhim ato.
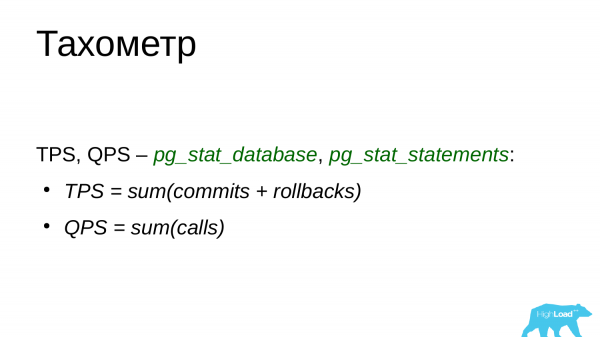
Mund të shtojmë një gjë si Takhometër. Kjo është numri i transaksioneve për sekondë dhe numri i pyetjeve për sekondë. Në mënyrë konvencionale, ju mund të përdorni këto numra si performancën aktuale të bazës suaj të të dhënave dhe të vini re nëse ka pika maksimale të pyetjeve, pika maksimale të transaksioneve ose, përkundrazi, nëse baza është nën-ngarkuar, sepse ndonjë backend ka dështuar. Ky numër është i rëndësishëm për t'u parë gjithmonë dhe për të mbajtur mend se për projektin tonë kjo performancë është normale, ndërsa vlerat më larta ose më të ulëta janë disa shqetësime dhe të paqarta, dhe do të thotë se duhet të shohim pse këto numra janë kështu.
Për të vlerësuar numrin e transaksioneve, mund të referohemi përsëri te pamja pg_stat_database. Mund të mbledhim numrin e commit dhe numrin e rollback dhe të marrim numrin e transaksioneve për sekondë.
Të gjithë e dinë se në një transaksion mund të përfshihen disa kërkesa? Prandaj, TPS dhe QPS janë paksa të ndryshme.
Numri i kërkesave për sekondë mund të merret nga pg_stat_statements dhe thjesht të llogaritet si shuma e të gjitha kërkesave të kryera. Është e qartë se ne po krahasojmë vlerën aktuale me atë të mëparshme, e heqim, marim diferencën dhe marrim numrin.
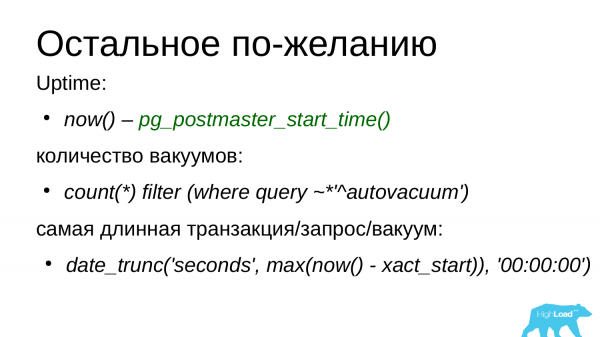
Mund të shtoni metrika të tjera sipas dëshires, të cilat ndihmojnë gjithashtu në vlerësimin e disponueshmërisë së bazës sonë dhe ndjekjen – nëse nuk kishte ndonjë downtime.
Një nga këto metrika është uptime. Por uptime në PostgreSQL është një gjë paksa e komplikuar. Do të tregoj pse. Kur PostgreSQL fillon, fillon të numërojë uptime. Por nëse në ndonjë moment, për shembull, gjatë natës, ekzekutohej ndonjë detyrë, vjen OOM-killer dhe detyron përfundimin e procesit bashkëpunues të PostgreSQL, në këtë rast PostgreSQL përfundon lidhjet e të gjithë klientëve, heq zonën e memories shpërndarëse dhe fillon rikuperimin nga pika e kontrollit më të fundit. Dhe ndërsa zgjat ky rikuperim nga pika e kontrollit, baza nuk pranon lidhje, dmth. kjo situatë mund të vlerësohet si downtime. Por megjithatë, numëruesi i uptime nuk do të zerë, sepse llogarit kohën e nisjes së postmaster që nga momenti i parë. Prandaj situata të tilla mund të kalohen.
Gjithashtu duhet të monitoroni numrin e punëtorëve të vakumit. Të gjithë e dinë se çfarë është autovacuum në PostgreSQL? Kjo është një nënstrukturë interesante në PostgreSQL. Për të është shkruar shumë, janë bërë shumë prezantime. Ka shumë diskutime rreth vakumit, se si duhet të funksionojë. Shumë e shohin si një të keqe të pashmangshme. Por ashtu është. Është një analog i mbledhësit të plehrave, i cili pastron versionet e vjetra të rreshtave, të cilat nuk i nevojiten asnjë nga transaksionet dhe lirojnë hapësirë në tabela, indekse për rreshta të rinj.
Pse duhet ta monitorojmë? Sepse vakumi ndonjëherë bën shumë dëm. Ai merr shumë burime dhe kërkesat e klientëve fillojnë të vuajnë nga kjo.
Dhe monitorimi i tij duhet bërë përmes pamjes pg_stat_activity, për të cilën do të flas në seksionin e ardhshëm. Kjo pamje tregon aktivitetin aktual në bazën e të dhënave. Nëpërmjet këtij aktiviteti, ne mund të ndjekim numrin e vakumeve që punojnë aktualisht. Mund të ndjekim vakumet dhe të shohim se nëse kemi tejkaluar kufirin, atëherë kjo është një arsye për të kontrolluar cilësimet e PostgreSQL dhe si të optimizojmë punën e vakumit.
Një tjetër veçori e PostgreSQL është se ai ndikohet shumë keq nga transaksionet e gjata. Sidomos nga transaksionet që qëndrojnë gjatë dhe nuk bëjnë asgjë. Këto quhen stat idle-in-transaction. Një transaksion i tillë mban bllokime dhe pengon punën e vakumit. Si rezultat, tabelat fryhen dhe rriten në madhësi. Kërkesat që punojnë me këto tabela fillojnë të punojnë më ngadalë, sepse duhet të nxjerrin të gjitha versionet e vjetra të rreshtave nga memoria në disk dhe përmbys. Prandaj, koha dhe gjatësi e transaksioneve më të gjata, si dhe e kërkesave më të gjata të vakumit gjithashtu duhet të monitorohet. Dhe nëse shohim disa procese që kanë punuar shumë gjatë, më shumë se 10-20-30 minuta për ngarkesat OLTP, atëherë duhet të vëmë re dhe t'i mbyllim ato me forcë, ose të optimizojmë aplikacionin që ato të mos thirren dhe të mos ngelen kaq gjatë. Për ngarkesat analitike, 10-20-30 minuta është normale, ndodhin edhe më të gjata.
Më pas kemi mundësinë me klientët e lidhur. Kur tani kemi formuar një panel, e kemi publikuar atë me metrikat kyçe të disponueshmërisë, mund të shtojmë gjithashtu informacion shtesë mbi klientët e lidhur.
Informacioni mbi klientët e lidhur është i rëndësishëm, sepse, nga pikëpamja e PostgreSQL, klientët janë të ndryshëm. Ka klientë të mirë dhe klientë të këqij.
Një shembull i thjeshtë. Nën klientin kuptoj aplikacionin. Aplikacioni është lidhur me bazën e të dhënave dhe fillon menjëherë të dërgojë kërkesat e tij, baza e të dhënave i përpunon ato dhe i ekzekuton, rezultatet kthehen te klienti. Këta janë klientë të mirë dhe të duhur.
Ka situata kur një klient lidhet, mban lidhjen, por nuk bën asgjë. Ai ndodhet në gjendjen idle.
Porosite ke janë edhe klientë të këqij. Për shembull, një klient i tillë u lidh, hapi një transaksion, bëri diçka në bazën e të dhënave dhe më pas kaloi në kod, le të themi, për t'u lidhur me një burim të jashtëm ose për të bërë atje përpunimin e të dhënave të marra. Por ai nuk e mbylli transaksionin. Dhe transaksioni qëndron hapur në bazë dhe mbajti bllokimin në rresht. Kjo është një gjendje e keqe. Dhe nëse ndonjëherë aplikacioni brenda ndonjë vendi bie për shkak të një përjashtimi (Exception), atëherë transaksioni mund të mbetet i hapur për një kohë të gjatë. Kjo ndikon drejtpërsëdrejti në performancën e PostgreSQL. PostgreSQL do të punojë më ngadalë. Prandaj, është e rëndësishme të monitoroni këta klientë dhe të mbyllni punën e tyre me forcë. Dhe duhet të optimizoni aplikacionin tuaj për të mos pasur situata të tilla.
Klientët e tjerë të këqij janë klientët që presin. Por ata bëhen të këqij për shkak të rrethanave. Për shembull, një transaksion i thjeshtë në pritje: mund të hapë një transaksion, të marrë bllokime në disa rreshta, pastaj diku në kod ai bie, duke lënë pas një transaksion që mbetet në pritje. Një klient tjetër vjen, kërkon të njëjtat të dhëna, por ai përballet me bllokimin, për shkak se ai transaksion që pret tashmë mban bllokime në disa rreshta të nevojshëm. Dhe transaksioni i dytë do të mbetet në pritje për derisa transaksioni i parë të përfundojë ose administratori i tij ta mbyllë me forcë. Kështu, transaksionet që presin mund të akumulohen dhe të tejkalojnë limitin e lidhjeve me bazën e të dhënave. Dhe kur limiti tejkalohet, aplikacioni nuk mund të punojë më me bazën. Kjo tashmë është një situatë emergjente për projektin. Prandaj, klientët e këqij duhet të monitorohen dhe të reagohet në kohë ndaj tyre.
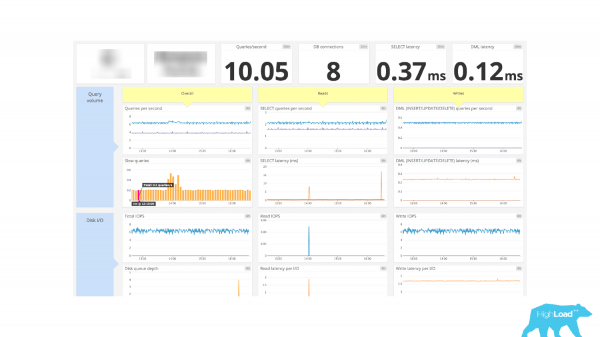
Një shembull tjetër i monitorimit. Dhe këtu kemi një panel të këndshëm. Ka informacion mbi lidhjet sipër. DB connection – 8 copë. Dhe kjo është gjithçka. Nuk kemi informacion se cilët klientë janë aktivë, cilët klientë thjesht janë në pritje, nuk bëjnë asgjë. Nuk ka informacion mbi transaksionet që presin dhe lidhjet që presin, domethënë, kjo është një shifër që tregon numrin e lidhjeve dhe gjithçka tjetër. Tani gjejeni vetë.
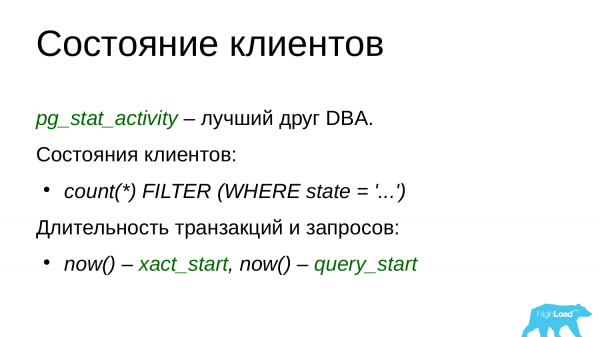
Prandaj, për ta shtuar këtë informacion në monitorim, duhet të referoheni në pamjen sistemore pg_stat_activity. Nëse kaloni shumë kohë në PostgreSQL, kjo është një pamje shumë e mirë që duhet të bëhet miku juaj, sepse tregon aktivitetin aktual në PostgreSQL, dmth çfarë po ndodh aty. Për çdo proces ka një rresht të veçantë, i cili tregon informacionin për atë proces: nga cili host është bërë lidhja, nën cilin përdorues, nën cilin emër, kur është nisur transaksioni, cili është kërkesa aktuale që po ekzekutohet, cili ishte kërkesa e fundit. Dhe, për rrjedhojë, gjendjen e klientit mund ta vlerësojmë nga fusha stat. Në terma të thjeshtë, mund të bëjmë grupimin sipas kësaj fushe dhe të marrim ato stats që janë aktualisht në bazën e të dhënave dhe numrin e lidhjeve që kanë këtë stat në bazën e të dhënave. Dhe numrat e marrë mund t'i dërgojmë në monitorimin tonë dhe të vizatojmë grafa për ta.
Po ashtu, është e rëndësishme të vlerësojmë kohëzgjatjen e transaksionit. Kam folur tashmë se është e rëndësishme të vlerësojmë kohëzgjatjen e vakumeve, por edhe transaksionet janë të vlerësuara saktësisht njësoj. Ka fusha xact_start dhe query_start. Ato, në terma të thjeshtë, tregojnë kohën e fillimit të transaksionit dhe kohën e fillimit të kërkesës. Ne marrim funksionin now(), i cili tregon markën aktuale të kohës dhe e zbritim timestamp-in e transaksionit dhe të kërkesës. Dhe marrim kohëzgjatjen e transaksionit, kohëzgjatjen e kërkesës.
Nëse shohim transaksione të gjata, duhet t'i përfundojmë ato. Për ngarkesat OLTP, transaksionet e gjata janë ato që kalojnë 1-2-3 minuta.. Për ngarkesat OLAP, transaksionet e gjata janë normale, por nëse ato zgjasin më shumë se dy orë, atëherë kjo është gjithashtu një shenjë se diku kemi një problem.
Kur klientët lidhen me bazën e të dhënave, ata fillojnë të punojnë me të dhënat tona. Ata referohen në tabela, ata referohen në indekse për të marrë të dhëna nga tabela. Dhe është e rëndësishme të vlerësojmë se si klientët punojnë me këto të dhëna.
Kjo është e nevojshme për të vlerësuar ngarkesën tonë të punës dhe për të kuptuar përafërsisht se cilat tabela janë më "të nxehta". Për shembull, kjo është e nevojshme në situatat kur dëshirojmë të vendosim "tabelat e nxehta" në ndonjë ruajtje SSD të shpejtë. Për shembull, disa tabela arkivale që nuk i përdorim më prej kohësh mund të zhvendosen në ndonjë "arkiv të ftohtë", në disqe SATA dhe le të qëndrojnë atje, aksesimi do të jetë vetëm kur është e nevojshme.
Gjithashtu, kjo është e dobishme për zbulimin e anomali pas çdo lëshimi dhe vendosjeje. Le të themi, projekti ka lëshuar një funksion të ri. Për shembull, është shtuar një funksionalitet i ri për punën me databazën. Dhe nëse ndërtuojmë grafike të përdorimit të tabelave, ne do të jemi në gjendje të zbulojmë lehtësisht këto anomali në këto grafike. Për shembull, shpërthime të update ose shpërthime të delete. Kjo do të jetë shumë e dukshme.
Gjithashtu, mund të zbulojmë anomali të "statistikave të lëshuara". Çfarë do të thotë kjo? Në PostgreSQL, planifikuesi i kërkesave është shumë i fortë dhe shumë i mirë. Dhe zhvilluesit i kushtojnë shumë kohë për ta zhvilluar atë. Si funksionon? Për të ndërtuar plane të mira, PostgreSQL, në një interval të caktuar kohor, mbledh statistikë mbi shpërndarjen e të dhënave në tabela. Kjo përfshin vlerat më të shpeshta: numri i vlerave unike, informacion rreth NULL në tabelë, shumë informacion.
Në bazë të kësaj statistike, planifikuesi ndërtan disa kërkesa, përzgjedh më të optimizuarin dhe përdor këtë plan kërkese për të ekzekutuar vetë kërkesën dhe për të kthyer të dhënat.
Dhe ndodhin raste kur statistika "lëviz". Cilësia dhe sasia e të dhënave janë ndryshuar në ndonjë mënyrë në tabelë, por statistika nuk është mbledhur. Dhe planet e formuara mund të rezultojnë jo optimale. Nëse planet tona rezultojnë jo optimale për monitorimin e mbledhur, në lidhje me tabelat, ne do të jemi në gjendje të shohim këto anomali. Për shembull, ndoshta ndodhi ndonjë ndryshim cilësor në të dhëna ku indeksi nisi të përdorë kalimin e radhës për të kaluar në tabelë, pra, nëse kërkesa duhet të kthejë vetëm 100 rreshta (ka kufizim limit 100), atëherë për këtë kërkesë do të realizohet një përmbledhje e plotë. Dhe kjo gjithmonë ndikon shumë keq në performancën.
Dhe ne do të jemi në gjendje ta shohim këtë në monitorim. Dhe tashmë të shohim këtë kërkesë, të kryejmë një shpjegim për të, të mbledhim statistika, të ndërtojmë një indeks të ri shtesë. Dhe tashmë të reagojmë ndaj kësaj problemi. Prandaj, kjo është e rëndësishme.
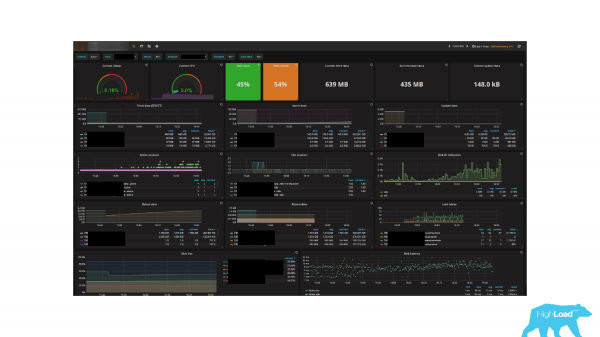
Një shembull tjetër monitorimi. Mendoj se shumë e kanë njohur, sepse është shumë popullor. Kush e përdor në projektet e tij. ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Por këtu ka një detaj të keq.
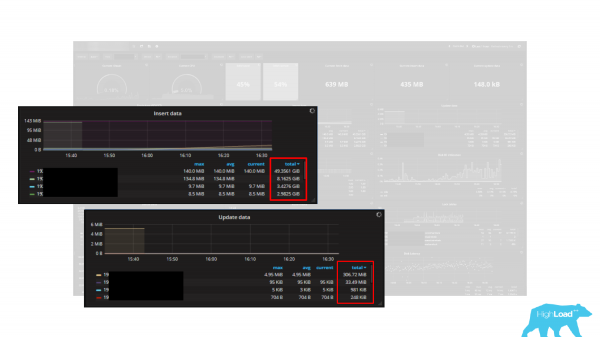
Ka disa grafika. Dhe si një njësi janë të dhënat në byte, pra aty janë 5 grafika. Këto janë Insert data, Update data, Delete data, Fetch data dhe Return data. Si njësi matjeje janë dhënë byte. Por çështja është se statistika në PostgreSQL kthen të dhënat në tuple (rrjeshta). Dhe, për pasojë, këto graficë janë një mënyrë shumë e mirë për të minimizuar ngarkesën tuaj për disa herë, për dhjetëra herë, sepse tuple nuk janë byte, tuple është një rrjesht, ajo përmban shumë byte dhe gjithmonë ka gjatësi të ndryshueshme. Pra, të llogaritësh ngarkesën në byte me anë të tuples është një detyrë e pamundur ose shumë e komplikuar. Prandaj, kur përdorni tabela të logaritjes ose monitorim të integruar, gjithmonë është e rëndësishme të kuptoni se ai funksionon siç duhet dhe ju kthen të dhëna të vlerësuara saktësisht.
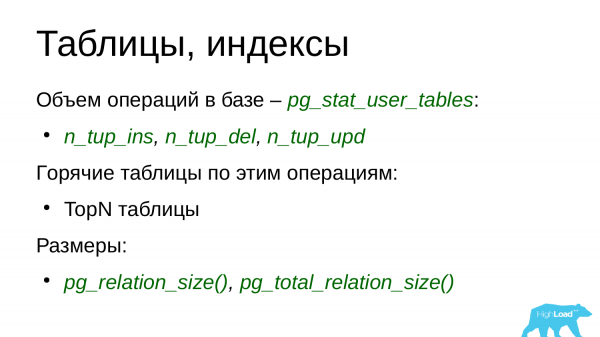
Si të merrni statistika për këto tabela? Për këtë, në PostgreSQL ka një grup të caktuar të pamjeve. Dhe pamja kryesore është . User_tables do të thotë se tabelat janë krijuar në emër të përdoruesit. Në kontrast, ka pamje sistemike, të cilat përdoren vetë nga PostgreSQL. Dhe ka një tabelë përmbledhëse Alltables, e cila përfshin si sistemet ashtu edhe përdoruesit. Ju mund të filloni nga cila do që ju pëlqen më shumë.
Sipas fushave të mësipërme, mund të vlerësoni numrin e insert, update dhe delete. Shembulli i tabelës që përdora, pikërisht përdor këto fusha për të vlerësuar karakteristikat e ngarkesës. Prandaj, ne gjithashtu mund të themi nga ato. Por duhet mbajtur mend se këto janë tuples, jo byte, prandaj nuk mund të marrë dhe ta bëj këtë në byte.
Bazuar në këto të dhëna, ne mund të ndërtojmë ato që quhen tabela TopN. Për shembull, Top-5, Top-10. Dhe mund të ndjekim ato tabela 'të nxehta' që janë përdorur më shumë se të tjerat. Për shembull, 5 tabelat 'të nxehta' për insert. Dhe nëpërmjet këtyre tabelave TopN ne vlerësojmë ngarkesën tonë dhe mund të vlerësojmë shpërthimet e ngarkesës pas çdo lëshimi, përditësimi dhe vendosjeje.
Është gjithashtu e rëndësishme të vlerësohen përmasat e tabelës, sepse ndonjëherë zhvilluesit nxjerrin një veçori të re dhe tabelat tona fillojnë të zmadhohen në përmasa të mëdha, sepse vendosën të shtojnë një volum të shtuar të të dhënave, por nuk parashikojnë se si do të ndikojë kjo në madhësinë e bazës së të dhënave. Raste të tilla gjithashtu na vijne si surpriza.
Dhe tani një pyetje e vogël për ju. Cila është pyetja që lind kur vëreni ngarkesën në serverin me bazën e të dhënave? Cila është pyetja tjetër që ju lind?
Por në të vërtetë pyetja është kjo. Cilat kërkesa shkaktojnë ngarkesën? Pra, nuk është interesante të shikosh proceset që shkaktojnë ngarkesën. Është e qartë se nëse host-i ka bazën e të dhënave, atëherë aty është e nisur baza e të dhënave dhe është e qartë se vetëm bazat e të dhënave do të shfrytëzohen aty. Nëse hapim Top, do të shohim listën e proceseve në PostgreSQL, të cilat bëjnë diçka. Nga Top nuk do të kuptohet se çfarë bëjnë.
Prandaj, është e nevojshme të zbulojmë ato kërkesa që shkaktojnë ngarkesën më të madhe, sepse tuning-i i kërkesave, në përgjithësi, sjell më shumë përfitim se tuning-u i konfigurimit të PostgreSQL ose sistemit operativ, ose madje tuning-u i hardware-it. Nga vlerësimi im – kjo është rreth 80-85-90%. Dhe kjo bëhet shumë më shpejt. Është më e lehtë të rregullosh një kërkesë sesa të rregullosh konfigurimin, të planifikosh një restart, sidomos nëse nuk është e mundur të rinisësh bazën, ose të shtosh harduer. Është më e lehtë ndonjëherë të rishkruash një kërkesë ose të shtosh një indeks për të marrë një rezultat më të mirë nga kjo kërkesë.
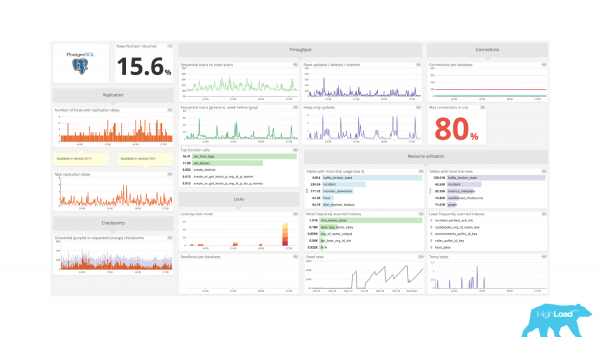
Prandaj, është e nevojshme të monitorohen kërkesat dhe adekuatësia e tyre. Le të marrim një shembull tjetër të monitorimit. Dhe këtu gjithashtu duket si një monitorim i shkëlqyer. Ka informacion për replikimin, ka informacion për kapacitetin, bllokimet, shfrytëzimin e burimeve. E gjitha është perfekte, por nuk ka informacion për kërkesat. Nuk është e qartë se cilat kërkesa po kryhen në bazën tonë të të dhënave, sa kohë zgjat ekzekutimi i tyre, sa janë këto kërkesa. Na nevojitet gjithmonë të kemi këtë informacion në monitorim.
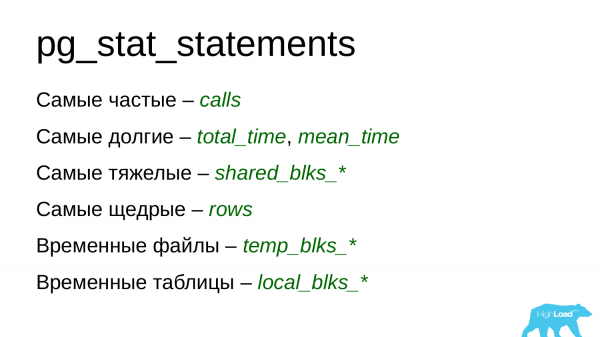
Dhe për të marrë këtë informacion, mund të përdorim modul nga pg_stat_statements. Bazuar në të, mund të ndërtojmë grafika të ndryshme. Për shembull, mund të marrim informacion mbi kërkesat më të shpeshta, pra ato kërkesa që ekzekutohen më shpesh. Po, pas përditësimeve është shumë e dobishme të shohim këto dhe të kuptojmë nëse ka ndonjë shpërthim të kërkesave.
Mund të monitorojmë kërkesat më të gjata, pra ato kërkesa që ekzekutohen më gjatë. Ato funksionojnë në procesor, konsumojnë I/O. Këtë mund ta vlerësojmë gjithashtu nga fushat total_time, mean_time, blk_write_time dhe blk_read_time.
Mund të vlerësojmë dhe të monitorojmë kërkesat më të ndërlikuara në aspektin e përdorimit të resurseve, ato që lexojnë nga disku, që punojnë me memorie ose, përkundrazi, që krijojnë ngarkesë shkrimi.
Mund të vlerësojmë kërkesat më bujare. Këto janë kërkesat që kthejnë një numër të madh rreshtash. Për shembull, mund të jetë ndonjë kërkesë ku është harruar të vendoset një kufi. Ajo thjesht kthen të gjithë përmbajtjen e tabelës ose kërkesat për tabelat e kërkuara.
Dhe gjithashtu mund të monitorojmë kërkesat që përdorin skedarë përkohës apo tabela përkohëse.
Dhe na kanë mbetur proceset e prapmë. Proceset e prapmë janë në radhë të parë kontrollet, ose siç i quajnë ndryshe, pikëkontrolli, autovacuum dhe replikimi.
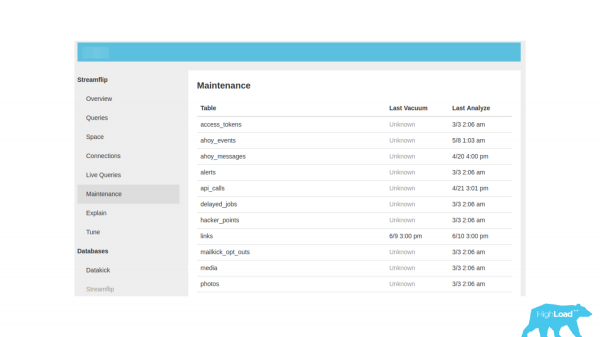
Një shembull tjetër monitorimi. Ka skedën Maintenance në anën e majtë, kalojmë në të dhe shpresojmë të shohim diçka të dobishme. Por këtu është vetëm koha e funksionimit të vakumit dhe mbledhjes së statistikave, asgjë më shumë. Kjo është një informacion shumë i varfër, prandaj gjithmonë duhet të kemi informacion për mënyrën se si punojnë proceset e prapme në bazën tonë të dhënash dhe nëse ka ndonjë problem nga puna e tyre.
Kur shqyrtojmë pikëkontrollin, duhet të mbajmë parasysh se pikëkontrolli shkarkon faqet "e papastra" nga zona e memories të ndara në disk, pastaj krijon një pikëkontroll. Dhe kjo pikëkontroll tani mund të përdoret si një vend gjatë rikuperimit, nëse ndonjëherë PostgreSQL është mbyllur në mënyrë të paplanifikuar.
Pra ndaj, për të rënë poshtë të gjitha faqet e "ndotura" në disk, duhet të kryhet një volum i caktuar shkrimi. Dhe, si rregull, në sistemet me shumë memorie – kjo është shumë. Dhe nëse bërthamat tona bëhen shumë shpesh brenda një intervali të shkurtër, atëherë performanca e disku do të bjerë shumë. Dhe kërkesat e klientëve do të vuajnë nga mungesa e burimeve. Ata do të përpiqen për burimet dhe do t'u mungojë performanca.
Pra ndaj, nëpërmjet pg_stat_bgwriter, për fushat e specifikuara, ne mund të monitorojmë numrin e bërthamave që ndodhin. Dhe nëse ne kemi shumë bërthama brenda një periudhe të caktuar kohe (për 10-15-20 minuta, për një gjysmë ore), për shembull, 3-4-5, atëherë kjo mund të jetë një problem. Dhe duhet të shikojmë në bazën e të dhënave, të kontrollojmë konfigurimin, se çfarë e shkakton këtë abundencë të bërthamave. Ndoshta ka ndonjë shkrim të madh në vijim. Nga ngarkesa e punës, ne mund ta vlerësojmë, sepse grafikët e ngarkesës së punës janë tashmë të shtuar. Ne mund të rregullojmë parametrat e pikave të kontrollit dhe të bëjmë që ato të mos ndikojnë shumë në performancën e kërkesave.
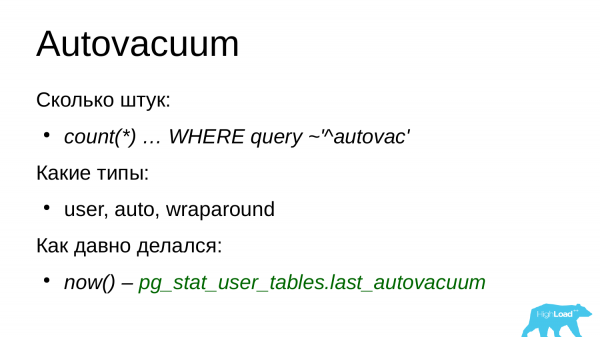
Unë përsëri kthehem te autovacuum, sepse kjo është një gjë, siç kam thënë më parë, që mund të dëmtojë lehtësisht performancën e diskëve dhe kërkesave, prandaj gjithmonë është e rëndësishme të vlerësojmë numrin e autovacuum.
Numri i punonjësve të autovacuum në bazën e të dhënave është i kufizuar. Me standard, ata janë tre, prandaj nëse ne kemi gjithnjë tre punonjës që punojnë në bazë, do të thotë se autovacuum është keqkonfiguruar, duhet të rriten kufijtë, të rishikohen parametrat e autovacuum dhe të shohim me konfigurimin.
Është e rëndësishme të vlerësojmë se cilët punonjës të vaksinimit po punojnë. Ose është nisur nga një përdorues, DBA ka ardhur dhe ka nisur me duar ndonjë vaksinë, dhe kjo ka krijuar ngarkesë. Ne kemi ndonjë problem. Ose është numri i vaksinave që rrotullojnë numrin e transaksioneve. Për disa versione të PostgreSQL – këto janë vaksina shumë të rënda. Dhe ata mund të dëmtojnë lehtësisht performancën, sepse ata lexojnë të gjithë tabelën në tërësi, skanojnë të gjitha bloket në këtë tabelë.
Dhe, sigurisht, është edhe kohëzgjatja e vakuumeve. Nëse kemi vakuume të gjata që funksionojnë për një periudhë të gjatë, atëherë kjo do të thotë se duhet të hedhim një sy në konfigurimin e vakuumit dhe ndoshta ta rishikojmë atë. Sepse mund të ndodhë që vakuumi të punojë mbi një tabelë për një periudhë të gjatë (3-4 orë), por gjatë kësaj kohe në tabelë mund të akumulohet përsëri një sasi e madhe e rreshtave të vdekur. Dhe sapo të përfundojë vakuumi, është e nevojshme që përsëri të vakuumojë këtë tabelë. Dhe arrijmë në një situatë të vakuumit të pafund. Në këtë rast, vakuumi nuk arrin të kryejë punën e tij, dhe tabelat fillojnë gradualisht të fryhen në përmasa, ndonëse sasia e të dhënave të dobishme në to mbetet e njëjtë. Prandaj, gjatë vakuumeve të gjata, ne gjithmonë e shqyrtojmë konfigurimin dhe përpiqemi ta optimizojmë, por pa e dëmtuar performancën e kërkesave të klientëve.
Aktualisht, praktikisht nuk ka instalimesh PostgreSQL pa replikimin në rrjedhë. Replikimi është procesi i transferimit të të dhënave nga masteri në replikë.
Replikimi në PostgreSQL është organizuar përmes regjistrit të transaksioneve. Masteri gjeneron regjistrin e transaksioneve. Regjistri i transaksioneve dërgohet përmes një lidhjeje rrjetit në replikë, dhe më pas në replikë ai riprodhohet. E thjeshtë.
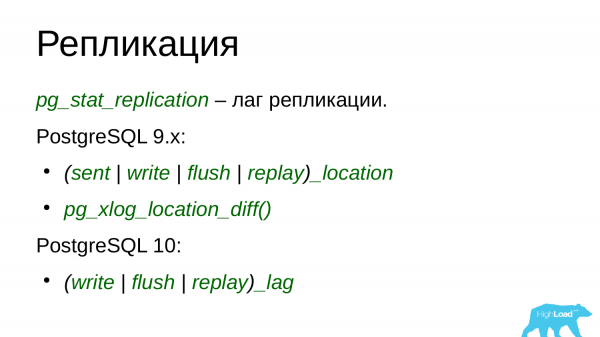
Për monitorimin e lagut të replikimit përdoret pamja pg_stat_replication. Por me të nuk është gjithçka e thjeshtë. Në versionin 10, pamja ka pësuar disa ndryshime. Së pari, disa fusha janë riemëruar. Dhe disa fusha janë shtuar. Në versionin 10 janë shtuar fusha që lejojnë vlerësimin e lagut të replikimit në sekonda. Kjo është shumë e dobishme. Para versionit 10, kishte mundësi për të vlerësuar lagun e replikimit në byte. Kjo mundësi mbetet edhe në versionin 10, pra mund të zgjidhni se çfarë ju është më e përshtatshme - të vlerësoni lagun në byte ose në sekonda. Shumë e bëjnë të dyja.
Megjithatë, për të vlerësuar lagun e replikimit, duhet të dini pozitat e regjistrit në transaksion. Dhe këto pozita të regjistrit të transaksioneve janë pikërisht në pamjen pg_stat_replication. Në mënyrë të thjeshtë, me ndihmën e funksionit pg_xlog_location_diff() ne mund të marrim dy pika në regjistrin e transaksioneve. Të llogarisim delta ndërmjet tyre dhe të marrim lagun e replikimit në byte. Kjo është shumë e dobishme dhe e thjeshtë.
Në versionin e 10-të kjo funksionalitet u riemërua në pg_wal_lsn_diff(). Në tërësi, në të gjitha funksionet, pamjet, utilitarët ku haset fjalë "xlog", ajo u zëvendësua me "wal". Kjo ka ndodhur si në pamje ashtu edhe në funksione. Ky është një ndryshim i rëndësishëm.
Për më tepër, në versionin 10 janë shtuar rreshta që tregojnë specifikisht vonesën. Këto janë write lag, flush lag, replay lag. Pra, është e rëndësishme të monitoroni këto gjëra. Nëse shohim se kemi vonesë replikimi, më pas duhet të hetojmë pse ka ndodhur, nga ka ardhur dhe ta zgjidhim problemin.
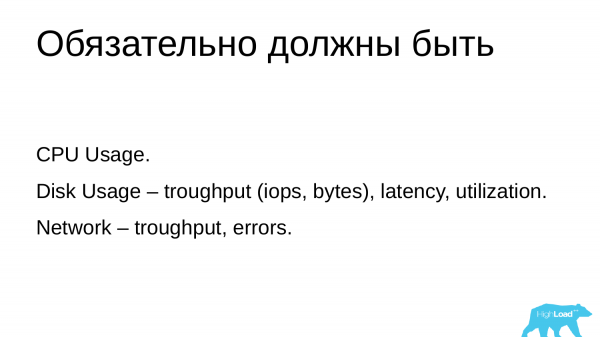
Me metrikat sistemike pothuajse gjithçka është në rregull. Kur krijohet çdo monitorim, ai fillon me metrikat sistemike. Kjo përfshin shfrytëzimin e procesorëve, memory, swap, rrjetin dhe diskun. Megjithatë, shumë parametra nuk janë aty default.
Nëse me shfrytëzimin e procesit gjithçka është në rregull, atëherë me shfrytëzimin e diskut ka probleme. Zakonisht, zhvilluesit e monitorimeve shtojnë informacion rreth kapacitetit të kalimit. Ky informacion mund të jetë në iops ose byte. Por ata harrojnë për latency dhe shfrytëzimin e pajisjeve diskore. Këto janë parametra më të rëndësishëm që lejojnë të vlerësojmë sa e ngarkuar janë diskun dhe sa ngadalësohen ato. Nëse kemi latency të lartë, atëherë kjo tregon se ka disa probleme me diskun. Nëse kemi shfrytëzim të lartë, ajo tregon se diskët nuk po e përballojnë ngarkesën. Këto janë karakteristika më cilësore se kapaciteti i kalimit.
Duke pasur parasysh se kjo statistikë mund të merret gjithashtu nga sistemi i skedarëve /proc, ashtu siç bëhet për shfrytëzimin e procesorëve. Pse nuk e shtojnë këtë informacion në monitorime, nuk e di. Megjithatë, është e rëndësishme ta keni këtë në monitorimin tuaj.
E njëjta gjë vlen për ndërfaqet rrjetë. Ka informacion rreth kapacitetit të kalimit të rrjetit në paketa, në byte, por megjithatë nuk ka informacion për latency dhe nuk ka informacion për shfrytëzimin, megjithatë kjo është gjithashtu informacion i dobishëm.
Çdo monitorim ka mangësi. Dhe çfarëdo monitorimi që të merrni, ai gjithmonë do të jetë i papërshtatshëm ndaj disa kritereve. Megjithatë, ato po zhvillohen, shtohen funksione të reja, gjëra të reja, prandaj zgjidhni diçka dhe përmirësoni.
Dhe për të përmirësuar, duhet gjithmonë të keni një ide se çfarë do të thotë statistika e dhënë dhe si mund ta përdorni atë për të zgjidhur probleme.
Dhe disa pika kyçe:
- Është e rëndësishme të monitoroni vazhdimisht disponueshmërinë, të keni panelë informacioni për të vlerësuar shpejt se baza juaj është në rregull.
- Është thelbësore të keni një ide të qartë se cilët klientë po punojnë me bazën tuaj të të dhënave, për të identifikuar klientët problematikë dhe për t'i larguar ata.
- Është e rëndësishme të vlerësoni se si këta klientë po e përdorin të dhënat. Duhet të keni një pasqyrë të ngarkesës suaj të punës.
- Është e rëndësishme të vlerësoni se si po formohet kjo ngarkesë pune dhe me cilat kërkesa. Ju mund të vlerësoni kërkesat, t'i optimizoni, t'i riformatoni dhe të ndihmoni me ndërtimin e indekseve për to. Kjo është shumë e rëndësishme.
- Proceset në sfond mund të ndikojnë negativisht në kërkesat e klientëve, prandaj është e rëndësishme të monitoroni që ato të mos përdorin shumë burime.
- Metritë sistemore ju lejojnë të bëni plane për shkallëzim dhe për rritjen e kapacitetit të serverëve tuaj, prandaj është e rëndësishme t'i monitoroni dhe vlerësoni ato.
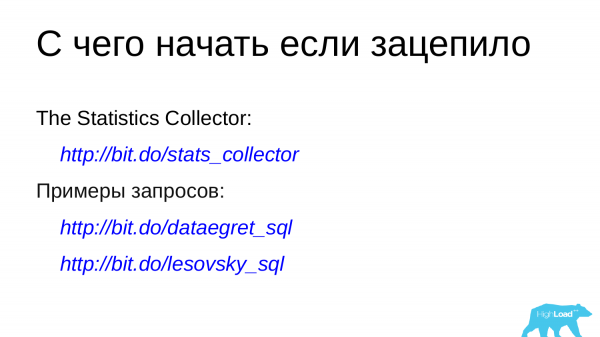
Nëse jeni të interesuar për këtë temë, mund të ndiqni këto lidhje.
— është dokumentacioni zyrtar për mbledhësin e statistikave. Atëherë ka përshkrime të të gjithë pamjeve statistikore dhe përshkrime të të gjitha fushave. Ju mund t'i lexoni, t'i kuptoni dhe t'i analizoni. Dhe tashmë në bazë të tyre të ndërlidhni grafiket tuaja, t’i shtoni në monitorimet tuaja.
Shembuj kërkesash:
Ky është repozitori ynë korporativ dhe timi vetjak. Në të ka shembuj kërkesash. Atje nuk ka kërkesa si select* from diçka. Atëherë ka kërkesa të gatshme me bashkime, me përdorimin e funksioneve interesante, që lejojnë të keni vlera të lexueshme, të dobishme, dmth, këto janë byte, kohë. Ju mund t'i shqyrtoni, t'i shihni, t’i analizoni, t'i shtoni në monitorimet tuaja, të ndërlidhni në bazë të tyre monitorimet tuaja.
Pyetje
Përgjigje: Ju thatë se nuk do të reklamoni markat, por megjithatë më intereson – cilat panelet informacioni përdorni në projektet tuaja?
Përgjigje: Në mënyra të ndryshme. Ndonjëherë ne shkojmë te klienti dhe ai ka tashmë monitorimin e tij. Dhe ne këshillojmë klientin mbi atë që duhet të shtohet në monitorimin e tij. Shumë keq është situata me Zabbiх. Sepse ai nuk ka mundësinë të ndërtojë grafika TopN. Ne vetë përdorim , sepse i kemi këshilluar këta djem rreth monitorimit. Ata bënë monitorimin e PostgreSQL mbi bazën e detyrës sonë. Unë po shkruaj projektin tim personal, i cili mbledh të dhëna përmes Prometheus dhe i paraqet ato në . Kam është një detyrë për të krijuar eksportuesin e vet në Prometheus dhe më pas për të vizatuar gjithçka në Grafana.
Pyetje: A ka alternativa për raportet AWR ose … agregimet? A dini për diçka të tillë?
Përgjigje: Po, unë e di se çfarë është AWR, është diçka e shkëlqyer. Aktualisht, ka shumë variante që zbatojnë një model të ngjashëm. Në një interval të caktuar kohor, disa baselines shkruhen në PostgreSQL të njëjtë ose në një magazinë të veçantë. Mund t'i gjeni ato në internet. Një nga zhvilluesit e një gjëje të tillë është në forumet sql.ru në temën PostgreSQL. Mund ta kapni atje. Po, ka të tilla, mund t'i përdorni. Plus, për veten time, unë gjithashtu po shkruaj një gjë që lejon të bëj të njëjtën gjë.
P.S.1 Nëse përdorni postgres_exporter, cila dashboard përdorni? Ka disa prej tyre. Të gjitha janë tashmë të vjetra. Ndoshta komuniteti do të krijojë një shabllon të përditësuar?
P.S.2 E hoqa pganalyze, pasi është një ofertë SaaS pronësore që përqendrohet në monitorimin e performancës dhe sugjerimet për optimizimin automatizuar.
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
Cila monitorim i vetë-hostuar për postgresql (me dashboard) e konsideroni si më të mirën?
30,0%Zabbix + shtesat nga Aleksei Lesovski ose zabbix 4.4 ose libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze është një SaaS pronësor - nuk mund ta fshij1
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 përdorues votuan. 26 përdorues abstenuan.
Burimi: habr.com
