

Kur puna jote është krijimi i diçkaje të bukur, nuk ka shumë për të thënë rreth saj, sepse rezultati është para gjithë atyre që e shohin. Por, nëse ti fshih shkrimet nga murët, puna jote nuk vërehet derisa murët të duken të pastër ose derisa të fshish diçka që nuk duhet.
Çdo shërbim ku mund të lësh një koment, një rishikim, të dërgosh mesazhe ose të ngarkosh imazhe, përballohet me problemin e spam-it, mashtrimeve dhe fjalëve ofendues. Kjo nuk mund të shmanget, por duhet të luftohet.
Më quajnë Mikhail, punoj në ekipin e Antispoamit, i cili mbron përdoruesit e shërbimeve të Yandex nga këto probleme. Puna jonë shpesh nuk vihet re (dhe është mirë!), prandaj sot do të flas më shumë për të. Do të mësoni në cilat raste moderimi është i pamjaftueshëm dhe pse saktësia nuk është treguesi i vetëm i efektivitetit të tij. Po ashtu, do të diskutojmë për fjalorin e keq duke përdorur shembuj nga macet dhe qentë dhe përse ndonjëherë është e dobishme të "mendonim si një ofendues".
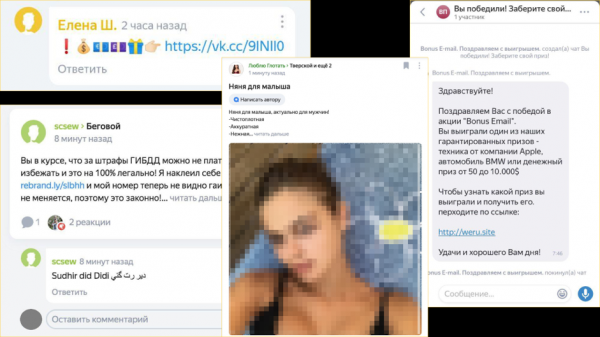
Në Yandex po shfaqen gjithnjë e më shumë shërbime ku përdoruesit publikojnë përmbajtjen e tyre. Mund të bësh një pyetje ose të shkruash një përgjigje në Yandex.Q, të diskutosh për lajmet e lagjes në Yandex.Rajoni, të ndash gjendjen e trafikut në bisedat në Yandex.Hartat. Por, kur audienca e shërbimit rritet, ai bëhet tërheqës për mashtruesit dhe spamatorët. Ata vijnë dhe mbushin komentet: ofrojnë fitime të lehta, reklamojnë mjete të mrekullueshme dhe premtojnë ndihma sociale. Për shkak të spamatorëve, disa përdorues humbasin para, ndërsa të tjerë humbasin dëshirën për të kaluar kohë në një shërbim të papastër, të mbushur me spam.
Dhe kjo nuk është problemi i vetëm. Ne synojmë jo vetëm të mbrojmë përdoruesit nga mashtruesit, por edhe të krijojmë një atmosferë komode për bisedë. Nëse njerëzit në komente përballen me fjalë ofenduese dhe sharje, ata kanë një probabilitet të lartë të largohen dhe të mos kthehen më. Kështu që kjo duhet gjithashtu të luftohet.
Web i Pastër
Si ndodh shpesh, zhvillimet e para lindën në Kërkim, në atë pjesë që lufton me spam në rezultatet e kërkimit. Dhjetë vjet më parë, aty u shfaq një detyrë për filtrimin e përmbajtjeve të rritur për kërkime familjare dhe për pyetje që nuk parashtrojnë përgjigje nga kategoria 18+. Kështu u krijuan fjalorët e parë, të shkruar me dorë, për pornografinë dhe fjalorin e fjalëve të neveritshme, të cilët i mbushnin analistët. Detyra kryesore ishte klasifikimi i pyetjeve në ato që lejohej të shfaqisnin përmbajtje të rritur dhe ato që nuk lejohej. Për këtë detyrë u grumbulluan shënime, u ndërtuan heuristika, u stjuan modele. Kështu u krijuan zhvillimet e para për filtrimin e përmbajtjeve të padëshiruara.
Me kalimin e kohës, në Yandex filloi të shfaqej UGC (përmbajtje e krijuar nga përdoruesit) — mesazhe që i shkruajnë vetë përdoruesit, dhe Yandex thjesht i publikonte ato. Për arsyet e përmendura më sipër, shumë mesazhe nuk mund të publikohej pa një shqyrtim — kërkohej moderimi. Atëherë u vendos të krijohej një shërbim që do të ofronte mbrojtje nga spam-i dhe keqbërësit për të gjitha produktet UGC të Yandex-it dhe përdorte zhvillimet për filtrimin e përmbajtjeve të padëshiruara në Kërkim. Shërbimi u quajt "Webi i Pastër".
Detyra të reja dhe ndihma e tolokerëve
Fillimisht, ne kishim vetëm automatizim të thjeshtë: shërbimet na dërgonin ne tekstet, dhe ne i kalonim ato përmes fjalorëve të fjalëve të neveritshme, fjalorëve të pornografisë dhe shprehjeve të rregullta — analistët e përgatitnin gjithçka manualisht. Por shërbimi me kalimin e kohës u përdor në numër gjithnjë e më të madh produktesh Yandex, dhe na duhej të mësojmë të punojmë me probleme të reja.
Shpesh, në vend që të japin një vlerësim, përdoruesit publikojnë një grup pa lidhje shkronjash, duke u përpjekur të fitojnë një arritje për veten e tyre, herë pas here reklamojnë kompaninë e tyre në vlerësimet për kompanitë konkurrente, dhe ndonjëherë thjesht ngatërrojnë organizatat dhe në një vlerësim për një dyqan për kafshë shkrijnë: "Peshku i gatuar shkëlqye!". Ndoshta një ditë inteligjenca artificiale do të mësojë të kuptojë plotësisht sensin e çdo teksti, por tani automatizimi shpesh nuk funksionon më mirë se njeriu.
U bë e qartë se pa një markup manual këtu nuk do të kishim zgjidhje, kështu që i shtuam konturit tonë një shkallë të dytë - dërgimin për kontroll manual nga një njeri. Aty shkonin ato tekste të publikuara për të cilat klasifikatori nuk kishte parë probleme. Masat e një detyre të tillë mund t’i imagjinoni lehtësisht, prandaj ne nuk iu besuam vetëm assessorëve, por gjithashtu përfituam nga "mençuria e turmës", dmth. kërkuam ndihmën e tolokerëve. Pikërisht ata na ndihmojnë të zbulojmë atë që mahniti makina dhe kështu e mësojnë atë.
Keshimi inteligjent dhe hashing LSH
Një tjetër problem me të cilin u përballëm gjatë punës me komentet ishte spam, për të qenë më saktë, volumi dhe shpejtësia e përhapjes së tij. Kur audienca e Yandex.Rajon filloi të rritet shpejt, atje erdhën spamerët. Ata mësuan të kalonin rregullat, duke ndryshuar pak tekstin. Sigurisht, spam-in e gjenim dhe e fshimë, por në masën e Yandex-it, një mesazh i papranueshëm i publikuar edhe për 5 minuta mund të shihte qindra njerëz.
Kjo sigurisht që nuk na kënaqte, prandaj ne krijuam një keshim inteligjent të teksteve në bazë të LSH (). Kjo funksionon siç vijon: ne normalizuam tekstin, e hiqnim lidhjet dhe e ndanim atë në n-grama (sëkuence prej n-character). Më pas, llogaritnim hash-ët e n-gramave, dhe sipas tyre ndërtonim vektorin LSH të dokumentit. Kuptimi është se tekstet e ngjashme, edhe nëse ato janë ndryshuar pak, shndërrohen në vektora të ngjashëm.
Ky zgjidhje na lejojti të ri-shfrytëzojmë verdiktet e klasifikatorëve dhe tolokerëve për tekste të ngjashme. Gjatë një sulmi me spam, sapo mesazhi i parë kalonte kontrollin dhe hynte në kesh me verdiktin "spam", të gjitha mesazhet e reja të ngjashme, edhe të modifikuara, merrnin të njëjtin verdikt dhe fshiheshin automatikisht. Më vonë, ne mësuam të mësojmë dhe të ri-mësojmë automatikisht klasifikatorët e spam, por ky "kesh inteligjent" na ka mbetur dhe akoma na ndihmon shpesh.
Klasifikatori i teksteve të mira
Pas arriti të pushojmë nga lufta me spamin, ne kuptuam se 95% e përmbajtjes tonë moderohen manualisht: klasifikuesit reagojnë vetëm ndaj shkeljeve, ndersa shumica e teksteve janë të mira. Ne ngarkojmë tolokerët, të cilët në 95 raste nga 100 japin vlerësim "Gjithçka në rregull". Duhej të merreshim me një punë të pazakontë - të krijonim klasifikues për përmbajtjen e mirë, fatmirësisht kemi akumuluar mjaft shënime gjatë këtij kohë.
Klasifikuesi i parë dukej kështu: lematizojmë tekstin (i kthejmë fjalët në formën fillestare), heqim të gjitha pjesët e fjalëve shërbyes dhe aplikojmë një "fjalor të fjalëve të mira" të përgatitur më parë. Nëse në tekst të gjitha fjalët janë "të mira", atëherë edhe teksti në tërësi nuk përmban shkelje. Në shërbime të ndryshme, ky qasje menjëherë dha nga 25 deri në 35% automatizim të shënimeve manuale. Natyrisht, ky qasje nuk është i përsosur: nuk është e vështirë të kombinosh disa fjalë të pafajshme dhe të marrësh një shprehje shumë ofenduese, por na lejoi të arrijmë shpejt një nivel të mirë të automatizimit dhe na dha kohë për të trajnuar modele më të komplikuara.
Versionet e ardhshme të klasifikuesve për tekstet e mira përfshinin tashmë edhe modele linjare, edhe pemë vendimtarësh, dhe kombinimet e tyre. Për shënimin e fyerjeve dhe ofendimeve, ne, për shembull, provuam rrjetin neuro BERT. Këtu është e rëndësishme të kapësh kuptimin e fjalës në kontekst dhe marrëdhënien e fjalëve nga fraza të ndryshme, dhe BERT e bën këtë mjaft mirë. (Për mendim, kolegët tanë nga Lajmet, si e aplikojnë teknologjinë për një detyrë jo standarde - gjetjen e gabimeve në tituj.) Si rezultat, arritëm të automatizojmë deri në 90% të fluksit në varësi të shërbimit. Saktësia, plotesia dhe shpejtësia
Për të u zhvilluar, është e nevojshme të kuptohet se çfarë dobi sjellin klasifikuesit automatikë, ndryshimet në to, si dhe nëse cilësia e kontrollimeve manuale degradohet. Për këtë, ne aplikojmë treguesit e saktësisë dhe plotësisë.
Për të u zhvilluar, duhet të kuptojmë se cila është dobi sjellin klasifikuesit automatike, ndryshimet në to, si dhe nëse nuk po degradohet cilësia e kontrollit manual. Për këtë ne përdorim treguesit e saktësisë dhe plotësisë.
Saktësia është përqindja e verdikteve të sakta në mesin e të gjitha verdikteve mbi përmbajtjen e keqe. Sa më e lartë të jetë saktësia, aq më pak janë alarmet false. Nëse nuk e monitorojmë saktësinë, në teori mund të fshijmë gjithë spam-in dhe fjalët përbuzëse, dhe së bashku me to gjysmën e mesazheve të mira. Nga ana tjetër, nëse mbështetemi vetëm në saktësi, teknologjia më e mirë do të ishte ajo që nuk kap askënd. Prandaj ka edhe një tregues tjetër, plotësinë: përqindja e përmbajtjes së keqe të zbuluar në mesin e gjithë sasisë së përmbajtjes së keqe. Këto dy metrika balancojnë njëra-tjetrën.
Për matjen e saj, ne marrim mostra nga i gjithë fluksi i hyrjes për çdo shërbim dhe ia dorëzojmë përmbajtjet asessorëve për vlerësim ekspert dhe krahasim me vendimet e makinës.
Por ka edhe një tregues tjetër të rëndësishëm.
Më sipër kam shkruar se një mesazh i papranueshëm mund të shihet nga qindra njerëz brenda 5 minutash. Prandaj ne llogarisim se sa herë arritëm të tregojmë përmbajtjen e keqe për para se ta fshijmë atë. Kjo është e rëndësishme, sepse nuk mjafton të punosh mirë - duhet të punosh gjithashtu shpejt. Dhe kur po ndreqnim mbrojtjen nga fjalët përbuzëse, e ndjemë këtë plotësisht.
Antifjalë për shembullin e maceve dhe qenve
Një shpjegim i vogël. Disa mund të thonë se fjalët e pahijshme dhe ofendimet nuk janë aq të rrezikshme sa lidhjet e dëmshme dhe nuk janë aq të bezdisshme si spam. Por ne përpiqemi të mbështesim kushte të rehatshme për bisedë për miliona përdorues, dhe njerëzit nuk pëlqejnë të kthehen atje ku ofendohen. Nuk është rastësi që ndalimi i fjalëve përbuzëse dhe ofendimeve është i përcaktuar në rregullat e shumë komuniteteve, përfshirë dhe Habrin. Por u tërhoqëm.
Fjalorët e fjalëve përbuzëse nuk përballen me gjithë pasurinë e gjuhës ruse. Megjithëse ka vetëm katër rrënjë kryesore të fjalëve përbuzëse, prej tyre mund të krijosh një numër të panumërt fjalësh, që nuk i kap dot me asnjë shprehje të rregullt. Për më tepër, mund të shkruash pjesë të fjalës në transliterim, të zëvendësosh shkronjat me kombinime të ngjashme, të përzjesësh shkronjat, të shtosh yje etj. Disa herë është e pamundur të përcaktosh se çfarë donte të thoshte përdoruesi pa kontekst. Ne respektuam rregullat e Habrës, prandaj do ta demonstrojmë këtë jo me shembuj të vërtetë, por me mace dhe qen.
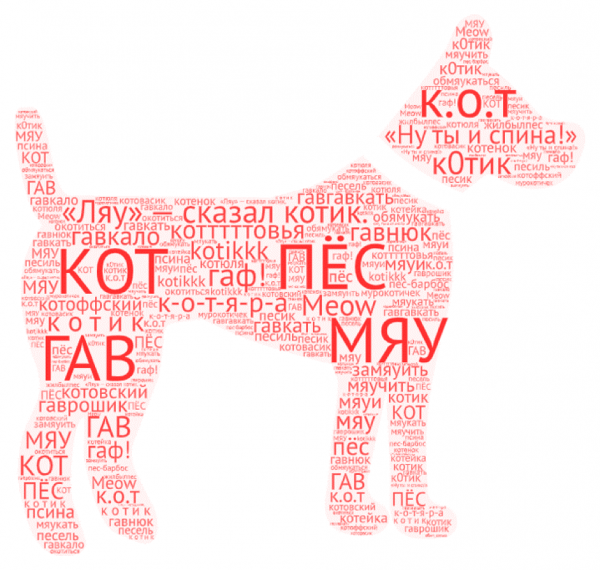
«Miau», - tha macja. Por ne e kuptojmë se macja tha një fjalë tjetër...
Fillojmë të mendojmë për algoritmet e 'përputhjes fuzzy' të fjalorit tonë dhe për një paraprocesim më inteligjent: përgatitëm transliterimin, bashkuam hapësirat dhe pikëzimin, kërkuam modele dhe shkruam shprehje të veçanta për to. Ky qasje dha rezultate, por shpesh ulte saktësinë, duke mos ofruar plotësinë e dëshiruar.
Kështu, ne vendosëm të 'mendojmë si ata që përdorin fjalë të ndaluara'. Filluam të shtojmë zhurmën në të dhëna: rregullojmë shkronjat, gjenerojmë gabime shkrimi, zëvendësojmë shkronjat me ato të ngjashme dhe kështu me radhë. Disa shënime fillestare për këtë morëm duke aplikuar fjalorët e fjalëve të ndaluara në korpus të mëdha teksti. Nëse marrim një fjali dhe e deformojmë në disa mënyra, mund të kemi shumë fjali. Kështu mund të rrisim numrin e mostrave për trajnimin në dhjetëra herë. Ishte e nevojshme vetëm të trajnohej një model më inteligjent, që merr parasysh kontekstin, me pool-in e marzhit të marrë.
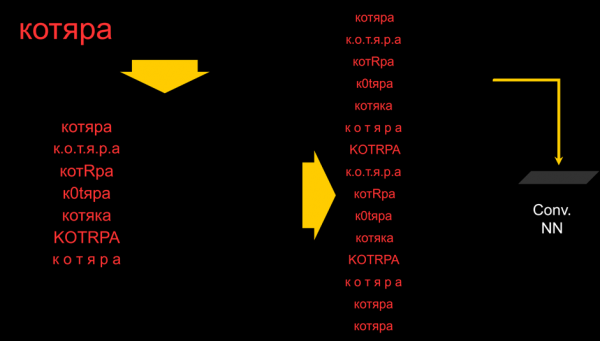
Është akoma herët të flasim për zgjidhjen përfundimtare. Ne ende po eksperimentojmë me qasje të ndryshme për këtë problem, por tashmë po shohim se një rrjet i thjeshtë konvolucional simbolesh nga disa shtresa është dukshëm më i mirë se fjalorët dhe shprehjet e rregullta: mund të rritet si saktësia ashtu edhe plotësia.
Natyrisht, kuptojmë se gjithmonë do të ekzistojnë mënyra për të kapërcyer edhe automatikën më të avancuar, sidomos kur ajo është kaq e emocionuese: të shkruash në një mënyrë që makina e budallaçk është e paaftë ta kuptojë. Këtu, ashtu si në luftën kundër spam-it, qëllimi ynë nuk është të eliminojmë mundësinë për të shkruar ndonjë gjë të pajustifikuar, por të sigurojmë që loja të mos vlejë gjithçka.
Të hapësh mundësinë për të ndarë mendimet e tua, për të komunikuar dhe komentuar — nuk është e vështirë. Më e vështirë është të arrish kushte të sigurta, komode dhe një respekt të ndërsjellë ndaj njerëzve. Dhe pa këtë, nuk do të ketë zhvillim të çdo komuniteti.
Burimi: habr.com
