

Kam publikova në Github .
Kjo është një tabelë thesarësh e thjeshtë për GPU që mund të procesojë qindra milionë futje në sekondë. Në laptopin tim me NVIDIA GTX 1060, kodi fut 64 milion çifte çelës-vlerë të gjeneruara rastësisht për afro 210 ms dhe heq 32 milion çifte për afro 64 ms.
Pra, shpejtësia në laptop është rreth 300 milion futjesh/sec dhe 500 milion heqjesh/sec.
Tabelat janë shkruar në CUDA, megjithatë e njëjta metodologji mund të aplikohet në HLSL ose GLSL. Zbatimi ka disa kufizime që sigurojnë performancë të lartë në kartën grafike:
- Procesohen vetëm çelësa dhe vlera 32-bit.
- Tabela e thesarit ka një madhësi fikse.
- Dhe kjo madhësi duhet të jetë e barabartë me dy në të njëjtin pushtet.
Për çelësat dhe vlerat duhet të rezervoni një ndarës të thjeshtë (në kodin e dhënë është 0xffffffff).
Tabela e thesarit pa bllokada
Tabela e thesarit përdor adresimin e hapur me , kjo do të thotë se është thjesht një varg çiftesh çelës-vlerë që ruhet në kujtesë dhe ka performancë të shkëlqyer të cache-it. Kjo nuk mund të thuhet për lidhjen në zinxhir (chaining), e cila nënkupton të kërkosh një tregues në një listë të lidhur. Tabela e thesarit është një varg i thjeshtë që ruan elementet KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Madhësia e tabelës është një fuqi e dy, jo një numër i thjeshtë, sepse për të aplikuar maskën pow2/AND mjafton një instrukcion i shpejtë, ndërsa operatori i modulit punon ndjeshëm më ngadalë. Kjo është e rëndësishme në rastin e sondimit linear, sepse gjatë kërkimit linear në tabelë indeksi i slotit duhet të mbështjellë në çdo slot. Dhe si rezultat, kostoja e operacionit të modulit shtohet në çdo slot.
Tabela ruan vetëm çelësin dhe vlerën për çdo element, jo thesarin e çelësit. Pasi tabela ruan vetëm çelësat 32-bit, thesarja llogaritet shumë shpejt. Në kodin e dhënë përdoret thesarja Murmur3, e cila kryen vetëm disa lëvizje, XOR dhe shumëzime.
Në tabelën e heshit aplikohet një metodë mbrojtjeje nga bllokimet, e cila nuk varet nga renditja e vendosjes në memorie. Edhe nëse disa operacione shkrimi shkelin renditjen e operacioneve të tjera të tilla, tabela e heshit do të ruajë një gjendje të saktë. Këtë do ta diskutojmë më poshtë. Metoda funksionon shkëlqyeshëm me kartat grafike, ku kryhen konkurrueshëm mijëra rrjedha.
Çelësit dhe vlerat në tabelën e heshit inicializohen si të zbrazëta.
Kodi mund të modifikohet në mënyrë që ai të mund të përpunojë si çelësa ashtu edhe vlera 64-bit. Për çelësat kërkohen operacione atomike të leximit, shkruan dhe krahasimit me shkëmbim (compare-and-swap). Ndërsa për vlerat, kërkohen operacione atomike të leximit dhe shkruan. Fatmirësisht, në CUDA, operacionet e leximit-shkrimit për vlera 32- dhe 64-bit janë atomike sa herë që ato janë të përputhura natyrshëm (shih. ), dhe kartat moderne grafike mbështesin operacione 64-bit atomike të krahasimit me shkëmbim. Sigurisht, kur kalojmë në 64-bit, performanca paksa bie.
Gjendja e tabelës së heshit
Çdo çift çelës-vlerë në tabelën e heshit mund të ketë një nga katër gjendje:
- Çelësi dhe vlera janë të zbrazëta. Në këtë gjendje tabela e heshit inicializohet.
- Çelësi është shkruar, por vlera ende jo. Nëse një rrjedhë tjetër ekzekutimi lexon të dhënat në atë moment, ajo do të kthejë një vlerë të zbrazët. Kjo është normale, e njëjta gjë do të ndodhte nëse një rrjedhë tjetër ekzekutimi do të kishte punuar pak më herët, dhe ne po flasim për një strukturë të dhënash konkurruese.
- Të dy, çelësi dhe vlera, janë shkruar.
- Vlera është në dispozicion për rrjedha të tjera ekzekutimi, ndërsa çelësi ende jo. Kjo mund të ndodhë sepse modeli i programimit në CUDA nënkupton një model të memorie të dobët renditur. Kjo është normale, në çdo rast çelësi është ende i zbrazët, edhe nëse vlera nuk është më e tillë.
Një hollësi e rëndësishme është se sa herë që çelësi është shkruar në slot, ai nuk lëviz më — edhe nëse çelësi do të fshihej, për të cilën do të flasim më poshtë.
Kodi i tabelës së heshit funksionon edhe me modelet e memorie të dobët renditur, ku renditja e leximeve dhe shkruajtjeve në memorie nuk është e njohur. Kur të shqyrtojmë futjen, kërkimin dhe fshirjen në tabelën e heshit, mbani mend se çdo çift çelës-vlerë ndodhet në njërën nga katër gjendjet e përshkruara më sipër.
Futja në tabelën e heshit
Funksioni CUDA, i cili fut çiftet çelës-vlerë në një tabelë hesh, duket si më poshtë:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Për të futur çelësin, kodi iteron përmes tabelës së heshit duke filluar nga hesh-i i çelësit që po futet. Në çdo slot të tabelës kryhet një operacion atomik krahasimi me ndërrim, ku çelësi në këtë slot krahasohet me të zbrazët. Nëse zbulohet një mosmarrëveshje, atëherë çelësi në slot përditësohet me çelësin që po futet, dhe më pas kthehet çelësi origjinal i slot-it. Nëse ky çelës origjinal ishte i zbrazët ose përputhej me çelësin që po futej, atëherë kodi ka gjetur një slot të përshtatshëm për të futur dhe vendos vlerën e futur në slot.
Nëse në një thirrje të bërthamës gpu_hashtable_insert() ka disa elemento me të njëjtin çelës, atëherë çdo njëra nga vlerat e tyre mund të shkruhet në slot-in e çelësit. Kjo konsiderohet normale: një nga operacionet e shkrimit të çelësit-vlerë gjatë thirrjes do të jetë e suksesshme, por duke qenë se gjithçka ndodh paralelisht brenda shumë fijeve ekzekutimi, ne nuk mund të parashikojmë se cili operacion shkrimi në memorie do të jetë i fundit.
Kërkimi në tabelën e heshit
Kodi për kërkimin e çelësave:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Për të gjetur vlerën e çelësit që ruhet në tabelë, ne iteron përmes tabelës duke filluar nga hesh-i i çelësit që po kërkojmë. Në çdo slot kontrollojmë nëse çelësi është ai që po kërkojmë, dhe nëse po, atëherë kthejmë vlerën e tij. Po ashtu kontrollojmë nëse çelësi është i zbrazët, dhe nëse po, atëherë ndërprejmë kërkimin.
Nëse nuk arrijmë të gjejmë çelësin, kodi kthen një vlerë të zbrazët.
Të gjitha këto operacione kërkimi mund të kryhen në mënyrë konkurente gjatë futjeve dhe fshirjeve. Çdo çift në tabelë do të ketë për çdo fijë një nga katër gjendjet e përshkruara më lart.
Fshirja në tabelën e heshit
Kodi për fshirjen e çelësave:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Fshirja e çelësit bëhet në një mënyrë të pazakontë: ne lëmë çelësin në tabelë dhe e shënojmë vlerën e tij (jo vetë çelësin) si të zbrazët. Ky kod është shumë i ngjashëm me lookup(), me përjashtim se kur gjen një përputhje me çelësin, e bën vlerën e tij të zbrazët.
Siç u përmend më lart, një herë që çelësi shkruhet në Slot, ai nuk lëviz më. Edhe kur hiqet një element nga tabela, çelësi mbetet në vend, thjesht vlera e tij bëhet e zbrazët. Kjo do të thotë se nuk na nevojitet të përdorim një operacion atomik për të shkruar vlerën e slotit, sepse nuk ka rëndësi nëse vlera aktuale është e zbrazët apo jo — ajo do të bëhet e zbrazët pavarësisht.
ndryshimi i madhësisë së tabelës hash
Mund të ndryshohet madhësia e tabelës hash duke krijuar një tabelë më të madhe dhe duke futur në të elementet e pacaktuara nga tabela e vjetër. Unë nuk e realizova këtë funksionalitet sepse dëshiroja të mbaja kodin të thjeshtë. Për më tepër, në programet CUDA, alokimi i memories shpesh bëhet në kodin e hostit dhe jo në bërthamën CUDA.
Në artikullin përshkruan se si të modifikoni një strukturë të tillë të dhënash që është e mbrojtur nga bllokimet.
Konkurrenca
Në fragmentet e kodit të sipërpërmendur, funksionet gpu_hashtable_insert(), _lookup() dhe _delete() përpunojnë një çift çelës-vlerë në një kohë. Ndërsa më poshtë gpu_hashtable_insert(), _lookup() dhe _delete() përpunojnë një array çiftësh paralelisht, çdo çift në njëThread të veçantë GPU:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Tabela hash me mbrojtje nga bllokimet mbështet insertimet, kërkimet dhe fshirjet konkurente. Duke qënë se çiftet çelës-vlerë janë gjithmonë në një nga katër gjendjet, dhe çelësat nuk lëvizin, tabela garanton saktësinë edhe kur operacione të ndryshme bëhen në të njëjtën kohë.
Megjithatë, nëse ne përpunojmë paralelisht një grup insertimesh dhe fshirjesh, dhe nëse në arrayn hyrës të çiftëve ka çelësa të dyfishtë, atëherë nuk do të jemi në gjendje të parashikojmë se cilat çifte "do të fitojnë" — do të shkruhen në tabelën hash të fundit. Le të themi se kemi thirrur kodin e insertimit me një array hyrës çiftësh A/0 B/1 A/2 C/3 A/4. Kur kodi përfundon, çiftet B/1 dhe C/3 garantohet se do të jenë të pranishme në tabelë, megjithatë, ndonjëra nga çiftet A/0, A/2 ose A/4Kjo mund të jetë një problem, ose mund të mos jetë - gjithçka varet nga aplikimi. Mund ta dini paraprakisht se në masivin hyrës nuk ka çelësa të dyfishtë, ose mund t'ju mos rëndisë se çfarë vlera u regjistrua e fundit.
Nëse ky është një problem për ju, duhet të ndani çiftet e dyfishta në thirrje të ndryshme CUDA. Në CUDA, çdo operacion me thirrjen e bërthamës përfundon para thirrjes tjetër të bërthamës (të paktën brenda një rrjedhe. Në rrjedha të ndryshme, bërthamat ekzekutohen paralelisht). Në shembullin e mësipërm, nëse thirret një bërthamë me A/0 B/1 A/2 C/3, dhe një tjetër me A/4, atëherë çelësi A do të marrë vlerën 4.
Tani le të flasim për ato funksione lookup() dhe delete() duhet të përdorin një tregues të zakonshëm (plain) ose të ndryshueshëm (volatile) për masivin e çifteve në tabelën e heshit. thotë se:
Kompilatori mund të optimizojë sipas dëshirës operacionet e leximit dhe shkruarjes në memorie globale ose të përbashkët ... Këto optimizime mund të çaktivizohen duke përdorur fjalën kyçe
volatile: ... çdo referencë në këtë variabël përkthehet në një urdhër të vërtetë të leximit ose shkruarjes në memory.
Kushtet e saktësisë nuk kërkojnë përdorimin e volatile. Nëse rrjedha e ekzekutimit përdor një vlerë të ruajtur nga një operacion më herët të leximit, atëherë kjo do të thotë se do të përdorë disa informata pak të vjetra. Por megjithatë, kjo është informacion nga një gjendje e saktë e tabelës së heshit në një moment të caktuar të thirrjes së bërthamës. Nëse keni nevojë të përdorni informacionin më të fundit, mund të përdorni një tregues volatile, por atëherë pak do të zvogëlohet performanca: sipas testeve të mia - gjatë fshirjes së 32 milion elementeve, shpejtësia u ul nga 500 milion fshirjesh/sek në 450 milion fshirjesh/sek.
Performanca
Në testin për inserimin e 64 milion elementeve dhe fshirjen e 32 milion prej tyre, konkurrenca midis std::unordered_map dhe tabelës së heshit për GPU në fakt nuk ekziston:
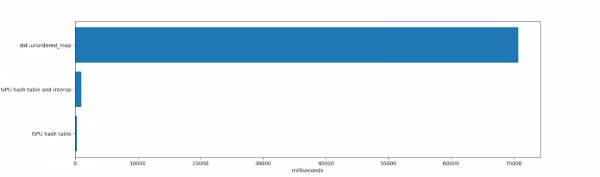
std::unordered_map ka kaluar 70,691 ms për të inseruar dhe fshirë elemente me çlirimin e mëpasshëm unordered_map (çlirimi i miliona elementeve merr shumë kohë, sepse brenda unordered_map kryhen shumë alokime memorie). Sinqerisht, për std:unordered_map kufizime krejtësisht të ndryshme. Kjo është një thread CPU që ekzekuton, mbështet çelësat-vlera të çdo madhësie, punon mirë me koeficiente të larta të përdorimit dhe tregon performancë të qëndrueshme pas shumë fshirjeve.
Kohëzgjatja e punës së hash tabelës për GPU dhe ndërveprimin në mes të proceseve ishte 984 ms. Kjo përfshin kohën e kaluar për vendosjen e tabelës në memorie dhe fshirjen e saj (ndarje unike e 1 GB memorie, e cila në CUDA merr disa kohë), futjen dhe fshirjen e elementeve, si dhe itërimin e tyre. Janë marrë parasysh gjithashtu të gjitha kopjet në memorie dhe nga memorja e kartës grafike.
Puna e vetë hash tabelës zgjati 271 ms. Kjo përfshin kohën e kaluar nga karta grafike për futjen dhe fshirjen e elementeve, dhe nuk përfshin kohën për kopjimin në memorie dhe itërimin e tabelës që rezulton. Nëse tabela GPU jeton gjatë, ose nëse hash tabela mbahet plotësisht në memorien e kartës grafike (për shembull, për të krijuar një hash tabelë që do të përdoret nga një kod tjetër GPU, dhe jo nga procesori qendror), atëherë rezultati i testit është relevant.
Hash tabela për kartën grafike tregon performancë të lartë falë një gjerësie të madhe të bandwidth-it dhe aktivizimit të paralelizmit.
Mangësitë
Arkitektura e hash tabelës ka disa probleme që duhet të mbahen mend:
- Klasifikimi pengon zbulimin lineare, duke bërë që çelësat në tabelë të vendosen shumë larg nga idealja.
- Çelësat nuk fshihen me funksionin
fshijdhe me kalimin e kohës e mbushin tabelën.
Si rezultat, performanca e hash tabelës mund të ulet gradualisht, veçanërisht nëse ajo ekziston për një kohë të gjatë dhe në të kryhen shumë futje dhe fshirje. Një nga mënyrat për të zbutur këto disavantazhe është rifushimi në një tabelë të re me një koeficient përdorimi mjaft të ulët dhe filtrimi i çelësave të fshirë gjatë rifushimit.
Për të ilustruar problemet e përshkruara, po përdor kodin e mësipërm për të krijuar një tabelë me 128 milion elemente, duke futur ciklikisht 4 milion elemente, derisa të mbush 124 milion slot-e (koeficienti i përdorimit rreth 0.96). Këtu është tabele e rezultateve, çdo rresht është një thirrje në CUDA me futjen e 4 milion elementeve të reja në një hash tabelë:
Koeficienti i përdorimit
Koha e futjes 4 194 304 elementeve
0,00
11,608448 ms (361,314798 milion çelësash/sek.)
0,03
11,751424 ms (356,918799 milion çelësh/sek.)
0,06
11,942592 ms (351,205515 milion çelësh/sek.)
0,09
12,081120 ms (347,178429 milion çelësh/sek.)
0,12
12,242560 ms (342,600233 milion çelësh/sek.)
0,16
12,396448 ms (338,347235 milion çelësh/sek.)
0,19
12,533024 ms (334,660176 milion çelësh/sek.)
0,22
12,703328 ms (330,173626 milion çelësh/sek.)
0,25
12,884512 ms (325,530693 milion çelësh/sek.)
0,28
13,033472 ms (321,810182 milion çelësh/sek.)
0,31
13,239296 ms (316,807174 milion çelësh/sek.)
0,34
13,392448 ms (313,184256 milion çelësh/sek.)
0,37
13,624000 ms (307,861434 milion çelësh/sek.)
0,41
13,875520 ms (302,280855 milion çelësh/sek.)
0,44
14,126528 ms (296,909756 milion çelësh/sek.)
0,47
14,399328 ms (291,284699 milion çelësh/sek.)
0,50
14,690304 ms (285,515123 milion çelësh/sek.)
0,53
15,039136 ms (278,892623 milion çelësh/sek.)
0,56
15,478656 ms (270,973402 milion çelësh/sek.)
0,59
15,985664 ms (262,379092 milion çelësh/sek.)
0,62
16,668673 ms (251,627968 milion çelësh/sek.)
0,66
17,587200 ms (238,486174 milion çelësh/sek.)
0,69
18,690048 ms (224,413765 milion çelësh/sek.)
0,72
20,278816 ms (206,831789 milion çelësh/sek.)
0,75
22,545408 ms (186,038058 milion çelësh/sek.)
0,78
26,053312 ms (160,989275 milion çelësh/sek.)
0,81
31,895008 ms (131,503463 milion çelësh/sek.)
0,84
42,103294 ms (99,619378 milion çelësh/sek.)
0,87
61,849056 ms (67,815164 milion çelësh/sek.)
0,90
105,695999 ms (39,682713 milion çelësh/sek.)
0,94
240,204636 ms (17,461378 milion çelësh/sek.)
Në masë të rritjes së koeficientit të përdorimit, performanca ulet. Kjo është e padëshirueshme në shumicën e rasteve. Nëse aplikacioni fut elemente në tabelë dhe pastaj i eliminon ato (p.sh., kur numëron fjalët në një libër), kjo nuk është problem. Por nëse aplikacioni përdor një tabelë heshti me jetëgjatësi të gjatë (p.sh., në një redaktues grafik për të ruajtur pjesët e plota të imazheve kur përdoruesi shpesh fut dhe heq informacion), kjo sjellje mund të jetë e pakëndshme.
Dhe e mat thellësinë e sondimit të tabelës heshte pas 64 milion futjesh (koeficienti i përdorimit 0,5). Thellësia mesatare ishte 0,4774, kështu që shumica e çelësave ishin ose në vendin më të mirë të mundshëm, ose në një slot nga pozita më e mirë. Thellësia maksimale e sondimit ishte 60.
Pastaj mat thellësinë e sondimit në tabelë me 124 milion futje (koeficienti i përdorimit 0,97). Thellësia mesatare tashmë ishte 10,1757, dhe maksimumi ishte 6474 (!!). Performanca e sondimit linear bie ndjeshëm kur koeficientet e përdorimit janë të larta.
Është më mirë të ruani një përdorim të ulët të kësaj hesh-hesh. Por atëherë ne rrisim performancën në kurriz të konsumit të memories. Fatmirësisht, në rastin e çelësave dhe vlerave 32-bit, kjo mund të jetë e justifikueshme. Nëse në shembullin e mësipërm, në tabelën me 128 milion elemente, ruajmë një përdorim prej 0.25, atëherë do të kemi mundësi të vendosim në të maksimumi 32 milion elemente, ndërsa 96 milion slot-e të tjera do të humbasin - nga 8 byte për çdo çift, 768 Mb memorje e humbur.
Kujdes, ky është humbja e memories së kartës grafike, e cila është një burim më i çmuar se memoria sistemike. Edhe pse shumica e kartave grafike moderne për desktop që mbështesin CUDA, kanë të paktën 4 Gb memorie (në momentin e shkruarjes, NVIDIA 2080 Ti ka 11 Gb), akoma humbja e këtyre sasi do të ishte një vendim jo i mençur.
Më vonë do të shkruaj më shumë rreth krijimit të hesh-hesheve për kartat grafike që nuk kanë probleme me thellësinë e sondimit, si dhe rreth mënyrave për të ri-shfrytëzuar slot-et e skaruara.
Maturimi i thellësisë së sondimit
Për të përcaktuar thellësinë e sondimit të një çelësi, ne mund të nxjerrim hesh-heshin e çelësit (indeksi i tij ideal në tabelë) nga indeksi i tij i vërtetë në tabelë:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Për shkak të magjisë së dy numrave binarë në kodin e plotë dhe faktit se kapaciteti i hesh-hesheve është fuqia e dy, ky qasje do të funksionojë edhe kur indeksi i çelësit zhvendoset në fillim të tabelës. Le të marrë një çelës që hesh-heshet në 1, por është vendosur në slotin 3. Atëherë për një tabelë me kapacitet 4 ne do të kemi (3 - 1) & 3, që është ekuivalente me 2.
Përfundim
Nëse keni pyetje ose komente, më shkruani në ose hapni një temë të re në.
Ky kod është shkruar nën frymëzim nga artikujt e mrekullueshëm:
Në të ardhmen do të vazhdoj të shkruaj mbi realizimet e hesh-hesheve për kartat grafike dhe do të analizoj performancën e tyre. Në planet e mia është lidhja në zinxhir, hesh-heshimi i Robin Hood dhe hesh-heshimi i kukullave duke përdorur operacione atomike në struktura të dhënash që janë të përshtatshme për kartat grafike.
Burimi: habr.com
