

Kur proceset e ndërlikuara përpunuese të grupeve të mëdha të të dhënave (ndryshe : importet, konvertimet dhe sinkronizimet me burime të jashtme) shpesh lind nevoja për të «ruajtur» temporalish, dhe për t'i përpunuar shpejt diçka voluminoze.
Një detyrë tipike e këtij lloji zakonisht formulohet kështu: «Ja ku pagesat e fundit të pranuara, duhet t'i ngarkojmë shpejt në sit dhe t'i lidhim me llogaritë»
Por kur vëllimi i këtij «diçka» fillon të matet në qindra megabajt, dhe shërbimi duhet të vazhdojë të funksionojë me bazën në modalitetin 24×7, lindin shumë efekte anësore që do t'ju prishin jetën.
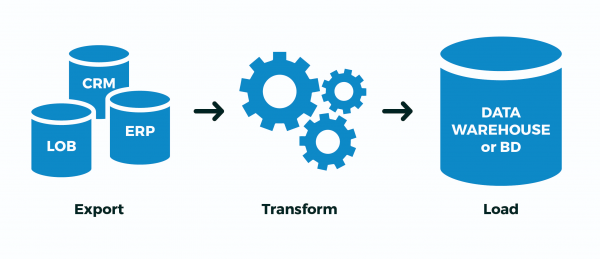
Për t'u përballur me to në PostgreSQL (po ashtu si dhe jo vetëm te ai), mund të përdoren disa mundësi për optimizime që do të lejojnë përpunimin më të shpejtë dhe me një konsum më të ulët të burimeve.
1. Ku të ngarkojmë?
Së pari, le të përcaktojmë se ku mund të ngarkojmë të dhënat që duam të «përpunojmë».
1.1. Tabela të përkohshme (TEMPORARY TABLE)
Në princip, për PostgreSQL të dhënat e përkohshme janë të njëjta si çdo tabelë tjetër. Prandaj, superstitat si «aty gjithë ruhet vetëm në memorie, dhe ajo mund të mbarojë»nuk janë të sakta. Por ka disa dallime të rëndësishme.
Një «emër» të veçantë për çdo lidhje me DB
Nëse dy lidhje përpiqen ndryshe të ekzekutojnë CREATE TABLE x, atëherë ndonjëri patjetër do të marrë gabimin e qëndrueshmërisë objekteve të DB.
Por nëse të dy përpiqen të ekzekutojnë CREATE PËRKOHE TABELA x, atëherë të dy do ta realizojnë normalisht, dhe secili do të marrë një shembujt e tij tabelës. Dhe mezi do të ketë ndonjë lidhje mes tyre.
«Vetë-shkatërrimi» pas disconnection
Kur mbyllet lidhja, të gjitha tabelat e përkohshme fshihen automatikisht, prandaj nuk ka asnjë kuptim të ekzekutoni DROP TABLE x përveç …
Nëse po punoni përmes pgbouncer në mënyrën e transaksionit, atëherë baza vazhdon të besojë se kjo lidhje është ende aktive, dhe se tabela e përkohshme vazhdon të ekzistojë në të.
Prandaj, përpjekja për ta krijuar përsëri, nga një lidhje tjetër me pgbouncer, do të sjellë një gabim. Por kjo mund të anashkalohet duke përdorur KRIJONI TABEL TEMPORARE NËSE NUK EKZISTON x.
Megjithatë, është më mirë të mos bëni kështu, sepse më pas mund të ‘zbulohet papritur’ aty, të dhëna që kanë mbetur nga ‘pronari i mëparshëm’. Në vend të kësaj, është shumë më mirë të lexoni manualin dhe të shihni se kur krijoni tabelën ka mundësinë të shtoni PËR ANGAZHIM DROP — pra atë, kur të mbyllet transaksioni, tabela do të fshihet automatikisht.
Jo-replikimi
Për shkak se i përket vetëm një lidhjeje të caktuar, tabelat përkohshme nuk replikohen. Por kjo nuk kërkon shkruaj të dyfishtë të të dhënave në heap + WAL, prandaj INSERT/UPDATE/DELETE në të është shumë më i shpejtë.
Por, duke qenë se tabela përkohshme është përfundimisht një tabelë "gati normale", atëherë nuk mund të krijohet as në replikë. Të paktën deri tani, ndonëse një patch përkatës është në qarkullim prej kohësh.
1.2. Tabelat e pa-journaluara (UNLOGGED TABLE)
Por çfarë të bëni, për shembull, nëse keni një proces ETL të rëndë, i cili nuk mund të realizohet brenda një transaksioni dhe ju keni pgbouncer në mënyrën e transaksionit?..
Ose fluksi i të dhënave është kaq i madh sa kapaciteti i një lidhjeje me DB (lexo, një proces në CPU) nuk është i mjaftueshëm? ..
Ose disa operacione shkojnë asirinkronisht në lidhje të ndryshme? ..
Këtu ka vetëm një mundësi — të krijoni përkohësisht një tabelë jo-përkohshme. Një lojë fjalësh, po. Domethënë:
- krijova "tabelat" e mia me emra sa më të rastësishëm për të mos u përzier me askënd
- Ekstrakto: i ngarkova ato me të dhëna nga një burim të jashtëm
- Transformo: i përpunova, popullova fushat e lidhjeve çelës
- Ngarko: transferova të dhënat e përgatitura në tabelat e synuara
- fshiva "tabelat" e mia
Tani — një lugë katran. Në thelb, e gjithë regjistrimi në PostgreSQL ndodh dy herë — , pastaj në trupin e tabelave/indeksëve. E gjithë kjo është bërë për të mbështetur ACID dhe për të siguruar dukshmërinë korrekte të të dhënave midis KREJT'transaksioneve të ferra dhe ROLLBACK'transaksioneve të ferra.
Por nuk kemi nevojë për këtë! Të gjithë procesi ose kaloi me sukses plotësisht, ose nuk kaloi. Nuk ka rëndësi sa do të ketë transaksione ndërmjetëse — nuk na intereson "të vazhdojmë procesin nga mesi", sidomos kur nuk dihet ku ishte.
Për këtë qëllim, zhvilluesit e PostgreSQL në versionin 9.1 implementuan një funksion si :
Me këtë njoftim, tabela krijohet si një tabelë e pa-journaluar. Të dhënat që shkruhen në tabelat e pa-journaluara nuk kalojnë përmes regjistrit të para-shkrimit (shih Kapitulli 29), si rezultat, tabelat e tilla punojnë shumë më shpejt se ato normale.Megjithatë, ato nuk janë të mbrojtura nga dështimi; në rast dështimi ose shkëputjeje të papritur të serverit, tabela e pa-journaluar automatikisht fshihet.Për më tepër, përmbajtja e tabelës së pa-journaluar nuk replikohen. në serverë të drejtuar. Çdo indeks që krijohet për një tabelë të pa regjistruar automatikisht bëhet i pa regjistruar.
Në mënyrë më të shkurtër, do të jetë shumë më e shpejtë, por nëse serveri i DB bie - do të jetë e pakëndshme. Por sa shpesh ndodh kjo, dhe a e di procesi juaj ETL ta rregullojë siç duhet "nga mesi" pasi "të ringjallet" DB?..
Nëse nuk është kështu dhe rasti më sipër është i ngjashëm me tuajin - përdorni UNLOGGED, por kurrë mos e aktivizoni këtë atribut në tabelat reale, të dhënat e të cilave ju janë të çmuara.
1.3. ON COMMIT { FSHIJ RRESHTAT | HUMB }
Ky konstrukt lejon të përcaktoni sjelljen automatike gjatë përmbylljes së transaksionit kur krijoni një tabelë.
Për PËR ANGAZHIM DROP Unë tashmë e kam shkruar më lart, ai gjeneron DROP TABLE, por këtu PËR ANGAZHIM Fshij Rreshtat situata është më interesante - këtu gjenerohet TRUNCATE TABLE.
Duke qenë se e gjithë infrastruktura e ruajtjes së meta-përshkrimit të tabelës përkohëshe është krejtësisht e njëjtë me atë të zakonshmes, atëherë krijimi dhe fshirja e tabelave përkohëshe çon në një "shkaktim" të fortë të tabelave sistemike pg_class, pg_attribute, pg_attrdef, pg_depend,…
Tani imagjinoni se keni një punëtor në një lidhje të drejtpërdrejtë me DB, i cili çdo sekondë hap një transaksion të ri, krijon, mbush, përpunon dhe fshin një tabelë përkohëshe… Do të grumbullohet shumë pleh në tabelat sistemike, që do të krijojë vonesa të tepërta në çdo operacion.
Në përgjithësi, mos e bëni kështu! Në këtë rast, është më efektive CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS ta nxirrni jashtë ciklit të transaksioneve - atëherë në fillim të çdo transaksioni të ri tabela do të ekzistojë (shpenzojmë thirrjen CREATE), por do të jetë bosh, falë TRUNCATE (ne gjithashtu e kemi kursyer thirrjen e saj) kur përfundon transaksioni i mëparshëm.
1.4. LIKE… PËR SHFAROSJE…
E përmenda në fillim se një nga rastet tipike të përdorimit për tabelat përkohësh është lloje të ndryshme importesh - dhe zhvilluesi me lodhje kopjon listën e fushave të tabelës objektiv në shpalljen e tabelës së tij përkohëshe…
Por inercia është motor i progresit! Prandaj krijimi i një tabele "sipër" mund të jetë shumë më i lehtë:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Duke qenë se është shumë e mundur të gjeneroni shumë të dhëna në këtë tabelë, kërkimet në të do të bëhen aspak të shpejta. Por për këtë ka një zgjidhje tradicionale - indekset! Dhe, po, edhe tabela përkohëshe mund të ketë indekse.
Duke qenë se shpesh herë, indekset e nevojshme përkojnë me ato të tabelës objektiv, mund të shkruani thjesht SI target_table DHE ME INDICES.
Nëse ju nevojiten gjithashtu DEFAULT-vlera (për shembull, për të plotësuar vlerat e çelësit primar), mund të përdorni SI target_table PËRSHKAK TË TË DËRGUARAVE TË PARACAKTUARA. Ose thjesht — SI target_table Përfshirë të gjitha — do të kopjojë defoltet, indekset, constraint-e,…
Por këtu duhet të kuptoni se nëse keni krijuar tabelën e importit menjëherë me indekse, atëherë do të importohen të dhënat më ngadalë, sesa nëse së pari importoni të gjithë të dhënat, dhe pastaj vendosni indekset — shikoni si e bën .
Në përgjithësi, !
2. Si të shkruani?
Do të them thjesht — përdorni -rrjedhën në vend të "grupit" SHTO, . Madje mund t'i merrni direkt nga një skedar i formuar paraprakisht.
3. Si të përpunoni?
Pra, le të supozojmë se hyrja jonë duket kështu:
- ju keni në bazë një tabelë me të dhënat e klientëve në 1M regjistrime
- çdo ditë klienti ju dërgon një të plotë "imazh"
- sipas përvojës e dini se nga hera në herë ndryshojnë jo më shumë se 10K regjistrime
Një shembull klasik i një situate të tillë është — ka shumë adresa, por në çdo shkarkim javore të ndryshimeve (ndryshime emrash të vendbanimeve, bashkime rrugësh, shfaqje të shtëpive të reja) ka shumë pak edhe në shkallë të tërë vendit.
3.1. Algoritmi i sinkronizimit të plotë
Për thjeshtësi supozojmë se nuk keni nevojë ta restrukturoni të dhënat — thjesht ta sillni tabelën në formën e duhur, pra:
- të fshijë gjithçka që nuk ekziston më
- Opsionet për procesorët «Elbrus» janë të disponueshme me gjithçka që ka qenë, dhe duhet të përditësohet
- shto gjithçka që nuk ka qenë ende
Pse duhet bërë operacionet në këtë rend? Sepse në këtë mënyrë përmasa e tabelës do të rritet minimalisht ().
DELETE FROM dst
Sigurisht, mund të bëni me vetëm dy operacione:
- të fshijë (
FSHI) gjithçka - shto all nga imazhi i ri
Por në këtë rast, falë MVCC, përmasa e tabelës do të rritet pikërisht dyfish! Të merrni +1M imazhe regjistrimesh në tabelë për shkak të përditësimit të 10K — nuk është shumë e mirë për shkak të tepricës…
TRUNCATE dst
Një zhvillues më i experienced e di që të gjithë tabelën mund ta pastroni mjaft lirshëm:
- pastro (
TRUNCATE) të gjithë tabelën - shto all nga imazhi i ri
Metoda është efektive, , por ka një problem… Do të importojmë 1M regjistrime për një kohë të gjatë, kështu që nuk mund të lejojmë tabelën të jetë bosh për gjithë këtë kohë (siç do të ndodhte pa e futur në një transaksion të vetme).
Kështu që:
- na fillon një transaksion të gjatë
TRUNCATEvendos AccessExclusive-bllokimin- ne tregojmë ngadalë futurin, dhe të gjithë të tjerët në këtë kohë nuk mund të
SELECT
Çfarë po ndodh që është e keqe…
ALTER TABLE… RENAME… / DROP TABLE …
Një mundësi është të ngarkohet gjithçka në një tavë të re dhe pastaj thjesht ta rinovoni në vendin e tavës së vjetër. Disa detaje të pakëndshme:
- po ashtu AccessExclusive, edhe pse ndjeshëm më pak në kohë
- do të humbasin të gjithë planet e kërkesave/statistikës së kësaj tavë
- shkelen të gjitha çelësat e jashtëm (FK) për tavën
Ishte një patch WIP nga Simon Riggs, i cili propozoi të bëhej ALTER-operacion për të zëvendësuar trupin e tavës në nivelin e skedarit, pa prekur statistikën dhe FK, por nuk arriti të grumbullojë kuorum.
DELETE, UPDATE, INSERT
Pra, ndalojmë te opsioni jo-bllokues nga tre operacione. Pothuajse tre... Si ta bëjmë më efektivisht?
-- gjithçka bëhet në kuadër të një transaksioni, që askush të mos e shohë "gjendjet e ndërmjetme"
BEGIN;

-- krijojmë një tavë të përkohshme me të dhënat e importuara
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- sipas modelit, së bashku me indekset
) ON COMMIT DROP; -- jashtë transaksionit nuk na duhet

-- shpejt e shpejt ngjitim imazhin e ri përmes COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- fshijmë ato që mungojnë
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- fushat e çelësit primar
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "antijoin"

-- përditësojmë të mbeturit
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- nuk ka qenë e nevojshme të përditësojmë të njëjtat

-- injektojmë ato që mungojnë
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Pastrimi i importit
Në të njëjtin KLADr, të gjitha regjistrimet e ndryshuara duhet të kalojnë gjithashtu përmes pastrimit - normalizimi, identifikimi i fjalëve kyçe, përshtatja në strukturat e nevojshme. Por si të dimë - çfarë saktësisht është ndryshuar, pa e komplikuar kodin e sinkronizimit, në ideale, duke mos e prekur fare?
Nëse qasja për shkrim në momentin e sinkronizimit është vetëm në procesin tuaj, atëherë mund të përdorni një trigger, i cili do të mbledhë të gjitha ndryshimet për ne:
-- tabelat celulare
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabelat me historinë ndryshimesh
CREATE TABLE kladr$log(
  ro kladr, -- këtu ndodhen imazhet e plota të regjistrimeve të vjetra/të reja
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- funksioni i përgjithshëm për regjistrimin e ndryshimeve
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- kontrollojmë nevojën për regjistrimin kur azhurnohet një regjistrim
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- krijojmë një regjistrim logu
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn) VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Tani mund t'i vendosim (ose t'i aktivizojmë nëpërmjet) trigget përpara fillimit të sinkronizimit ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Dhe pastaj mund të nxjerrim qetë të gjitha ndryshimet që na nevojiten nga tabelat log dhe t'i kalojmë përmes përpunuesve të tjerë.
3.3. Importimi i seteve të lidhura
Më sipër kemi shqyrtuar rastet kur struktura e të dhënave të burimit dhe të pranimit përputhen. Por çfarë të bëjmë, nëse eksporti nga sistemi i jashtëm ka një format të ndryshëm nga struktura e ruajtjes në bazën tonë?
Të marrim për shembull ruajtjen e klientëve dhe faturave për ta, një variant klasik "marrëdhënie shumë-në-një":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Ndërkaq, eksporti nga një burim të jashtëm na vjen në formën "gjithçka në një":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Sigurisht, të dhënat për klientët mund të jenë të dyfishta në këtë variant, dhe regjistrimi kryesor është "fatura":
0123456789;Vasja;A-01;2020-03-16;1000.00
9876543210;Petja;A-02;2020-03-16;666.00
0123456789;Vasja;B-03;2020-03-16;9999.00
Për modelin, thjesht do të insertojmë të dhënat tona testuese, por mbajmë mend — COPY më efikase!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasja', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petja', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasja', 'B-03', '2020-03-16', 9999.00);
Së pari, do të ndjekim ato "shkurtimet", për të cilat "faktet" tona iu referohen. Në rastin tonë, faturat iu referohen klientëve:
KRIJONI TABELË TEMPORALE client_import AS
SELECT DISTINCT ON(client_inn)
-- mund të përdorim thjesht SELECT DISTINCT, nëse të dhënat janë pa kundërshtime
  client_inn inn
, client_name "name"
FROM
  invoice_import;
Për të lidhur saktë faturat me ID-të e klientëve, na nevojiten fillimisht këto identifikues ose duhet të gjenerohen. Do të shtojmë fusha për to:
ALTER TABLE invoice_import SHTO COLUMN client_id integer;
ALTER TABLE client_import SHTO COLUMN client_id integer;
Do të përdorim metodën e përmendur më sipër për sinkronizimin e tabelave me një korrigjim të vogël — nuk do të përditësojmë ose fshijmë asgjë në tabelën e destinacionit, sepse importi i klientëve është "append-only":
-- vendosim në tabelën e importit ID-të e regjistrimeve tashmë ekzistuese
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- çelësi unik

-- shtojmë regjistrimet që mungojnë dhe vendosim ID-të e tyre
ME ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id ËSHTË NULL -- nëse ID nuk është vendosur
  KTHE
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- çelësi unik

-- vendosim ID-të e klientëve për regjistrimet e faturave
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- çelësi aplikativ
Në thelb, gjithçka është në invoice_import tani fusha e lidhjes është e mbushur client_id, me të cilin do ta vendosim faturën.
Burimi: habr.com
