

Paketa tidyr është pjesë e bazës së një prej bibliotekeve më të njohura në gjuhën R — tidyverse.
Qëllimi kryesor i paketës është të sjellë të dhënat në një format të rregullt.
Në Habrë tashmë ekziston një artikull i kushtuar kësaj pakete, por i datuar në vitin 2015. Unë dua të flas për ndryshimet më aktuale, të cilat disa ditë më parë i shpalli autori i saj, Hadley Wickham.
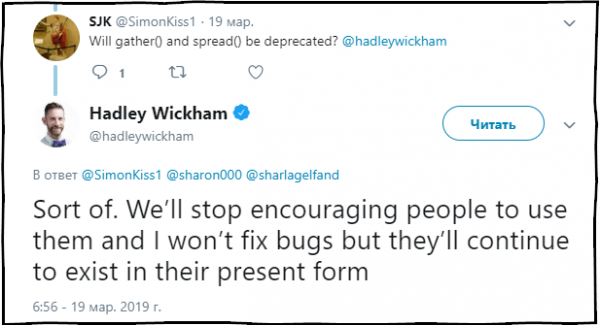
SJK: A do të konsiderohen funksionet gather() dhe spread() të vjetra?
Hadley Wickham: Në një farë mase. Ne do të ndalojmë rekomandimin e përdorimit të këtyre funksioneve dhe do të ndalojmë rregullimet e tyre, por ato do të mbeten në paketë në gjendjen aktuale.
Përmbajtja
Nëse jeni të interesuar për analizën e të dhënave, ndoshta do t'ju interesojnë kanalet e mia në dhe Gati të gjitha përmbajtjet e tyre i kushtohen gjuhës R.
Koncepsioni TidyData
Qëllimi tidyr — për t'ju ndihmuar të sillni të dhënat në atë që quhet format i rregullt. Të dhënat e rregullta janë të dhëna ku:
- Çdo variablë është në një kolonë.
- Çdo vëzhgim është një rresht.
- Çdo vlerë është një qeliza.
Me të dhënat që janë të rregullta është shumë më e lehtë dhe më e përshtatshme të punoni gjatë analizës.
Funksionet kryesore që përfshihen në paketën tidyr
tidyr përmban një grup funksionesh të dedikuara për transformimin e tabelave:
fill()— mbushja e vlerave të humbura në një kolonë me vlerat e mëparshme;separate()— ndan një fushë në disa përmes një ndarësi;unite()— realizon operacionin e bashkimit të disa fushave në një, veprimi i kundërt i funksionitseparate();pivot_longer()— funksioni që transformon të dhënat nga formati i gjerë në të gjatë;pivot_wider()— funksioni që transformon të dhënat nga formati i gjatë në të gjerë. Operacioni i kundërt i asaj që realizon funksionipivot_longer().gather()i vjetër — funksioni që transformon të dhënat nga formati i gjerë në të gjatë;spread()i vjetër — funksioni që transformon të dhënat nga formati i gjatë në të gjerë. Operacioni i kundërt i asaj që realizon funksionigather().
Një koncept i ri për transformimin e të dhënave nga formati i gjerë në të gjatë dhe anasjelltas
Më parë, për këtë lloj transformimi ishin përdorur funksionet gather() dhe spread()Gjatë viteve të ekzistencës së këtyre funksioneve, ka bërë të qartë se për shumicën e përdoruesve, përfshirë autorin e paketës, emrat e këtyre funksioneve dhe argumentet e tyre kanë qenë mjaft të paqarta dhe kanë shkaktuar vështirësi në gjetjen dhe kuptimin e asaj se cili nga këto funksione konverton frame të dhënash nga formati i gjerë në formatin e gjatë dhe anasjelltas.
Për këtë arsye, tidyr janë shtuar dy funksione të reja dhe të rëndësishme të cilat janë të destinuara për transformimin e frame-ve të dhënash.
Funksionet e reja pivot_longer() dhe pivot_wider() janë krijuar nën ndikimin e disa funksioneve nga paketa cdata, krijuar nga John Mount dhe Nina Zumel.
Instalimi i versionit më të fundit të tidyr 0.8.3.9000
Për të instaluar versionin më të ri të paketës tidyr 0.8.3.9000, në të cilën janë të disponueshme funksionet e reja, përdorni kodin në vazhdim.
devtools::install_github("tidyverse/tidyr")
Në momentin e shk writinges së këtij artikulli, këto funksione janë të disponueshme vetëm në versionin dev të paketës në GitHub.
Kalimi në funksione të reja
Në të vërtetë, për të përkthyer skenarët e vjetër për t'i bërë ata të punojnë me funksionet e reja nuk është e vështirë; për një kuptim të mëtejshëm, do të marr një shembull nga dokumentacioni i funksioneve të vjetra dhe do të tregoj si këto operacione kryhen me ndihmën e funksioneve të reja pivot_*() funksioneve.
Transformimi i formatit të gjerë në të gjatë.
Shembulli i kodit nga dokumentacioni i funksionit gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformimi i formatit të gjatë në të gjerë.
Shembulli i kodit nga dokumentacioni i funksionit spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Duke qenë se në shembujt e sipërpërmendur të punës me pivot_longer() dhe pivot_wider(), në tabelën fillestare stocks nuk ka kolona të listuara në argumentet names_to dhe values_to emrat e tyre duhet të jepen në cita.
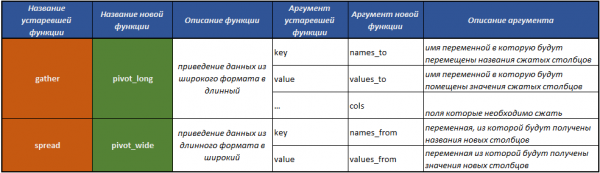
Tabela nëpërmjet së cilës do t'ju jetë më e thjeshtë të kuptoni se si të kaloni në punën me konceptin e ri tidyr.
Shënim nga autori
I gjithë teksti i dhënë më poshtë është një përkthim adaptiv, madje do të thosha një përkthim të lirë nga faqja zyrtare e bibliotekës tidyverse.
Një shembull i thjeshtë i transformimit të të dhënave nga formati i gjerë në të gjatë
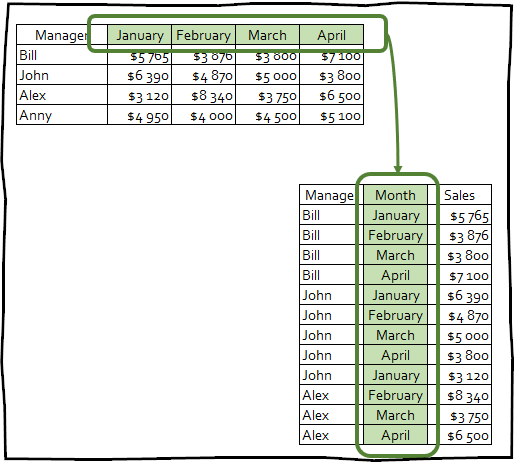
pivot_longer () bën grumbujt e të dhënave të gjatë, duke reduktuar numrin e kolonave dhe duke rritur numrin e rreshtave.
Për të realizuar shembujt e paraqitur në artikull, fillimisht është e nevojshme të ngarkoni paketat e nevojshme:
library(tidyr)
library(dplyr)
library(readr)
Supozoni se kemi një tabelë me rezultatet e një ankete, ku (mes të tjerash) u pyetën njerëzit mbi fenë e tyre dhe të ardhurat vjetore:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Ky tabela përmban të dhëna rreth religjionit të respondentëve në rreshta, ndërsa niveli i të ardhurave është shpërndarë sipas emrave të kolonave. Numri i respondentëve nga çdo kategori ruhet në vlerat e qelizave në ndërprerjen e religjionit dhe nivelit të të ardhurave. Për të sjellë tabelën në një format të rregullt dhe të saktë, mjafton të përdorni pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # Një tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostik 2 Agnostik $10-20k 34
#> 3 Agnostik $20-30k 60
#> 4 Agnostik $30-40k 81
#> 5 Agnostik $40-50k 76
#> 6 Agnostik $50-75k 137
#> 7 Agnostik $75-100k 122
#> 8 Agnostik $100-150k 109
#> 9 Agnostik >150k 84
#> 10 Agnostik Nuk e di/refuzoi 96
#> # … me 170 rreshta të tjeraArgumentet e funksionit pivot_longer()
- Argumenti i parë cols, përshkruan se cilat kolona duhet të bashkohen. Në këtë rast, të gjitha kolonat, përveç time.
- Argumenti names_to shkruan emrin e variablit që do të krijohet nga emrat e kolonave që kemi bashkuar.
- values_to shkruan emrin e variablit që do të krijohet nga të dhënat që ruhen në vlerat e qelizave të kolonave të bashkuara.
Specifikimet
Ky është një funksionalitet i ri i paketës tidyr, i cili më parë gjatë punës me funksionet e vjetra ishte i papërshtatshëm.
Specifikimi është një kornizë të dhënash, çdo rresht i së cilës i përgjigjet një kolone në dataframin e ri të daljes, dhe dy kolona speciale, të cilat fillojnë me:
- .name përmban emrin origjinal të kolonës.
- .value përmban emrin e kolonës, në të cilën do të hyjnë vlerat e qelizave.
Kolonat e tjera të specifikimit pasqyrojnë se si në kolonën e re do të paraqiten emrat e kolonave të shkurtra nga .name.
Specifikimi përshkruan metadatët, të cilat ruhen në emrin e kolonës, me një rresht për çdo kolone dhe një kolonë për çdo variabël të bashkuar me emrin e kolonës. Ndoshta tani kjo përkufizim duket e ngatërruar, por pas shqyrtimit të disa shembujve gjithçka do të bëhet shumë më e qartë.
Kuptimi i specifikimit është që ju mund të nxirrni, modifikoni dhe caktoni metadatë të reja në dataframin që po transformoni.
Për të punuar me specifikimet gjatë transformimit të tabelës nga formati i gjerë në të gjatë shërben funksioni pivot_longer_spec().
Si funksionon ky funksion, ai merr çdo datafram dhe formon metadatët e tij në mënyrën e përshkruar më sipër.
Për shembull, le të marrim setin e të dhënave who, i cili ofrohet së bashku me paketën tidyr. Ky set të dhënash përmban informacionin e ofruar nga organizata ndërkombëtare e shëndetësisë për sëmundshmërinë nga tuberkulozi.
who
# > # A tibble: 7,240 x 60
# >    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
# >        &  &
# >  1 Afghan… AF    AFG    1980          NA           NA           NA
# >  2 Afghan… AF    AFG    1981          NA           NA           NA
# >  3 Afghan… AF    AFG    1982          NA           NA           NA
# >  4 Afghan… AF    AFG    1983          NA           NA           NA
# >  5 Afghan… AF    AFG    1984          NA           NA           NA
# >  6 Afghan… AF    AFG    1985          NA           NA           NA
# >  7 Afghan… AF    AFG    1986          NA           NA           NA
# >  8 Afghan… AF    AFG    1987          NA           NA           NA
# >  9 Afghan… AF    AFG    1988          NA           NA           NA
# > 10 Afghan… AF    AFG    1989          NA           NA           NA
# > # … with 7,230 more rows, and 53 more variables
Do ta ndjekim specifikimin e tij.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsFushat country, iso2, iso3 tani janë variabla. Detyra jonë është të përmbysim kolonat me new_sp_m014 sipër newrel_f65.
Në emrat e këtyre kolonave ndodhet informacioni si vijon:
- Prefiksi
new_tregon se kolona përmban të dhëna mbi rastet e reja të sëmundjes nga tuberkulozi, ku data kuadër aktual përmban informacion vetëm për sëmundjet e reja, prandaj ky prefiks në këtë kontekst nuk ka ngarkesë semantike. sp/rel/sp/epshpjegon metodën e diagnostikimit të sëmundjes.m/fgjinia e pacientit.014/1524/2535/3544/4554/65intervali i moshës së pacientit.
Mund të ndajmë këto kolona duke përdorur funksionin extract(), duke përdorur një shprehje të rregullt.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsVini re, kolona .name duhet të mbetet e pandryshuar, pasi është indeksi ynë në emrat e kolonave të setit të të dhënave origjinal.
Gjinia dhe mosha (kolonat gender dhe age) kanë vlera fikse dhe të njohura, prandaj rekomandohet që këto kolona të konvertohen në faktorë:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Së fundi, për të aplikuar specifikimin që krijuam mbi kuadrin e të dhënave origjinal who na nevojitet të përdorim argumentin spec në funksionin pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
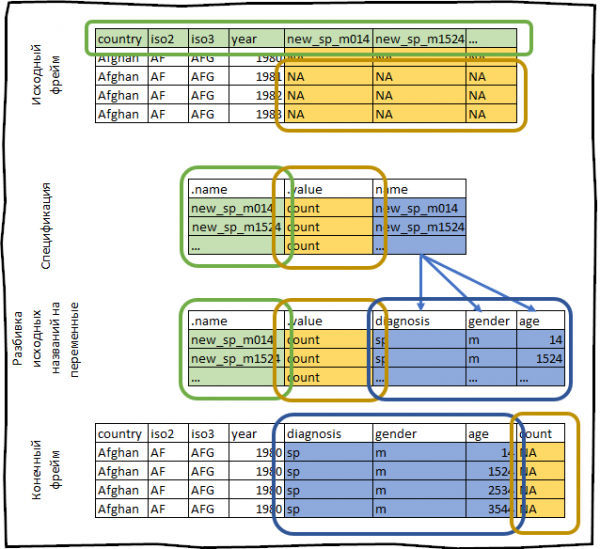
Çdo gjë që sapo bëmë mund të përfaqësohet në mënyrë schematike si në vijim:
Specifikimi me përdorimin e disa vlerave (.value)
Në shembullin e mësipërm, kolona e specifikimit .value përmbante vetëm një vlerë, në shumicën e rasteve kështu ndodh.
Por ndonjëherë mund të ndodhi një situatë kur ju nevojitet të mbledhni në vlera të dhëna nga kolona me lloje të ndryshme të të dhënave. Duke përdorur funksionin e vjetruar spread() do të ishte mjaft e vështirë ta realizonit këtë.
Shembulli më poshtë është marrë nga paketa data.table.
Le ta krijojmë një dataframe trajnimi.
familja <- tibble::tribble(
  ~familja,  ~dob_fëmija1,  ~dob_fëmija2, ~gjinia_fëmija1, ~gjinia_fëmija2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
familja <- familja %>% mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Dataframe i krijuar në çdo rresht përmban të dhëna për fëmijët e një familje. Në familje mund të ketë një ose dy fëmijë. Për secilin fëmijë sigurohen të dhëna mbi datën e lindjes dhe gjininë, ndërsa të dhënat për secilin fëmijë janë në kolona të veçanta, detyra jonë është të sjellim këto të dhëna në formatin e duhur për analizë.
Vini re se kemi dy variabla me informacion mbi secilin fëmijë: gjinia dhe data e lindjes (kolonat me prefiksin dop përmbajnë datën e lindjes, kolonat me prefiksin gender përmbajnë gjininë e fëmijës). Në rezultatin e pritur ato duhet të jenë në kolona të veçanta. Ne mund ta bëjmë këtë duke gjeneruar një specifikim, në të cilin kolona .value do të ketë dy vlera të ndryshme.
spec <- familja %>%
  pivot_longer_spec(-familja) %>%
  separate(col = name, into = c(".value", "fëmija"))%>%
  mutate(fëmija = parse_number(fëmija))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Kështu, le të analizojmë hapat që kryhen nga kodi i mësipërm.
pivot_longer_spec(-familja)— krijojmë një specifikim që comprimion të gjitha kolonat ekzistuese, përveç kolonës familja.separate(col = name, into = c(".value", "fëmija"))— ndajmë kolonën .name, e cila përmban emrat e fushave origjinale, sipas poshtës dhe regjistron vlerat e marra në kolonat .value dhe fëmija.mutate(fëmija = parse_number(fëmija))— konvertojmë vlerat e fushës fëmija nga lloji tekstual në llojin numëror.
Tani ne mund të aplikojmë specifikimin e fituar në dataframe origjinal dhe ta formatojmë tavolinën në mënyrën e dëshiruar.
familja %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Ne përdorim argumentin na.rm = TRUE, sepse forma aktuale e të dhënave detyron krijimin e rreshtave të tepërt për observimet që nuk ekzistojnë. Pasi në familjen 2 ka vetëm një fëmijë, na.rm = TRUE siguron se që familja 2 do të ketë një rresht në dalje.
Transformimi i frame-ve të të dhënave nga formati i gjatë në të gjerë
pivot_wider() — është një transformim i kundërt, dhe përkundrazi rrit numrin e kolonave të kuadrit të të dhënave duke ulur numrin e rreshtave.
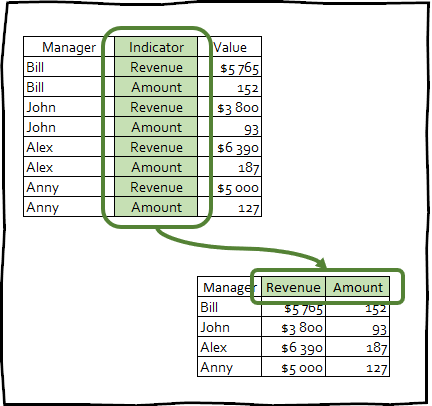
Kjo lloj transformimi përdoret shumë rrallë për të sjellë të dhënat në një pamje të rregullt, megjithatë ky metodë mund të jetë e dobishme për krijimin e tabelave përmbledhëse që përdoren në prezantime, ose për integrimin me ndonjë vegël tjetër.
Në fakt funksionet pivot_longer() dhe pivot_wider() janë simetrike, dhe kryejnë veprime të kundërta, dmth: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) dhe df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) do të rikthejë df origjinal.
Një shembull shumë i thjeshtë i sjelljes së tabelës në një format të gjerë
Për të demonstruar funksionin pivot_wider() ne do të përdorim një grup të dhënash fish_encounters, i cili ruan informacione rreth mënyrave si stacionet e ndryshme regjistrojnë lëvizjen e peshqve në lumë.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
Në shumicën e rasteve, kjo tabelë do të jetë më informuese dhe e lehtë për t'u përdorur nëse paraqesim informacionin për çdo stacion në një kolonë të veçantë.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # Një tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … me 9 rreshta të tjera dhe 1 variabël më shumë: MAW
Ky grup të dhënash regjistron informacione vetëm në rastet kur peshku është zbuluar nga stacioni, dmth. nëse ndonjë peshk nuk është regjistruar nga ndonjë stacion, atëherë ato të dhëna nuk do të jenë në tabelë. Kjo do të thotë se daljet do të jenë të mbushura me NA.
Megjithatë në këtë rast ne e dimë se mungesa e një regjistrimi do të thotë se peshku nuk është vënë re, prandaj mund të përdorim argumentin values_fill në funksionin pivot_wider() dhe të mbushim këto vlera të humbura me zero:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generimi i emrit të kolonës nga disa variabla burimorë
Imagjinoni se kemi një tabelë që përmban një kombinim të produktit, vendit dhe vitit. Për të gjeneruar një kuadër të dhënash testues, mund të ekzekutoni kodin e mëposhtëm:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsDetyra jonë është të zgjasim kuadrin e të dhënave në mënyrë që një kolonë të përmbajë të dhëna për çdo kombinim produkti dhe vendi. Për këtë, mjafton të kaloni në argumentin names_from një vektor që përmban emrat e fushave të bashkuara.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsPo ashtu, mund të aplikoni specifikime në funksionin pivot_wider(). Por kur kaloni në pivot_wider() specifikimi kryen një transformim, të kundërt pivot_longer(): krijohen kolonat që përmenden në .name, duke përdorur vlerat nga .value dhe kolonat e tjera.
Për këtë set të dhënash, mund të gjeneroni një specifikim personalizues, nëse dëshironi që çdo kombinim të mundshëm të vendit dhe produktit të ketë kolonën e vet, e jo vetëm ato që janë të pranishme në të dhëna:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Disa shembuj më të avancuar të punës me konceptin e ri tidyr
Kozhime të dhënash në një format të rregullt me shembullin e një seti të dhënash mbi të ardhurat dhe qiratë në SHBA
Seti i të dhënave us_rent_income përmban informacion mbi të ardhurat mesatare dhe qiranë për çdo shtet në SHBA për vitin 2017 (seti i të dhënave është i disponueshëm në paketën tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … with 94 more rows
Në formën në të cilën ruhen të dhënat në dataset, us_rent_income punimi me to është jashtëzakonisht i vështirë, prandaj do të dëshironim të krijonim një set të dhënash me kolonat: rent, rent_moe, come, income_moe. Ka shumë mënyra për të krijuar këtë specifikim, por e rëndësishme është se na nevojitet të gjenerojmë çdo kombinim të vlerave të variablës dhe estimate/moe, dhe pastaj të gjenerojmë emrin e kolonës.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeOfrimi i kësaj specifikimi pivot_wider() na jep rezultatin që kërkojmë:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Banka Botërore
Ndonjëherë, shndërrimi i një seti të dhënash në formën e duhur kërkon disa hapa.
Dataset world_bank_pop përmban të dhëna nga banka botërore për popullsinë e çdo vendi në periudhën nga viti 2000 deri në vitin 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Qëllimi ynë është të krijojmë një set të dhënash të organizuar, ku çdo variabël ndodhet në një kolonë të veçantë. Deri më tani, nuk është e qartë se cilat hapa të nevojiten saktësisht, por ne do të fillojmë me problemin më të dukshëm: viti është shpërndarë në disa kolona.
Për ta riparuar këtë, është e nevojshme të përdoret funksioni pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsHapi tjetër është të shqyrtojmë variablën indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Ku SP.POP.GROW është rritja e popullsisë, SP.POP.TOTL është numri total i popullsisë, dhe SP.URB. * është e njëjta, por vetëm për zonat urbane. Le të ndajmë këto vlera në dy variabla: area — zona (total ose urban) dhe një variabël që përmban të dhënat e vërteta (population ose growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsTani na mbetet vetëm të ndajmë variablën variable në dy kolona:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsLista e kontakteve
Shembulli i fundit, imagjinoni se keni një listë kontakti që e keni kopjuar dhe ngjitur nga një faqe interneti:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Transformimi i kësaj liste në format tabelar është mjaft i komplikuar, sepse nuk ka një variabël që identifikon se cilat të dhëna i përkasin cilit kontakt. Ne mund ta korrigjojmë këtë duke vënë re se të dhënat për çdo kontakt të ri fillojnë me emrin ("name"), prandaj mund të krijojmë një identifikues unik dhe ta rrisim atë me një çdo herë që në kolonën field hasim vlerën “name”:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Tani që kemi një identifikues unik për çdo kontakt, ne mund të kthejmë fushën dhe vlerën në kolona:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Përfundim
Sipas mendimit tim, koncepti i ri tidyr është me të vërtetë më intuitiv dhe tejkalon ndjeshëm funksionalitetin e funksioneve të vjetra. spread() dhe gather()Shpresoj se ky artikull ju ndihmoi të kuptoni pivot_longer() dhe pivot_wider().
Burimi: habr.com
