

Shën. përkth.: kjo storie e mësimdhënies nga Omio — një grumbullues europian i udhëtimeve — e kalon lexuesin nga teoria bazë në nuancat emocionuese praktike të konfigurimit të Kubernetes. Njohja me raste të tilla ndihmon jo vetëm në zgjerimin e horizontit, por gjithashtu në parandaluar problemet jo triviale.
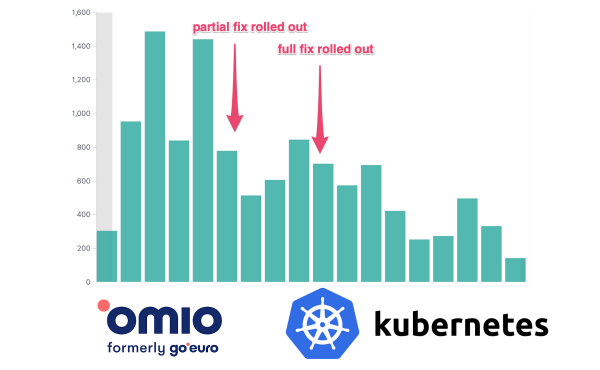
A keni pasur ndonjëherë përvojën që aplikacioni të 'ngjiste' në vend, të ndalte përgjigjen ndaj kërkesave për kontrollin e gjendjes (health checks) dhe nuk e kuptonit arsyen e këtij sjelljeje? Një nga shpjegimet e mundshme lidhet me kufirin e kuotave për burimet e CPU. Kjo do të jetë tema e këtij arti.
TL;DR:
Ne theksojmë fortesë për t'u hequr dorë nga kufijtë e CPU në Kubernetes (ose për të çaktivizuar kuotat CFS në Kubelet), nëse po përdoret një version i bërthamës Linux me gabime në kuotat CFS. Në bërthamë është një gabim serioz dhe që çon në shtrëngime të tepruara dhe vonesa.
Në Omio e gjithë infrastruktura menaxhohet nga Kubernetes. Të gjitha ngarkesat tona stateful dhe stateless punojnë ekskluzivisht në Kubernetes (përdorim Google Kubernetes Engine). Gjatë gjashtë muajve të fundit, kemi vënë re ngadalësime të rastësishme. Aplikacionet ngecin ose ndalojnë së përgjiguri ndaj kontrollëve të gjendjes, humbin lidhjen me rrjetin, etj. Një sjellje e tillë na ka futur në një ngërç për një kohë të gjatë, dhe përfundimisht ne vendosëm të merremi me problemin për një kohë të gjatë.
Përmbledhje e artikullit:
- Disa fjalë rreth kontejnerëve dhe Kubernetes;
- Si janë zbatuar kërkesat dhe kufijtë e CPU;
- Si funksionon kufiri i CPU në ambientet me disa bërthama;
- Si të monitoroni shtrëngimin e CPU;
- Zgjidhja e problemit dhe nuancat.
Disa fjalë rreth kontejnerëve dhe Kubernetes
Kubernetes, në thelb, është standardi modern në botën e infrastrukturës. Detyra e tij kryesore është orkestrimi i kontejnerëve.
Kontenierët
Në të kaluarën, na ka dashur të krijojmë artefakte të tilla si Java JAR'e/WAR'e, Python Egg'e ose skedarë ekzekutivë për t'i filluar më pas në servera. Megjithatë, për t'i bërë ata të funksionojnë, ishte e nevojshme të bëhej punë shtesë: të instalohej ambienti ekzekutiv (Java/Python), të vendoseshin skedarët e nevojshëm në vende të duhura, të sigurohej përputhshmëria me një version të caktuar të sistemit operativ, etj. Në fjalë të tjera, duhej kushtuar vëmendje të madhe menaxhimit të konfigurimeve (çka shpesh shërbente si shkak i mosmarrëveshjeve midis zhvilluesve dhe administratorëve të sistemeve).
Kontejnerët e kanë ndryshuar gjithçka. Tani tani bëhet një imazh kontejneri. Ai mund të paraqitet si një lloj skedari ekzekutiv të zgjeruar, i cili përmban jo vetëm programin, por edhe një mjedis të plotë ekzekutimi (Java/Python/…), si dhe skedarët/paketat e nevojshme, të instaluar paraprakisht dhe gati për tu nisur. Konteinerët mund të vendosen dhe fillohen në servera të ndryshëm pa veprime të tjera shtesë.
Për më tepër, konteinerët funksionojnë në një ambient-kuti të vetin. Ata kanë një adapter të vet virtual të rrjetit, një sistem skedari me qasje të kufizuar, hierarkinë e tyre të proceseve, kufizime për CPU dhe memorie etj. Të gjitha këto realizohen falë një nën-sistemi të veçantë të bërthamës Linux — namespaces (hapësirat e emrave).
Kubernetes
Siç u tha më parë, Kubernetes është orkestruesi i konteinerëve. Ai funksionon kështu: ju i ofroni atij një grup makinash dhe më pas thoni: “Hej, Kubernetes, nis dhjetë kopje të konteinerit tim me 2 procesorë dhe 3 GB memorie për secilin, dhe mbaji ato në gjendje pune!”. Kubernetes merr përsipër gjithçka tjetër. Ai do të gjejë kapacitete të lira, do të nisë konteinerët dhe do t’i ristartojë sipas nevojës, do të nxjerrë përditësime kur të ndryshojnë versionet etj. Në thelb, Kubernetes lejon të disassociosh prej përbërësit harduerik dhe bën që të gjithë diversitetin e sistemeve të jetë të përdorshëm për vendosjen dhe funksionimin e aplikacioneve.
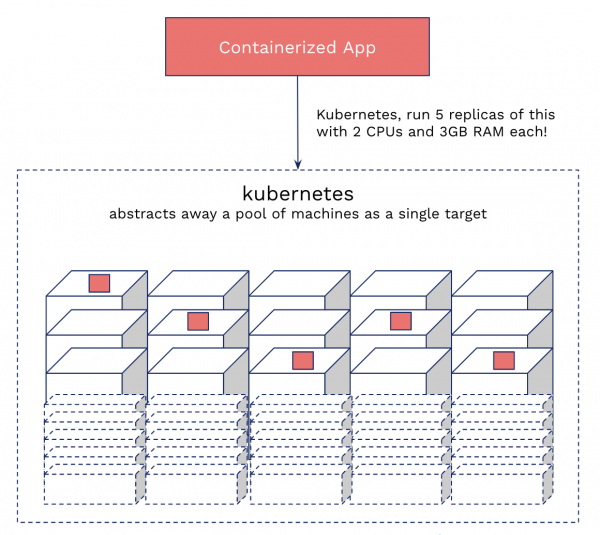
Kubernetes nga pikëpamja e një personi të zakonshëm
Çfarë janë request-at dhe limit-et në Kubernetes
Mirë, ne u morëm vesh me konteinerët dhe Kubernetes. Po ashtu, ne dimë se disa konteinerë mund të jenë në të njëjtën makinë.
Mund të bëhet një analogji me një apartament me shumë dhoma. Merret një ambient i gjerë (makinat/nodet) dhe jepet me qira disa të dhënësve (konteinerëve). Kubernetes vepron si agjenti imobiliar. Lind pyetja, si t'i mbash qiramarrësit të mos konflitkojnë me njëri-tjetrin? Çfarë ndodh nëse njëri prej tyre, le të themi, vendos të zërë banjën për gjysmë dite?
Këtu futen në lojë request-at dhe limit-et. CPU Request është e nevojshme ekskluzivisht për planifikim. Është diçka si një "listë dëshirash" e konteinerit, dhe përdoret për të zgjedhur nodin më të përshtatshëm. Në të njëjtën kohë, CPU Limit mund të krahasohet me një kontratë qiraje — sa herë që ne zgjedhim një nod për konteinerin, ai nuk mund të kalojë kufijtë e vendosur.
Si si realizohen request'ët dhe limit'ët në Kubernetes
Kubernetes përdor një mekanizëm të integruar të throttling (përjashtimi i cikleve) për të implementuar limit'ët e CPU. Nëse aplikacioni kalon limitin, aktivizohet throttling (dmth. merr më pak cikle CPU). Request'ët dhe limit'ët për memorie janë organizuar ndryshe, prandaj janë më të lehtë për t'u zbuluar. Mjafton të kontrolloni statusin e fundit të rinovimit të pod'it: a është ai "OOMKilled". Me throttling-un e CPU, nuk është kaq e thjeshtë, pasi K8s bën të disponueshme vetëm metrikat e përdorimit, e jo për cgroups.
CPU Request
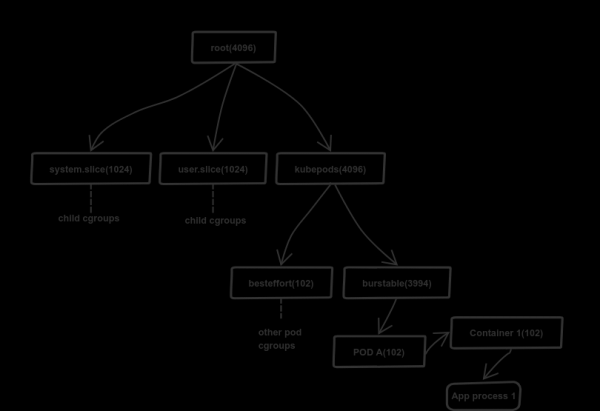
Si është implementuar CPU request
Për thjeshtësi, le të marrim një proces si shembull me një makinë me CPU 4-në.
K8s përdor mekanizmin e grupit të kontrollit (cgroups) për të menaxhuar shpërndarjen e burimeve (memorie dhe procesor). Për të, është e disponueshme një model hierarkik: fëmija trashëgon limit'ët e grupit prind. Detajet e shpërndarjes ruhen në sistemin virtual të skedave (/sys/fs/cgroup). Në rastin e procesorit, kjo është /sys/fs/cgroup/cpu,cpuacct/*.
K8s përdor skedarin cpu.share për shpërndarjen e burimeve të procesorit. Në rastin tonë, grupi kryesor i kontrollit merr 4096 pjesë të burimeve të CPU — 100% e kapacitetit të disponueshëm të procesorit (1 bërthamë = 1024; kjo është një vlerë fixe). Grupi kryesor shpërndan burimet në mënyrë proporcionale në varësi të pjesëve të fëmijëve të tij, të shkruara në cpu.share, dhe ata, nga ana e tyre, veprojnë njësoj me fëmijët e tyre, etj. Në një nyje tipike Kubernetes, grupi kryesor i kontrollit ka tre fëmijë: system.slice, user.slice dhe kubepods. Dy grupet e para përdoren për shpërndarjen e burimeve midis ngarkesave sistemike kritike dhe programeve të përdoruesit jashtë K8s. E fundit — kubepods — krijohet nga Kubernetes për të shpërndarë burimet midis pod'ëve.
Në skemën e mësipërme, shihet se grupet e para dhe të dyta morën nga 1024 pjesë, ndërsa grupit kubepod i janë ndarë 4096 pjesë. Si është e mundur kjo: për shkak se grupit kryesor i janë të disponueshme vetëm 4096 pjesë, ndërsa shuma e pjesëve të fëmijëve të tij tejkalon ndjeshëm këtë numër (6144)? Arsyeja është se vlera ka kuptim logjik, prandaj planifikuesi Linux (CFS) e përdor atë për shpërndarjen proporcionale të burimeve të CPU. Në rastin tonë, dy grupet e para marrin nga 680 pjesë të vërteta (16.6% e 4096), ndërsa kubepod merr pjesët e mbetura 2736 pjesë. Në rastin e papunësisë, grupet e para nuk do të përdorin burimet e ndara.
Fatke, planifikuesi ka një mekanizëm që parandalon humbjen e burimeve të padisponueshme CPU. Ai transferon kapacitetet "në pritje" në një pool global, nga i cili ato shpërndahen në grupe që kanë nevojë për kapacitet shtesë të procesorit (transferimi ndodh në grupe për të shmangur humbjet nga rroundimi). Një metodë e ngjashme aplikohet gjithashtu për të gjitha pasardhësit e pasardhësve.
Ky mekanizëm siguron një shpërndarje të drejtë të kapaciteteve të procesorit dhe siguron që asnjë proces të mos "vjedhë" burime nga të tjerët.
Kufiri i CPU
Megjithëse konfigurimet e limitit dhe kërkesave në K8s duken të ngjashme, realizimi i tyre është radikalisht i ndryshëm: kjo është pjesa më mashtruese dhe më pak e dokumentuar.
K8s angazhon për të realizuar limitet. Konfigurimet e tyre përcaktohen në skedarët cfs_period_us dhe cfs_quota_us në direktorinë cgroup (aty ndodhet gjithashtu skedari cpu.share).
Në dallim nga cpu.share, kuota bazohet në periudhën e kohës, dhe jo në kapacitetin e disponueshëm të procesorit. cfs_period_us përcakton vazhdimësinë e periudhës (epokës) - kjo gjithmonë është 100000 µs (100 ms). Në K8s ka mundësi për të ndryshuar këtë vlerë, megjithatë ajo është deri tani e disponueshme vetëm në versionin alfa. Planifikuesi përdor epokën për të rinisur kuotat e përdorura. Skedari tjetër, cfs_quota_us, përcakton kohën e disponueshme (kuotën) në çdo epokë. Kini mend për atë që gjithashtu jepet në mikrosekonda. Kuota mund të tejkalojë vazhdimësinë e epokës; në fjalë të tjera, ajo mund të jetë më shumë se 100 ms.
Le të shqyrtojmë dy skenarë në makinat me 16 bërthama (tipi më i zakonshëm i kompjuterëve te ne në Omio):
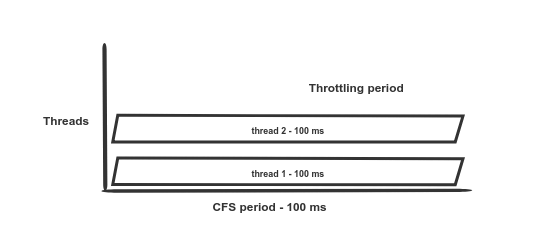
Skenari 1: 2 flukse dhe limit prej 200 ms. Pa trottling.
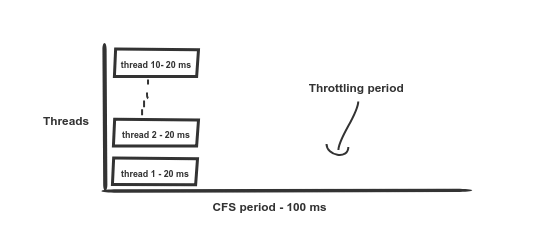
Skenari 2: 10 flukse dhe limit prej 200 ms. Trottling fillon pas 20 ms, aksesin në burimet e CPU rikthehet pas 80 ms.
Supozoni se keni vendosur kufirin e CPU në 2 bërthama; Kubernetes do ta konvertojë këtë vlerë në 200 ms. Kjo do të thotë që kontejneri mund të përdorë maksimumi 200 ms kohë procesori pa trottling.
Dhe këtu fillon argëtimi. Siç u tha më sipër, kuota e disponueshme është 200 ms. Nëse keni 10 flukse që punojnë paralelisht në një makinë me 12 bërthama (shih ilustrimin e skenarit 2), ndërsa të gjithë pod’ët e tjerë janë në pritje, kuota do të shterojë pas vetëm 20 ms (pasi 10 * 20 ms = 200 ms), dhe të gjithë flukset e këtij pod’i do të "ngelin" (trottling) rrjedhje në një makinë me 12 bërthama (shih ilustrimin për skenarin 2), ndërsa të gjithë pod'ët e tjerë janë në pritje, kuota do të ndalet pas vetëm 20 ms (pasi 10 * 20 ms = 200 ms), dhe të gjitha rrjedhjet e këtij pod'i do të "ngjiten" (throttle) për 80 ms të ardhshëm. Situatën e rëndon edhe më shumë, ndryshe nga përmendur , për shkak të cilit ndodh trottlizim i tepruar dhe kontejneri nuk mund të prodhojë as edhe kuotën e vet.
Si ta vlerësojmë trottlizimin në pod’ave?
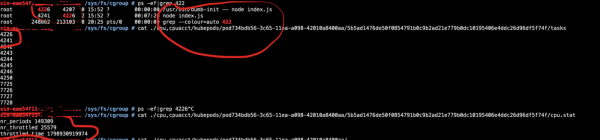
Mjafton të hyni në pod dhe të ekzekutoni cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— numri total i periudhave të planifikuesit; -
nr_throttled— numri i periudhave të trottlizuara në përbërjenr_periods; -
throttled_time— koha e totalizuar e trottlizuar në nanosekonda.
Çfarë po ndodh në të vërtetë?
Si rezultat, ne kemi një trottlizim të lartë në të gjithë aplikacionet. Ndonjëherë është në një e gjysmë herë më e fortë se sa e pritur!
Kjo çon në gabime të ndryshme - dështime të kontrolleve të gatishmërisë (readiness), ngritje të kontejnerëve, ndërprerje të lidhjeve rrjet, kohëzgjatje brenda thirrjeve shërbimore. Në fund, kjo shfaqet si një rritje e vonesave dhe një rritje e numrit të gabimeve.
Zgjidhja dhe pasojat
Këtu është e thjeshtë. Ne u privuam nga kufizimet e CPU-së dhe merremi me përditësimin e bërthamës së OS në klasterët me versionin më të ri, ku u korrigjua bug-u. Numri i gabimeve (HTTP 5xx) në shërbimet tona ra menjëherë ndjeshëm:
Gabimet HTTP 5xx
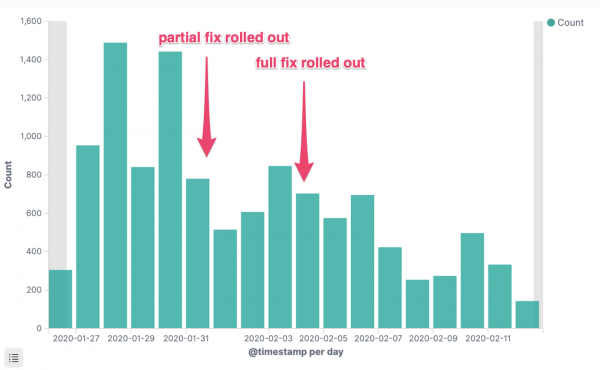
Gabimet HTTP 5xx të një shërbimi kritik
Koha e përgjigjes p95
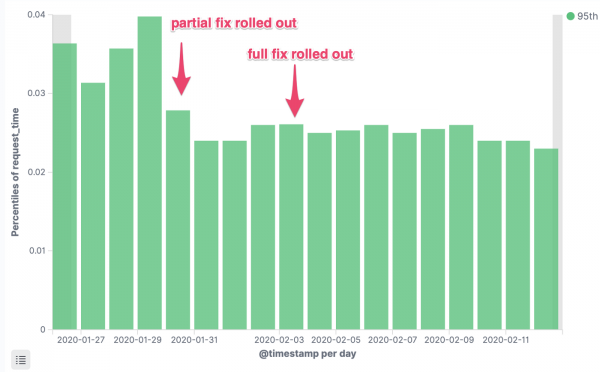
Vonesa e kërkesave të një shërbimi kritik, percentili 95
Shpenzimet operative
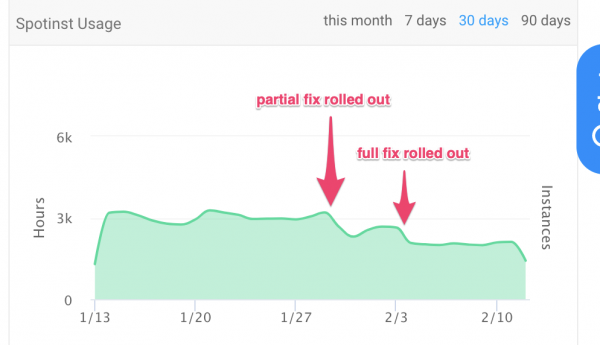
Numri i orëve të shpenzuara për instance
Në çfarë gracke?
Siç u tha në fillim të artikullit:
Mund të bëhet një analogji me një apartament komunal... Kubernetes vepron si agjenti imobiliar. Por si të mbash qiraxhinjtë të mos mëndojnë me njëri-tjetrin? Çfarë nëse njëri prej tyre, le të themi, vendos të zërë banjën për gjysmë dite?
Këtu është gracka. Një kontejner i pakujdesshëm mund të përthithë të gjithë burimet e disponueshme të procesorit në makinë. Nëse keni një grumbull të kujdesshëm aplikacionesh (për shembull, JVM të konfiguruara siç duhet, Go, Node VM), atëherë kjo nuk është një problem: mund të punoni në këto kushte për një kohë të gjatë. Por nëse aplikacionet janë optimizuar keq ose fare nuk janë optimizuar (FROM java:latest), situata mund të dalë jashtë kontrollit. Ne në Omio kemi Dockerfile bazikë të automatizuar me konfigurime të arsyeshme në default për grumbullin e gjuhëve kryesore, prandaj një problem i tillë nuk ka ekzistuar.
Ne rekomandojmë të vëzhgoni metrikat (përdorimi, ngopja dhe gabimet), vonesat e API dhe frekuenca e shfaqjes së gabimeve. Sigurohuni që rezultatet të përputhen me pritshmëritë.
Linket
Kjo është historia jonë. Materialet në vijim ndihmuan shumë për të kuptuar atë që po ndodh:
- ;
- ;
- ;
- ;
- — kërkoni "cpu throttling".
Raportet për gabime të Kubernetes:
- ;
- ;
- .
A keni përjetuar probleme të ngjashme në praktikën tuaj ose keni përvojë që lidhet me trottlimin në mjedise prodhimi të kontejnerizuara? Ndani historinë tuaj në komentet!
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
