

Në sistemet e ndërlikuara ERP shumë entitete kanë natyrë hierarkike, kur objektet homogjene radhiten në një pemë marrëdhëniesh "prind - fëmijë" — kjo është si struktura organizative e një ndërmarrjeje (të gjitha këto degë, departamente dhe grupe punuese), ashtu siç është katalogu i produkteve, fushat e punës, dhe gjeografia e pikave të shitjes,…
Faktikisht, nuk ka asnjë , ku ndonjë hierarki nuk do të shfaqej si rezultat. Por edhe nëse nuk punoni "për biznes", gjithsesi mund të përballeni lehtësisht me lidhje hierarkike. Dhe për të dhënë një shembull, madje edhe pemën tuaj gjenealogjike ose skema katësore e ambienteve në një qendër tregtare — është e njëjta strukturë.
Ekzistojnë shumë mënyra për të ruajtur këtë pemë në një DBMS, por sot do të ndalemi vetëm në një variant:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- mos harroni se FK nuk nënkupton krijimin automatik të indeksit, përndryshe nga PK
Dhe ndërsa ju shqyrtoni thellësinë e hierarkisë, ajo pret me durim për të parë sa efektive do të duken mënyrat tuaja "naive" të punës me këtë strukturë.
Le të analizojmë detyrat tipike që shfaqen, implementimin e tyre në SQL dhe të provojmë të përmirësojmë performancën e tyre.
#1. Насколько глубока кроличья нора?
Le të pranojmë, për saktësi, që kjo strukturë do të reflektojë nënshtrimin e departamenteve në strukturën e organizatës: departamentet, divizionet, sektorët, filialet, grupet e punës,… — si do t’i quani.
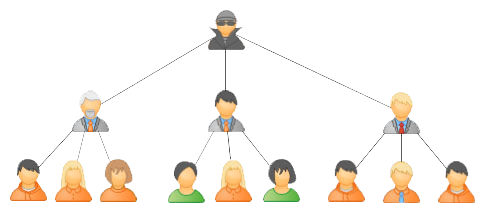
Fillimisht do të krijojmë 'pemën' tonë me 10K elemente
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Të fillojmë me detyrën më të thjeshtë — të gjejmë të gjithë punonjësit që punojnë brenda një sektori të caktuar, ose në terma hierarkike — të gjejmë të gjithë pasardhësit e një nodi. Po ashtu, do të ishte mirë të fitonim edhe "thellësinë" e pasardhësit… Të gjitha këto mund të jenë të nevojshme, për shembull, për të ndërtuar një .
I would be fine if there were only a couple of descendants at a few levels, but when there are more than 5 levels and dozens of descendants — problems can arise. Let's take a look at how traditional methods of searching ‘down the tree’ are written (and work). But first, let's determine which nodes will be the most interesting for our research.
The most ‘deep’ subtrees:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...The most ‘broad’ subtrees:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
For these queries, we used a typical recursive JOIN:
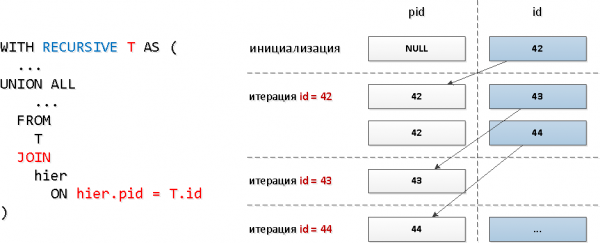
It is evident that with such a model of the query the number of iterations will match the total number of descendants (and there are indeed dozens), and this can occupy quite significant resources, and consequently, time.
Let's check it on the ‘broadest’ subtree:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 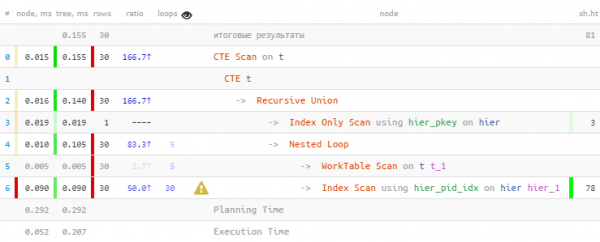
As we expected, we found all 30 records. But we spent 60% of the total time on this — because we also performed 30 index searches. Is there a way to do it faster?
Bulk reading from the index
And do we need to make a separate request to the index for each node? It turns out, no — we can read from the index at once for several keys in one request nëpërmjet = ANY(array).
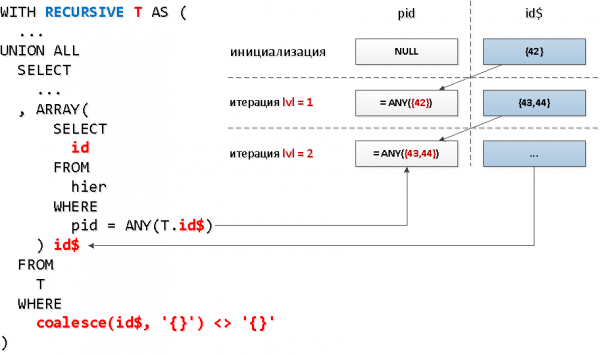
And in each such group of identifiers, we can take all the IDs found in the previous step by ‘nodes’. This means that at each subsequent step, we will be searching for all descendants of a certain level at once..
Only, here lies the problem, in a recursive selection, you cannot refer to itself in a nested query, and we need to somehow select only what was found at the previous level… It turns out that making a nested query to the entire selection is not allowed, but to its specific field — it is possible. And this field can also be an array — which is what we need to use. ÇDO.
It sounds a bit strange, but on the scheme — it's all simple.
ME RECURSIVE T AS (
  SELECT
    ARRAY[id] id$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    ARRAY(
      SELECT
        id
      FROM
        hier
      WHERE
        pid = ANY(T.id$)
    ) id$
  FROM
    T
  WHERE
    coalesce(id$, '{}')  '{}' -- kushtet për daljen nga cikli - array i zbrazët
)
SELECT
  unnest(id$) id
FROM
T; 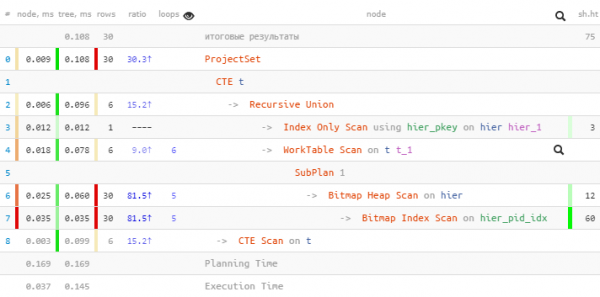
Dhe këtu, më e rëndësishmja nuk është as që fitimi prej 1.5 herë në kohë, por që kemi lexuar më pak buffers, për shkak se kërkesat ndaj indeksit janë gjithsej 5 në vend të 30!
Një bonus shtesë është fakti se pas unnest-it përfundimtar, identifikuesit do të qëndrojnë të renditur sipas "nivelit".
Treguesi i nyjës
Këtu është një konsideratë tjetër që do të ndihmojë për të përmirësuar performancën — në "gjethet" nuk mund të ketë fëmijë, domethënë për ta nuk ka nevojë të kërkojmë "poshtë" fare. Në kuadrin e detyrës sonë, kjo do të thotë se nëse kemi ecur përmes një zinxhiri departamentesh dhe kemi arritur te punonjësi, atëherë më tej për këtë degë nuk ka nevojë të kërkojmë.
Le të shtojmë në tabelën tonë një boolean-fushë, e cila do të na tregojë menjëherë nëse kjo regjistrim konkret në pemën tonë është "nyjë" — domethënë nëse mund të ekzistojnë pasardhës për të gjithashtu.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      hier
    WHERE
      pid = T.id
    LIMIT 1
);
-- Kërkesa u krye me sukses: 3033 rreshta u ndryshuan për 42 ms.
Shumë mirë! Kështu që vetëm pak më shumë se 30% e të gjitha elementeve të pemës kanë pasardhës.
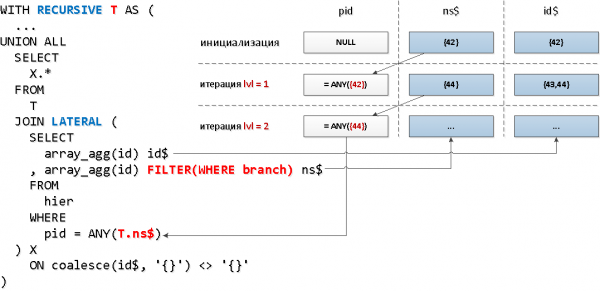
Tani, le të aplikojmë një mekanikë pak më ndryshe — bashkëngjitje me pjesën rekursive përmes LATERAL, duke na lejuar të qasemi menjëherë në fushat e "tabelës" rekursive, dhe funksionin agregat me kushtin e filtrimit sipas treguesit të nyjës do ta përdorim për të reduktuar grupin e çelësave:
ME RECURSIVE T AS (
  SELECT
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    X.*
  FROM
    T
  JOIN LATERAL (
    SELECT
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FROM
      hier
    WHERE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
SELECT
  unnest(id$) id
FROM
T; 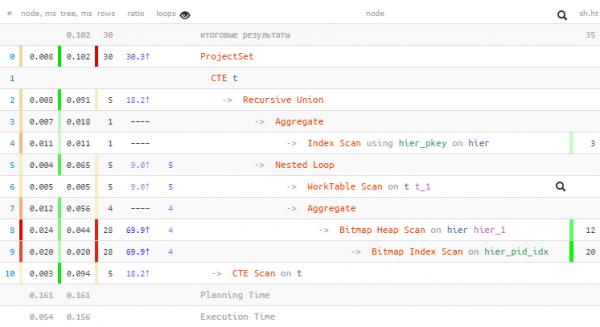
Kemi arritur të reduktojmë një tjetër kërkesë ndaj indeksit dhe fituam më shumë se dy herë sa i përket volumit të lexuar.
#2. Вернемся к корням
Ky algoritëm do të jetë i dobishëm nëse ju nevojitet të mbledhni regjistrime për të gjithë elementët "lart në pemë", duke ruajtur informacionin se cili gjethe burimore (dhe me cilat parametra) e ka sjellë në zgjedhje — për shembull, për formimin e një raporti përmbledhës me agregim në nyjë.
Të tjerat duhen parë ekskluzivisht si një provë koncepti, pasi kërkesa bëhet shumë e ngarkuar. Por nëse ajo dominon në bazën tuaj — vlen të mendoni për përdorimin e metodave të ngjashme.
Le të fillojmë me disa pohime të thjeshta:
- Të njëjtën regjistrim nga baza është më mirë ta lexoni një herë.
- Regjistrimet nga baza është më efikase t'i lexoni "grup", sesa një për një.
Tani do të provojmë të ndërtojmë kërkesën që na nevojitet.
Hapi 1
E dukshme është se në inicializimin e rekursioneve (ku do të shkonim pa të!) na duhet të lexojmë regjistrimet e vetë gjetheve sipas grupit të identifikuesve fillestarë:
WITH RECURSIVE tree AS (
  SELECT
    rec -- ky është regjistrimi i plotë i tabelës
  , id::text chld -- ky është "grupi" i gjetheve fillestare që e sollën këtu
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Nëse dikujt i ka dukur e çuditshme që "grupi" ruhet si një varg dhe jo si një masë, ka një shpjegim të thjeshtë për këtë. Për vargjet ekziston një funksion i integruar agregues "bashkues", string_agg, ndërsa për masat — jo. Megjithatë, nuk është e vështirë ta realizoni vetë .
Hapi 2
të grupohen , duke ruajtur informacionin mbi gjethe të burimit.Por këtu na presin tri probleme të pakëndshme:
"Nënrekursive" pjesa e kërkesës nuk mund të përmbajë funksione agregate me
- Qasja në "tabelën" rekursive nuk mund të jetë në një nën-kërkesë.
GRUPIM NGA. - Kërkesa në pjesën rekursive nuk mund të përmbajë CTE.
- Fatmirësisht, të gjitha këto probleme janë mjaft të lehta për t'u anashkaluar. Le të fillojmë nga fundi.
CTE në pjesën rekursive
funksionon:
Ja kështu jo WITH RECURSIVE tree AS ( ... UNION ALL WITH T (...) SELECT ... )
Dhe kështu — funksionon, shkronjat vendosin!WITH RECURSIVE tree AS ( ... UNION ALL ( WITH T (...) SELECT ... ) )
Kërkesa e përfshirë në "tabelën" rekursiveHmm… Qasja në CTE rekursive nuk mund të jetë në një kërkesë të përfshirë. Por ajo mund të jetë brenda CTE! Dhe kërkesa e përfshirë mund të adresojë tashmë këtë CTE!
GRUPI NGA brenda rekursioneve
E pakëndshme, por… Kemi një mënyrë të thjeshtë për të simuluar GRUPIN NGA me
DISTINCT ON dhe funksione dritare! SELECT (rec).pid id , string_agg(chld::text, ',') chld FROM tree WHERE (rec).pid IS NOT NULL GROUP BY 1 -- nuk funksionon!
Por kështu — funksionon!SELECT DISTINCT ON((rec).pid) (rec).pid id , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld FROM tree WHERE (rec).pid IS NOT NULL
ZGJvbg0KICBTZWN0IERpc3RpbmN0IE9OKHJlYykucGlkDQogICgocmVjKS5waWQgaWQgYXMgc2VjdGlvbl9sYW5nZSwgYEx1bGFyaXRlgWQgY2lyaGp1YWxjanjIHRvcmElDQogIEZST00KICB0cmUUDQo=Kështu, tani e shohim se përse ID numerik u shndërrua në tekst - që të mund të bashkohen me një presje!
Hapi 3
Na ka mbetur vetëm pak për në fund:
- ne shqyrtojmë regjistrimet e "seksioneve" sipas grupit të ID-ve të grumbulluara
- korrigjojmë seksionet e lexuara me "grupet" e fletëve burimore
- "zhvillojmë" vargun-set përmes
unnest(string_to_array(chld, ',')::integer[])
ME REKURSIV TË TREE SI (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    ME prnt SI (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes SI (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 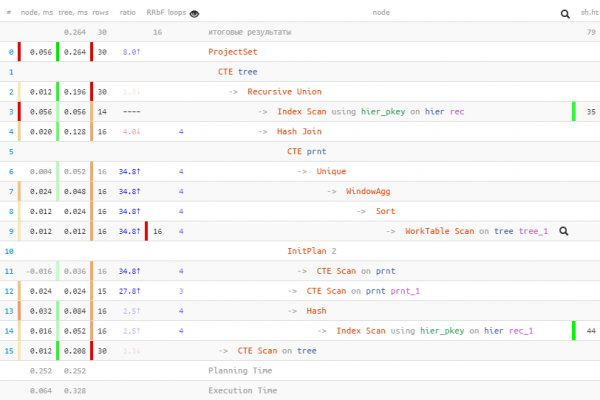
Burimi: habr.com
