

Përshëndetje, kohët e fundit më ra një detyrë interesante për të konfiguruar një depo për backup të një numri të madh të pajisjeve të bllokuara.
Çdo javë ne kryejmë backup të të gjitha makinave virtuale në re, kështu që duhet të jemi në gjendje të menaxhojmë mijëra kopje rezervë dhe ta bëjmë këtë sa më shpejt dhe efikas.
Fatkeqësisht, konfigurimet standarde RAID5, RAID6 në këtë rast nuk do të na përshtaten për shkak se procesi i rikuperimit në disqe kaq të mëdhenj si tonat do të jetë tejet i gjatë dhe ndoshta nuk do të përfundojë kurrë.
Le t'i shqyrtojmë alternativat:
— Një ekuivalent i RAID5, RAID6, por me një nivel pariteti të konfiguroshëm. Në këtë mënyrë, rezervimi nuk bëhet bllok për bllok, por për çdo objekt veçmas. Mënyra më e thjeshtë për të provuar erasure coding është të deploy .
— është një mundësi e papublikuar ende për ZFS. Ndryshe nga RAIDZ, DRAID ka një bllok pariteti të shpërndarë dhe gjatë rikuperimit angazhon të gjitha disqet e grumbullit, duke e bërë këdo të përshtatshëm ndaj dështimeve dhe duke u rikuperuar më shpejt pas një dështimi.
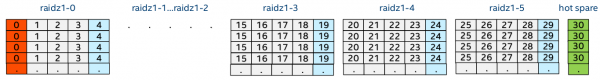
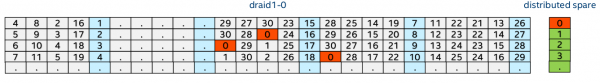
Në dispozicion është një server Fujitsu Primergy RX300 S7 me procesorin Intel Xeon CPU E5-2650L 0 @ 1.80GHz, nëntë module RAM Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), një kabinet diskesh Supermicro SuperChassis 847E26-RJBOD1, i lidhur përmes Dual LSI SAS2X36 Expander dhe 45 disqe Seagate ST6000NM0115-1YZ110 sipër 6TB secili.
Para se të vendosim diçka, duhet së pari të testojmë gjithçka siç duhet.
Për këtë, unë u përgatita dhe kryeva testimin e konfiguracionesh të ndryshme. Për këtë, përdora minio, që shërbeu si S3-backend dhe e nisa atë në mënyra të ndryshme me numra të ndryshëm target.
Kryesisht u testua rasti minio në erasure coding vs software raid me të njëjtin numër disqesh dhe disqe pariteti, ato janë: RAID6, RAIDZ2 dhe DRAID2.
Për referencë: kur aktivizoni minio me një target të vetëm, minio funksionon si një gateway S3 duke ofruar sistemin tuaj të skedarëve lokal në formën e një depo S3. Ndërsa nëse aktivizoni minio me specifikimin e disa targeteve, do të aktivizohet automatikisht mënyra e Erasure Coding, e cila do të shpërndajë të dhënat midis targeteve tuaja duke ofruar qëndrueshmëri ndaj dështimeve.
Në mënyrë default, minio i ndan objektivat në grupe me nga 16 disqe, ku për çdo grup ka 2 paritete. Kjo do të thotë se dy disqe mund të dalin jashtë funksionit në të njëjtën kohë pa humbur të dhënat.
Për testimin e performancës kam përdorur 16 disqe prej 6TB secili dhe kam shkruar mbi ta objekte të vogla me madhësi 1MB, duke përshkruar në mënyrë sa më të saktë ngarkesën tonë të ardhshme, pasi të gjitha mjetet moderne për backup ndajnë të dhënat në blloqe disa megabajtësh dhe i shkruajnë në këtë mënyrë.
Për bënçmarkun u përdor utilitari s3bench i ekzekutuar në një server të largët që dërgonte dhjetëra mijëra objekte të tilla në minio me njëqind rrjedha. Pas kësaj, në të njëjtën mënyrë, përpiqej t'i kërkonte ato përsëri.
Rezultatet e bënçmarkut janë paraqitur në tabelën e mëposhtme:
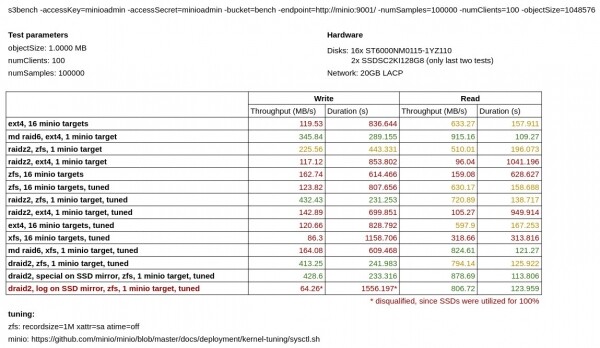
Siç e shohim, minio në modin e kodimit të tij të zerimit punon ndjeshëm më keq në shkruarje sesa minio që është aktivizuar mbi RAID6 programor, RAIDZ2 dhe DRAID2 në të njëjtën konfiguracion.
Veçmas, të testoj minio në ext4 vs XFS. E habitshme, por për llojin tim të ngarkesës, XFS u tregua dukshëm më e ngadaltë se ext4.
Në raundin e parë të testeve, Mdadm tregoi superioritet ndaj ZFS, por më vonë, , se mund të përmirësoj performancën e ZFS duke vendosur opsionet e mëposhtme:
xattr=sa atime=off recordsize=1Mdhe pas kësaj, testet me ZFS u përmirësuan ndjeshëm.
Gjithashtu mund të vërehet se DRAID nuk ofron ndonjë përfitim të veçantë në performancë në krahasim me RAIDZ, por në teori duhet të jetë shumë më i sigurt.
Në dy testet e fundit, gjithashtu u përpoqa të ndaj metadatën (special) dhe ZIL (log) në një ra kyç SSD. Por kalimi i metadatave nuk solli ndonjë përfitim të veçantë në shpejtësinë e shkruarjes, ndërsa me kalimin e ZIL-it, arritëm në plafon me 100% të përdorimit, kështu që këtë test e konsideroj të dështuar. Nuk përjashtoj se po të kisha disqe SSD më të shpejtë, ndoshta kjo do të përmirësonte ndjeshëm rezultatet e mia, por, fatkeqësisht, nuk i kisha në dispozicion.
Në fund, vendosa të ndalem te përdorimi i DRAID dhe pavarësisht statusit të tij beta, ai është zgjidhja më e shpejtë dhe më efektive për ruajtjen në rastin tonë.
Krijova një DRAID2 të thjeshtë në konfigurimin me tre grupe dhe dy sparet të shpërndara:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Mirë, tani që u zgjodh depoja, kalojmë te çfarë do të përdorim për backup. Këtu menjëherë dua të flas për tre zgjidhje që arrita të provoj, dhe ato janë:
— fork , një zgjidhje e specializuar për backup-in e pajisjeve bllok, ka një integrim të ngushtë me Ceph. Mund të nxjerrë differencat midis snapshot-eve dhe të formojë një backup incremental. Mbështet një numër të madh backend-esh ruajtjeje, midis të cilave ka si lokale ashtu edhe S3. Kërkon një bazë të veçantë të dhënash për ruajtjen e tabelës hash të deduplifikimit. Nga disavantazhet: është shkruar në python, ka një cli pak jo të përgjegjshëm.
— fork , një mjet i njohur dhe i provuar për backup, mund të bëjë backup të të dhënave dhe deduplifikon ato shumë mirë. Mund të ruajë backup-et si lokale ashtu edhe në një server të kaluar përmes scp. Mund të bëjë backup të pajisjeve bllok nëse nisi me flamurin --special, nga anët negative: kur krijohet një backup, repository blokon plotësisht, për këtë arsye rekomandohet që për çdo makinë virtuale të krijohet një repository të veçantë, në thelb kjo nuk është një problem, duke qenë se ato krijohen shumë lehtësisht.
— një projekt në zhvillim aktiv, shkruar në go, mjaft i shpejtë dhe mbështet një numër të madh backend-esh për ruajtje, midis të cilave ka magazinim lokal, scp, S3 dhe shumë më tepër. Duhet të theksohet veçanërisht se ka një për restic, i cili lejon eksportimin më të shpejtë të magazinës për përdorim të largët. Nga të gjitha të përmendurat më pëlqeu më shumë. Mund të bëjë backup nga stdin. Praktikisht nuk ka disavantazhe të dukshme, por ka disa veçori:
Së pari, provova ta përdor atë në modalitetin e repository-t të përbashkët për të gjitha makinat virtuale (si Benji) dhe kjo edhe funksionoi mjaft mirë, por operacionet e rikuperimit zgjatën shumë, pasi çdo herë para rikuperimit restic përpiqet të lexojë metadata të të gjithë backup-eve. Ky problem u zgjidh lehtësisht ashtu si me borg, duke krijuar një repository të veçantë për çdo makinë virtuale. Ky qasje u tregua shumë efektive gjithashtu për menaxhimin e backup-eve. Repository-t e veçanta mund të kenë një fjalëkalim të veçantë për qasje në të dhëna, dhe gjithashtu ne mund të mos kemi frikë se repository globale mund të prishet ndonjëherë. Të krijosh repository të rinj është gjithashtu kaq e thjeshtë sa në borg backup.
Në çdo rast, deduplifikimi bëhet vetëm në lidhje me versionin e mëparshëm të kopjes së rezervës, versioni i mëparshëm i kopjes së rezervës përcaktohet nga path për kopjen e specifikuar, prandaj, nëse bëni kopje rezervë të objekteve të ndryshme nga stdin në një depo të përbashkët, mos harroni të specifikoni opsionin
--stdin-filename, ose ta specifikoni çdo herë në mënyrë endèhe--parent.
Së dyti, rikthimi në stdout zë më shumë kohë se rikthimi në sistemin e skedarëve për shkak të paralelësisë së tij. Në të ardhmen, planifikohet të shtohet mbështetje më e ngushtë për kopjet rezervë të pajisjeve bllok.
Së treti, aktualisht rekomandohet të përdorni , sepse versioni 0.9.6 ka një defekt me rikthimin e gjatë të skedarëve të mëdhenj.
Për të testuar efikasitetin e kopjes rezervë dhe shpejtësinë e shkrimit / rikthimit nga kopja rezervë, krijova një depo të veçantë dhe provoja të bëja kopje rezervë të një imazhi të vogël të makinës virtuale (21 GB). U kryen dy kopje rezervë pa ndryshuar origjinalin, duke përdorur secilin nga zgjidhjet e renditura për të testuar se sa më shpejt / më ngadalë kopjohen të dhënat e deduplikuara.
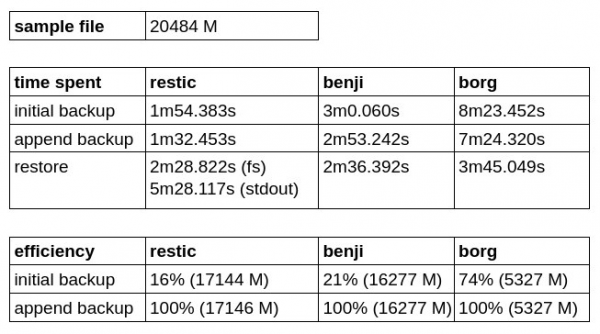
Siç e vërejmë, Borg Backup ka koeficientin më të lartë të efikasitetit për kopjen e parë rezervë, por humbet për sa i përket shpejtësisë së shkrimit dhe rikthimit.
Restic doli të jetë më i shpejtë se Benji Backup, por rikthen më gjatë në stdout, dhe të shkruajë drejtpërdrejt në pajisjen bllok, për fat të keq, deri tani nuk di.
Pas peshoj gjithçka në pro dhe kundra, vendosa të ndalem te restic me rest-server si zgjidhja më e rehatshme dhe e perspektivës për kopje rezervë.
Në këtë skrinj të filmimit mund të shihni si kanali 10-gigabit plotësisht shfrytëzohet në disa operacione të kopjave rezervë që përfundojnë njëkohësisht. Vlen të përmendet se shfrytëzimi i disqeve gjatë kësaj nuk kalon 30%.
Ishte një zgjidhje me të cilën isha më shumë se i kënaqur!
Burimi: habr.com
