

Çfarë do të ndihnit nëse një ditë të bukur vere datacentri me pajisjet tuaja do të dukej kështu?
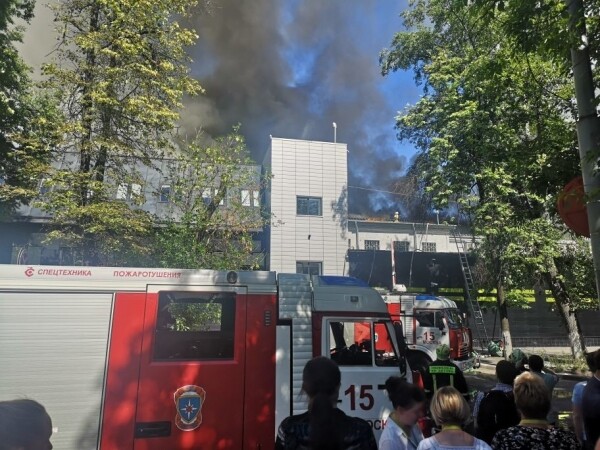
Përshëndetje të gjithëve! Emri im është Dmitrij Samsonov, unë punoj si administrator kryesor i sistemeve në "". Në fotografinë e kësaj fotografie është një nga katër datacentrat ku ndodhen pajisjet që shërbejnë projektin tonë. Pas këtyre murëve ndodhen rreth 4,000 njësi pajisje: serverë, sisteme ruajtjeje të të dhënave, pajisje rrjetesh etj. — gati ⅓ e gjithë pajisjeve tona.
Shumica e serverëve janë me Linux. Ka edhe një duzinë serverësh me Windows (MS SQL) — trashëgimia jonë, nga e cila kemi filluar të heqim dorë gradualisht për shumë vite.
Pra, më 5 qershor 2019, në ora 14:35, inxhinierët e njërit prej datacentrove tona raportuan për një alarm zjarri.
Mohim
14:45. Incidentet e vogla me tym në datacentre ndodhin më shpesh se sa duket. Të dhënat brenda sallave ishin normale, prandaj reagimi ynë i parë ishte relativisht i qetë: vendosëm një ndalesë për punët me prodhimin, që do të thotë çdo ndryshim konfiguracionesh, publikim të versioneve të reja etj., përveç punëve që lidhen me riparimin e ndonjë gjëje.
Nervozizëm
A keni provuar ndonjëherë të pyesni zjarrfikësit, në cilin vend specifik në çati ndodhi zjarri, ose të shkoni vetë në çatin e djegur për të vlerësuar situatën? Sa do të jetë niveli i besimit në informacionin e marrë përmes pesë njerëzve?
14:50. Ka ardhur informacion që zjarri po afrohet deri te sistemi i ftohjes. Por, a do të arrijë? Administrator i sistemit në detyrë po nxjerr trafikun e jashtëm nga frontet e këtij datacentri.
Momentalisht, frontet e të gjithë shërbimeve tona janë të dyfishuara në tre datacentre, me balansim në nivelin DNS, e cila lejon heqjen e adresave të një datacentri nga DNS, duke kështu mbrojtur përdoruesit nga probleme të mundshme me qasjen në shërbime. Në rast se problemet në datacentër tashmë kanë ndodhur, ai automatikisht del nga rotacioni. Më shumë mund të lexoni këtu:
Për ne zjarri nuk ka pasur asnjë ndikim deri tani — as përdoruesit, as pajisjet nuk kanë pësuar. Është një fatkeqësi? Seksioni i parë i dokumentit "Plani i veprimeve në rast fatkeqësie" jep një definicion për konceptin "Fatkeqësi", dhe përfundon seksioni kështu:
«Nëse ka dyshime, është fatkeqësi ose jo, atëherë është fatkeqësi!»
14:53. Emërohet koordinatori i fatkeqësisë.
Koordinatori është personi që kontrollon komunikimin midis të gjithë pjesëmarrësve, vlerëson përmasat e fatkeqësisë, përdor "Planin e veprimeve në rast fatkeqësie", angazhon personelin e nevojshëm, kontrollon përfundimin e riparimit, më e rëndësishmja — delegon çdo detyrë. Në fjalë të tjera, ky është personi që menaxhon të gjithë procesin e likuidimit të fatkeqësisë.
Tregu
15:01. Fillojmë të çaktivizojmë serverat që nuk janë të lidhur me prodhimin.
15:03. Çaktivizojmë në mënyrë të saktë të gjitha shërbimet e rezervuara.
Këtu përfshihen jo vetëm frontet (në të cilat në këtë moment përdoruesit nuk hyjnë më) dhe shërbimet e tyre ndihmëse (logjika e biznesit, cache etj.), por edhe bazat e ndryshme të të dhënave me faktor replikimi 2 dhe më shumë (, , , etj.).
15:06. Më ka ardhur informacioni se zjarri i kërcënon një nga sallat e qendrës së të dhënave. Në këtë sallë nuk kemi pajisje, por fakti që zjarri mund të kalojë nga çatia në salla, ndryshon ndjeshëm situatën.
(Më vonë doli se nuk kishte rrezik fizik për sallën, pasi ajo ishte e izoluar hermetikisht nga çatia. Rreziku ishte vetëm për sistemin e ftohjes së kësaj salle.)
15:07. Lejojmë ekzekutimin e komandave në servera në mënyrë të përshpejtuar pa kontrollime shtesë ().
15:08. Temperatura në salla është brenda normës.
15:12. Është regjistruar një rritje e temperaturës në salla.
15:13. Më shumë se gjysma e serverave në qendrën e të dhënave janë çaktivizuar. Po vazhdojmë.
15:16. Është marrë vendimi për të çaktivizuar të gjithë pajisjet.
15:21. Fillojmë të çaktivizojmë energjinë në serverat stateless pa çaktivizimin e saktë të aplikacionit dhe operativit.
15:23. Përcaktohet një grup përgjegjësish për MS SQL (janë të pakët, varësia e shërbimeve ndaj tyre nuk është e madhe, por procedura e rikthimit të funksionalitetit zgjat më shumë kohë dhe është më e komplikuar se, për shembull, ajo e Cassandra).
Depresioni
15:25. Më ka ardhur informacioni për çaktivizimin e energjisë në katër salla nga 16 (Nr. 6, 7, 8, 9). Në sallat 7 dhe 8 ndodhet pajisja jonë. Nuk ka ende informacion rreth dy sallave tona (nr. 1 dhe 3).
Në përgjithësi, kur ndodhin zjarre, energjia elektrike ndërpritet menjëherë, por në këtë rast, falë punës së koordinuar të zjarrfikësve dhe stafit teknik të qendrës së të dhënave, ajo nuk u fik në çdo vend dhe menjëherë, por sipas nevojës.
(Më vonë u zbulua se energjia në sallat 8 dhe 9 nuk u ndërpre.)
15:28. Fillojmë të rikthejmë bazat MS SQL nga backup-et në qendrat e tjera të të dhënave.
Sa kohë do të kërkohet për këtë? A mjafton kapaciteti i rrjetit në tërë itinerarin?
15:37. Është regjistruar ndërprerja e disa pjesëve të rrjetit.
Menaxhimi dhe rrjeti i prodhimit janë fizikisht të izoluar nga njëri-tjetri. Nëse rrjeti i prodhimit është i aksesueshëm, atëherë mund të hyni në server, të ndaloni aplikacionin dhe të fikni sistemin operativ. Nëse nuk është i aksesueshëm, atëherë mund të hysh përmes IPMI, të ndalosh aplikacionin dhe të fikësh sistemin operativ. Nëse nuk ka asnjë nga rrjetet, nuk mund të bëni asgjë. 'Faleminderit, kapiten!', do të mendoni.
'Po ashtu, si duket, ka shumë zhurmë', ndoshta do të mendoni.
E gjithë çështja është se serverët, edhe pa zjarr, gjenerojnë një sasi të madhe heat. Saktësisht, kur ka ftohje, ata gjenerojnë nxehtësi, dhe kur nuk ka, ata krijojnë një ferr të tmerrshëm, i cili në rastin më të mirë do të shkrijë një pjesë të pajisjeve dhe do të fikë një pjesë tjetër, por në rastin më të keq… do të shkaktojë një zjarr brenda sallës, i cili praktikisht garanton shkatërrimin e gjithçkaje.
15:39. Regjistrojmë probleme me bazën conf.
Baza conf është backend për shërbimin e njëjtë, i cili përdoret nga të gjitha aplikacionet e prodhimit për ndryshimin e shpejtë të konfigurimeve. Pa këtë bazë ne nuk mund të menaxhojmë funksionimin e portalit, por portali mund të funksionojë gjithsesi.
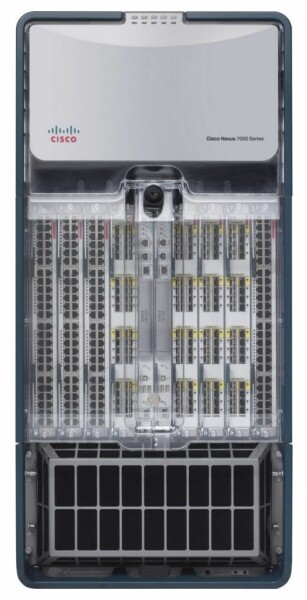
15:41. Sensorët e temperaturës në pajisjet thelbësore të rrjetit regjistrojnë lexime të afërta me ata të lejuar. Ky është një kuti që zë një raft dhe siguron funksionimin e të gjithë rrjeteve brenda qendrës së të dhënave.
15:42. Issue tracker dhe wiki nuk janë të aksesueshme, kalojmë në standby.
Kjo nuk është prodhim, por në rast emergjence aksesueshmëria e çdo baze njohurish mund të jetë kritike.
15:50. Një nga sistemet e monitorimit u ndal.
Ata janë disa, dhe ata mbulojnë aspekte të ndryshme të funksionimit të shërbimeve. Disa prej tyre janë të configuruar për të punuar autonomisht brenda çdo qendre të të dhënave (do të thotë se monitorojnë vetëm qendrën e tyre të të dhënave), ndërsa të tjerët përbëhen nga komponente të shpërndara, që pësojnë transparencë në rast humbjeje të ndonjë qendre të të dhënave.
Në këtë rast, ka pushuar së funksionuari , i cili operon në modin master-standby. Kaluam në standby.
Pranimi
15:51. Përdorëm IPMI për të fikur të gjithë serverat pa përfundim të duhur, përveç MS SQL.
A jeni të gatshëm për menaxhimin masiv të serverëve përmes IPMI në raste nevoje?
Ky është momenti ku shpëtimi i pajisjeve në qendrën e të dhënave në këtë fazë është përfunduar. Çfarë mund të bëhej është bërë. Disa kolegë mund të pushojnë.
16:13. Kemi marrë informacion se tubat e freonit nga kondicionerët në çati janë thyer - kjo do ta vonojë hapjen e qendrës së të dhënave pas eliminimit të zjarrit.
16:19. Sipas të dhënave të marra nga stafi teknik i qendrës së të dhënave, ndalimi i rritjes së temperaturës në sallat ka ndodhur.
17:10. Rindërtuam funksionimin e bazës conf. Tani mund të ndryshojmë konfigurimet e aplikacioneve.
Pse është kaq e rëndësishme, nëse gjithçka është e vijueshme dhe punon edhe pa një qendër të dhënash?
Së pari, jo gjithçka është e vijueshme. Ka shërbime të ndryshme dytësore që për momentin nuk përballojnë mjaft mirë dështimin e qendrës së të dhënave, dhe ka baza në modin master-standby. Mundësia për të menaxhuar konfigurimet lejon që të bëhet çdo gjë e nevojshme për të minimizuar ndikimin e pasojave të aksidenteve në përdorues edhe në kushte të vështira.
Së dyti, bëhet e qartë se në orët e ardhshme puna e qendrës së të dhënave nuk do të rikthehet plotësisht, ndaj ishte e nevojshme të merreshin masa që mosshpërndarja afatgjate e kopjeve të sillte probleme të tjera si mbushja e disqeve në qendrat e mbetura të të dhënave.
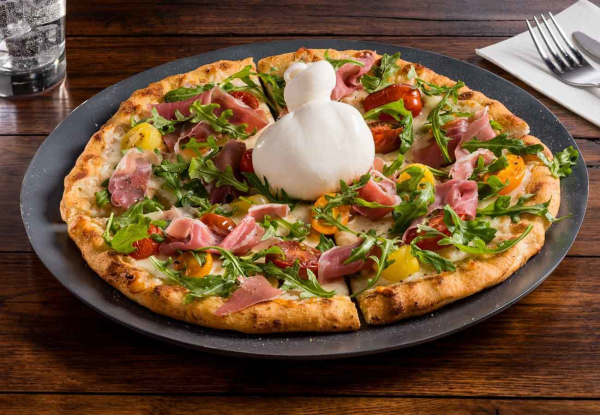
17:29. Është koha për picë! Ne kemi njerëz që punojnë, jo robotë.
Rehabilitimi
18:02. Në sallat №№8 (tona), 9, 10 dhe 11 temperatura u stabilizua. Në njërën nga sallat që mbeten të fikura (№7), ndodhet pajisja jonë, dhe temperatura atje vazhdon të rritet.
18:31. Dhënë lejen për të ndezur pajisjet në sallat №№1 dhe 3 - këto sallat nuk u prekën nga zjarri.
Aktualisht po bëhet nisja e serverëve në sallat №№1, 3, 8, duke filluar nga më të kritikuarit. Po kontrollohet saktësia e funksionimit të të gjitha shërbimeve të nisura. Ende ka probleme me sallën №7.
18:44. Personeli teknik i qendrës së të dhënave zbuloi se në sallën №7 (ku është vetëm pajisja jonë) shumë serverë nuk janë fikur. Sipas të dhënave tona, aty mbeten të ndezur 26 serverë. Pas një kontrolli të përsëritur zbulojmë 58 serverë.
20:18. Personeli teknik i qendrës së të dhënave po ajros sallën pa kondicionerë përmes kanaleve mobile të ajrit, të vendosura përmes korridoreve.
23:08. Lëshuam adminin e parë për në shtëpi. Disa duhet të flenë gjatë natës, që nesër të vazhdojmë punët. Më pas, lëshojmë edhe një pjesë të adminëve dhe zhvilluesve.
02:56. Aktivizuam gjithçka që mund të aktivizohej. Po bëjmë një kontroll të madh të të gjitha shërbimeve me teste të automatizuara.
03:02. Kondicionimi në sallën e fundit, №7, është rikthyer.
03:36. Vendosëm frontet në qendrën e të dhënave në rotacion në DNS. Nga ky moment fillon të arrijë trafiku i përdoruesve.
Po lëshojmë pjesën më të madhe të ekipit të administratorëve për në shtëpi. Por disa persona i lëmë.
Një FAQ i vogël:
Q: Çfarë ndodhi nga 18:31 deri në 02:56?
A: Duke ndjekur "Planin e Veprimit në Rast të Aksidentit", ne aktivizojmë të gjitha shërbimet, duke filluar nga më të rëndësishmet. Në këtë rast, koordinatori në bisedë i jep shërbimin administratorit të lirë, i cili kontrollon nëse janë nisur OS dhe aplikacioni, a ka ndonjë gabim, a janë treguesit në rregull. Pas përfundimit të aktivizimit, ai njofton në bisedë se është i lirë dhe merr nga koordinatori një shërbim të ri.
Procesi ngadalësohet gjithashtu nga hardueri i dështuar. Edhe nëse ndalimi i OS dhe fikja e serverëve kalojnë siç duhet, disa serverë nuk kthehen për shkak të disqeve, memories, shasisë që dështojnë papritur. Në rast të humbjes së energjisë elektrike, përqindja e dështimeve rritet.
Q: Pse nuk mund ta aktivizoni gjithçka njëherësh dhe pastaj të riparoni atë që del në monitorim?
A: Çdo gjë duhet bërë gradualisht, sepse ka varësi midis shërbimeve. Dhe duhet kontrolluar gjithçka menjëherë, pa pritur monitorimin — sepse është më mirë të zgjidhen problemet menjëherë, pa pritur që ato të përkeqësohen.
7:40. Administratori i fundit (koordinatori) u shkua për të fjetur. Punët e ditës së parë përfundojnë.
8:09. Inxhinierët e parë dhe administratorët në qendrat e të dhënave (përfshirë koordinatorin e ri) filluan punën për rikuperim.
09:37. Filluam ngërçin e sallës №7 (salla e fundit).
Paralelisht vazhdojmë të rikuperojmë atë që nuk e përfunduam në sallat e tjera: zëvendësimin e disqeve/memories/serveryve, riparimin e gjithçkaje që "digjet" në monitorim, rikthimin e roleve në skemat master-standby dhe ndihma me gjëra të tjera, që megjithatë janë mjaft.
17:08. Lejojmë të gjitha punimet standarde me prodhimin.
21:45. Punët e ditës së dytë përfunduan.
09:45. Sot është e premte. Në monitorim ende ka shumë probleme të vogla. Të shtunën po afrohet, të gjithë duan të pushojnë. Vazhdoni të riparoni masivisht gjithçka që është e mundur. Detyrat standarde të administratorëve që mund të ishin shtyrë janë shtyrë. Koordinatori është i ri.
15:40. Papritmas, gjysma e stackut të pajisjeve rrjetore në një qendër tjetër të të dhënave u ristartua. Nxorrëm përjashtim nga rotacioni për minimizimin e riskut. Nuk kishte ndonjë efekt për përdoruesit. Më vonë u zbulua se kjo ishte një çështje e shasisë. Koordinatori po punon me riparimin e dy emergjencave.
17:17. Funksionimi i rrjetit në qendrën tjetër të të dhënave është rikthyer, gjithçka është kontrolluar. Qendra e të dhënave është futur në rotacion.
18:29. Punët e ditës së tretë dhe në përgjithësi rikuperimi pas emergjencës janë përfunduar.
Pasthënie
04.04.2013. , "Odnoklassniki" — për tre ditë portali ishte totalisht apo pjesërisht i papërshtatshëm. Gjatë gjithë kësaj kohe, më shumë se 100 persona nga qytete të ndryshme, nga kompani të ndryshme (edhe njëherë faleminderit shumë!), riparuan mijëra servera, në distancë dhe drejtpërdrejt në qendrat e të dhënave, në mënyrë manuale dhe automatike.
Ne kemi nxjerrë përfundime. Që të mos ndodhi përsëri diçka e tillë, ne kemi realizuar dhe vazhdojmë të realizojmë deri më sot punë të gjera.
Cilat janë dallimet kryesore midis kësaj emergjence dhe asaj 404?
- Ne kemi krijuar "Planin e veprimit në raste emergjence". Çdo tremujor zhvillojmë stërvitje — simulojmë një situatë emergjente, që grupi i administratorëve (të gjithë me radhë) duhet të zgjidhë duke përdorur "Planin e veprimit në raste emergjence". Administratorët kryesorë sistematikisht stërviten në rolin e koordinatorit.
- Në mënyrë të përkohshme, çdo tremujor izolojmë qendrat e të dhënave (të gjithë me radhë) në rrjetin LAN dhe WAN, që lejon identifikimin e pikave të dobëta në kohën e duhur.
- Më pak disqe të prishura, sepse e kemi rritur standardin: më pak orë funksionimi, vlerësime më të rrepta për S.M.A.R.T.
- Kemi hequr dorë plotësisht nga BerkeleyDB - një bazë të dhënash të vjetër dhe të paqëndrueshme, që kërkonte shumë kohë për t'u rikuperuar pas rinisjes së serverit.
- Kemi reduktuar numrin e serverëve me MS SQL dhe kemi ulur varësinë nga ata që kanë mbetur.
- Ne kemi krijuar cloud-in tonë , në të cilin tashmë për dy vjet po migrojmë aktivisht të gjitha shërbimet. Cloud-i thjeshton ndjeshëm gjithë ciklin e punës me aplikacionin dhe në rast të emergjencës ofron mjete unike si:
- ndalimi i saktë i të gjitha aplikacioneve me një klik;
- migrimi i lehtë i aplikacioneve nga serverët problematikë;
- nisja automatike e ranguar (në rend të prioritetit të shërbimeve) të gjithë qendrës të dhënash.
Emergjenca e përshkruar në këtë artikull ishte më e madhe që nga 404-ta. Sigurisht, nuk shkoi gjithçka kështu për një soje. Për shembull, gjatë papërkrahshmërisë së qendrës së të dhënave të djegur, në një qendër tjetër të dhënash një disk në një nga serverët dështoi, duke lënë të disponueshme vetëm një nga tri kopjet në klasterin Cassandra, çka bëri që 4,2% e përdoruesve të aplikacioneve mobile të mos mund të hynin. Ndërkohë, përdoruesit e lidhur vazhduan të punonin. Në total, si rezultat i emergjencës, u identifikuan më shumë se 30 probleme - nga defekte të zakonshme deri te mangësitë e arkitekturës së shërbimeve.
Por dallimi më i rëndësishëm i emergjencës aktuale nga 404-ta është se ndërsa po zgjidhnim pasojat e fatkeqësisë, përdoruesit vazhdonin të shkruanin mesazhe dhe biseda video në , luanin lojëra, dëgjonin muzikë, ndihmonin njëri-tjetrin me dhurata, shikonin video, seri dhe kanale televizive në , si dhe transmetonin në .
Si kaloni ju emergjencat tuaja?
Burimi: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish