

Përkthimi i raportit të vitit 2015 nga Aleksej Lesovski "Deep dive into PostgreSQL internal statistics"
Kujdes nga autori i raportit: Dua të theksoj se ky raport është datuar në nëntor 2015 — kanë kaluar më shumë se 4 vjet dhe ka kaluar shumë kohë. Versioni i shqyrtuar në raportin 9.4 nuk mbështetet më. Gjatë këtyre 4 viteve janë lëshuar 5 versione të reja ku janë sjellë shumë risitë, përmirësime dhe ndryshime në lidhje me statistikën dhe shumë nga materialet janë bërë të papërshtatshme dhe të pavlefshme. Gjatë rishikimit, përpiqesha të shënoja këto vende për të mos të çuar në ngatërresë, lexues i dashur. Nuk e kam shkruar përsëri, është shumicë e madhe dhe do të rezultonte një raport krejtësisht ndryshe.
Sistemi i Menaxhimit të Shkathës PostgreSQL është një mekanizëm i madh, përveç që ky mekanizëm përbëhet nga shumë nën-sisteme, nga funksionimi i mirë i të cilave varet drejtpërdrejt performanca e sistemit. Gjatë procesit të përdorimit, mbledhja e statistikave dhe informacionit rreth funksionimit të komponenteve sigurohet, duke lejuar vlerësimin e eficiencës së PostgreSQL dhe marrjen e masave për të përmirësuar performancën. Megjithatë, kjo informacion është shumë e madhe dhe paraqitet në një formë mjaft të thjeshtë. Procesi i përpunimit të këtij informacioni dhe interpretimi i tij ndonjëherë është një detyrë e papritur, dhe "zooparku" i mjeteve dhe utilitareve lehtë mund të trazojë edhe një DBA të avancuar.
Përshëndetje! Unë quhem Aleksej. Siç tha Ilia, do të flas për statistikën e PostgreSQL.
Statistika e aktivitetit të PostgreSQL. PostgreSQL ka dy statistika. Statistika e aktivitetit, për të cilën do të flasim. Dhe statistika e planifikuesit për shpërndarjen e të dhënave. Do të flas pikërisht për statistikën e aktivitetit të PostgreSQL, e cila na lejon të gjykojmë për performancën dhe si ta përmirësojmë atë.
Do të tregoj se si ta përdorim efektivisht statistikën për zgjidhjen e problemeve të ndryshme që ju dalin ose mund të dalin.
Çfarë nuk do të ketë në raport? Në raport nuk do të diskutoj për statistikën e planifikuesit, pasi kjo është një temë e veçantë në një raport të veçantë për mënyrën se si të dhënat ruhen në bazë dhe se si planifikuesi i kërkesave merr një pamje mbi karakteristikat cilësore dhe sasiore të këtyre të dhënave.
Dhe nuk do të ketë shqyrtime të mjeteve, nuk do të krahasoj një produkt me tjetrin. Nuk do të ketë asnjë reklame. Të heqim këto.
Dua t'ju tregoj se përdorimi i statistikave është i dobishëm. Kjo është e nevojshme. Të përdorësh atë nuk është frikësuese. Na nevojitet vetëm SQL-i i zakonshëm dhe njohuri bazike mbi SQL-in.
Dhe do të flasim se cila statistikë duhet zgjedhur për zgjidhjen e problemeve.
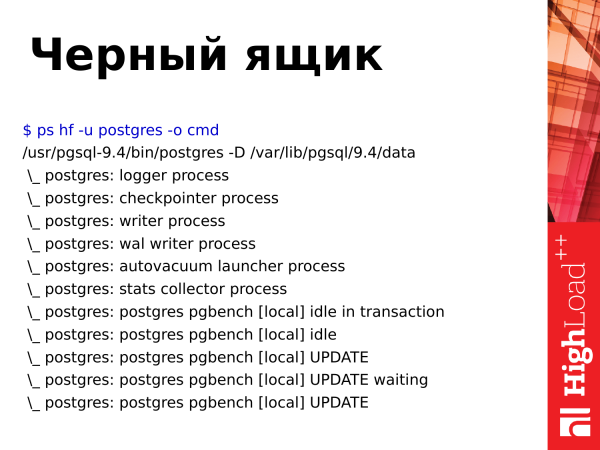
Nëse shikojmë PostgreSQL dhe në sistemin operativ ekzekutojmë një komandë për të parë proceset, do të shohim një "kutinë e zezë". Do të shohim disa procese që bëjnë diçka dhe nëpërmjet emrit mund të përfytyrojmë se çfarë ndodhin aty, çfarë po bëjnë. Por, në thelb, kjo është një kuti e zezë, ne nuk mund të shohim brenda.
Ne mund të shohim ngarkesën në procesor në top, mund të shohim shfrytëzimin e memories me disa utilitetet sistemike, por nuk do të mund t'i hedhim një sy brenda PostgreSQL. Për këtë, na duhen mjete të tjera.
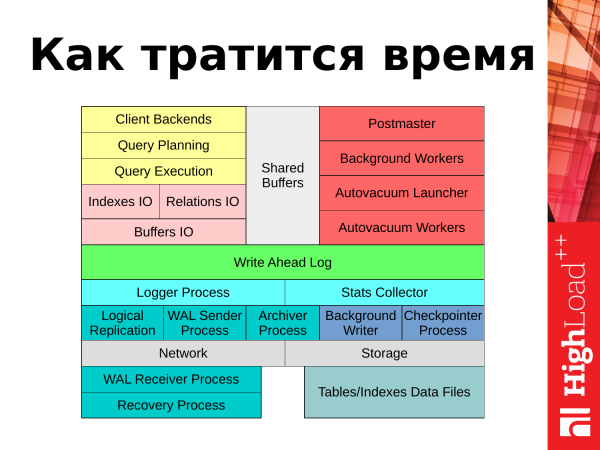
Dhe duke vazhduar përpara, do t'ju tregoj ku shpenzohet koha. Nëse e paraqesim PostgreSQL si një skemë të tillë, do të mund të përgjigjemi se ku shpenzohet koha. Këto janë dy gjëra: trajtimi i kërkesave të klientëve nga aplikacionet dhe detyrat e prapambetura që kryen PostgreSQL për të ruajtur funksionalitetin e tij.
Nëse fillojmë të shqyrtojmë nga këndi i sipërm majtas, mund të ndjekim se si trajtohen kërkesat e klientëve. Kërkesa vjen nga aplikacioni dhe për punën e mëtejshme hapet një sesion klienti. Kërkesa kalon në planifikues. Planifikuesi ndërtuon një plan kërkese. E dërgon për realizim. Realizohet ndonjë hyrje-dalje e dhënave nga blloqet të lidhura me tabelat dhe indeksat. Të dhënat e nevojshme lexohen nga diskët në memorie në një zonë të veçantë "shared buffers". Rezultatet e kërkesës, nëse janë për përditësime, fshirje, regjistrohen në ditarin e transaksioneve në WAL. Disa informacione statistikore kalojnë në log ose në kolektorin e statistikave. Dhe rezultati i kërkesës i jepet klientit përsëri. Pas kësaj, klienti mund të përsërisë gjithçka nga fillimi me një kërkesë të re.
Çfarë ndodh me detyrat dhe proceset e prapambetura? Ne kemi disa procese që sigurojnë funksionimin dhe mbajnë bazën e të dhënave në një gjendje normale pune. Këto procese do të trajtohen gjithashtu në raport: autovacuum, checkpointer, proceset lidhur me replikimin, background writer. Secilin prej tyre do ta prek me gjatë raportit.
Cilat janë problemet me statistikat?
- Ka shumë informacion. PostgreSQL 9.4 ofron 109 metrika për shikimin e të dhënave statistikore. Megjithatë, nëse në bazën e të dhënave ruhet shumë tabela, skema, ose baza, të gjitha këto metrika do të duhet të shumëzohen me numrin përkatës të tabelave dhe bazave. Kjo do të thotë se informata bëhet akoma më e madhe. Është shumë e lehtë të humbasësh në të.
- Problemi tjetër është se statistika paraqitet nga numërues. Nëse ne e shohim këtë statistikë, do të shohim numërues që rriten vazhdimisht. Nëse ka kaluar shumë kohë që nga resetimi i statistikës, do të shohim vlera miliardesh. Këto nuk na thonë asgjë.
- Nuk ka histori. Nëse keni ndodhur ndonjë dështim, diçka ka rënë para 15-30 minutash, nuk do të mund të shfrytëzoni statistikën për të parë se çfarë ka ndodhur 15-30 minuta më parë. Ky është një problem.
- Mungesa e një instrumenti të integruar në PostgreSQL është një problem. Zhvilluesit e bërthamës nuk ofrojnë asnjë utilitar. Nuk kanë asgjë të tillë. Ata thjesht ofrojnë statistikën në bazë. Përdorni, bëni kërkesa, bëni çfarë dëshironi.
- Duke qenë se nuk ka një instrument të integruar në PostgreSQL, kjo është një shkak tjetër i problemit. Shumë instrumente të jashtme. Çdo kompani që ka disa aftësi për të zhvilluar përpiqet të shkruajë programin e vet. Dhe në fund, në komunitet ka shumë instrumente që mund të përdoren për të punuar me statistikën. Disa instrumente kanë disa mundësi, të tjerat nuk kanë disa mundësi, ose kanë disa mundësi të reja. Kështu që krijohet një situatë ku duhet të përdoren dy, tri, katër instrumente që përputhen me njëri-tjetrin dhe kanë funksione të ndryshme. Kjo është shumë e pakëndshme.
Çfarë ndodh nga kjo? Është e rëndësishme të jeni në gjendje të merrni statistikën direkt, për të mos u varur nga programet, ose ndonjëherë të përmirësoni vetë këto programe: të shtoni disa funksione për të përfituar.
Dhe nevojiten njohuri bazike SQL. Për të marrë disa të dhëna nga statistika, duhet të formoni kërkesa SQL, domethënë, ju nevojitet të dini si të formoni select, join.
Statistika na ofron disa gjëra. Ato mund të ndahen në kategori.
- Kategoria e parë janë ngjarjet që ndodhin brenda bazës. Kjo është kur ndodh një ngjarje në bazë: një kërkesë, një referencë në tabelë, autovakuumi, komitë, këto janë të gjitha ngjarje. Numëruesit përkatës për këto ngjarje inkrementohen. Kështu që mund të ndjekim këto ngjarje.
- Kategoria e dytë janë vetitë e objekteve siç janë tabelat, bazat. Ato kanë disa veti. Kjo është madhësia e tabelave. Mund të ndjekim rritjen e tabelave, rritjen e indekseve. Mund të shohim ndryshimet në dinamikë.
- Kategoria e tretë është koha e shpenzuar për një ngjarje. Një kërkesë është një ngjarje. Ajo ka një masë specifike të kohëzgjatjes. Këtu filloi, këtu përfundoi. Mund ta ndjekim. Po ashtu edhe koha e leximit të bllokut nga disku ose e shkruarjes. Këto gjëra gjithashtu ndjekin.
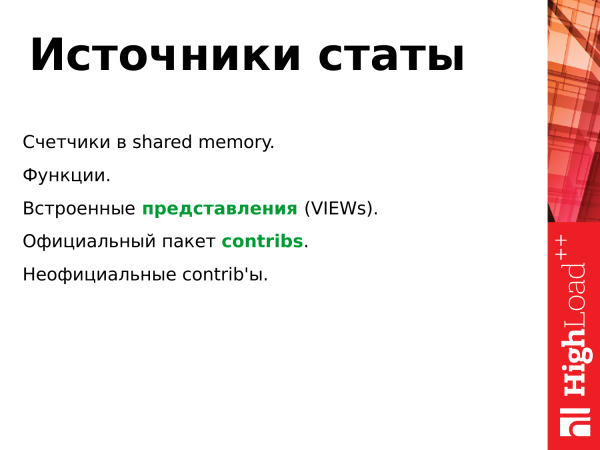
Burimet e statistikës janë paraqitur si më poshtë:
- Në memorjen e ndarë (shared buffers) ka një segment për vendosjen e të dhënave statistikore, ku ndodhen edhe ato numërues që inkrementohen vazhdimisht kur ndodhin disa ngjarje ose shfaqen disa çaste në punën e bazës.
- Të gjithë këta numërues nuk janë të aksesueshëm për përdoruesit dhe as për administratorin. Këto janë gjëra të nivelit të ulët. Për të pasur qasje në to, PostgreSQL ofron një ndërfaqe në formën e funksioneve SQL. Mund të bëjmë seleksione me ndihmën e këtyre funksioneve dhe të marrim disa metrika (ose një grup metrike).
- Megjithatë, perdorimi i këtyre funksioneve nuk është gjithmonë i përshtatshëm, kështu që funksionet janë baza për pamjet (VIEWs). Këto janë tabela virtuale që ofrojnë statistikë për një nënsistem të caktuar, ose për një grup ngjarjesh në bazën e të dhënave.
- Këto pamje të ndërtuara brenda (VIEWs) janë ndërfaqja kryesore e përdoruesit për të punuar me statistikën. Ato janë të aksesueshme siç janë pa pasur nevojë për ndonjë konfigurim të mëtejshëm, mund të filloni t'i përdorni menjëherë, të shihni, të merrni informacion prej aty. Dhe ka gjithashtu kontribuime. Kontribuimet janë zyrtare. Mund të instaloni paketën postgresql-contrib (për shembull, postgresql94-contrib), të ngarkoni modul të nevojshëm në konfigurim, të tregoni parametrat për të, të ri-nderprisni PostgreSQL dhe të filloni ta përdorni. (Shënim. Në varësi të distribuimit, në versionet e fundit, paketa e kontribuimit është pjesë e paketës kryesore.).
- Dhe ka kontribucione jo zyrtare. Ata nuk vijnë me shpërndarjen standard të PostgreSQL. Duhet t'i kompiloni ose t'i instaloni si bibliotekë. Opcionesh mund të jenë të ndryshme, në varësi të asaj çfarë ka menduar zhvilluesi i këtij kontribuimi jo zyrtar.
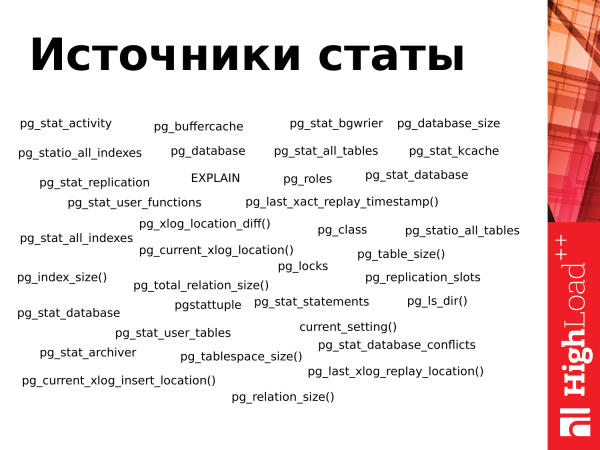
Në këtë slajd janë paraqitur të gjitha këto pamje (VIEWs) dhe disa prej atyre funksioneve që janë të disponueshme në PostgreSQL 9.4. Siç shohim, ka shumë prej tyre. Dhe është mjaft e lehtë të ngatërrohesh nëse hasesh për herë të parë me këtë.
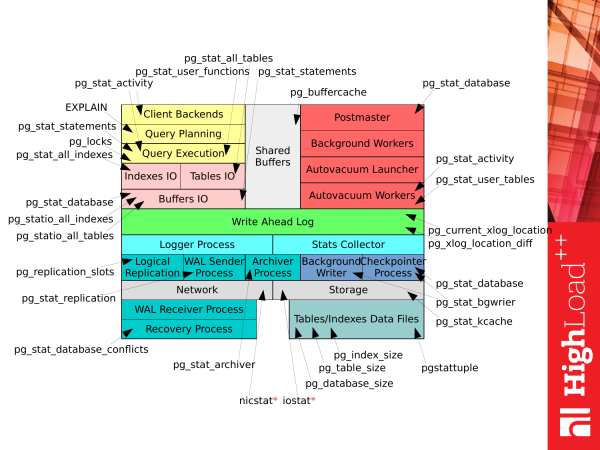
Megjithatë, nëse e marrim figurën e mëparshme Si shpërndahet koha në PostgreSQL dhe e përputhim me këtë listë, atëherë do të marrim një figurë të tillë. Çdo pamje (VIEWs) ose çdo funksion mund ta përdorim për qëllime të ndryshme për të marrë statistikat përkatëse, kur PostgreSQL funksionon. Dhe mund të marrim tashmë ndonjë informacion për funksionimin e nën-sistemit.
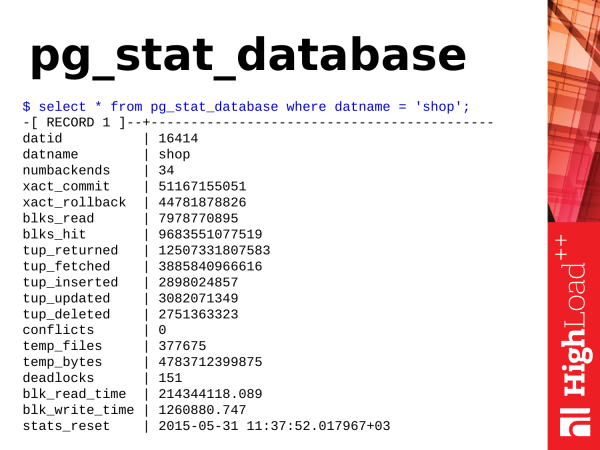
E para që do të shikojmë është pg_stat_database. Siç e shohim, kjo është pamja. Ajo ka shumë informacion. Informacioni është shumë i larmishëm. Dhe ajo ofron njohuri shumë të dobishme mbi atë që ndodh në bazën e të dhënave.
Çfarë mund të marrim të dobishme nga aty? Le të fillojmë me gjërat më të thjeshta.
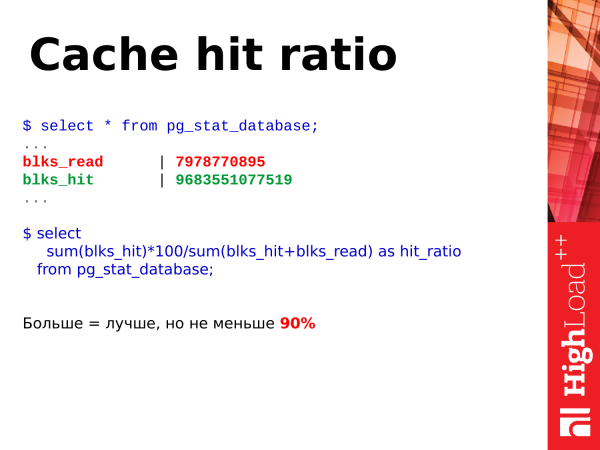
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
E para që mund të shohim – është përqindja e goditjeve në cache. Përdorimi në cache – është një metrikë e dobishme. Ajo lejon të vlerësojmë se sa të dhëna merret nga bufferat e ndarë shared, dhe sa të dhëna lexohen nga disku.
Natyrisht sa më shumë që kemi goditje në cache, aq më mirë. Ne e vlerësojmë këtë metrikë si përqindje. Dhe, për shembull, po që nëse përqindja e goditjeve në cache është mbi 90%, atëherë është mirë. Nëse bie poshtë 90%, atëherë do të thotë se kemi mungesë memorie për të mbajtur "kokën" e nxehtë të të dhënave në memorie. Dhe për të përdorur këto të dhëna, PostgreSQL është e detyruar të vijë tek disku dhe kjo është më e ngadalshme se sa të dhënat të lexohen nga memoria. Kështu që duhet të mendojmë për rritjen e memories: ose të rregullojmë bufferat e ndarë, ose të rritim memorien fizike (RAM).
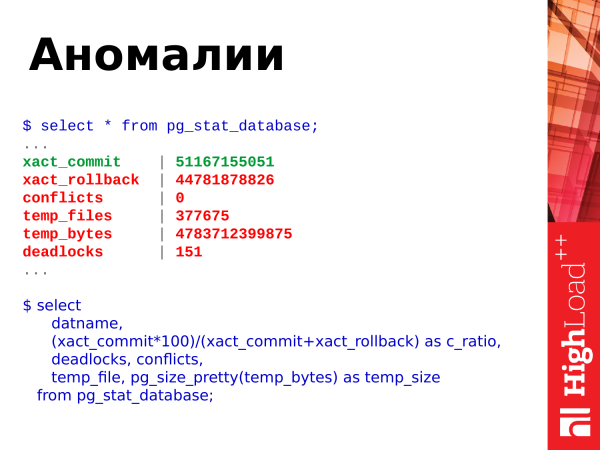
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Çfarë tjetër mund të marrim nga kjo pamje? Mund të shikojmë anomali që ndodhin në bazë. Çfarë tregon këtu? Ka commits, rollbacks, krijimin e fileve përkohëshe, volumin e tyre, deadlocks dhe konflikte.
Mund të shfrytëzojmë këtë kërkesë. Ky SQL është mjaft i thjeshtë. Dhe mund të shohim këto të dhëna në sistemin tonë.
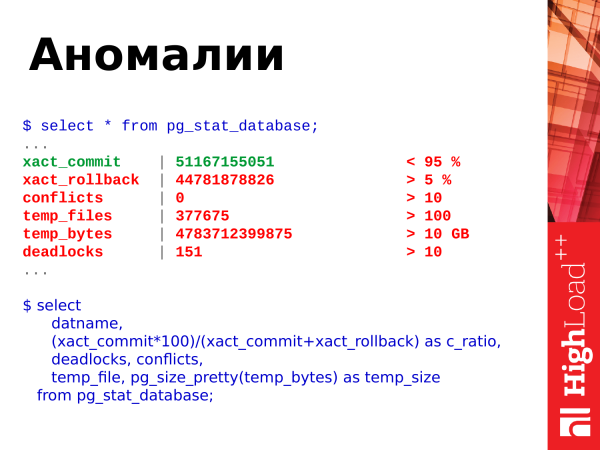
Dhe këtu janë menjëherë vlerat kufi. Ne shikojmë raportin midis commits dhe rollbacks. Commits janë konfirmime të suksesshme të transaksionit. Rollbacks janë ristrukturim, pra, transaksioni bënte ndonjë punë, ngarkonte databazën, llogariste diçka, e pastaj ndodhi një dështim dhe rezultatet e transaksionit hidhen poshtë. Kështu, numri i rollbacks që rritet vazhdimisht është i pafavorshëm. Duhet të shmangim ndodhi të tilla dhe të rregullojmë kodin për të parandaluar këtë.
Konfliktet janë të lidhura me replikimin. Dhe ato gjithashtu duhet të shmangen. Nëse keni disa kërkesa që ekzekutohen në replikë dhe ndodhin konflikte, duhet t'i shqyrtoni këto konflikte, të shikoni çfarë po ndodh. Detajet mund të gjenden në log. Dhe të zgjidhni situatat konfliktuale që kërkesat e aplikacionit të funksionojnë pa gabime.
Deadlocks është gjithashtu një situatë e keqe. Kur kërkesat garojnë për burime, një kërkesë i drejtohet një burimi dhe merr një bllokim, kërkesa tjetër i drejtohet një burimi tjetër dhe gjithashtu merr një bllokim, pastaj të dyja kërkesat i drejtohen burimeve të njëra-tjetrës dhe bllokohen duke pritur që njeriu fqinj të lirojë bllokimin. Kjo gjithashtu është një situatë problematike. Ato duhet të zgjidhen në nivelin e rishkrimit të aplikacioneve dhe serializimit të aksesit në burime. Dhe nëse shihni se deadlocks tuaj po rriten vazhdimisht, duhet të shikoni detajet në log, të shqyrtoni situatat e shfaqura dhe të shikoni ku është problemi.
Skedarët temporal janë gjithashtu të këqij. Kur një kërkesë nga përdoruesi nuk ka mjaftueshëm memorie për të ruajtur të dhëna temporale, ajo krijon një skedar në disk. Dhe të gjitha operacionet që mund të kryejë në buffer-in temporar në memorie, këto fillon ti kryejë tashmë në disk. Kjo është ngadalë. Kjo rrit kohën e ekzekutimit të kërkesës. Dhe klienti, që dërgoi kërkesën në PostgreSQL, do të marrë një përgjigje pak më vonë. Nëse të gjitha këto operacione do të kryhen në memorie, Postgres do të përgjigjet shumë më shpejt dhe klienti do të presë më pak.
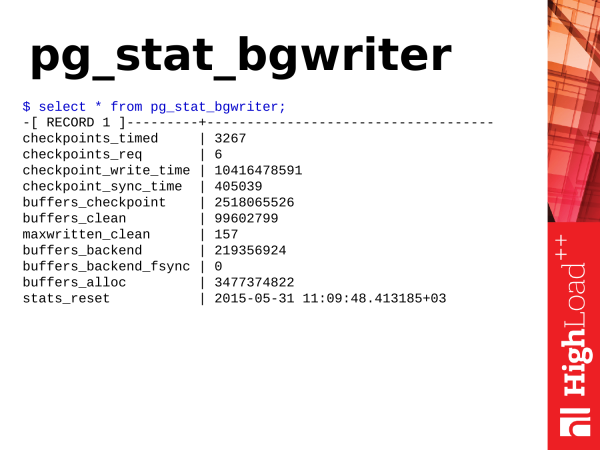
Pg_stat_bgwriter është një paraqitje që përshkruan punën e dy nënsistemeve të prapme të PostgreSQL: kjo është checkpointer dhe background writer.
Fillimisht do të shqyrtojmë pikët kontrolle, të njohura si checkpoints. Çfarë janë piketat e kontrollit? Një pikë kontrolli është një pozicion në regjistrin e transaksioneve që njofton se të gjitha ndryshimet e të dhënave të regjistruara në regjistër janë sinkronizuar me sukses me të dhënat në disk. Procesi, në varësi të ngarkesës së punës dhe konfigurimeve, mund të jetë i gjatë dhe në të shumtën e rasteve përfshin sinkronizimin e faqeve të ndotura në buffers të përbashkët me skedarët e të dhënave në disk. Për çfarë është kjo e nevojshme? Nëse PostgreSQL do të kishim qasje gjithmonë në disk për të marrë të dhëna dhe për t'i shkruar ato me çdo qasje, do të ishte e ngadalët. Prandaj, PostgreSQL ka një segment të memories, madhësia e të cilit varet nga parametrat në konfigurim. PostgreSQL vendos të dhënat operuese në këtë memorie për përpunim të mëtejshëm ose për t'i ofruar ato sipas kërkesave. Në rastin e kërkesave për ndryshimin e të dhënave, ato pësojnë ndryshime. Kështu, ne marrim dy versione të të dhënave. Njëra është në memorie, tjetra është në disk. Dhe herë pas here është e nevojshme t'i sinkronizojmë këto të dhëna. Na nevojitet që ajo që është ndryshuar në memorie, të sinkronizohet në disk. Këtu nevojitet piketa e kontrollit.
Piketat e kontrollit kalojnë nëpër buffers të përbashkët, etiketojnë faqe të ndotura, që ato janë të nevojshme për piketat e kontrollit. Pastaj fillon një kalim i dytë nëpër buffers të përbashkët. Dhe faqet që janë etiketuar për piketat e kontrollit, ato tani sinkronizohen. Kështu, përfundon sinkronizimi i të dhënave me disku.
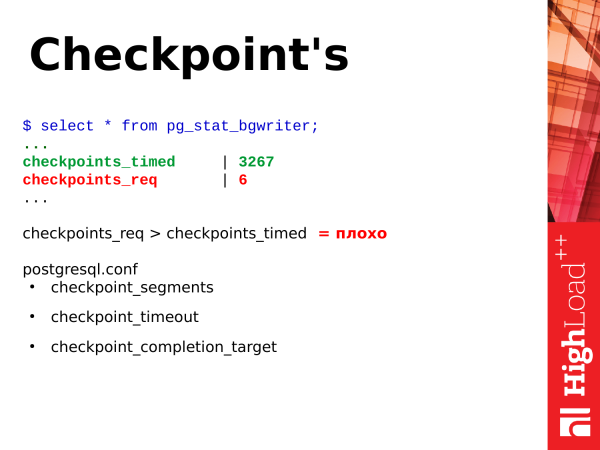
Ka dy lloje piketash të kontrollit. Një pikë kontrolli zbatohet sipas skadimit. Kjo pikë kontrolli është e dobishme dhe e mirë – checkpoint_timed. Dhe ka piketat e kontrollit sipas kërkesës – checkpoint required. Një pikë kontrolli e tillë ndodh kur kemi një shkarkim shumë të madh të të dhënave. Ne kemi regjistruar shumë regjistra transaksionesh. Dhe PostgreSQL mendon se i nevojitet ta sinkronizojë gjithçka sa më shpejt të jetë e mundur, të krijojë një pikë kontrolli dhe të vazhdojë më tej.
Dhe nëse e keni parë statistikën pg_stat_bgwriter dhe keni parë se ju keni checkpoint_req shumë më tepër se checkpoint_timed, atëherë kjo është e keqe. Pse është e keqe? Kjo do të thotë që PostgreSQL ndodhet në një situatë të vazhdueshme stresi, kur i nevojitet të shkruajë të dhëna në disk. Piketa e kontrollit sipas skadimit është më pak stresuese dhe zbatohet sipas një orari të brendshëm dhe është siç thonë, e shpërndarë në kohë. PostgreSQL ka mundësinë të bëjë pause në punë dhe të mos e ngarkojë nënstrukturën e diskut. Kjo është e dobishme për PostgreSQL. Dhe kërkesat që ekzekutohen gjatë piketës së kontrollit nuk do të ndiejnë stres nga fakti se nënstruktura e diskut është e angazhuar.
Dhe për rregullimin e checkpoint ka tre parametra:
checkpoint_segments.checkpoint_timeout.checkpoint_competion_target.
Këta lejojnë rregullimin e punës së pikave të kontrollit. Por nuk do të ndalem shumë te ato. Të ndikimit të tyre - kjo është një temë e veçantë.
Kujdes: Versioni 9.4 i diskutuar në raport tashmë nuk është aktual. Në versionet moderne të PostgreSQL, parametri checkpoint_segments është zëvendësuar me parametrat min_wal_size dhe max_wal_size.
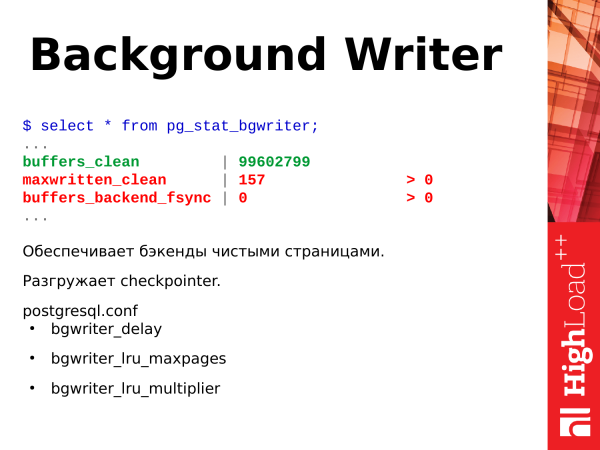
Nënësistemi tjetër është shkruesi i sfondit - background writer. Çfarë bën ai? Ai punon vazhdimisht në një cikël të pafund. Skanon faqet në buffers të ndarë dhe faqet e ndotura që gjen, i shkarkon në disk. Kështu ndihmon checkpointer-in të bëjë punë më pak gjatë ekzekutimit të pikave të kontrollit.
Për çfarë tjetër është i nevojshëm? Ai siguron nevojën për faqe të pastra në buffers të ndarë nëse ato papritmas kërkohen (në sasi të mëdha dhe papritmas) për ruajtjen e të dhënave. Supozoni se ndodhi një situatë kur për ekzekutimin e një kërkese u nevojiten faqe të pastra dhe ato janë tashmë në buffers të ndarë. PostgreSQL-i backend thjesht i merr dhe i përdor, nuk ka nevojë të pastrojë asgjë vetë. Por nëse papritmas nuk ka faqesh të tilla, backend ndalon punën dhe fillon të kërkojë faqe për t'i shkarkuar në disk dhe për t'i përdorur për nevojat e tij - që ndikon negativisht në kohën e kërkesës që po ekzekutohet në atë moment. Nëse shihni që parametri juaj maxwritten_clean është i madh, kjo do të thotë se shkruesi i sfondit nuk po përmbush detyrat e tij dhe duhet të rriten parametrat bgwriter_lru_maxpages, që ai të mund të bëjë më shumë punë në një cikël, të pastrojë më shumë faqe.
Dhe një tregues tjetër shumë i dobishëm - është buffers_backend_fsync. Backend-et nuk bëjnë fsync, sepse është i ngadaltë. Ata e kalojnë fsync më lart në IO stack te checkpointer-i. Checkpointer-i ka radhën e tij, ai përpunon fsync nga koha në kohë dhe sinkronizon faqet në kujtesë me skedarët në disk. Nëse radha është e madhe te checkpointer-i dhe e mbushur, atëherë backend-i është i detyruar të bëjë vetë fsync dhe kjo ngadalëson punën e backend-it,, dmth. klienti do të marrë përgjigje më vonë se sa mund të kishte. Nëse shihni se kjo vlerë është më e madhe se zero, atëherë kjo është një problem dhe duhet të kushtoni vëmendje parametrave të shkruesit të sfondit dhe gjithashtu të vlerësoni performancën e nënësistemit të disqeve.
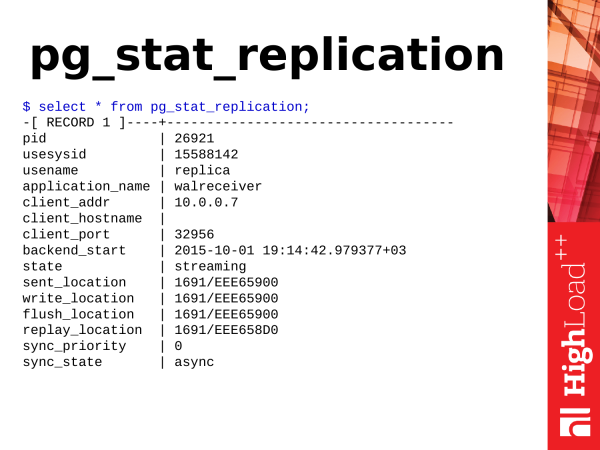
Kujdes: _Teksti në vazhdim përshkruan përfaqësime statistikore të lidhura me replikimin. Pjesa më e madhe e emrave të përfaqësimeve dhe funksioneve është riemëruar në Postgres 10. Esenca e riemërimeve qëndron në zëvendësimin xlog në wal dhe location në në emrat e funksioneve/përfaqësimeve etj. Një shembull konkret, funksioni pg_xlog_location_diff() u riemërua në pg_wal_lsn_diff() Kemi shumë informacione këtu. Por do na nevojiten vetëm pikat që lidhen me lokacionin.._
Nëse shohim se të gjitha vlerat janë të barabarta, atëherë ky është varianti ideal dhe replika nuk vonohet nga masteri.
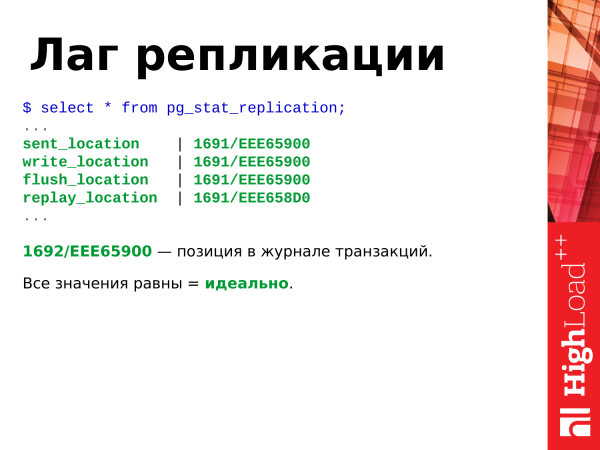
Kjo pozita në sistemin hexadecimal është pozita në regjistrin e transaksioneve. Ajo vazhdimisht rritet nëse në bazë ka ndonjë aktivitet: shtesa, fshirje etj.
sa është shkruar xlog në bytes $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); shkalla e vonesës së replikimit në byte $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) from pg_stat_replication; shkalla e vonesës së replikimit në sekonda $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
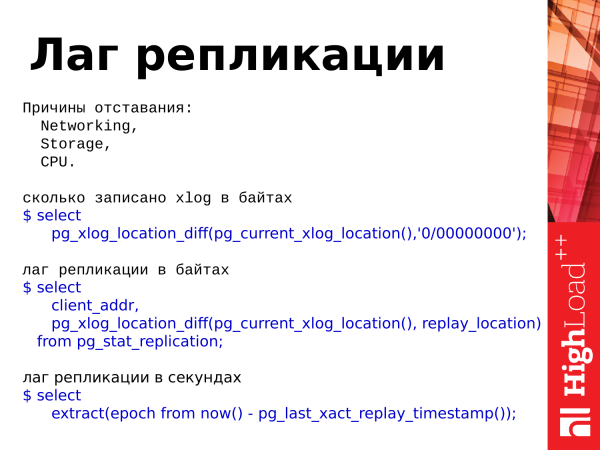
Nëse këto gjëra ndryshojnë, atëherë ka një vonesë. Vonesa është prapambetje e replikës nga masteri, pra të dhënat ndryshojnë mes serverëve.Ka tre arsye për prapambetje:
Kjo është sepse sub-sistemi i diskut nuk arrin të përballojë regjistrimin e sinkronizimit të skedareve.
- Kjo mund të jetë për shkak të gabimeve në rrjet, ose ngarkesës në rrjet, kur të dhënat nuk arrijnë në replikë dhe ai nuk mund t'i riprodhojë.
- Dhe procesori. Procesori është një rast shumë i rrallë. Kam parë diçka të tillë dy ose tre herë, por gjithashtu mund të ndodhë.
- Dhe këtu janë tre kërkesa që na lejojnë të përdorim statistikat. Mund të vlerësojmë sa është shkruar në regjistrin e transaksioneve. Ka një funksion
pg_xlog_location_diff dhe mund të vlerësojmë vonesën e replikimit në byte dhe sekonda. Ne gjithashtu e përdorim atë vlerë nga këtë përfaqësim (VIEWs). _Në vend të pg_xlog_location
Vërejtje: diff() funksioni mund të përdorim operatorin e zbritjes dhe të zbrisnim një lokacion nga tjetri. Është e përshtatshme.Me vonesën që është në sekonda, ka një moment. Nëse në master nuk ka asnjë aktivitet, transaksioni atje ishte diku 15 minuta më parë dhe nuk ka aktivitet, dhe nëse shohim këtë vonesë në replikë, do të shohim një vonesë prej 15 minutash. Kjo është diçka për të cilën duhet të kujdesemi. Dhe kjo mund të shkaktojë konfuzion kur shihni këtë vonesë.
Kjo mund të shkaktojë konfuzion kur shihni këtë vonesë.
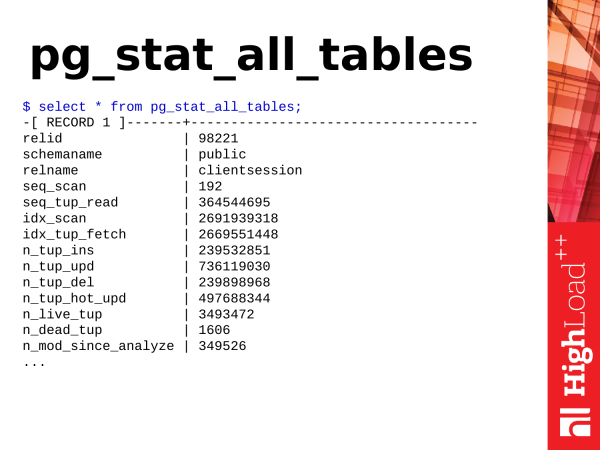
Pg_stat_all_tables – një tjetër pamje e dobishme. Ajo tregon statistikën për tabelat. Kur kemi tabela në bazën tonë, me ndonjë aktivitet, ndonjë veprim, ne mund ta marrim këtë informacion nga kjo pamje.
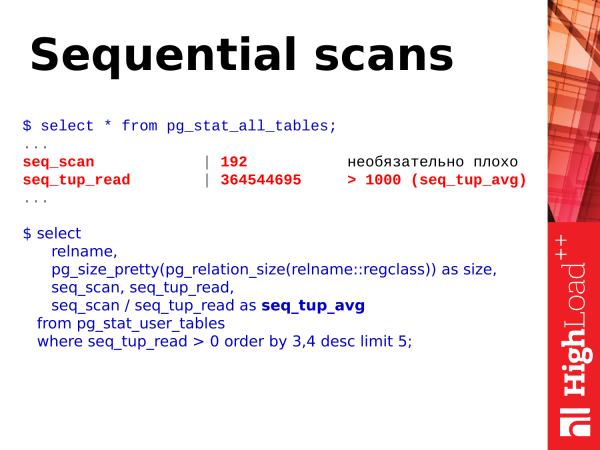
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
E para që mund të shohim është skanimi sekondar për tabelën. Numri vete pas këtyre kalimeve nuk është domosdoshmërisht i keq dhe nuk është tregues se duhet të ndërmarrim diçka.
Megjithatë, ka një metrikë tjetër – seq_tup_read. Kjo është numri i rreshtave të kthyer si rezultat i skanimit sekondar. Nëse numri mesatar kalon 1,000, 10,000, 50,000, 100,000, atëherë kjo është një tregues se ndoshta duhet të ndërtohet ndonjë indeks, që të kemi qasje përmes indeksit, ose ndoshta të optimizohen kërkesat që përdorin skanime të tilla, që të mos ndodhin.
Një shembull i thjeshtë – le të themi se një kërkesë me OFFSET dhe LIMIT të madh është e nevojshme. Për shembull, skanohen 100,000 rreshta në tabelë dhe pas kësaj merren 50,000 rreshta të nevojshëm, ndërsa rreshtat e skanuar më parë përjashtohen. Ky është gjithashtu një rast i keq. Këto kërkesa duhet të optimizohen. Dhe këtu ka një SQL të thjeshtë, mbi të cilin mund të shohim dhe vlerësojmë shifrat e marra.
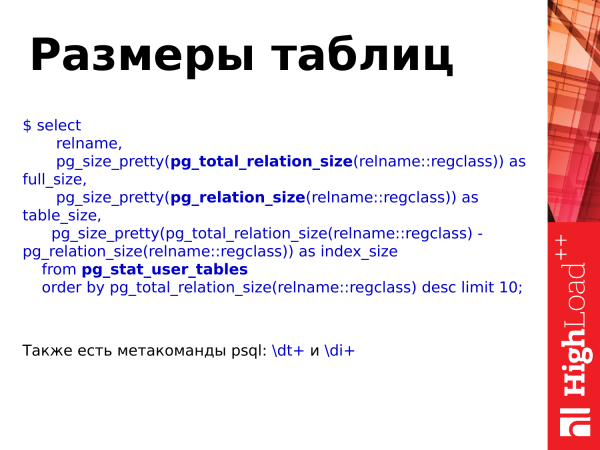
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Madhësitë e tabelave gjithashtu mund të merren përmes kësaj tabele dhe me funksione shtesë pg_total_relation_size(), pg_relation_size().
Në thelb, ka komanda metaverse dt dhe di, të cilat mund të përdoren në PSQL dhe gjithashtu të shikoni madhësitë e tabelave dhe indekseve.
Megjithatë, përdorimi i funksioneve na ndihmon të shohim madhësitë e tabelave gjithashtu duke marrë parasysh indekset, ose pa marrë parasysh indekset dhe tashmë të bëjmë disa vlerësime mbi rritjen e bazës së të dhënave, dmth si po rritet, me çfarë intensiteti dhe të nxjerrim disa përfundime mbi optimizimin e madhësive.
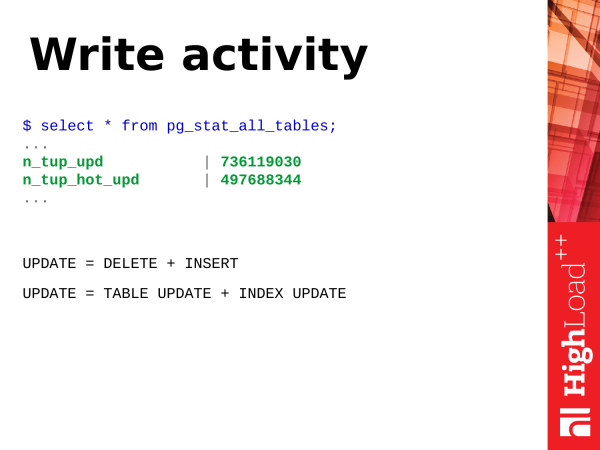
Aktiviteti në shkrim. Çfarë është shkrimi? Le të shqyrtojmë operacionin UPDATE – operacionin e përditësimit të rreshtave në tabelë. Në thelb, update është dy operacione (në fakt më shumë). Kjo është një futje e një versioni të ri të rreshtit dhe shënimi i versionit të vjetër të rreshtit si të vjetruar. Më vonë do të vijë avokati automatik dhe do të pastrojë këto versione të vjetra të rreshtave, duke e shënuar këtë vend si të disponueshëm për ripërdorim.
Për më tepër, update nuk është vetëm përditësimi i tabelës. Kjo është gjithashtu përditësimi i indekseve. Nëse keni shumë indekse në tabelë, atëherë gjatë update të gjitha indekset, në të cilat merrni pjesë fusha të përditësuara në kërkesë, gjithashtu duhet të përditësohen. Në këto indekse do të ketë gjithashtu versione të vjetra të rreshtave, të cilat duhen pastruar.
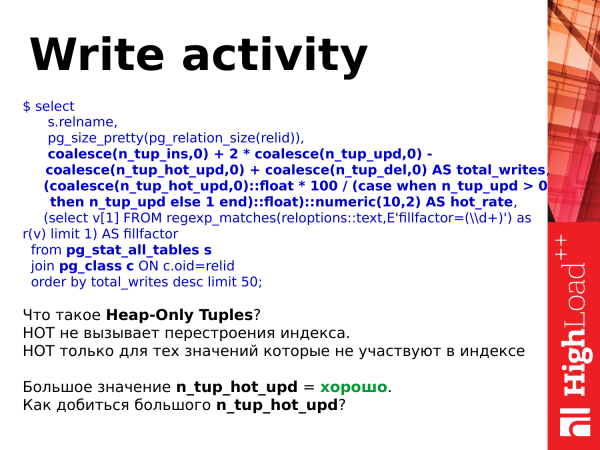
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Dhe për shkak të dizajnit të saj, UPDATE është operacione të rënda. Por ato mund të lehtësohen. Ka përditësime të nxehta. Ato u shfaqën në versionin 8.3 të PostgreSQL. Çfarë janë ato? Kjo është një përditësim i lehtë, i cili nuk shkakton rindarjen e indekseve. Kështu, ne përditësuam regjistrimin, por gjatë kësaj përditësua vetëm regjistrimi në faqen (e cila i përket tabelës), ndërsa indekset vazhdojnë të tregojnë për të njëjtin regjistrim në faqe. Atje ka një logjikë interesante të funksionimit, kur vjen vakuumi, ai rindërton këto lidhje të nxehta dhe gjithçka vazhdon të funksionojë pa përditësimin e indekseve, dhe ndodh gjithçka me një konsum më të vogël të burimeve.
Dhe kur keni n_tup_hot_upd të lartë, kjo është shumë mirë. Kjo do të thotë se përditësimet e lehta mbizotërojnë dhe kjo na dalin më lirë në burime dhe gjithçka është në rregull.
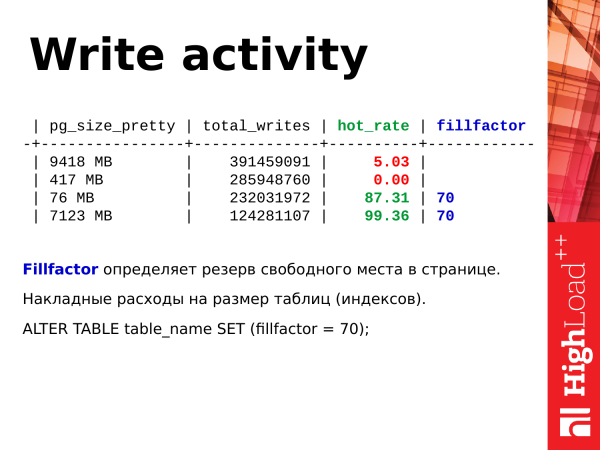
ALTER TABLE tabela_emri SET (fillfactor = 70);Si të rrisim volumet e përditësimeve të nxehtamunde të përdorim fillfactor. Ai përcakton madhësinë e hapësirës së lirë të rezervuar kur mbushni faqen në tabelë me anë të INSERT-ve. Kur në tabelë hyjnë futje, ato plotësojnë plotësisht faqen, pa lënë hapësirë të lirë. Më pas krijohet një faqe e re. Sërish të dhënat plotësohen. Dhe ky është sjellja e paracaktuar, fillfactor = 100%.
Ne mund të bëjmë fillfactor në 70%. Kjo do të thotë se gjatë inserts, një faqe e re u ndan, por është mbushur vetëm 70% e saj. Dhe 30% mbetet si rezervë. Kur do të jetë e nevojshme të bëhet përditësimi, ka një mundësi të lartë që ai do të ndodhë në të njëjtën faqe, dhe versione e re e rreshtit do të vendoset në të njëjtën faqe. Dhe do të bëhet hot_update. Kështu lehtësohet regjistrimi në tabela.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
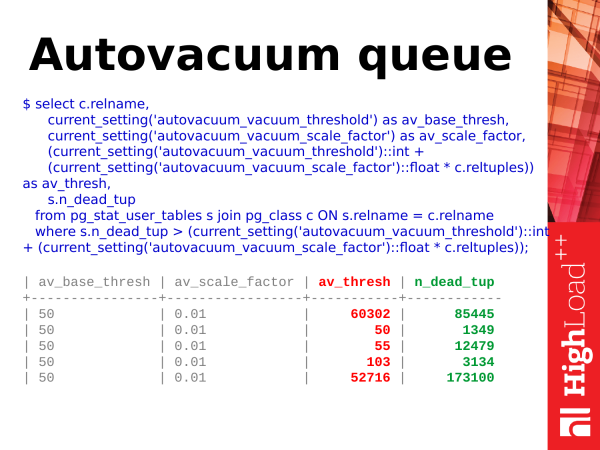
Rradha e avtokakuumit. Avtokakuumi është një nën-sistem për të cilin statistika në PostgreSQL është shumë e pakët. Ne mund të shohim në tabela vetëm në pg_stat_activity për të parë sa avokume janë duke zgjatur në moment. Megjithatë, të kuptojmë se sa tabela janë në radhë është shumë e vështirë.
Vërejtje: _Që nga versioni Postgres 10, situata me monitorimin e avtokakuumit është përmirësuar ndjeshëm — është shfaqur pamja pg_stat_progressvacuum, e cila e thjeshton ndjeshëm çështjen e monitorimit të avtokakuumit.
Ne mund të përdorim një kërkesë të tillë të thjeshtuar. Dhe mund të shohim se kur duhet të bëhet vakumi. Por, si dhe kur duhet të fillojë vakumi? Këto janë versionet e tejkalura të rreshtave, për të cilat kam folur më parë. Ndodhi një përditësim, një version i ri rreshti u vendos. U shfaq një version i tejkaluar i rreshtit. Në tabelë pg_stat_user_tables ka një parametër të tillë n_dead_tup. Ai tregon numrin e rreshtave "të vdekur". Dhe sa herë që numri i rreshtave të vdekur kalon një prag të caktuar, avtokakuumi do të vijë në tabelë.
Dhe si llogaritet ky prag? Ky është një raport specifik përqindje nga numri i përgjithshëm i rreshtave në tabelë. Ka një parametër autovacuum_vacuum_scale_factor. Ai përcakton raportin përqindje. Supozoni, 10% + një prag bazë shtesë prej 50 rreshtash. Dhe çfarë ndodh? Kur numri i rreshtave të vdekur është më i madh se "10% + 50" nga të gjithë rreshtat në tabelë, atëherë e vendosim tabelën në avtokakum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
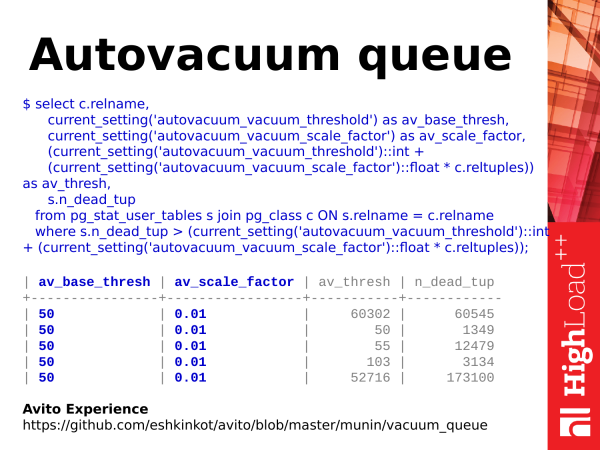
Megjithatë, këtu ka një moment. Pragjet bazë të parametrave av_base_thresh dhe av_scale_factor mund të caktohen individualisht. Dhe, përkatësisht, pragu nuk do të jetë global, por individual për tryezën. Prandaj, për ta llogaritur, është e nevojshme të përdoren truke dhe hile. Dhe nëse jeni të interesuar, mund të shihni përvojën e kolegëve tanë nga Avito (linku në slajd është i pavlefshëm dhe është përditësuar në tekst).
Ata shkruan për , i cili merr parasysh këto gjëra. Aty ka një dokument që zgjat dy faqe. Por ai llogarit saktë dhe ndihmon për të vlerësuar mjaft eficent ku kemi shumë vakuum të nevojshëm për tabelat, ku pak.
Çfarë mund të bëjmë me këtë? Nëse kemi një radhë të madhe dhe avotokum nuk përballon, atëherë mund të rrisim numrin e punëtorëve të vakuumit, ose thjesht ta bëjmë vakuumin më agresiv, në mënyrë që ai të aktivizohet më herët, të përpunojë tabelën në copa të vogla. Dhe kështu radhët do të pakësohen. — E rëndësishme këtu është të ndjekim ngarkesën në disqe, pasi vakuumi nuk është i lirë, megjithatë me ardhjen e pajisjeve SSD/NVMe, problemi është bërë më pak i dukshëm.
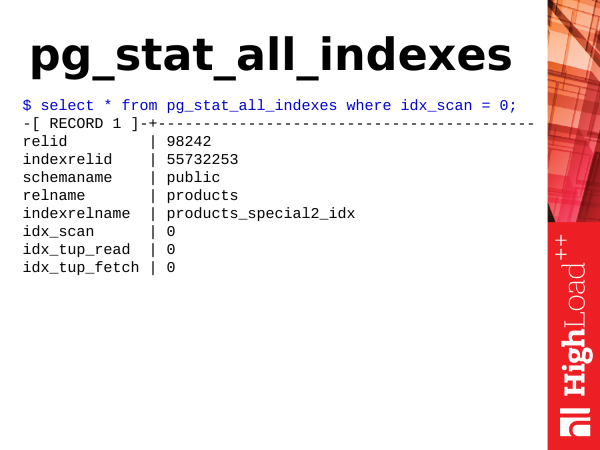
Pg_stat_all_indexes – kjo është statistika për indekset. Ajo është e vogël. Dhe ne mund të marrim informacion për përdorimin e indekseve. Për shembull, mund të përcaktojmë cilat indekse janë të tepërta.
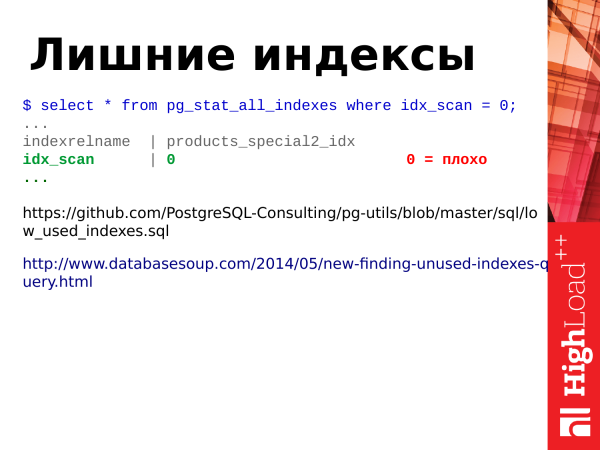
Siç e thashë më parë, update – nuk është vetëm përditësimi i tabelave, por gjithashtu përditësimi i indekseve. Pra, nëse kemi shumë indekse në tabelë, gjatë përditësimit të rreshtave në tabelë, indekset e fushave të indeksuara gjithashtu duhet të përditësohen, dhe nëse kemi indekse që nuk përdoren, për të cilat nuk ka skanime indekse, ato na mbajnë peshë. Dhe duhet të heqim dorë nga ato. Për këtë na nevojitet fusha idx_scan. Ne thjesht shohim numrin e skanimeve të indekseve. Nëse indekset kanë zero skanime për një periudhë të gjatë të ruajtjes së statistikave (jo më pak se 2-3 javë), atëherë shumë gjasë ato janë indekse të dobëta, duhet të heqim dorë nga to.
Vërejtje: Gjatë kërkimit të indekseve që nuk përdoren në rastin e klastereve të replikimit të vazhdueshëm, duhet të kontrollojmë të gjithë nyjet e klasterit, pasi statistika nuk është globale, dhe nëse indeksi nuk përdoret në master, mund të përdoret në replika (nëse ka ngarkesë atje).
Dy linke:
Këto janë shembuj më të avancuar të pyetjeve se si të kërkoni indekse që nuk përdoren.
Linku i dytë është një kërkesë mjaft interesante. Aty është e vendosur një logjikë shumë e veçantë. E rekomandoj për t'u njohur.
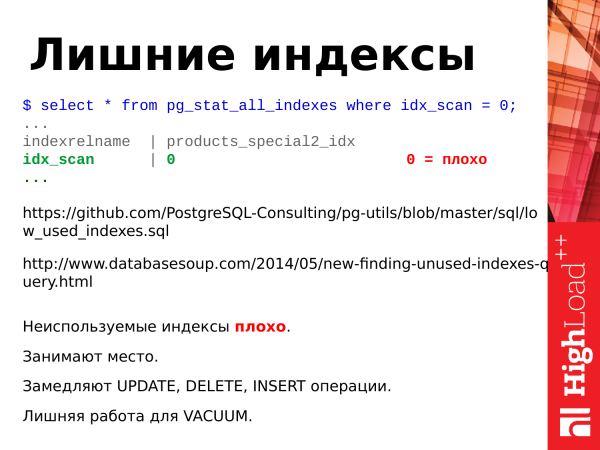
Çfarë tjetër duhet të përmbledhësh për indeksat?
Indeksat e pa përdorur janë të këqija.
Zgjatin hapësirën.
Ngadalësojnë operacionet e përditësimit.
Puna e tepërt për vakuumin.
Nëse ne i hiqnim indeksat e pa përdorur, do t'i bënim bazës vetëm më të mirë.
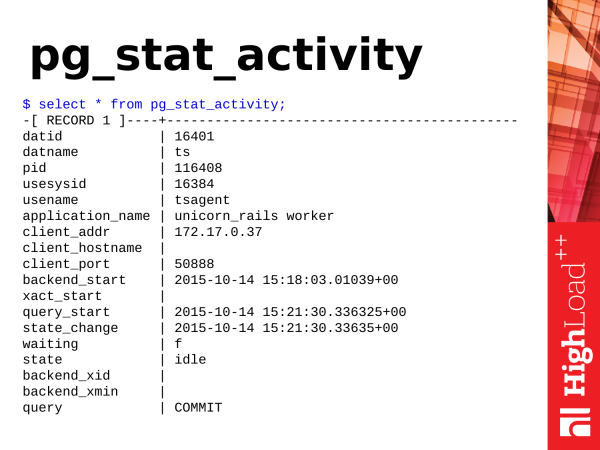
Prezantimi tjetër është pg_stat_activity. Kjo është një analogji e utilitarit ps, vetëm në PostgreSQL. Nëse psnë ‘ju shikoni proceset në sistemin operativ, atëherë pg_stat_activity do t'ju tregojë aktiviteten brenda PostgreSQL.
Çfarë mund të marrim atje të dobishme?
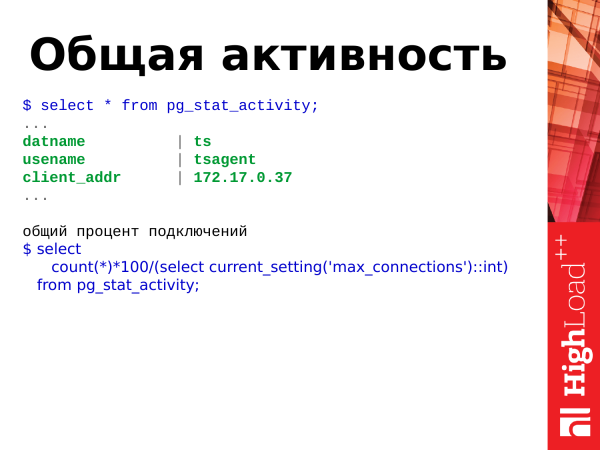
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Mund të shohim aktivitetin e përgjithshëm, çfarë po ndodh në bazë. Mund të bëjmë një shpërndarje të re. Atje të gjitha u shpërthejnë, nuk pranohet lidhje të reja, gabimet vërshojnë në aplikacion.
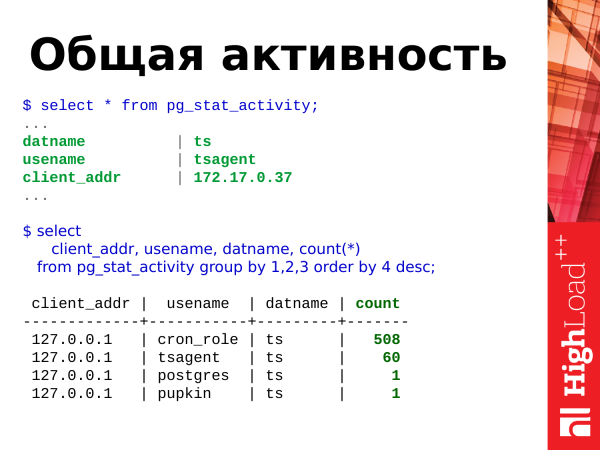
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Mund të kryejmë një kërkesë të tillë dhe të shohim përqindjen e përgjithshme të lidhjeve në lidhje me limitin maksimal të lidhjeve dhe të shohim se kush ka më shumë lidhje. Dhe në rastin e dhënë, ne shohim që përdoruesi cron_role ka hapur 508 lidhje. Dhe diçka ka ndodhur me të. Duhet të merremi me të dhe është e mundur që kjo është një numër anormal lidhjesh.
Nëse kemi ngarkesë OLTP, kërkesat duhet të kryhen shpejt, shumë shpejt dhe nuk duhet të ketë kërkesa të gjata. Megjithatë, nëse ndodhin kërkesa të gjata, atëherë në një perspektivë afatshkurtër nuk ka asgjë të tmerrshme, por në një perspektivë afatgjatë, kërkesat e gjata dëmtojnë bazën, ato rrisin efektin e bloat në tabela, kur ndodhin fragmentime të tabelave. Dhe duhet të heqim dorë nga bloat dhe nga kërkesat e gjata.
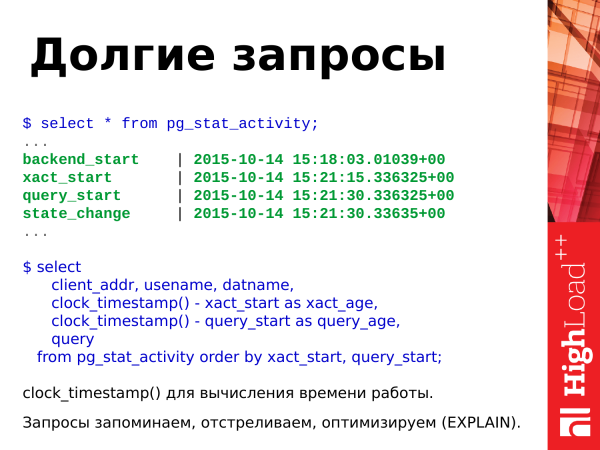
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Kujdes: me një kërkesë të tillë ne mund të identifikojmë kërkesat e gjata dhe transaksionet. Ne përdorim funksionin clock_timestamp() për të përcaktuar kohëzgjatjen e punës. Kërkesat e gjata që gjetëm, mund t'i ruajmë, t'i kryejmë explain, të shohim planet dhe të optimizojmë disi. Kërkesat aktuale të gjata i eliminojmë dhe vazhdojmë të jetojmë.
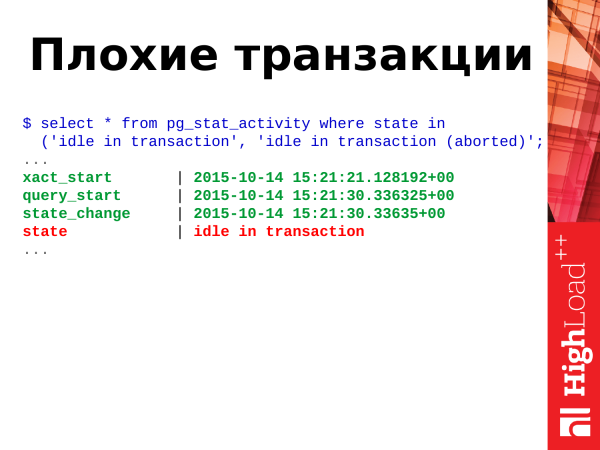
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Transaksionet e këqija janë transaksionet në gjendjen idle in transaction dhe idle in transaction (aborted).
Çfarë do të thotë kjo? Transaksionet kanë disa gjendje. Një nga këto gjendje mund të jetë në çdo moment. Për të përcaktuar gjendjet, ka një fushë state në këtë pamje. Dhe ne e përdorim atë për të përcaktuar gjendjen.
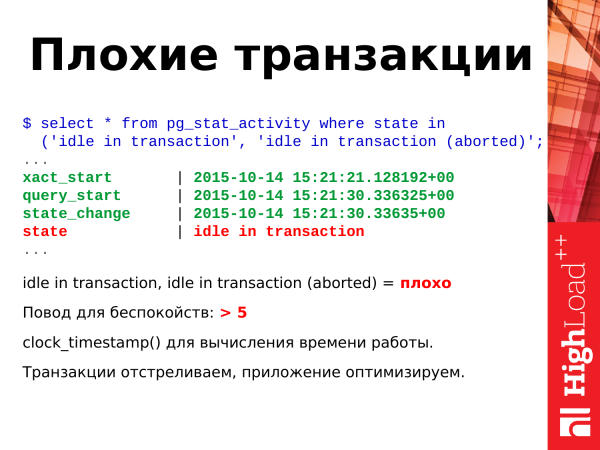
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Dhe, siç e thashë më sipër, këto dy gjendje idle in transaction dhe idle in transaction (aborted) – janë të keqija. Çfarë janë? Kjo ndodh kur aplikacioni hap një transaksion, bën disa veprime dhe largohet për punët e tij. Transaksioni mbetet i hapur. Ai mbetet pezull, nuk ndodh asgjë, zë një lidhje, bllokime mbi rreshtat e ndryshuar dhe potencialisht rrit shfrytëzimin e tabeleve të tjera, për shkak të arkitekturës së motorit transaksional Postgres. Dhe këto transaksione gjithashtu duhet të eleminohen, sepse janë të dëmshme në çdo rast.
Nëse shihni se keni më shumë se 5-10-20 të tilla në bazën tuaj, atëherë duhet të shqetësoheni dhe të filloni të bëni diçka për to.
Këtu ne gjithashtu përdorim clock_timestamp()për kohën e llogaritjes. Ne eleminojmë transaksionet, optimizojmë aplikacionin.
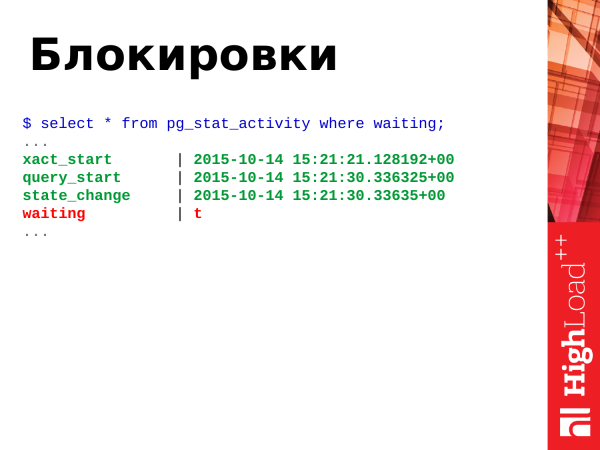
Ashtu siç kam thënë më parë, bllokimet janë kur dy ose më shumë transaksione luftojnë për një ose një grup burimesh. Për këtë kemi një fushë waiting me një vlerë booleane true ose false.
True – do të thotë se procesi është në pritje, duhet të bëhet diçka. Kur procesi është në pritje, do të thotë se klienti që iniciuoi këtë proces po pret gjithashtu. Klienti në shfletues po pret gjithashtu.
Kujdes: _Që nga versioni Postgres 9.6, fusha waiting është hequr dhe në vend të saj janë shtuar dy fusha më informuese wait_event_type dhe wait_event._
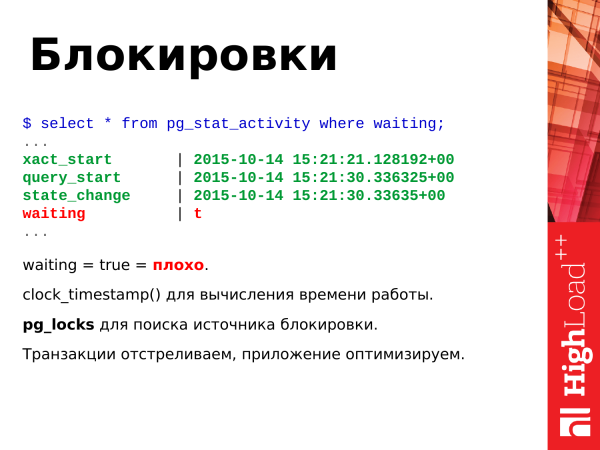
Çfarë të bëjmë? Nëse shihni true për një kohë të gjatë, do të thotë se duhet të heqim dorë nga kërkesat e tilla. Thjesht eleminojmë këto transaksione. U shkruajmë zhvilluesve që duhet të optimizojnë për të shmangur garat për burime. Dhe më pas zhvilluesit optimizojnë aplikacionin që të mos ndodhin të tilla.
Dhe rasti ekstrem, por potencialisht jo fatal – është kërcimi i deadlocks. Dy transaksione kanë përditësuar dy burime, pastaj i referohen atyre përsëri, tashmë për burimet e kundërta. PostgreSQL në këtë rast merr dhe eleminon vetë transaksionin, në mënyrë që tjetri të mund të vazhdojë punën. Kjo është një situatë e bllokuar dhe ajo nuk zgjidhet më vete. Prandaj PostgreSQL është i detyruar të marrë masa ekstreme.
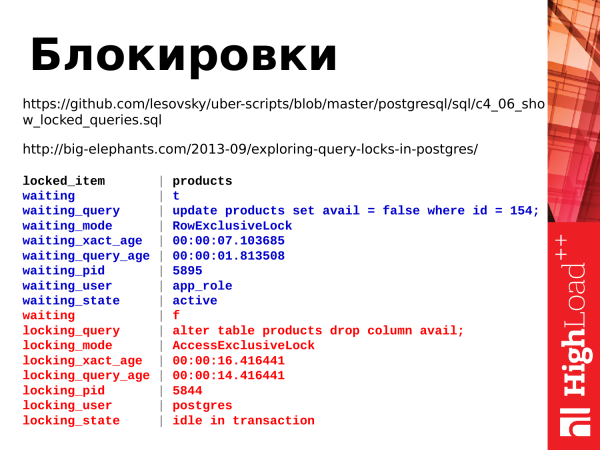
Dhe këtu janë dy kërkesa që lejojnë të ndjekim bllokimet. Ne përdorim pamjen pg_locks, e cila ndihmon në ndjekjen e bllokimeve të rënda.
Dhe lidhja e parë është vetë teksti i pyetjes. Ai është mjaft i gjatë.
Dhe lidhja e dytë është artikulli mbi locks. Është e dobishme të lexohet, shumë interesante.
Pra, çfarë shohim? Shohim dy pyetje. Transaksion me ALTER TABLE – është një transaksion bllokues. Ai është aktivizuar, por nuk është përfunduar dhe aplikacioni që ka nisur këtë transaksion është duke u marrë me gjëra të tjera. Dhe pyetja e dytë – update. Ai pret që të përfundojë alter table-in që të vazhdojë punën e tij.
Kështu mund të zbulojmë se kush ka bllokuar kë dhe mund të merremi më tej me këtë.
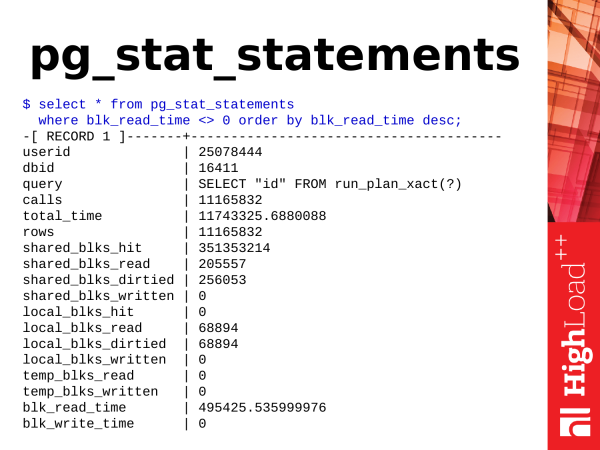
Moduli tjetër është pg_stat_statements. Siç e përmenda, ky është një modul. Për ta përdorur, duhet të ngarkoni bibliotekën e tij në configuracion, të rinisni PostgreSQL, të instaloni modulin (me një komandë) dhe pastaj do të kemi një pamje të re.
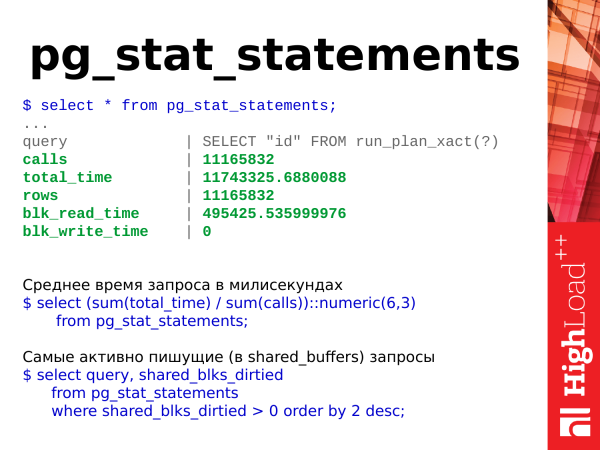
Koha mesatare e pyetjes në milisekonda
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Pyetjet më aktive të shkruara (në shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Çfarë mund të marrim nga atje? Nëse flasim për gjëra të thjeshta, mund të marrim kohën mesatare të ekzekutimit të pyetjes. Nëse koha rritet, atëherë PostgreSQL po përgjigjet ngadalë dhe duhet të marrim masa.
Mund të shohim transaksionet më aktive të shkruara në bazën e të dhënave, që ndryshojnë të dhënat në shared buffers. Të shikojmë se kush po përditëson ose fshin të dhëna.
Dhe mund të shohim thjesht statistika të ndryshme mbi këto pyetje.
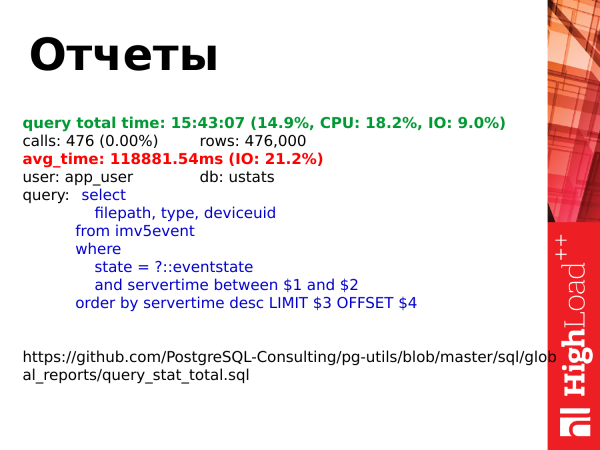
Ne pg_stat_statements e përdorim për ndërtimin e raporteve. Një herë në ditë e resetem statistikën. E akumulojmë atë. Para rindërritjes së statistikave herën tjetër, ndërtojmë raportin. Këtu është lidhja për raportin. Mund ta shihni atë.
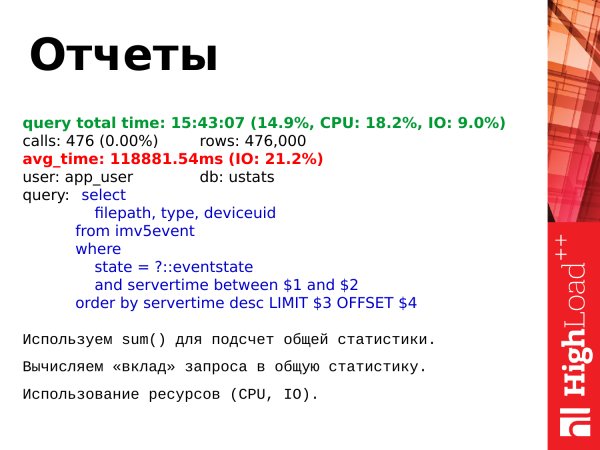
Çfarë bëjmë? Llogarisim statistikat totale për të gjitha pyetjet. Më pas, për secilën pyetje llogarisim kontributin e saj individual në këtë statistikë të përgjithshme.
Dhe çfarë mund të shohim? Mund të shohim kohën totale të ekzekutimit të të gjitha pyetjeve të një lloji specifik në sfondin e të gjitha pyetjeve të tjera. Mund të shohim përdorimin e burimeve të procesorit dhe input-output në lidhje me pamjen e përgjithshme. Dhe pastaj të optimizojmë këto pyetje. Ndërtojmë topin e pyetjeve mbi këtë raport dhe më pas marrim informacione për t'u menduar, se çfarë të optimizojmë.
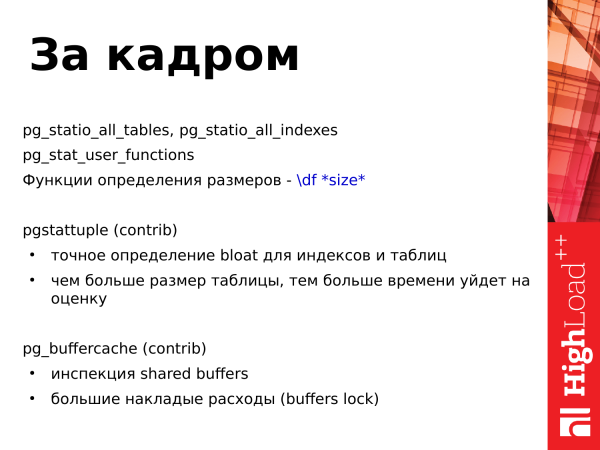
Çfarë na ka mbetur pas skenës? Janë ende disa prezantime që nuk i shqyrtova, sepse koha është e kufizuar.
Ka pgstattuple – është gjithashtu një modul shtesë nga paketa standarde contribs. Ai lejon të vlerësosh bloat tabelat, e ashtuquajtur fragmentimi i tabelës. Dhe nëse fragmentimi është i madh, duhet të hiqet, të përdoren mjete të ndryshme. Dhe funksioni pgstattuple punon për një kohë të gjatë. Dhe sa më shumë tabela të jenë, aq më gjatë do të punojë.
Contrib-i tjetër është pg_buffercache. Ai lejon inspektimin e shfletuesve të ndarë: sa intensa dhe për cilat tabela shfrytëzohen faqet e shfletuesit. Dhe thjesht lejon të hedhësh një vështrim në shfletuesit e ndarë dhe të vlerësosh se çfarë ndodh atje.
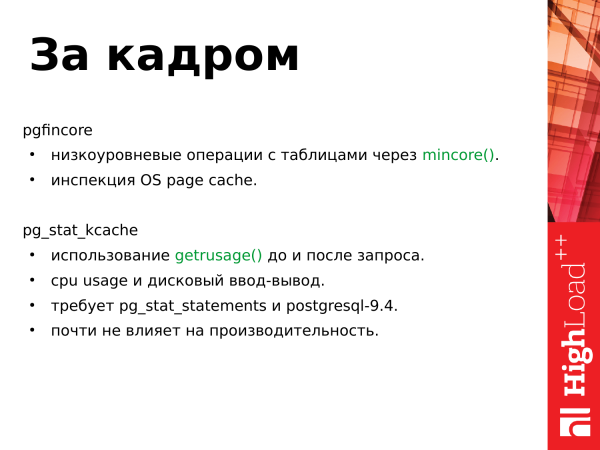
Moduli tjetër është pgfincore. Ai lejon kryerjen e operacioneve me nivel të ulët me tabelat përmes thirrjeve sistemore mincore(), dmth ai lejon ngarkimin e një tabele në shfletuesit e ndarë ose shkarkimin e saj. Dhe, përveç kësaj, lejon inspektimin e caches së faqeve të sistemit operativ, dmth në çfarë sasi tabela jonë zë në cache të faqes, në shfletuesit e ndarë dhe thjesht lejon të vlerësohet ngarkesa e tabelës.
Moduli tjetër është pg_stat_kcache. Ai gjithashtu përdor thirrjen sistemore getrusage(). Dhe e ekzekuton atë para dhe pas ekzekutimit të pyetjes. Dhe në statistikën e marrë lejon të vlerësojmë se sa e ka shpenzuar pyetja jonë për ekzekutimin e hyrjeve dhe daljeve në disk, dmth operacionet me sistemin e skedarëve dhe sheh përdorimin e procesorit. Megjithatë, moduli është i ri (ahem-ahem) dhe për funksionimin e tij kërkon PostgreSQL 9.4 dhe pg_stat_statements, për të cilin kam folur më parë.
Të diturit si të përdorësh statistikat është e dobishme. Nuk keni nevojë për programe të jashtme. Mund të hedhësh vetë një vështrim, të shohësh, të bësh diçka, të ekzekutosh.
Përdorimi i statistikave nuk është i vështirë, është SQL i zakonshëm. Keni grumbulluar një pyetje, e keni përgatitur, e keni dërguar, e keni parë.
Statistikat ndihmojnë për të përgjigjur pyetjeve. Nëse keni pyetje, ju drejtoheni statistikave – shihni, nxjerrni përfundime, analizoni rezultatet.
Dhe eksperimentoni. Ka shumë pyetje, shumë të dhëna. Gjithmonë mund të optimizoni një pyetje ekzistuese. Mund të bëni versionin tuaj të pyetjes, i cili ju përshtatet më shumë se origjinali dhe ta përdorni.
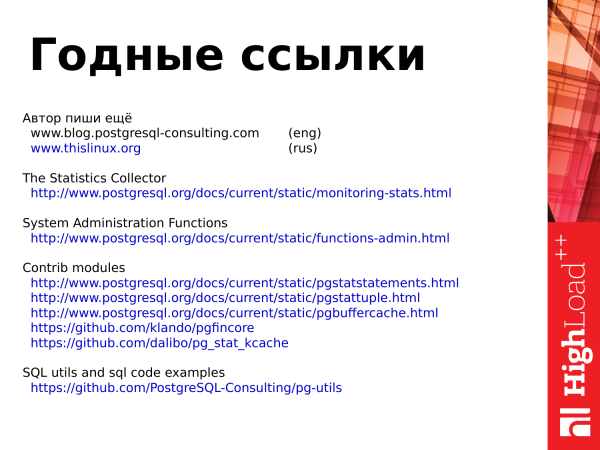
Linket
Lidhje të vlefshme që u përmendën në artikullin, mbi materialet e të cilit, ishin në raport.
Autori shkruan akoma
(eng)
Koleksionisti i Statistikave
Funksionet e Administratës së Sistemit
Modulet Contrib
Mjetet SQL dhe shembujt e kodit sql
Faleminderit të gjithëve për vëmendjen!
Burimi: habr.com
