

Disa më parë, na erdhi në mendje pyetja e zgjedhjes së një mjeti ETL për të punuar me BigData. Zgjidhja e mëparshme Informatica BDM nuk na e plotësonte nevojat për shkak të funksionalitetit të kufizuar. Përdorimi i saj përfundonte në një kornizë për të nisur komandat spark-submit. Në treg nuk kishte shumë alternativa që ishin në gjendje të punonin me volumet e të dhënave me të cilat ne merremi çdo ditë. Në fund, ne zgjodhëm Ab Initio. Gjatë demonstratave pilot, produkti tregoi një shpejtësi shumë të lartë në përpunimin e të dhënave. Informacione mbi Ab Initio në gjuhën ruse janë pothuajse të pandodhura, prandaj vendosëm të ndajmë përvojën tonë në Habr.
Ab Initio ka një shumëllojshmëri transformimesh klasike dhe të pazakonta, kodi i të cilave mund të zgjerohet me anë të gjuhës së tij PDL. Për bizneset e vogla, një mjet kaq i fuqishëm, ndoshta, do të ishte i tepërt, dhe shumica e mundësive të tij mund të duken të shtrenjta dhe pa përdorim. Por nëse shkallët tuaja i afrohen atyre të Sberbank, atëherë Ab Initio mund të jetë i interesuar për ju.
Ai ndihmon biznesin globalisht të grumbullojë njohuri dhe të zhvillojë ekosistemin, ndërsa zhvilluesit — të avancojnë aftësitë e tyre në ETL, të përmirësojnë njohuritë në shell, ofron mundësinë për t'u njohur me gjuhën PDL, jep një pamje vizuale të proceseve të ngarkesës, dhe e thjeshton zhvillimin falë shumtisë së komponentëve funksionalë.
Në këtë postim do të flas për mundësitë e Ab Initio dhe do të jap karakteristikat krahasuese për punën e tij me Hive dhe GreenPlum.
- Përshkrimi i kornizës MDW dhe punëve për përshtatjen e saj për GreenPlum
- Karakteristikat krahasuese të performancës së Ab Initio në punën me Hive dhe GreenPlum
- Puna e Ab Initio me GreenPlum në modalitetin Near Real Time
Funksionaliteti i këtij produkti është shumë i gjerë dhe kërkon një kohë të konsiderueshme për t'u mësuar. Megjithatë, me aftësi të duhura në punë dhe konfigurime të sakta të performancës, rezultatet e përpunimit të të dhënave janë mjaft impresionuese. Përdorimi i Ab Initio për një zhvillues mund të ofrojë një përvojë interesante. Kjo është një shikim i ri në zhvillimin ETL, një hibrid midis mjedisit vizual dhe zhvillimit të ngarkesave në një gjuhë të ngjashme me skriptin.
Biznesi po zhvillon ekosistemet e tij dhe ky mjet duket se është më i nevojshëm se kurrë. Me Ab Initio është e mundur të grumbullohen njohuritë mbi biznesin aktual dhe t'i përdorim ato për të zgjeruar bizneset e vjetra dhe për të hapur të reja. Alternativat e Ab Initio përfshijnë mjediset vizuale të zhvillimit Informatica BDM dhe ato jo-vizuale si Apache Spark.
Përshkrimi i Ab Initio
Ab Initio, siç është dhe mjetet e tjera ETL, përbën një grup produktesh.
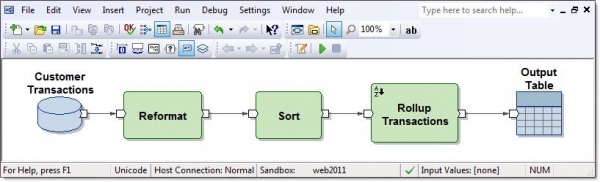
Ab Initio GDE (Graphical Development Environment) është një mjedis për zhvilluesit ku ata ndyshojnë transformimet e të dhënave dhe i lidhen ato me rrjedha të dhënash në formën e shigjetave. Këto transformime quhen grafë:
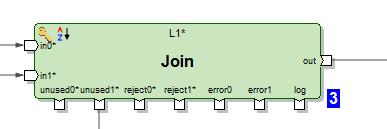
Lidhjet hyrëse dhe dalëse të komponentëve funksionalë janë porte dhe përmbajnë fushat e llogaritura brenda transformimeve. Disa grafë, të lidhur me rrjedha në formën e shigjetave sipas rendit të ekzekutimit quhen plan.
Ekzistojnë disa qindra komponentë funksionalë, që janë shumë të shumtë. Shumica e tyre janë të specializuar. Mundësitë e transformimeve klasike në Ab Initio janë më të gjera se në mjetet e tjera ETL. Për shembull, Join ka disa dalje. Përveç rezultatit të bashkimit të dataset-eve, mund të merret në dalje edhe regjistrimi i dataset-eve hyrëse për të cilat nuk arriti të bashkohet. Po ashtu, mund të merret rejects, errors dhe log-u i punës së transformimit, i cili mund të lexohet si një skedar tekstual në këtë graf dhe të përpunohen nga transformime të tjera:
Ose, për shembull, mund të materializohet pranuesi i të dhënave në formën e një tabele dhe në këtë graf të lexohen të dhënat prej saj.
Ka transformime origjinale. Për shembull, transformimi Scan ka funksionalitet si funksionet analitike. Ekzistojnë transformime me emra të kuptueshëm: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB, etj. Grafët mund të përdorin parametra të kohës së ekzekutimit, përfshirë mundësinë e kalimit të parametrave nga sistemi operativ ose në sistemin operativ. Skedarët me grupin e gatshëm të parametrave të dërguar në graf quhen parameter sets (psets).
Siç pritet, Ab Initio GDE ka depozitat e saj, të quajtura EME (Enterprise Meta Environment). Zhvilluesit kanë mundësinë të punojnë me versione lokale të kodit dhe të bëjnë check in të zhvillimeve të tyre në depozitat qendrore.
Ka kemi mundësinë që gjatë ose pas ekzekutimit të grafikës të klikojmë mbi çdo lidhje që transformon flukset dhe të shikojmë të dhënat që kaluan ndërmjet këtyre transformimeve.
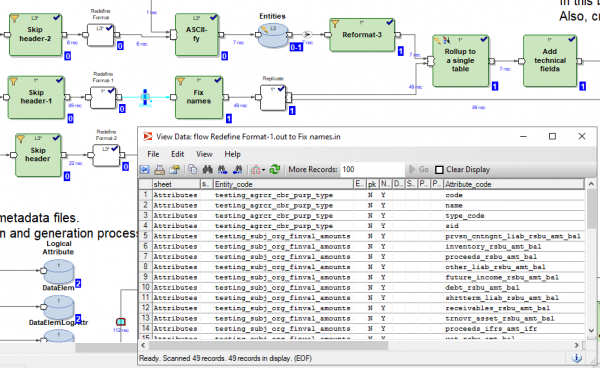
Gjithashtu, ka mundësinë të klikojmë mbi çdo rrjedhë dhe të shikojmë detajet e ndjekjes – sa paralelisht ka punuar transformimi, sa rreshta dhe byte janë ngarkuar në cilën nga paralelët.
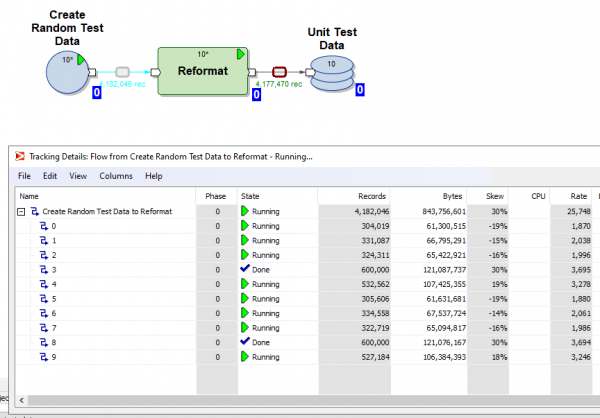
Ka mundësi të ndajmë ekzekutimin e grafikës në faza dhe të shënojmë se disa transformime duhet të ekzekutohen në fillim (në fazën zero), pasuar nga ato në fazën e parë, dhe më pas në fazën e dytë, etj.
Çdo transformim mund të zgjedhë një layout të ashtuquajtur (ku do të ekzekutohet): pa paralelë ose në fluste paralelë, numrin e të cilave mund ta përcaktojmë. Në të njëjtën kohë, skedarët përkohësorë që krijon Ab Initio gjatë punës së transformimeve mund të vendosen si në sistemin e skedareve serverë, ashtu edhe në HDFS.
Në çdo transformim bazuar në modelin e parazgjedhur, mund të krijoni skenarin tuaj në gjuhën PDL, e cila është paksa e ngjashme me shell.
Me anë të gjuhës PDL, ju mund të zgjatni funksionalitetin e transformimeve dhe, konkretisht, mund të gjeneroni në mënyrë dinamike ( gjatë ekzekutimit) fragma të rastësishme të kodit në varësi të parametrave të ekzekutimit.
Po ashtu, në Ab Initio integrimi me OS-në është mëse i zhvilluar përmes shell-it. Konkretisht në Sberbank përdoret linux ksh. Mund të shkëmbeni me shell variablat dhe t’i përdorni ato si parametra të grafikëve. Mund të thërrisni ekzekutimin e grafikëve Ab Initio nga shell dhe të administroni Ab Initio.
Përveç Ab Initio GDE, dërgesa përfshin shumë produkte të tjerë. Ka një sistem Co>Operation me pretendimin për t’u quajtur sistem operativ. Ka Control>Center, ku mund të vendosni në program dhe të monitoroni flukset e ngarkesës. Ka produkte për zhvillim në një nivel më të thjeshtë sesa lejon Ab Initio GDE.
Përshkrimi i kornizës MDW dhe punëve për përshtatjen e saj për GreenPlum
Së bashku me produktet e tij, shitësi ofron produktin MDW (Metadata Driven Warehouse), i cili është një konfigurues grafikësh, i destinuar për të ndihmuar në detyrat tipike të mbushjes së depozita të dhënash ose vault-eve të dhënash.
Ai përmban parserë metadatas përdoruesish (specifik për projektin) dhe gjeneratorë kodi “ndër shfletues”.
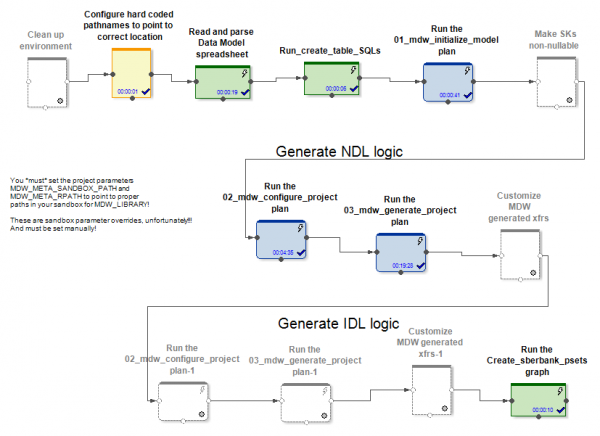
MDW merr modelin e të dhënave, një skedë konfigurimi për cilësimin e lidhjes me bazën e të dhënave (Oracle, Teradata ose Hive) dhe disa cilësime të tjera. Pjesa specifike për projektin, për shembull, e vendos modelin në bazën e të dhënave. Pjesa standarde e produktit gjeneron grafet dhe skedat e konfigurimit për to, në procesin e ngarkimit të të dhënave në tabelat e modelit. Kjo krijon grafet (dhe psets) për disa mënyra të punës fillestare dhe inkrementale për përditësimin e entiteteve.
Në rastet e Hive dhe RDBMS, gjenerohen grafet e ndryshme për përditësimin fillestar dhe inkremental të të dhënave.
Në rastin e Hive, të dhënat e dërguara të dytës kombinohen përmes Ab Initio Join me të dhënat që kanë qenë në tabelë para përditësimit. Ngarkuesit e të dhënave në MDW (si në Hive, ashtu edhe në RDBMS) jo vetëm që futin të dhëna të reja nga dëlta, por gjithashtu mbyllin periudhat e aktualitetit të të dhënave, sipas çelësave primarë për të cilët ka ardhur dëlta. Për më tepër, duhet të rilexohet përsëri pjesa e pandryshuar e të dhënave. Megjithatë, kjo është e nevojshme, pasi në Hive nuk ka operacione të fshirjes ose përditësimit.
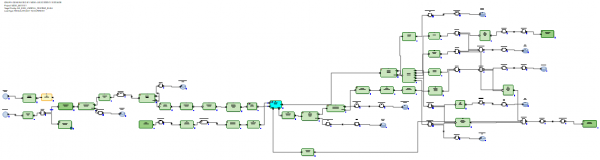
Ndërsa në rastin e RDBMS, grafet për përditësimin inkremental të të dhënave duken më optimiste, sepse RDBMS ka mundësi të vërteta për përditësim.
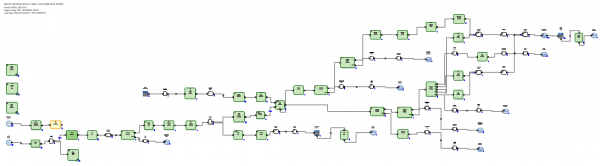
Dëlta e pranuar ngarkohet në një tabelë ndërmjetëse në bazën e të dhënave. Pas kësaj, ndodhi kombinimi i dëlta me të dhënat që ishin në tabelë para përditësimit. Kjo bëhet me anë të SQL përmes një pyetjeje SQL të gjeneruar. Më pas, përmes komandave SQL për fshirje+futje, bëhet futja e të dhënave të reja nga dëlta në tabelën e objektit dhe mbyllen periudhat e aktualitetit të të dhënave, sipas çelësave primarë për të cilët ka ardhur dëlta.
Nuk është e nevojshme të rilexohet pjesa e pandryshuar e të dhënave.
Kështu, arritëm në përfundimin se në rastin e Hive, MDW duhet të bëjë përsëri të gjithë tabelën, sepse Hive nuk ka funksion përditësimi. Dhe asgjë më e mirë se rileximi i plotë i të dhënave gjatë përditësimit nuk është krijuar. Në rastin e RDBMS, përkundrazi, krijuesit e produktit e konsideruan të nevojshme të besojnë lidhjen dhe përditësimin e tabelave për përdorimin e SQL.
Për projektin në Sberbank, ne krijuam një implementim të ri të ripërdorshëm të ngarkuesit të bazës së të dhënave për GreenPlum. Kjo ishte e bazuar në versionin që MDW gjeneron për Teradata. Pikërisht Teradata, dhe jo Oracle, ishte më e përshtatshme për këtë, pasi gjithashtu është një sistem MPP. Mënyrat e punës, si dhe sintaksa e Teradata dhe GreenPlum, rezultuan të kenë ngjashmëri.
Shembujt e dallimeve kritike për MDW midis RDBMS-ve të ndryshme janë si më poshtë. Në GreenPlum, ndryshe nga Teradata, kur krijoni tabela, duhet të shkruani një klauzolë
distributed byNë Teradata shkruhet
fshij <table> të gjitha, ndërsa në GreenPlum shkruhet
fshij nga <table>Në Oracle, për qëllime optimizimi, shkruhet
delete from t where rowid in (), ndërsa në Teradata dhe GreenPlum shkruhet
delete from t where exists (select * from delta where delta.pk=t.pk)Gjithashtu, duhet të theksojmë se për funksionimin e Ab Initio me GreenPlum, ishte e nevojshme të instalonim klientin e GreenPlum në të gjitha nodet e klasterit Ab Initio. Kjo për shkak se ne u lidhëm me GreenPlum njëherësh nga të gjitha nyjet e klasterit tonë. Dhe që leximi nga GreenPlum të ishte paralel dhe çdo rrjedhë paralele e Ab Initio të lexonte porcionin e saj të të dhënave nga GreenPlum, duhej të vendosnim në seksionin “ku” të pyetjeve SQL një konstrukcion të kuptueshëm për Ab Initio
where ABLOCAL()dhe të përcaktonim vlerën e kësaj konstrukcioni, duke e caktuar parametrin e transformimit që lexon nga DB
ablocal_expr=«string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))», e cila kompilohhet në diçka si
mod(sk,10)=3, dmth, na duhet të tregojmë GreenPlum një filtër të qartë për secilën parti. Për bazat e tjera të të dhënave (Teradata, Oracle), Ab Initio mund ta kryejë këtë paralelizim automatikisht.
Karakteristikat krahasuese të performancës së Ab Initio në punën me Hive dhe GreenPlum
Në Sberbank u zhvillua një eksperiment për të krahasuar performancën e grafikëve të gjeneruar nga MDW në lidhje me Hive dhe GreenPlum. Në kuadër të eksperimentit, në rastin e Hive kishte 5 node në të njëjtin klaster me Ab Initio, ndërsa në rastin e GreenPlum kishte 4 node në një klaster të veçantë. DMth, Hive kishte një avantazh të caktuar mbi GreenPlum “në harduer”.
U shqyrtuan dy çift grafesh që realizonin të njëjtin detyrë të përditësimit të të dhënave në Hive dhe në GreenPlum. Në këtë rast, u nisën grafikët e gjeneruar nga konfiguratori MDW:
- ngarkesa fillestare + ngarkesa inkrimetuese e të dhënave të rastësishme të gjeneruara në tabelën Hive
- ngarkesa fillestare + ngarkesa inkrimetuese e të dhënave të rastësishme të gjeneruara në një tabelë të ngjashme GreenPlum
Në të dyja rastet (Hive dhe GreenPlum) u lançuan ngarkesa në 10 rrjedha paralele në të njëjtin klaster Ab Initio. Të dhënat ndërmjetëse për llogaritjet Ab Initio u ruajtën në HDFS (në terma të Ab Initio u përdor MFS layout duke përdorur HDFS). Një rresht i të dhënave të krijuara rastësisht zinte 200 byte në të dyja rastet.
Rezultati doli si më poshtë:
Hive:
Ngarkesa fillestare në Hive
Numri i rreshtave të futur
6 000 000
60 000 000
600 000 000
Kohëzgjatja e ngarkesës fillestare
në sekonda
41
203
1 601
Ngarkesa inkrementale në Hive
Numri i rreshtave që ishin në
tabelën e synuar në fillim të eksperimentit
6 000 000
60 000 000
600 000 000
Numri i rreshtave të dytë që u aplikuan në
tabelën e synuar gjatë eksperimentit
6 000 000
6 000 000
6 000 000
Kohëzgjatja e ngarkesës inkrementale
në sekonda
88
299
2 541
GreenPlum:
Ngarkesa fillestare në GreenPlum
Numri i rreshtave të futur
6 000 000
60 000 000
600 000 000
Kohëzgjatja e ngarkesës fillestare
në sekonda
72
360
3 631
Ngarkesa inkrementale në GreenPlum
Numri i rreshtave që ishin në
tabelën e synuar në fillim të eksperimentit
6 000 000
60 000 000
600 000 000
Numri i rreshtave të dytë që u aplikuan në
tabelën e synuar gjatë eksperimentit
6 000 000
6 000 000
6 000 000
Kohëzgjatja e ngarkesës inkrementale
në sekonda
159
199
321
Duket se shpejtësia e ngarkesës fillestare si në Hive ashtu edhe në GreenPlum varet linearisht nga volumi i të dhënave dhe për shkak të pajisjeve më të mira është pak më e shpejtë për Hive se për GreenPlum.
Ngarkesa inkrementale në Hive gjithashtu varet linearisht nga volumi i të dhënave të ngarkuara më parë në tabelat e synuara dhe kalon mjaft ngadalë me rritjen e volumit. Kjo shkaktohet nga nevoja për të riparuar plotësisht tabelën e synuar. Kjo do të thotë se aplikimi i ndryshimeve të vogla në tabela të mëdha nuk është një opsion i mirë për përdorim në Hive.
Ngarkesa inkrementale në GreenPlum varion pak nga volumi i të dhënave të ngarkuara më parë në tabelat e synuara dhe kalon mjaft shpejt. Kjo arrihet falë SQL Joins dhe arkitekturës së GreenPlum, e cila lejon operacionin delete.
Pra, GreenPlum bën derdhjen e diferencës duke përdorur metodën delete+insert, ndërsa në Hive nuk ka operacione delete ose update, prandaj e gjithë masa e të dhënave në përditësimin inkremental duhej të shkruhej përsëri në tërësi. Më e dukshme është krahasimi i qelizave të theksuara me ndihmën e bold, pasi kjo përkon me variantin më të zakonshëm të shfrytëzimit të ngarkesave që kërkojnë shumë burime. Shikojmë se GreenPlum fitoi nga Hive në këtë test me 8 herë.
Puna e Ab Initio me GreenPlum në modalitetin Near Real Time
Në këtë eksperiment do të shqyrtojmë mundësinë që Ab Initio të bëjë përditësimin e tabelës GreenPlum me grupe të dhënash të krijuara rastësisht në një mod të afërt me kohën reale. Do të shqyrtojmë tabelën GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, me të cilën do të punohet.
Do të përdorim tre grafe Ab Initio për të punuar me të:
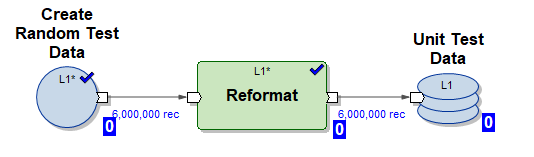
1) Grafi Create_test_data.mp – krijon në 10 rrjedha paralele skedarët me të dhëna në HDFS me 6 000 000 rreshta. Të dhënat janë rastësore, struktura e tyre është organizuar për futje në tabelën tonë.
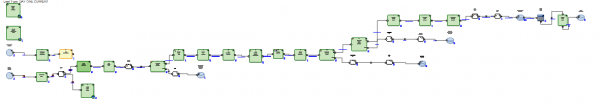
2) Grafi mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – grafi i prodhuar MDW për ngarkimin fillestar të të dhënave në tabelën tonë në 10 rrjedha paralele (përdoren të dhëna testuese, të gjeneruara nga grafi (1)).
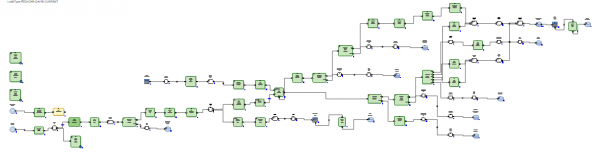
3) Grafi mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – grafi i prodhuar MDW për përmirësimin inkremental të tabelës tonë në 10 rrjedha paralele duke përdorur një skedë të dhënash të freskëta që kanë ardhur (deltat), të gjeneruara nga grafi (1).
Do të ekzekutojmë skenarin e mëposhtëm në modin NRT:
- gjeneroni 6 000 000 rreshta testues.
- bëni ngarkimin fillestar duke futur 6 000 000 rreshta testues në një tabelë bosh.
- përsëri 5 herë ngarkimin inkremental.
- gjeneroni 6 000 000 rreshta testues.
- bëni një futurë inkrementale me 6 000 000 rreshta testues në tabelë (në këtë rast, të dhënave të vjetra u caktohet një kohë skadimi valid_to_ts dhe futen të dhëna më të freskëta me të njëjtin çelës primar).
Ky skenar imiton modin e funksionimit të një sistemi të biznesit real – në kohë reale shfaqet një sasi e konsiderueshme të dhënash të reja dhe menjëherë derdhen në GreenPlum.
Tani do të shikojmë logun e punës së skenarit:
Start Create_test_data.input.pset në 2020-06-04 11:49:11.
Finish Create_test_data.input.pset në 2020-06-04 11:49:37.
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:49:37.
Finish mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:50:42.
Start Create_test_data.input.pset në 2020-06-04 11:50:42.
Finish Create_test_data.input.pset në 2020-06-04 11:51:06.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:51:06.
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:53:41.
Start Create_test_data.input.pset në 2020-06-04 11:53:41.
Finish Create_test_data.input.pset në 2020-06-04 11:54:04.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:54:04.
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:56:51.
Start Create_test_data.input.pset në 2020-06-04 11:56:51.
Finish Create_test_data.input.pset në 2020-06-04 11:57:14.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:57:14.
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 11:59:55.
Start Create_test_data.input.pset në 2020-06-04 11:59:55.
Finish Create_test_data.input.pset në 2020-06-04 12:00:23.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 12:00:23.
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset në 2020-06-04 12:03:23.
Start Create_test_data.input.pset në 2020-06-04 12:03:23.
Finish Create_test_data.input.pset në 2020-06-04 12:03:49.
Nisni mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset më 2020-06-04 12:03:49
Mbarojmë mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset më 2020-06-04 12:06:46
Kështu duket kjo pamje:
Grafiku
Koha e fillimit
Koha e mbarimit
Gjatësia
Krijo_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Krijo_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Krijo_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Krijo_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Krijo_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Krijo_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vërejmë se 6 000 000 rreshta inkrementi përpunohen brenda 3 minutash, që është mjaft shpejt.
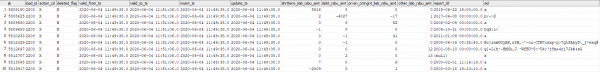
Të dhënat në tabelën e synuar rezultuan të shpërndara në këtë mënyrë:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 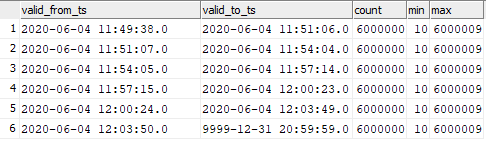
Mund të shihet përputhja e të dhënave të futura me momentet e aktivizimit të grafikëve.
Pra, mund të nisim ngarkimin inkremental të të dhënave në GreenPlum me Ab Initio me një frekuencë shumë të lartë dhe të vëzhgojmë shpejtësinë e lartë të futjes së këtyre të dhënave në GreenPlum. Sigurisht, nuk do të jetë e mundur të fillojmë çdo sekondë, pasi Ab Initio, si çdo mjet ETL, kërkon kohë "për t'u ngrohur" gjatë aktivizimit.
Përfundim
Aktualisht Ab Initio përdoret në Sberbank për ndërtimin e Një Shtrese Semantike të Dhënash (ECS). Ky projekt parashikon ndërtimin e një versioni të vetëm të gjendjes së entiteteve të ndryshme të biznesit të bankës. Informacioni vjen nga burime të ndryshme, riplikat e të cilave përgatiten në Hadoop. Në përputhje me nevojat e biznesit, përgatitet modeli i të dhënave dhe përshkruhen transformimet e të dhënave. Ab Initio ngarkon informacionin në ECS dhe të dhënat e ngarkuara jo vetëm që paraqesin interes për biznesin për vetë, por gjithashtu shërbejnë si burim për ndërtimin e vitrinave të të dhënave. Në të njëjtën kohë, funksionaliteti i produktit lejon përdorimin e sistemeve të ndryshme si pranues (Hive, Greenplum, Teradata, Oracle), duke ofruar mundësinë për të përgatitur të dhënat për biznesin në formate të ndryshme që kërkohet.
Mundësitë e Ab Initio janë të shumta, për shembull, framework-u i bashkangjitur MDW ofron mundësinë për të ndërtuar historikun teknik dhe të biznesit të të dhënave "nga kutia". Për zhvilluesit Ab Initio ofron mundësinë që "të mos shpikin biçikletën", por të përdorin një sërë komponentesh funksionale të gatshme, të cilat janë në thelb biblioteka të nevojshme për punën me të dhënat.
Autori - ekspert i komunitetit profesional të Sberbank SberProfi DWH/BigData. Komuniteti profesional SberProfi DWH/BigData është përgjegjës për zhvillimin e kompetencave në fusha të tilla si ekosistemi Hadoop, Teradata, Oracle DB, GreenPlum, si dhe në mjetet BI Qlik, SAP BO, Tableau dhe të tjera.
Burimi: habr.com
