

Përkthimi i artikullit është përgatitur para fillimit të kursit
Mësimi i shpërndarë në disa instance të fuqishme kompjuterike mund të reduktojë kohën e trajnimet të rrjeteve nervore të thella moderne mbi një volum të madh të dhënash nga disa javë në orë apo madje minuta, duke e bërë këtë teknikë mësimi dominuese në çështjet e përdorimit praktik të mësimit të thellë. Përdoruesit duhet të kuptojnë se si të ndajnë dhe sinkronizojnë të dhënat në disa instance, e cila ndikon ndjeshëm në efikasitetin e shkallëzimit. Përveç kësaj, përdoruesit gjithashtu duhet të dinë se si të vendosin një skenar trajnues në disa instance që punon në një instance.
Në këtë artikull do të flasim për një mënyrë të shpejtë dhe të lehtë të mësimit të shpërndarë duke përdorur bibliotekën e hapur për mësimin e thellë Apache MXNet dhe kuadrin e mësimit të shpërndarë Horovod. Ne do të ilustrojmë përfitimet e kuadrit Horovod në çështjet e performancës dhe do të tregojmë se si të shkruajmë një skenar trajnues MXNet që punon shpërndarë me Horovod.
Çfarë është Apache MXNet
është një kuadër i hapur për mësimin e thellë, i cili përdoret për ndërtimin, trajnimin dhe vendosjen e rrjeteve nervore të thella. MXNet e abstrakton kompleksitetin e lidhur me zbatimin e rrjeteve nervore, ka performancë të lartë dhe shkallëzim, si dhe ofron API për gjuhët e njohura të programimit si , , , , , , dhe të tjerat.
Mësimi i shpërndarë në MXNet me serverin e parametrave
përdor qasjen e serverit të parametrave (parameter server). Ai përdor një grup serverash parametrash për të mbledhur gradientët nga çdo punëtor, për të kryer agregimin dhe për të dërguar gradientët e përditësuar prapa punëtorëve për iteratën e ardhshme të optimizimit. Përcaktimi i raportit të duhur të serverëve me punëtorët është çelësi për një shkallëzim efikas. Nëse ka vetëm një server parametrash, ai mund të bëhet një ngushtim në llogaritje. Përkundrazi, nëse përdoren shumë serverë, lidhja 'shumë-për-shumë' mund të mbushë të gjitha lidhjet rrjetore.
Çfarë është Horovod
– një kornizë e hapur e mësimit të thellë të shpërndarë, e zhvilluar në Uber. Ajo përdor teknologji efikase për komunikimin midis shumë GPU dhe nyjave, siç është NVIDIA Collective Communications Library (NCCL) dhe Message Passing Interface (MPI) për të shpërndarë dhe agreguar parametrat e modelit mes punëtorëve. Optimizon përdorimin e kapacitetit të rrjetit dhe skalon mirë gjatë punës me modelet e rrjeteve nervore të thella. Aktualisht, mbështet disa korniza të njohura të mësimit të makinerisë, të cilat përfshijnë , Tensorflow, Keras, dhe PyTorch.
Integrimi i MXNet dhe Horovod
MXNet integrohet me Horovod përmes API-ve të mësimit të shpërndarë, të përcaktuar në Horovod. Në Horovod, API-të komunikative horovod.broadcast(), horovod.allgather() dhe horovod.allreduce() janë realizuar me ndihmën e kthimeve asinkrone të motorit MXNet, si pjesë e grafikës së tij të detyrave. Kështu, varësitë e të dhënave midis komunikimit dhe llogaritjeve trajtohen lehtësisht nga motori MXNet, për të shmangur humbjen e performancës për shkak të sinkronizimit. Objekti optimizer i shpërndarë, e përcaktuar në Horovod horovod.DistributedOptimizer zgjatim Optimizer në MXNet në një mënyrë që ai të thërrasë API-të përkatëse të Horovod për përditësimin e shpërndarë të parametrave. Të gjitha këto detaje të implementimit janë transparante për përdoruesit fundorë.
Nisja e shpejtë
Ju mund të filloni shpejt të trajtoni një rrjet nervor të vogël konvolucional mbi grupin e të dhënave MNIST me MXNet dhe Horovod në MacBook tuaj.
Për të filluar, instaloni mxnet dhe horovod nga PyPI:
pip install mxnet
pip install horovod
Vërejtje: Nëse hasni një gabim gjatë pip install horovod, ndoshta duhet të shtoni variablën MACOSX_DEPLOYMENT_TARGET=10.vvindex vv – është versioni i versionit tuaj të MacOS, për shembull, për MacOSX Sierra duhet të shkruani MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Pastaj instaloni OpenMPI .
Në fund, shkarkoni skriptin testues mxnet_mnist.py dhe ekzekutoni komandat e mëposhtme në terminalin e MacBook në drejtorinë e punës:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyKështu do të nisni trajnimin në dy bërthama të procesorit tuaj. Rezultati do të jetë si më poshtë:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Demonstrimi i performancës
Gjatë trajtimit të modelit ResNet50-v1 mbi grupin e të dhënave ImageNet në 64 GPU me tetë instancia p3.16xlarge EC2, secila prej të cilave përmban 8 GPU NVIDIA Tesla V100 në AWS cloud, ne arritëm një kapacitet trajnimi prej 45000 imazhe/një sekondë (dmth. numri i mostrave të trajnuara në sekondë). Trajnimi përfundoi pas 44 minutash pas 90 epokave me saktësinë më të mirë prej 75.7%.
Ne e krahasuam këtë me trajnimin e shpërndarë MXNet me qasjen e përdorimit të serverëve të parametrave në 8, 16, 32 dhe 64 GPU me një server me një parameter dhe raportin e serverëve ndaj punëtorëve 1 me 1 dhe 2 me 1 përkatësisht. Rezultatin mund ta shihni në Figurën 1 më poshtë. Në boshtin y të majtë kolonat pasqyrojnë numrin e imazheve për trajnim në sekondë, linjat pasqyrojnë efikasitetin e shkallëzimit (dmth. raporti i kapacitetit të vërtetë ndaj atij ideal) në boshtin y të djathtë. Siç e shihni, zgjedhja e numrit të serverëve ndikon në efikasitetin e shkallëzimit. Nëse ka vetëm një server parametrash, efikasiteti i shkallëzimit bie në 38% me 64 GPU. Për të arritur një efikasitet të tillë të shkallëzimit si me Horovod, është e nevojshme të dyfishohet numri i serverëve në raport me numrin e punëtorëve.
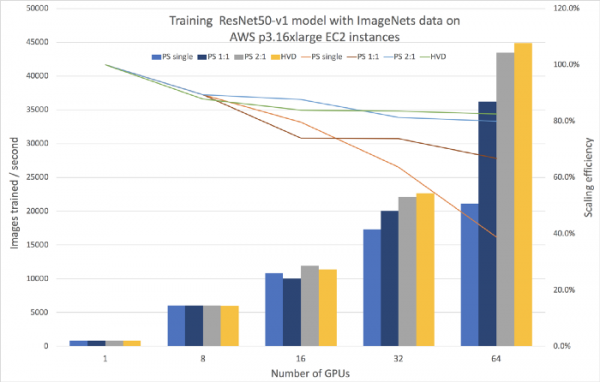
Figura 1. Krahasimi i trajnimit të shpërndarë duke përdorur MXNet me Horovod dhe me një server parametrash
Në Tabelën 1 më poshtë, ne krahasuam koston përfundimtare të instancës gjatë eksperimentimeve me 64 GPU. Përdorimi i MXNet së bashku me Horovod siguron kapacitetin më të mirë me shpenzimet më të ulëta.
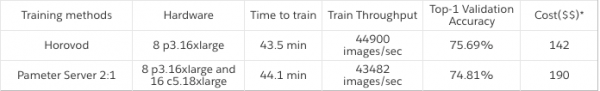
Tabela 1. Krahasimi i shpenzimeve midis Horovod dhe serverit parametrik me raportin e serverëve ndaj punëtorëve 2 me 1.
Hapat për riprodhimin
Në hapat e mëposhtëm ne do t'ju tregojmë si të riprodhoni rezultatin e trajnimit të shpërndarë duke përdorur MXNet dhe Horovod. Për të mësuar më shumë rreth trajnimit të shpërndarë me MXNet, lexoni .
Hapi 1
Krijoni një klaster të instancave homogjene me MXNet version 1.4.0 ose më lart dhe Horovod version 0.16.0 ose më lart për të përdorur trajnimin e shpërndarë. Ju gjithashtu do t'ju nevojiten bibliotekat për trajnim në GPU. Për instancat tona, ne zgjodhëm Ubuntu 16.04 Linux, me GPU Driver 396.44, CUDA 9.2, bibliotekën cuDNN 7.2.1, komunikatorin NCCL 2.2.13 dhe OpenMPI 3.1.1. Gjithashtu, mund të përdorni , ku këto biblioteka tashmë janë të instaluara.
Hapi 2
Shtoni në skriptin tuaj të trajnimit MXNet mundësinë për të punuar me API Horovod. Skripti i mëposhtëm, i bazuar në API-në MXNet Gluon, mund të përdoret si një shabllon i thjeshtë. Rreshtat e shënuar me shkronja të trasha kërkohen në rast se tashmë keni skriptin përkatës të trajnimit. Ja disa ndryshime kritike që duhet të bëni për trajnimin me Horovod:
- Vendosni kontekstin në përputhje me rangun lokal të Horovod (rreshti 8), në mënyrë që të kuptoni se trajnimi po kryhet në bërthamën e duhur grafike.
- Shkoni parametrat fillestarë nga një punëtor tek të gjithë (rreshti 18), për t'u siguruar që të gjithë punëtorët fillojnë punën me parametrat e njëjtë fillestarë.
- Krijoni Horovod DistributedOptimizer (rreshti 25), për të përditësuar parametrat në mënyrë të shpërndarë.
Për të marrë skriptin e plotë, referohuni tek shembujt e Horovod-MXNet dhe .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inizializoni Horovod
5  hvd.init()
6
7  # Horovod: ngjitni një GPU për t'u përdorur për rangun lokal
8  konteksti = mx.gpu(hvd.local_rank())
9
10 # Ndërtoni modelin
11 model = ...
12
13 # Inizializoni parametrat
14 model.initialize(initializer, ctx=konteksti)
15 params = model.collect_params()
16
17 # Horovod: transmetoni parametrat
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Krijoni optimizuesin
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: mbështillni optimizuesin me DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Krijoni trajnerin dhe funksionin e humbjes
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Trajnojeni modelin
32 për epoch në gamën e num_epoch:
33    ...
Hapi 3
Hyni në një nga punëtorët për të nisur trajnimin e shpërndarë përmes direktivës MPI. Në këtë shembull, trajnim i shpërndarë niset në katër ekzemplarë me 4 GPU në secilin, dhe me 16 GPU në total në klaster. Do të përdoret optimizuesi i gradientit stohastik (SGD) me hiperparametra të mëposhtëm:
- mini-batch size: 256
- learning rate: 0.1
- momentum: 0.9
- weight decay: 0.0001
Ndërsa po e rrisnim nga një GPU në 64 GPU, ne e rritëm linearisht shpejtësinë e të mësuarit sipas numrit të GPU-ve (nga 0.1 për 1 GPU deri në 6.4 për 64 GPU), duke mbajtur numrin e imazheve për çdo GPU në 256 (nga paketa e 256 imazheve për 1 GPU deri në 16,384 për 64 GPU). Parametrat e weight decay dhe momentum ndryshuan për sa u rrit numri i GPU-ve. Ne përdorëm mësimin me saktësi të përzier me tipin e të dhënave float16 gjatë kalimit përpara dhe float32 për gradientët, për të përshpejtuar llogaritjet e float16, të mbështetura nga GPU-të NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Përfundim
Në këtë artikull ne shqyrtuam një qasje të shkallëzueshme për trajnim të shpërndarë të modelit duke përdorur Apache MXNet dhe Horovod. Ne treguam efikasitetin e shkallëzimit dhe eficiencën ekonomike krahasuar me qasjen që përdor një server parametrash në grupin e të dhënave ImageNet, mbi të cilin u stërvit modeli ResNet50-v1. Gjithashtu, ne reflektuam hapat me anë të të cilëve mund të ndryshoni skriptin ekzistues për të nisur stërvitjen në disa instance duke përdorur Horovod.
Nëse sapo keni filluar të punoni me MXNet dhe mësimin e thellë, kaloni në faqen e instalimit , për të ndërtuar fillimisht MXNet. Po ashtu, rekomandojmë të lexoni artikullin , për të filluar punën.
Nëse tashmë keni punuar me MXNet dhe dëshironi të provoni mësimin e shpërndarë me Horovod, atëherë shikoni në , ndërtoni atë me MXNet dhe ndiqni shembullin ose .
*çmimi llogaritet mbi bazën e AWS për instancat EC2
Mësoni më shumë rreth kursit
Burimi: habr.com
