

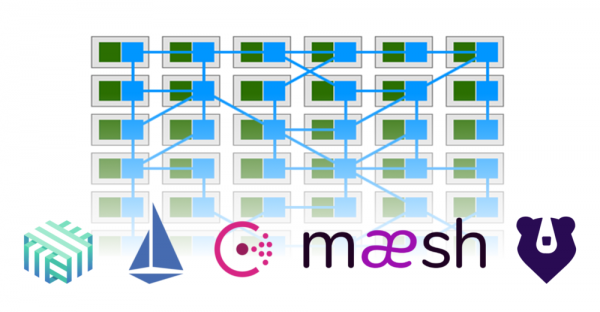
Shën. përkth.: autori i këtij artikulli (Luc Perkins) është developer advocate në organizatën CNCF, e cila është shtëpia e projekteve Open Source si Linkerd, SMI (Service Mesh Interface) dhe Kuma (meqë ra fjala, edhe ju e keni pyetur veten pse në këtë listë mungon Istio?..). Duke u përpjekur edhe një herë t’i sjellë komunitetit DevOps një kuptim më të qartë të fenomenit në modë të quajtur «service mesh», ai paraqet 16 aftësi karakteristike që ofrojnë zgjidhje të tilla.
Sot ― është një nga temat më të nxehta në fushën e inxhinierisë së softuerit (dhe me të drejtë!). Mendoj se kjo teknologji ka një potencial të jashtëzakonshëm dhe shpresoj ta shoh të përhapet gjerësisht (natyrisht, kur kjo ka kuptim). Megjithatë, për shumicën e njerëzve ajo ende mbetet e mbështjellë me një farë misteri. Madje edhe ata që e njohin mirë shpesh e kanë të vështirë të shpjegojnë qartë cilat janë përparësitë e saj dhe çfarë përfaqëson saktësisht (duke përfshirë edhe mua). Në këtë artikull do të përpiqem ta sqaroj këtë, duke renditur skenarë të ndryshëm përdorimi të «rrjeteve të shërbimeve»*.
* Shënim i përkthyesit: këtu dhe më poshtë në artikull do të përdoret pikërisht ky përkthim («rrjet shërbimesh») për termin ende relativisht të ri service mesh.
Por më parë dua të bëj disa sqarime:
- Unë nuk kam punuar kurrë me rrjete shërbimesh dhe nuk i kam përdorur ato jashtë projekteve të nisura për vetë-edukim. Nga ana tjetër, pikërisht unë kam shkruar shumë dokumentacion për service mesh-in e brendshëm të Twitter në vitin 2015 (atëherë ai ende nuk quhej as «rrjet shërbimesh») dhe kam marrë pjesë në zhvillimin e faqes dhe dokumentacionit për , kështu që kjo ndoshta ka njëfarë peshe.
- Lista ime është e përafërt dhe jo e plotë. Mund të ketë fare mirë skenarë përdorimi për të cilët nuk jam në dijeni, dhe me kalimin e kohës me siguri do të shfaqen variante të reja, ndërsa teknologjia zhvillohet dhe popullariteti i saj rritet.
- Po ashtu, jo çdo implementim ekzistues i service mesh mbështet të gjitha rastet e përdorimit të renditura më poshtë. Prandaj, shprehje të miat si «service mesh mund të…» duhen lexuar si «disa, e ndoshta të gjitha implementimet e njohura të service mesh mund të…».
- Renditja e shembujve nuk ka ndonjë rëndësi të veçantë.
Lista e shkurtër:
- zbulimi i shërbimeve;
- enkriptimi;
- autentikimi dhe autorizimi;
- balancimi i ngarkesës;
- circuit breaking;
- auto-shkallëzimi;
- deployime kanarinë;
- deployime blue-green;
- kontrolli i gjendjes;
- load shedding;
- pasqyrimi i trafikut;
- izolimi;
- kufizimi i frekuencës së kërkesave, riprovime dhe time-out;
- telemetria;
- auditimi;
- vizualizimi.
1. Zbulimi i shërbimeve
TL;DR: Lidheni me shërbime të tjera në rrjet duke përdorur emra të thjeshtë.
Shërbimet duhet të jenë në gjendje të “gjejnë” automatikisht njëri-tjetrin përmes emrave të përshtatshëm — për shembull, service.api.production, pets/staging ose cassandra. Mjediset cloud dallohen për elasticitetin e tyre dhe pas një emri mund të fshihen shumë instanca të një shërbimi. Është e qartë se në një situatë të tillë është fizikisht e pamundur të hardkodohen të gjitha adresat IP.
Për më tepër, kur një shërbim gjen një tjetër, ai duhet të jetë në gjendje t’i dërgojë kërkesa atij shërbimi pa u shqetësuar se ato do të përfundojnë te një instancë jo funksionale. Me fjalë të tjera, service mesh duhet të monitorojë gjendjen e të gjitha instancave të shërbimeve dhe ta mbajë listën e hosteve sa më të përditësuar që të jetë e mundur.
Çdo service mesh e zbaton mekanizmin e zbulimit të shërbimeve në mënyrën e vet. Aktualisht, mënyra më e përhapur është delegimi te procese të jashtme si DNS i Kubernetes. Në të kaluarën, në Twitter ne përdornim sistemin e emërtimit . Përveç kësaj, teknologjia service mesh bën të mundur krijimin e mekanizmave të personalizuar të emërtimit (megjithëse ende nuk kam hasur asnjë implementim SM me këtë funksionalitet).
2. Kriptimi
TL;DR: Hiqni dorë nga trafiku i pakriptuar midis shërbimeve dhe bëjeni këtë proces të automatizuar dhe të shkallëzueshëm.
Është qetësuese të dish se keqbërësit nuk mund të depërtojnë në rrjetin tuaj të brendshëm. Firewall-et e përballojnë shumë mirë këtë. Por çfarë ndodh nëse një haker arrin gjithsesi të futet brenda? A do të jetë në gjendje të bëjë çfarë të dojë me trafikun midis shërbimeve? Le të shpresojmë që kjo të mos ndodhë. Për të parandaluar një skenar të tillë, duhet të zbatohet një rrjet me besim zero (zero-trust), ku i gjithë trafiku ndërmjet shërbimeve është i kriptuar. Shumica e service mesh moderne e arrijnë këtë me ndihmën e (mutual TLS, mTLS). Në disa raste, mTLS funksionon në të gjithë cloud-et dhe klasterët (mendoj se një ditë edhe komunikimet ndërplanetare do të organizohen në mënyrë të ngjashme).
Sigurisht, për mTLS service mesh nuk është e detyrueshme. Çdo shërbim mund të kujdeset vetë për TLS-in e tij, por kjo do të thotë se duhet të gjeni një mënyrë për të gjeneruar certifikata, për t’i shpërndarë ato te hostet e shërbimit dhe për të përfshirë në aplikacion kodin që do t’i ngarkojë këto certifikata nga skedarët. Po, dhe mos harroni rinovimin e këtyre certifikatave në intervale të caktuara kohore. Service mesh automatizojnë mTLS me ndihmën e sistemeve si , të cilat, nga ana e tyre, automatizojnë procesin e lëshimit dhe rotacionit të certifikatave.
3. Autentikimi dhe autorizimi
TL;DR: Përcaktoni kush është iniciatori i kërkesës dhe çfarë i lejohet të bëjë, para se kërkesa të arrijë te shërbimi.
Shërbimet shpesh duan të dinë, kush po e kryen kërkesën (autentikim), dhe, duke përdorur këtë informacion, vendosin, nuk shkon, dhe gjithashtu ka një ide për atë që ndodh në shërbimet përreth, për të kuptuar, çfarë i lejohet të bëjë këtij subjekti (autorizim). Në këtë rast, pas përemrit «kush» mund të fshihen:
- Shërbime të tjera. Kjo quhet «autentikimi i peer-it». Për shembull, shërbimi
webdëshiron të ketë qasje te shërbimidb. Service mesh zakonisht i zgjidhin këto probleme me mTLS: në këtë rast, certifikatat shërbejnë si identifikuesi i nevojshëm. - Përdorues njerëzorë. Kjo quhet «autentikimi i kërkesës». Për shembull, përdoruesi
haxor69dëshiron të blejë një llambë të re. Service mesh ofrojnë mekanizma të ndryshëm, për shembull, .Shumë prej nesh e kanë bërë këtë në kodin e aplikacionit. Vjen një kërkesë, ne kontrollojmë tabelën
users, gjejmë përdoruesin dhe krahasojmë fjalëkalimin, pastaj kontrollojmë kolonënpermissionse kështu me radhë. Në rastin e service mesh, kjo ndodh para se kërkesa të arrijë te shërbimi.
Pasi të kemi përcaktuar nga ka ardhur kërkesa, duhet të vendosim çfarë i lejohet të bëjë këtij subjekti. Disa service mesh lejojnë përcaktimin e politikave bazë (për atë se kush dhe çfarë mund të bëjë) në formën e skedarëve YAML ose në vijën e komandës, ndërsa të tjerët ofrojnë integrim me framework-e si . Qëllimi përfundimtar është që shërbimet tuaja të pranojnë çdo kërkesë, duke supozuar me besim se ajo vjen nga një burim i besueshëm dhe dhe se ky veprim lejohet.
4. Balancimi i ngarkesës
TL;DR: Shpërndajeni ngarkesën midis instancave të shërbimit sipas një modeli të caktuar.
"Shërbimi" brenda rrjetit të shërbimeve shumë shpesh përbëhet nga shumë instanca identike. Për shembull, sot shërbimi cache përbëhet nga 5 kopje, ndërsa nesër numri i tyre mund të rritet në 11. Kërkesat që drejtohen te cacheduhet të shpërndahen sipas një objektivi të caktuar. Për shembull, të minimizohet vonesa ose të maksimizohet mundësia për të arritur te një instancë funksionale. Më së shpeshti përdoret algoritmi Round-robin, por ekzistojnë edhe shumë të tjerë — për shembull, metoda e kërkesave të peshuara (weighted) (mund të zgjidhen objektivat prioritare), hashimi unazor (ring) (përdorimi i hashing-ut të qëndrueshëm për hostët upstream) ose metoda e numrit më të vogël të kërkesave (përparësi i jepet instancës me numrin më të ulët të kërkesave).
Balancuesit klasikë kanë edhe funksione të tjera, si cache-imi HTTP dhe mbrojtja nga DDoS, por ato nuk janë shumë të rëndësishme për trafikun east-west (domethënë për trafikun që qarkullon brenda datacenter-it — shën. përkth.). Kjo është fusha tipike e përdorimit të service mesh. Natyrisht, nuk është e detyrueshme të përdoret service mesh për balancimin e ngarkesës, por ajo ju lejon të përcaktoni dhe të kontrolloni politikat e balancimit për çdo shërbim nga një shtresë e centralizuar menaxhimi, duke eliminuar kështu nevojën për të nisur dhe konfiguruar balancues të veçantë në stack-un e rrjetit.
5. Ndërprerja e qarkut (circuit breaking)
TL;DR: Ndaloni trafikun drejt shërbimit problematik dhe kufizoni dëmin në skenarët më të këqij.
Nëse për çfarëdo arsye një shërbim nuk e përballon trafikun, service mesh ofron disa mënyra për ta zgjidhur këtë problem (për të tjerat do të flitet në seksionet përkatëse). Circuit breaking është mënyra më drastike për ta shkëputur shërbimin nga trafiku. Megjithatë, në vetvete nuk ka kuptim — duhet një plan rezervë. Mund të parashikohet backpressure () mbi shërbimet që ekzekutojnë kërkesa (vetëm mos harroni ta konfiguroni service mesh-in tuaj për këtë!), ose, për shembull, ta ktheni faqen e statusit në të kuqe dhe t’i ridrejtoni përdoruesit te një variant tjetër i faqes me «balenën që bie» («Twitter is down»).
Rrjetet e shërbimeve ju lejojnë jo vetëm të përcaktoni, kur do të ndodhë ndërprerja dhe nuk shkon, dhe gjithashtu ka një ide për atë që ndodh në shërbimet përreth, për të kuptuar, do të pasohet nga kjo. Në këtë rast, “kur” mund të përfshijë çdo kombinim të parametrave të caktuar: numrin total të kërkesave gjatë një periudhe të caktuar, numrin e lidhjeve paralele, kërkesat pending, riprovimet aktive etj.
Me shumë gjasa nuk do të doni të abuzoni me circuit breaking, por është mirë të dini se ekziston një plan rezervë për rastet ekstreme.
6. Autoskalimi
TL;DR: Rrisni ose ulni numrin e instancave të shërbimit sipas kritereve të përcaktuara.
Service mesh-et nuk janë planifikues, prandaj nuk kryejnë skalimin vetë. Megjithatë, ato mund të ofrojnë të dhëna mbi të cilat planifikuesit do të marrin vendime. Meqenëse service mesh-et kanë qasje në të gjithë trafikun midis shërbimeve, ato disponojnë informacion të gjerë për atë që po ndodh: cilat shërbime kanë hasur probleme, cilat janë fare pak të ngarkuara (burimet e alokuara për to shpërdorohen) etj.
Për shembull, Kubernetes i shkallëzon shërbimet në varësi të përdorimit të CPU dhe memories nga pod-et (shihni prezantimin tonë “” — shën. përkth.), por nëse vendosni të kryeni shkallëzimin bazuar në çfarëdo treguesi tjetër (në rastin tonë, të lidhur me trafikun), do t’ju duhet një metrikë e veçantë. Udhëzuesi tregon se si të bëhet kjo me ndihmën e , dhe , por vetë procesi është mjaft i ndërlikuar. Ne do të donim që service mesh ta thjeshtonte këtë, duke ju lejuar thjesht të përcaktoni kushte si “rrite numrin e instancave të shërbimit auth, nëse numri i kërkesave në pritje e kalon vlerën prag për një minutë”.
7. Vendosjet canary
TL;DR: Testoni funksione ose versione të reja të shërbimit te një nëngrup përdoruesish.
Le të themi se po zhvilloni një produkt SaaS dhe planifikoni të nxirrni versionin e tij të ri. E keni testuar në staging dhe ka funksionuar shkëlqyeshëm. Megjithatë, ende keni disa dyshime se si do të sillet në kushte reale. Me fjalë të tjera, duhet të kontrolloni versionin e ri në detyra reale, pa rrezikuar besimin e përdoruesve. Canary deployment është zgjidhja ideale për këtë. Ato ju lejojnë t’ua prezantoni funksionalitetin e ri një nëngrupi të caktuar përdoruesish. Ky nëngrup mund të përbëhet nga përdoruesit më besnikë, nga ata që përdorin versionin falas të produktit ose nga përdorues që kanë shprehur dëshirën të jenë «kavie prove».
Service mesh e bëjnë këtë të mundur duke ju lejuar të përcaktoni kriteret që vendosin kush do të shohë cilin version të aplikacionit, dhe duke e rutuar trafikun në përputhje me to. Ndërkohë, për vetë shërbimet nuk ndryshon asgjë. Versioni 1.0 i shërbimit supozon se të gjitha kërkesat vijnë nga përdoruesit që duhet të shohin pikërisht atë, ndërsa versioni 1.1 mendon të njëjtën gjë për përdoruesit e vet. Ju, nga ana tjetër, mund të ndryshoni përqindjen e trafikut mes versionit të vjetër dhe atij të ri, duke ridrejtuar gjithnjë e më shumë përdorues te versioni i ri, nëse ai punon në mënyrë të qëndrueshme dhe «testuesit» tuaj japin miratimin.
8. Vendosjet blue-green
TL;DR: Nxirrni funksionalitetin e ri, por jini gati ta ktheni gjithçka menjëherë mbrapsht.
Thelbi është të nxirrni shërbimin e ri «blu», duke e nisur paralelisht me të vjetrin, «jeshil». Nëse gjithçka shkon pa probleme dhe shërbimi i ri e dëshmon veten mirë, atëherë i vjetri mund të çaktivizohet gradualisht. (Fatkeqësisht, një ditë edhe ky shërbim i ri «blu» do ta përsërisë fatin e atij «jeshil» dhe do të zhduket...) Vendosjet blue-green ndryshojnë nga canary deployment sepse funksionaliteti i ri u shfaqet të gjithë përdoruesve menjëherë (dhe jo vetëm një pjese); ideja këtu është të keni gati një «strehë rezervë» nëse papritur diçka shkon keq.
Service mesh-et ofrojnë një mënyrë shumë të përshtatshme për të testuar shërbimin «blu» dhe për të kaluar menjëherë te shërbimi funksional «jeshil» në rast problemesh. Për më tepër, ato japin edhe shumë informacion (shih pikën «Telemetria» më poshtë) për funksionimin e shërbimit «blu», gjë që ndihmon të kuptohet nëse ai është gati për përdorim të plotë.
Shën. përkth.: Më shumë rreth strategjive të ndryshme të vendosjes në Kubernetes (përfshirë canary, blue/green dhe të tjera të përmendura) mund të lexoni te .
9. Kontrolli i gjendjes
TL;DR: Monitoroni se cilat instanca të shërbimeve janë funksionale dhe reagoni ndaj atyre që pushojnë së qeni të tilla.
Kontrolli i gjendjes (health check) ndihmon për të vendosur nëse instancat e shërbimit janë gati të pranojnë dhe të përpunojnë trafikun. Për shembull, në rastin e shërbimeve HTTP, kontrolli i gjendjes mund të duket si një kërkesë GET drejt endpoint-it /health. Përgjigjja 200 OK do të thotë se instanca është në gjendje të mirë; çdo përgjigje tjetër do të thotë se ajo nuk është gati të pranojë trafik. Service mesh-et ju lejojnë të përcaktoni si metodën me të cilën do të kontrollohet funksionimi, ashtu edhe shpeshtësinë me të cilën do të kryhet ky kontroll. Kjo informacion mund të përdoret më pas për qëllime të tjera, për shembull për balancimin e ngarkesës dhe circuit breaking.
Kështu, kontrolli i gjendjes nuk është një skenar përdorimi më vete, por zakonisht përdoret për të arritur qëllime të tjera. Gjithashtu, në varësi të rezultateve të health check-eve, mund të nevojiten veprime të jashtme (në raport me qëllimet e tjera të service mesh-eve): për shembull, përditësimi i faqes së statusit, krijimi i një issue në GitHub ose plotësimi i një tikete në JIRA. Dhe service mesh ofron një mekanizëm të përshtatshëm për automatizimin e të gjitha këtyre.
10. Shpërndarja e ngarkesës (load shedding)
TL;DR: Ridrejtoni trafikun si përgjigje ndaj një rritjeje të përkohshme të përdorimit.
Nëse një shërbim i caktuar mbingarkohet nga trafiku, mund ta ridrejtoni përkohësisht një pjesë të këtij trafiku diku tjetër (domethënë ta «shkarkoni», ta «transferoni» (shed) atje). Për shembull, te një shërbim rezervë ose qendër të dhënash, ose te një topic. Si rezultat, shërbimi do të vazhdojë të përpunojë një pjesë të kërkesave në vend që të bjerë dhe të ndalojë krejtësisht përpunimin e të gjithave. Heqja e ngarkesës është më e preferueshme sesa ndërprerja e qarkut, por sërish nuk duhet abuzuar me të. Ajo ndihmon në parandalimin e dështimeve kaskadë, të cilat çojnë në rrëzimin e shërbimeve downstream.
11. Paralelizimi/pasqyrimi i trafikut
TL;DR: Dërgojeni një kërkesë njëkohësisht në disa destinacione.
Ndonjëherë lind nevoja që një kërkesë (ose një pjesë e caktuar e kërkesave) të dërgohet njëkohësisht në disa shërbime. Një shembull tipik është dërgimi i një pjese të trafikut production te një shërbim staging. Web server-i kryesor i production dërgon një kërkesë te shërbimi vartës products.production dhe vetëm tek ai. Ndërkohë, service mesh e kopjon në mënyrë inteligjente këtë kërkesë dhe e dërgon te products.staging, pa e ditur fare web server-i.
Një tjetër skenar i lidhur i përdorimit të service mesh, që mund të zbatohet mbi paralelizimin e trafikut, është . Ai parashikon dërgimin e të njëjtave kërkesa te versione të ndryshme të shërbimit dhe verifikimin nëse të gjitha versionet sillen njësoj. Ende nuk më ka rastisur të shoh një implementim të service mesh me një sistem të integruar të testimit të regresionit si , por vetë ideja duket premtuese.
12. Izolimi
TL;DR: Ndajeni service mesh tuaj në mini-rrjete.
I njohur gjithashtu si segmentimi, izolimi është arti i ndarjes së service mesh në segmente logjikisht të veçuara, të cilat nuk dinë asgjë për njëri-tjetrin. Izolimi i ngjan disi krijimit të rrjeteve private virtuale. Dallimi themelor është se ju prapë mund të përfitoni nga të gjitha avantazhet e service mesh (si zbulimi i shërbimeve), por me siguri shtesë. Për shembull, nëse një sulmues arrin të depërtojë në një shërbim brenda njërës prej nënrrjeteve, ai nuk do të mund të shohë se cilat shërbime ekzekutohen në nënrrjetet e tjera ose të përgjojë trafikun e tyre.
Përveç kësaj, përfitimet mund të jenë edhe organizative. Mund të dëshironi t’i ndani shërbimet në nënrrjete sipas strukturës së kompanisë dhe t’i çlironi zhvilluesit nga ngarkesa njohëse që shkakton nevoja për ta mbajtur në mendje të gjithë service mesh.
13. Kufizimi i frekuencës së kërkesave, riprovimet dhe timeout-et
TL;DR: Nuk ka më nevojë t’i fusni në bazën e kodit detyrat e përditshme për menaxhimin e kërkesave.
Të gjitha këto mund të konsideroheshin si raste përdorimi më vete, por vendosa t’i bashkoj për shkak të një veçorie të përbashkët: ato marrin përsipër detyrat e menaxhimit të ciklit të jetës së kërkesave, të cilat zakonisht i kryejnë bibliotekat e aplikacioneve. Nëse zhvilloni një web server në Ruby on Rails (jo të integruar me service mesh), i cili dërgon kërkesa te shërbimet backend përmes , aplikacioni do të duhet të vendosë vetë çfarë të bëjë nëse N kërkesa dështojnë. Gjithashtu do të duhet të përcaktohet sa trafik mund të përpunojnë këto shërbime dhe këto parametra të hardcode-ohen me ndihmën e një biblioteke të veçantë. Për më tepër, aplikacioni do të duhet të vendosë kur është koha të heqë dorë dhe të lejojë që kërkesa të skadojë (sipas timeout). Dhe për të ndryshuar cilindo nga parametrat e mësipërm, web server-i do të duhet të ndalet, të rikonfigurohet dhe të niset sërish.
Kalimi i këtyre detyrave te service mesh do të thotë jo vetëm që zhvilluesit e shërbimeve nuk do të duhet të mendojnë më për to, por edhe që ato mund të trajtohen në një nivel më të gjerë. Nëse përdoret një zinxhir kompleks shërbimesh, për shembull, A -> B -> C -> D -> E, duhet marrë parasysh i gjithë cikli i jetës së kërkesës. Nëse synohet të zgjaten timeout-et në shërbimin C, ka kuptim që kjo të bëhet njëherazi dhe jo pjesë-pjesë: duke përditësuar kodin e shërbimit dhe duke pritur që pull request të pranohet e që sistemi CI të vendosë versionin e përditësuar të shërbimit.
14. Telemetria
TL;DR: Mblidhni të gjithë informacionin e nevojshëm (dhe jo vetëm) nga shërbimet.
Telemetria është një term i përgjithshëm që përfshin metrika, gjurmim të shpërndarë dhe log-e. Service mesh ofrojnë mekanizma për mbledhjen dhe përpunimin e të tre këtyre llojeve të të dhënave. Këtu gjithçka bëhet disi më e paqartë, sepse numri i varianteve të mundshme është shumë i madh. Për mbledhjen e metrikave ka dhe mjete të tjera, për mbledhjen e log-eve mund të përdoren , , etj. (për shembull, ClickHouse me për K8s — shën. e përkth.), ndërsa për gjurmimin e shpërndarë ka etj. Çdo service mesh mund të mbështesë disa mjete dhe të mos mbështesë të tjera. Do të jetë interesante të shihet nëse projekti do të mund të sjellë njëfarë konvergjence.
Në këtë rast, përparësia e teknologjisë service mesh qëndron në faktin se kontejnerët sidecar, në parim, mund t’i mbledhin të gjitha të dhënat e mësipërme nga shërbimet e tyre. Me fjalë të tjera, ju merrni një sistem të unifikuar për mbledhjen e telemetrisë dhe service mesh mund ta përpunojë gjithë këtë informacion në mënyra të ndryshme. Për shembull:
- të bëni tail të logjeve të një shërbimi të caktuar në CLI;
- të monitoroni volumin e kërkesave nga paneli i monitorimit të service mesh;
- të mblidhni gjurmime të shpërndara dhe t’i ridrejtoni ato në një sistem si Jaeger.
Kujdes, gjykim subjektiv: Në përgjithësi, telemetria është ajo fushë ku ndërhyrja e fortë e service mesh nuk është e dëshirueshme. Mbledhja e informacionit bazë dhe ndjekja në kohë reale e disa “metrikave të arta”, si përqindja e kërkesave të suksesshme dhe vonesat, është krejt normale, por le të shpresojmë që të mos shohim shfaqjen e disa stack-eve Frankenstein që do të përpiqen të zëvendësojnë sisteme të specializuara, disa prej të cilave tashmë e kanë provuar veten shumë mirë dhe janë studiuar gjerësisht.
15. Auditimi
TL;DR: Ai që harron mësimet e historisë, është i dënuar t’i përsërisë ato.
Auditimi është arti i vëzhgimit të ngjarjeve të rëndësishme në sistem. Në rastin e service mesh, kjo mund të nënkuptojë ndjekjen e asaj se kush ka bërë kërkesa ndaj endpoint-eve specifike të shërbimeve të caktuara ose sa herë ka ndodhur gjatë muajit të fundit një ngjarje e caktuar që lidhet me sigurinë.
Është e qartë se auditimi është shumë i lidhur ngushtë me telemetrinë. Dallimi është se telemetria zakonisht lidhet me gjëra si performanca dhe qëndrueshmëria teknike, ndërsa auditimi mund të ketë të bëjë me çështje ligjore dhe tema të tjera që dalin përtej sferës rreptësisht teknike (për shembull, përputhshmëria me kërkesat e GDPR — Rregullores së Përgjithshme të BE-së për Mbrojtjen e të Dhënave).
16. Vizualizimi
TL;DR: Rroftë React.js — burim i pashtershëm i ndërfaqeve të çuditshme.
Ndoshta ka një term më të përshtatshëm, por unë nuk e di. Thjesht kam parasysh paraqitjen grafike të service mesh ose të disa prej komponentëve të saj. Këto vizualizime mund të përfshijnë tregues si vonesat mesatare, informacion mbi konfigurimin e kontejnerëve sidecar, rezultatet e kontrollit të gjendjes dhe njoftimet.
Puna në një mjedis të orientuar drejt shërbimeve shoqërohet me një ngarkesë njohëse shumë më të lartë krahasuar me Madhërinë e Tij Monolitin. Prandaj, kjo ngarkesë duhet ulur me çdo kusht. Edhe një ndërfaqe e thjeshtë grafike për service mesh, ku mjafton të klikoni një buton për të marrë rezultatin e dëshiruar, mund të ketë rëndësi vendimtare për rritjen e popullaritetit të kësaj teknologjie.
Nuk u përfshinë në listë
Fillimisht kisha ndërmend të përfshija në listë edhe disa skenarë të tjerë përdorimi, por më pas vendosa të mos e bëja. Ja cilët janë, së bashku me arsyet e këtij vendimi:
- Multi-data center. Sipas mendimit tim, kjo nuk është aq një skenar përdorimi, sa një fushë e ngushtë dhe konkrete e zbatimit të service mesh ose e një grupi funksionesh si zbulimi i shërbimeve.
- Ingress dhe egress. Kjo është një fushë e lidhur, por unë e kufizova veten (ndoshta artificialisht) te skenari i përdorimit të “trafikut east-west”. Ingress dhe egress meritojnë një artikull më vete.
Përfundim
Kaq për momentin! Edhe një herë, kjo listë është mjaft relative dhe me shumë gjasa jo e plotë. Nëse ju duket se kam lënë diçka pa përmendur ose kam gabuar diku, më kontaktoni në Twitter (). Ju lutem, respektoni rregullat e mirësjelljes.
P.S. nga përkthyesi
Si bazë për ilustrimin kryesor të artikullit është përdorur një imazh nga artikulli “” (autor — Gregory MacKinnon). Ai tregon se si një pjesë e funksionalitetit është zhvendosur nga aplikacionet (me ngjyrë të gjelbër) te service mesh, e cila siguron ndërlidhjen mes tyre (me ngjyrë blu të çelët).
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
