

Zhvillimi i një depoje të dhënash është një proces i gjatë dhe serioz.
Shumë gjëra në jetën e një projekti varen nga sa mirë janë menduar modeli i objekteve dhe struktura e bazës së të dhënave që në fillim.
Qasja e pranuar gjerësisht ka qenë dhe mbetet kombinimi i varianteve të ndryshme të skemës “yll” me formën e tretë normale. Zakonisht, sipas parimit: të dhënat burimore — 3NF, data mart-et — yll. Kjo qasje, e provuar me kohën dhe e mbështetur nga një numër i madh studimesh, është gjëja e parë (dhe ndonjëherë e vetmja) që i vjen në mendje një specialisti me përvojë të DWH kur mendon se si duhet të duket një depo analitike e të dhënave.
Nga ana tjetër, biznesi në tërësi dhe kërkesat e klientit në veçanti priren të ndryshojnë shpejt, ndërsa të dhënat të rriten si “në thellësi”, ashtu edhe “në gjerësi”. Pikërisht këtu del në pah mangësia kryesore e skemës yll — fleksibiliteti i kufizuar.
Dhe nëse në jetën tuaj të qetë e komode si zhvillues DWH papritur:
- u shfaq detyra “të bëjmë shpejt të paktën diçka, pastaj do të shohim”;
- u shfaq një projekt me zhvillim të vrullshëm, me lidhjen e burimeve të reja dhe rishikimin e modelit të biznesit të paktën një herë në javë;
- u shfaq një klient që nuk e ka të qartë si duhet të duket sistemi dhe cilat funksione duhet të kryejë në fund, por është i gatshëm për eksperimente dhe për saktësimin gradual të rezultatit të dëshiruar, duke iu afruar atij hap pas hapi;
- hyri menaxheri i projektit me lajmin e gëzueshëm: “Dhe tani kemi Agile!”.
Ose nëse thjesht ju intereson të mësoni se si tjetër mund të ndërtohen depot e të dhënave — mirë se vini më poshtë!
Çfarë do të thotë «fleksibilitet»
Së pari, le të përcaktojmë se çfarë vetish duhet të ketë një sistem që të mund të quhet “fleksibël”.
Më vete vlen të theksohet se vetitë e përshkruara duhet t’i referohen pikërisht sistemit, dhe jo procesit të zhvillimit të tij. Prandaj, nëse donit të lexonit për Agile si metodologji zhvillimi, më mirë shihni artikuj të tjerë. Për shembull, po këtu, në Habr, ka shumë materiale interesante (si dhe , ashtu edhe ).
Kjo nuk do të thotë se procesi i zhvillimit dhe struktura e DW nuk kanë fare lidhje mes tyre. Në përgjithësi, ndërtimi i një depoje të dhënash me arkitekturë fleksibile sipas Agile duhet të jetë dukshëm më i lehtë. Megjithatë, në praktikë më shpesh hasen kombinime si zhvillimi sipas Agile i një DWH klasik sipas Kimball dhe Data Vault sipas waterfall, sesa përputhje të lumtura të fleksibilitetit në të dyja format e tij brenda të njëjtit projekt.
Pra, çfarë aftësish duhet të ketë një depo fleksibile e të dhënave? Këtu mund të veçohen tre pika:
- Dorëzim i hershëm dhe përmirësim i shpejtë — kjo do të thotë se, në rastin ideal, rezultati i parë i biznesit (për shembull, raportet e para funksionale) duhet të merret sa më herët të jetë e mundur, pra ende përpara se sistemi të projektohet dhe të zbatohet plotësisht në tërësi. Në të njëjtën kohë, çdo përmirësim pasues duhet gjithashtu të marrë sa më pak kohë.
- Përmirësim iterativ — kjo do të thotë se çdo përmirësim i radhës, në rastin ideal, nuk duhet të ndikojë funksionalitetin që tashmë është në punë. Pikërisht kjo pikë shpesh kthehet në makthin më të madh në projektet e mëdha — herët a vonë, objektet e veçanta fillojnë të mbingarkohen me aq shumë lidhje, sa bëhet më e lehtë të përsëritet plotësisht logjika në një kopje pranë saj, sesa të shtohet një fushë në tabelën ekzistuese. Dhe nëse ju habit fakti që analiza e ndikimit të një përmirësimi mbi objektet ekzistuese mund të marrë më shumë kohë se vetë përmirësimi, ka shumë të ngjarë që ende të mos keni punuar me DW të mëdha në sektorin bankar ose në telekom.
- Përshtatje e vazhdueshme ndaj kërkesave të biznesit që ndryshojnë — struktura e përgjithshme e objekteve duhet të projektohet jo thjesht duke marrë parasysh zgjerimin e mundshëm, por duke llogaritur që drejtimi i zgjerimit të ardhshëm mund të jetë diçka që as nuk do t’ju shkonte në mendje në fazën e projektimit.
Dhe po, përmbushja e të gjitha këtyre kërkesave në një sistem të vetëm është e mundur (natyrisht, në raste të caktuara dhe me disa kufizime).
Më poshtë do të shqyrtoj dy metodologjitë më të njohura të projektimit fleksibil për DW — Anchor model dhe Data Vault. Jashtë këtij materiali mbeten teknika kaq të mira si, për shembull, EAV, 6NF (në formën e pastër) dhe gjithçka që lidhet me zgjidhjet NoSQL — jo sepse janë disi më të dobëta, madje as sepse në këtë rast artikulli do të rrezikonte të merrte përmasat e një disertacioni mesatar. Thjesht, të gjitha këto i përkasin zgjidhjeve të një klase disi tjetër — ose teknikave që mund t’i përdorni në raste specifike, pavarësisht nga arkitektura e përgjithshme e projektit tuaj (si EAV), ose paradigmave thelbësisht të ndryshme të ruajtjes së informacionit (si, për shembull, bazat e të dhënave grafike dhe variante të tjera të NoSQL).
Problemet e qasjes “klasike” dhe zgjidhjet e tyre në metodologjitë fleksibile
Me qasjen “klasike” kam parasysh modelin e vjetër të mirë me yll (pavarësisht nga implementimi konkret i shtresave më poshtë, më falshin adhuruesit e Kimball, Inmon dhe CDM).
1. Kardinaliteti i ngurtë i marrëdhënieve
Në bazë të një modeli të tillë vendoset një ndarje e qartë e të dhënave në dimensione (Dimension) dhe fakte (Fact). Dhe kjo, dreqi ta hajë, është logjike — sepse analiza e të dhënave në shumicën dërrmuese të rasteve reduktohet pikërisht në analizën e treguesve të caktuar numerikë (fakteve) sipas prerjeve të caktuara (dimensioneve).
Ndërkohë, lidhjet midis objekteve përcaktohen si lidhje midis tabelave përmes çelësit të huaj. Kjo duket krejt e natyrshme, por menjëherë sjell kufizimin e parë të fleksibilitetit — përcaktimin e ngurtë të kardinalitetit të marrëdhënieve.
Kjo do të thotë që në fazën e projektimit të tabelave duhet të përcaktoni saktësisht për çdo çift objektesh të lidhura nëse ato mund të jenë në marrëdhënie shumë-me-shumë, apo vetëm një-me-shumë, dhe “në cilin drejtim”. Nga kjo varet drejtpërdrejt se në cilën prej tabelave do të jetë çelësi primar dhe në cilën — çelësi i huaj. Ndryshimi i kësaj marrëdhënieje pas marrjes së kërkesave të reja me shumë gjasa do të çojë në ripunimin e bazës së të dhënave.
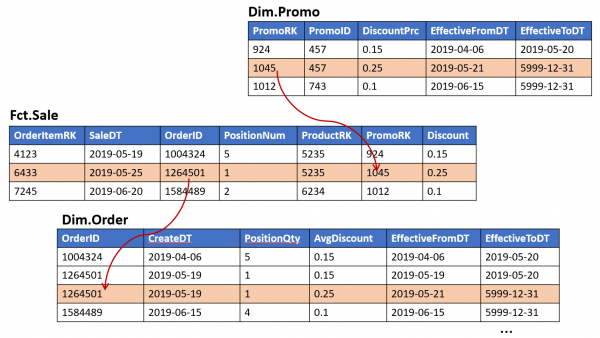
Për shembull, duke projektuar objektin “kupon fiskal”, ju, duke u mbështetur te garancitë solemne të departamentit të shitjeve, keni parashikuar mundësinë e veprimit të një promocioni mbi disa rreshta të kuponit (por jo anasjelltas):
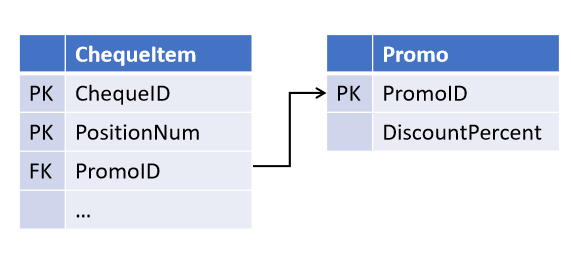
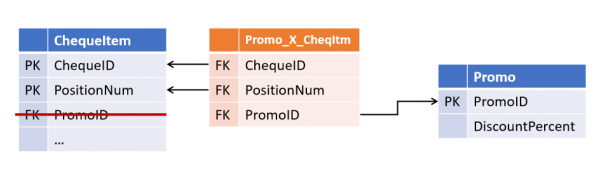
Dhe pas njëfarë kohe, kolegët prezantuan një strategji të re marketingu, në të cilën mbi të njëjtin rresht mund të veprojnë disa promocione njëkohësisht. Dhe tani duhet të përpunoni tabelat më tej, duke e veçuar marrëdhënien në një objekt më vete.
(Të gjitha objektet derivuese ku bëhet join i çekut me promon tani gjithashtu kërkojnë përpunim shtesë).
Lidhjet në Data Vault dhe Anchor Model
Shmangia e një situate të tillë doli të ishte mjaft e thjeshtë: mjafton të mos i besohet departamentit të shitjeve dhe të gjitha lidhjet të ruhen që në fillim në tabela të veçanta dhe të trajtohen si many-to-many.
Kjo qasje u propozua nga Dan Linstedt si pjesë e paradigmës së Data Vault dhe u mbështet plotësisht nga Lars Rönnbäck në Anchor Model.
Si rezultat, marrim veçorinë e parë dalluese të metodologjive fleksibël:
Lidhjet midis objekteve nuk ruhen në atributet e entiteteve prind, por përfaqësojnë një lloj më vete objektesh.
Në Data Vault këto tabela ndërlidhëse quhen Link, ndërsa në Anchor Model — Tie. Në pamje të parë ato janë shumë të ngjashme, megjithëse dallimet e tyre nuk kufizohen vetëm te emri (për çka do të flasim më poshtë). Në të dy arkitekturat, tabelat ndërlidhëse mund të lidhin çfarëdo numri entitetesh (jo domosdoshmërisht 2).
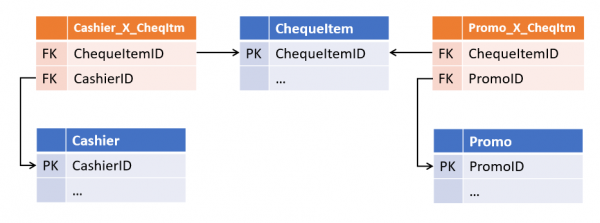
Kjo tepricë, që në pamje të parë duket e panevojshme, jep fleksibilitet të konsiderueshëm gjatë ndryshimeve. Kjo strukturë bëhet tolerante jo vetëm ndaj ndryshimit të kardinaliteteve të lidhjeve ekzistuese, por edhe ndaj shtimit të të rejave — nëse tani një pozicion çeku do të ketë edhe një referencë te arkëtari që e ka regjistruar, shfaqja e një lidhjeje të tillë do të jetë thjesht një shtresë shtesë mbi tabelat ekzistuese, pa ndikuar në asnjë objekt apo proces ekzistues.
2. Dublikimi i të dhënave
Problemi i dytë që zgjidhet nga arkitekturat fleksibël është më pak i dukshëm dhe është karakteristik kryesisht për dimensionet e tipit SCD2 (dimensione me ndryshim të ngadaltë të tipit 2), megjithëse jo vetëm për to.
Në një depo klasike të të dhënave, dimensioni zakonisht përfaqëson një tabelë që përmban një çelës zëvendësues (si PK), si edhe një grup çelësash biznesi dhe atributesh në kolona të veçanta.
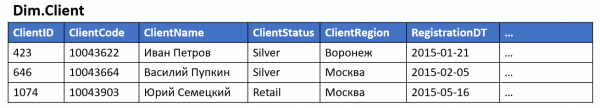
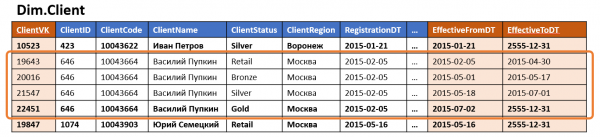
Nëse dimensioni mbështet versionim, grupit standard të fushave i shtohen kufijtë kohorë të vlefshmërisë së versionit, dhe për një rresht në burim krijohen disa versione në depo (nga një për çdo ndryshim të atributeve të versionuara).
Nëse dimensioni përmban të paktën një atribut versionues që ndryshon shpesh, numri i versioneve të këtij dimensioni do të jetë i konsiderueshëm (edhe nëse atributet e tjera nuk janë versionuese ose nuk ndryshojnë kurrë), ndërsa nëse ka disa atribute të tilla, numri i versioneve mund të rritet në progresion gjeometrik në varësi të numrit të tyre. Një dimension i tillë mund të zërë hapësirë të konsiderueshme në disk, megjithëse pjesa më e madhe e të dhënave të ruajtura në të janë thjesht dublikatë të vlerave të atributeve të pandryshueshme nga rreshta të tjerë.
Për më tepër, shumë shpesh përdoret edhe denormalizimi — një pjesë e atributeve ruhen qëllimisht si vlerë dhe jo si referencë ndaj një klasifikuesi ose dimensioni tjetër. Kjo qasje përshpejton qasjen në të dhëna, duke ulur numrin e join-eve gjatë aksesimit të dimensionit.
Si rregull, kjo çon në faktin që i njëjti informacion ruhet njëkohësisht në disa vende. Për shembull, informacioni për rajonin e banimit dhe përkatësinë në kategorinë e klientit mund të ruhet njëkohësisht në dimensionin “Klient” dhe në faktet “Blerje”, “Dorëzim” dhe “Kontakte me call center”, si edhe në tabelën ndërlidhëse “Klient — Menaxher i klientit”.
Në përgjithësi, sa u përshkrua më sipër vlen edhe për dimensionet e zakonshme (jo versionuese), por te dimensionet versionuese kjo mund të marrë përmasa të tjera: shfaqja e një versioni të ri të objektit (sidomos në mënyrë retroaktive) nuk sjell thjesht përditësimin e të gjitha tabelave të lidhura, por edhe shfaqjen kaskadë të versioneve të reja të objekteve të lidhura — kur Tabela 1 përdoret për ndërtimin e Tabelës 2, ndërsa Tabela 2 përdoret për ndërtimin e Tabelës 3, e kështu me radhë. Edhe nëse asnjë atribut i Tabelës 1 nuk merr pjesë në ndërtimin e Tabelës 3 (dhe në të marrin pjesë atribute të tjera të Tabelës 2, të marra nga burime të tjera), përditësimi versionues i kësaj strukture, të paktën, do të sjellë kosto shtesë operative, ndërsa në rastin më të keq — versione të panevojshme në Tabelën 3, e cila këtu në fakt “nuk ka lidhje fare”, dhe më tej përgjatë gjithë zinxhirit.
3. Kompleksitet jolinear i përpunimeve
Për më tepër, çdo data mart i ri që ndërtohet mbi bazën e një tjetri rrit numrin e pikave ku të dhënat mund të “dalin nga sinkroni” gjatë ndryshimeve në ETL. Kjo, nga ana tjetër, sjell rritje të kompleksitetit (dhe kohëzgjatjes) së çdo përpunimi të mëpasshëm.
Nëse sa më sipër vlen për sisteme me procese ETL që përpunohen rrallë, mund të punohet në një paradigmë të tillë — mjafton thjesht të kontrollohet që përmirësimet e reja të aplikohen saktë në të gjitha objektet e lidhura. Por nëse përmirësimet bëhen shpesh, gjasat për të “harruar” rastësisht disa lidhje rriten ndjeshëm.
Nëse, për më tepër, merret parasysh se ETL “me versionim” është dukshëm më i ndërlikuar se ai “pa versionim”, shmangia e gabimeve gjatë përpunimeve të shpeshta të gjithë këtij sistemi bëhet mjaft e vështirë.
Ruajtja e objekteve dhe atributeve në Data Vault dhe Anchor Model
Qasja e propozuar nga autorët e arkitekturave fleksibile mund të formulohet kështu:
Duhet të ndahet ajo që ndryshon nga ajo që mbetet e pandryshueshme. Pra, çelësat duhen ruajtur veçmas nga atributet.
Megjithatë, nuk duhet ngatërruar pa versionim atributi me të pandryshueshëm: i pari nuk ruan historinë e ndryshimeve të veta, por mund të ndryshojë (për shembull, gjatë korrigjimit të një gabimi në futje ose pas marrjes së të dhënave të reja), ndërsa i dyti nuk ndryshon kurrë.
Pikëpamjet mbi atë se çfarë saktësisht mund të konsiderohet e pandryshueshme në Data Vault dhe Anchor Model ndryshojnë.
Nga pikëpamja e arkitekturës Data Vault, i pandryshueshëm mund të konsiderohet i gjithë grupi i çelësave — natyrorë (NIPT-i i organizatës, kodi i produktit në sistemin burimor etj.) dhe surrogate. Ndërkohë, atributet e tjera mund të ndahen në grupe sipas burimit dhe/ose shpeshtësisë së ndryshimeve dhe për secilin grup të mbahet një tabelë më vete me një grup versionesh të pavarura.
Ndërsa në paradigmën e Anchor Model i pandryshueshëm konsiderohet vetëm çelësi surrogate i entitetit. Gjithçka tjetër (përfshirë çelësat natyrorë) është thjesht një rast i veçantë i atributeve të tij. Në të njëjtën kohë, të gjitha atributet janë të pavarura nga njëri-tjetri si parazgjedhje, prandaj për secilin atribut duhet të krijohet një tabelë më vete.
Në Data Vault tabelat që përmbajnë çelësat e entiteteve quhen Hub-e (Hub). Hub-et përmbajnë gjithmonë një grup fushash fikse:
- Çelësat natyrorë të entitetit
- Çelësi surrogate
- Referenca te burimi
- Koha e shtimit të regjistrimit
Regjistrimet në Hub-e nuk ndryshojnë kurrë dhe nuk kanë versione. Nga ana e jashtme, hub-et janë shumë të ngjashëm me tabelat e tipit ID-map që përdoren në disa sisteme për gjenerimin e surrogateve, megjithatë në Data Vault rekomandohet që si surrogate të përdoret jo një sekuencë me numra të plotë, por një hash i grupit të çelësave të biznesit. Kjo qasje thjeshton ngarkimin e lidhjeve dhe atributeve nga burimet (nuk ka nevojë të bëhen join me hub-in për të marrë surrogate-in, mjafton të llogaritet hash-i nga çelësi natyror), por mund të sjellë probleme të tjera (të lidhura, për shembull, me kolizionet, regjistrin e shkronjave dhe karakteret e paprintueshme në çelësat tekstualë etj.), prandaj nuk konsiderohet si praktikë universalisht e pranuar.
Të gjitha atributet e tjera të entiteteve ruhen në tabela të posaçme, të quajtura Satelitë (Satellit). Një hub mund të ketë disa satelitë që ruajnë grupe të ndryshme atributesh.
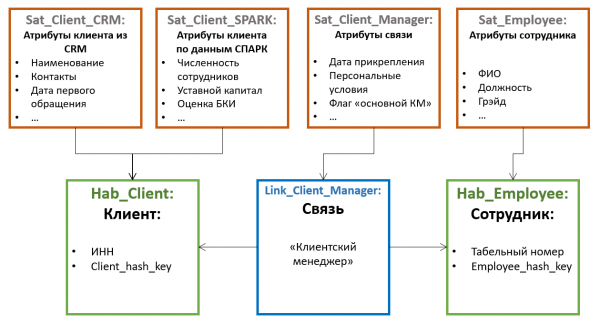
Shpërndarja e atributeve ndërmjet satelitëve bëhet sipas parimit të ndryshimit të përbashkët — në një satelit mund të ruhen atribute jo-versionale (për shembull, data e lindjes dhe numri personal për një person fizik), në një tjetër atribute versionale që ndryshojnë rrallë (për shembull, mbiemri dhe numri i pasaportës), ndërsa në një të tretë atribute që ndryshojnë shpesh (për shembull, adresa e dorëzimit, kategoria, data e porosisë së fundit etj.). Versionimi në këtë rast mbahet në nivelin e satelitëve individualë, jo të entitetit në tërësi, ndaj shpërndarja e atributeve është e arsyeshme të bëhet në mënyrë që mbivendosja e versioneve brenda një sateliti të jetë minimale (gjë që ul numrin e përgjithshëm të versioneve të ruajtura).
Gjithashtu, për të optimizuar procesin e ngarkimit të të dhënave, atributet e marra nga burime të ndryshme shpesh ndahen në satelitë të veçantë.
Satelitët lidhen me Hub-in përmes çelësit të jashtëm (që korrespondon me kardinalitetin 1-me-shumë). Kjo do të thotë se vlerat e shumëfishta të atributeve (për shembull, disa numra telefoni kontakti për një klient) mbështeten nga kjo arkitekturë “si parazgjedhje”.
Në Modelit Anchor (Anchor Model) tabelat që ruajnë çelësat quhen Anchors (Anchor). Dhe ato ruajnë:
- Vetëm çelësa surrogate
- Referenca te burimi
- Koha e shtimit të regjistrimit
Çelësat natyrorë, nga këndvështrimi i Modelit Anchor, konsiderohen si atribute të zakonshme. Ky variant mund të duket më i vështirë për t’u kuptuar, por ofron shumë më tepër hapësirë për identifikimin e objektit.
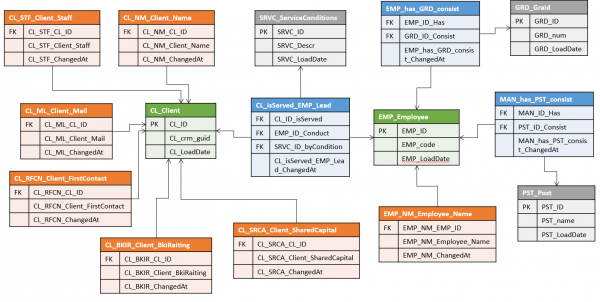
Për shembull, nëse të dhënat për të njëjtin entitet mund të vijnë nga sisteme të ndryshme, ku secili përdor çelësin e vet natyror. Në Data Vault kjo mund të çojë në struktura mjaft të rënda me disa hub-e (nga një për çdo burim + një version master që i bashkon), ndërsa në Anchor Model çelësi natyror i çdo burimi vendoset në atributin e vet dhe mund të përdoret gjatë ngarkimit pavarësisht nga të gjithë të tjerët.
Por këtu fshihet edhe një moment delikat: nëse në një entitet bashkohen atribute nga sisteme të ndryshme, me shumë gjasa ekzistojnë disa rregulla të “bashkimit”, sipas të cilave sistemi duhet të kuptojë se regjistrimet nga burime të ndryshme i përkasin të njëjtit instancë të entitetit.
Në Data Vault Këto rregulla, me shumë gjasa, do të përcaktojnë formimin e “hub-it surrogate” të entitetit master dhe nuk do të ndikojnë aspak te Hub-et që ruajnë çelësat natyrorë të burimeve dhe atributet e tyre fillestare. Nëse në një moment rregullat e bashkimit ndryshojnë (ose vjen një përditësim i atributeve mbi të cilat ai kryhet), do të mjaftojë të riformohen hub-et surrogate.
Në Anchor Model ndërkaq një entitet i tillë, me shumë gjasa, do të ruhet në një ankorë të vetme. Kjo do të thotë se të gjitha atributet, pavarësisht nga cili burim janë marrë, do të lidhen me të njëjtin surrogate. Ndarja e regjistrimeve të bashkuara gabimisht dhe, në përgjithësi, ndjekja e vlefshmërisë së bashkimit në një sistem të tillë mund të rezultojë dukshëm më e vështirë, sidomos nëse rregullat janë mjaft komplekse dhe ndryshojnë shpesh, ndërsa i njëjti atribut mund të merret nga burime të ndryshme (edhe pse kjo është plotësisht e mundur, pasi çdo version i atributit ruan referencën te burimi i vet).
Në çdo rast, nëse në sistemin tuaj parashikohet zbatimi i funksionalitetit për deduplikim, bashkim regjistrimesh dhe elemente të tjera të MDM, ia vlen të analizohen me kujdes të veçantë aspektet e ruajtjes së çelësave natyrorë në metodologjitë fleksibile. Ka gjasa që struktura më e rëndë e Data Vault të dalë papritur më e sigurt nga këndvështrimi i gabimeve të bashkimit.
Anchor Model gjithashtu parashikon një lloj shtesë objekti, të quajtur Nyja (Knot) në thelb, kjo është një formë e degjeneruar e ankorës, i cili mund të përmbajë vetëm një atribut. Nyjet supozohet të përdoren për ruajtjen e referencave të thjeshta (për shembull gjinia, statusi martesor, kategoria e shërbimit të klientit etj.). Ndryshe nga Anchor, Nyja nuk ka tabela atributesh të lidhura, ndërsa atributi i saj i vetëm (emri) ruhet gjithmonë në të njëjtën tabelë me çelësin. Nyjet lidhen me Anchor përmes tabelave të lidhjes (Tie), njësoj si lidhen anchorët me njëri-tjetrin.
Nuk ka një mendim të vetëm për përdorimin e Nyjeve. Për shembull, , i cili promovon në mënyrë aktive përdorimin e modelit Anchor në Rusi, konsideron (me të drejtë) se për asnjë referencë nuk mund të thuhet me siguri se ajo të ashpër në do të jetë statike dhe me një nivel të vetëm, prandaj për të gjitha objektet është më mirë të përdoret menjëherë një Anchor i plotë.
Një tjetër dallim i rëndësishëm midis Data Vault dhe modelit Anchor është prania e atributeve te lidhjet:
Në Data Vault Lidhjet janë objekte po aq të plota sa edhe Hub-et dhe mund të kenë atributet e tyre. Në Anchor Model Lidhjet përdoren vetëm për të bashkuar Anchor-et dhe nuk mund të kenë atribute të tyre. Ky ndryshim sjell qasje thelbësisht të ndryshme ndaj modelimit të fakteve, për të cilat do të flasim më tej.
Ruajtja e fakteve
Deri tani kemi folur kryesisht për modelimin e dimensioneve. Me faktet, situata është disi më pak e qartë.
Në Data Vault objekti tipik për ruajtjen e fakteve është Lidhja (Link), në Satellite-et e së cilës ruhen treguesit numerikë.
Kjo qasje duket intuitive. Ajo ofron qasje të thjeshtë te treguesit që analizohen dhe në përgjithësi i ngjan një tabele tradicionale faktesh (vetëm se treguesit nuk ruhen në vetë tabelën, por në një “fqinje”). Por ka edhe vështirësi: një nga zgjerimet tipike të modelit — zgjerimi i çelësit të faktit — sjell nevojën për shtimin e një çelësi të ri të jashtëm në Link. Kjo, nga ana tjetër, “e thyen” modularitetin dhe potencialisht krijon nevojën për ndryshime edhe në objekte të tjera.
Në Anchor Model Lidhja nuk mund të ketë atribute të veta, prandaj kjo qasje nuk funksionon — absolutisht të gjitha atributet dhe treguesit duhet të lidhen me një anchor konkret. Përfundimi është i thjeshtë — edhe për çdo fakt nevojitet anchor-i i vet. Për një pjesë të asaj që jemi mësuar ta perceptojmë si fakte, kjo mund të duket e natyrshme — për shembull, fakti i blerjes përfaqësohet lehtësisht nga objekti “porosi” ose “faturë”, vizita në sajt — nga sesioni, e kështu me radhë. Por ka edhe fakte për të cilat nuk është aq e lehtë të gjendet një “objekt bartës” i tillë natyror — për shembull, gjendja e stokut në magazina në fillim të çdo dite.
Përkatësisht, probleme me modularitetin gjatë zgjerimit të çelësit të faktit në modelin Anchor nuk lindin (mjafton thjesht të shtohet një Lidhje e re te Anchor-i përkatës), por projektimi i modelit për të pasqyruar faktet është më pak i njëkuptimtë dhe mund të shfaqen Anchor-e “artificiale”, që e pasqyrojnë modelin objektor të biznesit jo në mënyrë të dukshme.
Si arrihet fleksibiliteti
Struktura e përftuar në të dyja rastet përmban dukshëm më shumë tabela, sesa një dimension tradicional. Por mund të zërë dukshëm më pak hapësirë në disk me të njëjtin grup atributesh të versionuara si një dimension tradicional. Natyrisht, këtu nuk ka asnjë magji — e gjitha lidhet me normalizimin. Duke i shpërndarë atributet nëpër Satellite (në Data Vault) ose në tabela të veçanta (në Anchor Model), ne zvogëlojmë (ose e eliminojmë plotësisht) dyfishimin e vlerave të disa atributeve kur ndryshojnë të tjerat.
Për Data Vault përfitimi do të varet nga shpërndarja e atributeve nëpër Satellite, ndërsa për Anchor Model — është pothuajse drejtpërdrejt proporcional me numrin mesatar të versioneve për objekt dimensioni.
Megjithatë, përfitimi në hapësirën e zënë është një avantazh i rëndësishëm, por jo kryesori i ruajtjes së veçuar të atributeve. Së bashku me ruajtjen e veçuar të lidhjeve, një qasje e tillë e bën magazinën e të dhënave një strukturë modulare. Kjo do të thotë se shtimi si i atributeve të veçanta, ashtu edhe i fushave krejtësisht të reja lëndore në një model të tillë, paraqitet si një shtresëzim mbi grupin ekzistues të objekteve pa i ndryshuar ato. Dhe pikërisht kjo i bën fleksibile metodologjitë e përshkruara.
Kjo ngjan edhe me kalimin nga prodhimi artizanal te ai masiv — nëse në qasjen tradicionale çdo tabelë e modelit është unike dhe kërkon vëmendje të veçantë, atëherë në metodologjitë fleksibile kemi tashmë një grup “pjesësh” tipike. Nga njëra anë, tabelat bëhen më të shumta dhe proceset e ngarkimit e të marrjes së të dhënave duhet të duken më komplekse. Nga ana tjetër, ato bëhen tipike. Dhe kjo do të thotë se mund të jenë janë të automatizuara dhe të menaxhohen nga metadatat. Pyetja “si do ta organizojmë?”, përgjigjja e së cilës mund të zinte një pjesë të konsiderueshme të punës gjatë projektimit të përmirësimeve, tani thjesht nuk shtrohet më (ashtu si edhe pyetja për ndikimin e ndryshimit të modelit mbi proceset që janë në funksion).
Kjo nuk do të thotë se analistët në një sistem të tillë nuk nevojiten fare — dikush ende duhet të përpunojë grupin e objekteve me atributet përkatëse dhe të kuptojë se nga dhe si do të ngarkohen të gjitha këto. Por vëllimi i punës, si edhe gjasat dhe kostoja e gabimit, ulen ndjeshëm. Si në fazën e analizës, ashtu edhe gjatë zhvillimit të ETL, i cili në një pjesë të madhe mund të reduktohet në redaktimin e metadatave.
Ana e errët
Gjithçka e përshkruar më sipër i bën të dyja qasjet vërtet fleksibile, teknologjikisht të avancuara dhe të përshtatshme për përmirësime iterative. Natyrisht, ekziston edhe “ana negative”, për të cilën besoj se tashmë e merrni me mend.
Dekompozimi i të dhënave, që qëndron në bazë të modularitetit të arkitekturave fleksibile, çon në rritjen e numrit të tabelave dhe, për rrjedhojë, të kostove shtesë për join-et gjatë marrjes së të dhënave. Për të marrë thjesht të gjitha atributet e një dimensioni, në një depo klasike mjafton një SELECT i vetëm, ndërsa një arkitekturë fleksibile do të kërkojë një varg të tërë join-esh. Madje, nëse për raportet të gjitha këto join-e mund të shkruhen paraprakisht, analistët që janë mësuar ta shkruajnë SQL me dorë do ta ndiejnë këtë dyfish më shumë.
Ka disa fakte që e lehtësojnë këtë situatë:
Gjatë punës me dimensione të mëdha, pothuajse kurrë nuk përdoren njëkohësisht të gjitha atributet e tyre. Kjo do të thotë se join-et mund të jenë më pak nga sa duket në shikim të parë të modelit. Në Data Vault mund të merret parasysh edhe frekuenca e pritshme e përdorimit të përbashkët gjatë shpërndarjes së atributeve nëpër satelitë. Ndërkohë, vetë Hub-et ose Anchor-ët nevojiten kryesisht për gjenerimin dhe mapimin e surrogate-ve në fazën e ngarkimit dhe përdoren rrallë në pyetje (kjo vlen veçanërisht për Anchor-ët).
Të gjitha join-et janë sipas çelësit. Për më tepër, mënyra më “e ngjeshur” e ruajtjes së të dhënave ul kostot shtesë të skanimit të tabelave aty ku kjo është e nevojshme (për shembull, gjatë filtrimit sipas vlerës së atributit). Kjo mund të sjellë që përzgjedhja nga një bazë e normalizuar me shumë join të jetë madje më e shpejtë sesa skanimi i një dimensioni të vetëm të rëndë me shumë versione për rresht.
Për shembull, në artikullin ka një test krahasues të detajuar të performancës së modelit Anchor kundrejt përzgjedhjes nga një tabelë e vetme.
Shumëçka varet nga engine-i. Shumë platforma moderne kanë mekanizma të brendshëm për optimizimin e join. Për shembull, MS SQL dhe Oracle dinë t’i “anashkalojnë” join-et me tabela nëse të dhënat e tyre nuk përdoren askund tjetër përveç join-eve të tjera dhe nuk ndikojnë në përzgjedhjen përfundimtare (table/join elimination), ndërsa MPP Vertica, sipas , është treguar si një engine i shkëlqyer për modelin Anchor, me kushtin e një optimizimi të caktuar manual të planit të query-t. Nga ana tjetër, ruajtja e modelit Anchor, për shembull, në Click House, i cili ka mbështetje të kufizuar për join, për momentin nuk duket si ide shumë e mirë.
Përveç kësaj, për të dyja arkitekturat ekzistojnë teknika të posaçme, që lehtësojnë qasjen në të dhëna (si nga këndvështrimi i performancës së query-ve, ashtu edhe për përdoruesit fundorë). Për shembull, tabelat Point-In-Time në Data Vault ose funksione të posaçme tabelare në modelin Anchor.
Përveç kësaj
Thelbi kryesor i arkitekturave fleksibile të shqyrtuara qëndron te modulariteti i “ndërtimit” të tyre.
Pikërisht kjo veçori bën të mundur:
- Pas një përgatitjeje fillestare, të lidhur me vendosjen e metadata-ve dhe shkrimin e algoritmeve bazë ETL, t’i ofrohet shpejt klientit rezultati i parë në formën e disa raporteve që përmbajnë të dhëna vetëm nga disa objekte të burimeve. Për këtë nuk është e domosdoshme të mendohet plotësisht (madje as në nivel të lartë) e gjithë modeli i objekteve.
- Modeli i të dhënave mund të fillojë të funksionojë (dhe të sjellë vlerë) vetëm me 2-3 objekte, e më pas të zgjerohet gradualisht (sa i përket modelit Anchor, Nikolai një krahasim të bukur me micelin).
- Shumica e përmirësimeve, përfshirë zgjerimin e fushës së biznesit dhe shtimin e burimeve të reja, nuk prekin funksionalitetin ekzistues dhe nuk krijojnë rrezik për të prishur diçka që tashmë funksionon.
- Falë dekompozimit në elemente standarde, proceset ETL në sisteme të tilla duken të njëjta, shkrimi i tyre i nënshtrohet algoritmizimit dhe, në fund të fundit, automatizimit.
Kostoja e kësaj fleksibiliteti është e përmirësuar. Kjo nuk do të thotë se është e pamundur të arrihet një performancë e pranueshme me modele të tilla. Më shpesh, thjesht mund t’ju nevojiten më shumë përpjekje dhe vëmendje ndaj detajeve për të arritur metrikat e kërkuara.
Aplikacionet
Llojet e entiteteve Data Vault
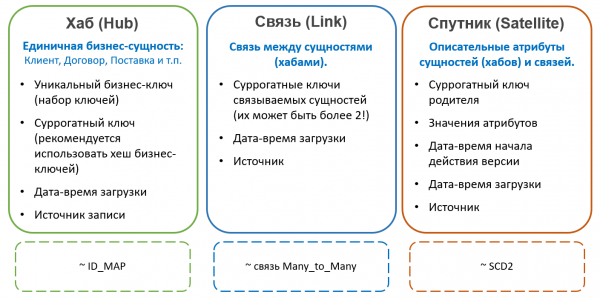
Më shumë rreth Data Vault:
Llojet e entiteteve Anchor Model
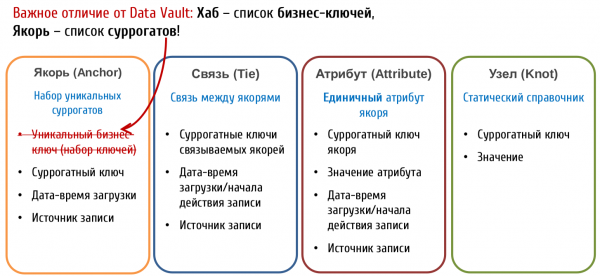
Më shumë rreth Anchor Model:
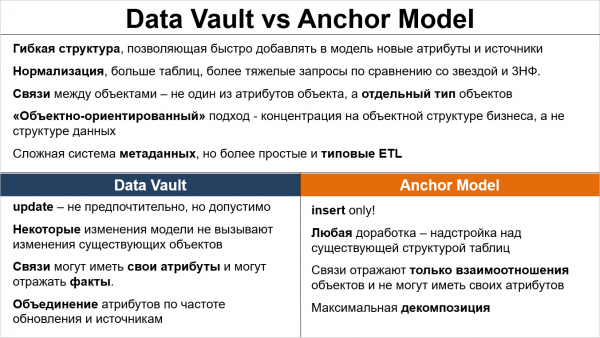
Tabelë përmbledhëse me tiparet e përbashkëta dhe dallimet e qasjeve të shqyrtuara:
Burimi: habr.com
