

Gjatë gjashtë muajve të fundit, kam punuar në krijimin e një sistemi për të luftuar mashtrimet (aktivitetet mashtruese, mashtrimi, etj.) pa asnjë infrastrukturë fillestare për këtë. Idetë e sotme që ne gjetëm dhe zbatuam në sistemin tonë na ndihmojnë të zbulojmë shumë aktivitete mashtruese dhe t’i analizojmë ato. Në këtë artikull, do të doja të flisja për parimet që ndoqëm dhe për atë që bëmë për të arritur gjendjen aktuale të sistemit tonë, pa hyrë thellë në aspektin teknik.
Parimet e sistemit tonë
Kur dëgjoni terma si "automatik" dhe "mashtrim", ndoshta filloni të mendoni për mësimin makinerik, Apache Spark, Hadoop, Python, Airflow dhe teknologjitë e tjera të ekosistemës së Apache Foundation dhe fushës së Data Science. Mendoj se ka një aspekt të përdorimit të këtyre mjeteve, i cili zakonisht nuk përmendet: ato kërkojnë ekzistencën e kushteve të caktuara paraprake në sistemin tuaj korporativ, përpara se të filloni t’i përdorni. Në mënyrë të shkurtër, ju nevojitet një platformë korporative të dhënash që përfshin një liqen të dhënash dhe një depo të dhënash. Por çfarë ndodh nëse nuk keni një platformë të tillë dhe ende duhet të zhvilloni këtë praktikë? Parimet që po i ndaj më poshtë na ndihmuan të arrijmë në një moment kur mund të fokusohemi në përmirësimin e ideve tona, dhe jo në gjetjen e asaj që funksionon. Megjithatë, kjo nuk është një "plato" projekti. Ka ende shumë për të bërë nga këndvështrimi teknologjik dhe produktiv.
Parimi 1: vlera për biznesin para së gjithash
Në krye të të gjitha përpjekjeve tona, kemi vendosur "vlerën për biznesin". Në përgjithësi, çdo sistem analitik automatizuar i përket grupit të sistemeve komplekse me nivel të lartë automatizimi dhe kompleksitet teknik. Krijimi i një zgjidhjeje përfundimtare do të kërkonte shumë kohë, nëse do ta krijonit nga e para. Ne vendosëm të vendosim në radhë të parë vlerën për biznesin, dhe në vendin e dytë, përfundimin teknik. Në jetën e përditshme, kjo do të thotë se ne nuk i pranojmë teknologjitë e avancuara si dogmë. Ne zgjedhim teknologjinë që funksionon më mirë për ne në momentin e tanishëm. Në kohë, ndoshta do të duket se na nevojitet të ribëjmë disa module. Ky është një kompromis që ne pranuam.
Parimi 2: Inteligjenca e zgjeruar e njeriut (inteligjenca e zgjeruar)
Mendoj se shumica e njerëzve që nuk janë thellësisht të përfshirë në zhvillimin e zgjidhjeve për mësim të automatizuar mund të mendojnë se zëvendësimi i njerëzve është qëllimi. Në të vërtetë, zgjidhjet për mësim të automatizuar janë shumë të pafundme dhe zëvendësimi është i mundur vetëm në disa fusha. E kemi hequr këtë ide nga fillimi për disa arsye: të dhënat e paekuilibruara mbi aktivitetin mashtrues dhe pamundësia për të ofruar një listë të plotë funksionesh për modelet e mësimit të automatizuar. Përkundrazi, ne zgjodhëm një opsion me inteligjencë të zgjeruar. Kjo është një koncept alternativ i inteligjencës artificiale që fokusohet në rolin ndihmës të IA, duke theksuar faktin se teknologjitë kognitive janë destinuar për të përmirësuar inteligjencën njerëzore, jo për ta zëvendësuar. [1]
Duke marrë parasysh këtë, zhvillimi i një zgjidhjeje të plotë për mësim të automatizuar që nga fillimi do të kërkonte përpjekje të mëdha, të cilat do të vononin krijimin e vlerës për biznesin tonë. Ne vendosëm të ndërtojmë një sistem me një aspekt të rritjes iteruese të mësimit të automatizuar nën udhëheqjen e ekspertëve tanë në fushën përkatëse. Pjesa e vështirë në zhvillimin e këtij sistemi është se ai duhet të ofrojë analistëve tanë raste jo vetëm nga këndvështrimi i aktivitetit mashtrues ose jo. Në përgjithësi, çdo anomal në sjelljen e klientëve është një rast të dyshimtë që specialistët duhet ta hetojnë dhe të reagojnë në njëfarë mënyre. Vetëm një pjesë e vogël e këtyre rasteve të regjistruara mund të klasifikohen si mashtrim.
Principi 3: platforma e analitikës së gjerë
Pjesa më e komplikuar e sistemit tonë është verifikimi i vazhdueshëm i procesit të punës. Analistët dhe zhvilluesit duhet të kenë qasje të lehtë në grupe të dhënash nga periudha të kaluara me të gjitha metrikat që janë përdorur për analizë. Përveç kësaj, platforma e të dhënave duhet të ofrojë një mënyrë të thjeshtë për të plotësuar grupin ekzistues të treguesve me të rinj. Proceset që krijojmë, ndonjëherë jo vetëm proceset programore, duhet të lejojnë llogaritjen e lehtë të periudhave të mëparshme, të shtojnë metrika të reja dhe të modifikojnë parashikimet e të dhënave. Mund të arrinim këtë duke akumuluar të gjitha të dhënat që gjeneron sistemi ynë prodhues. Në këtë rast, të dhënat gradualisht do të bënin pengesë. Do të na duhej të ruanim një volum në rritje të të dhënave që nuk i përdorim dhe t'i mbrojmë ato. Në një skenar të tillë, me kalimin e kohës, të dhënat do të bëheshin gjithnjë e më të padobishme, por do të kërkonin ende përpjekjet tona për t'i menaxhuar. Për ne, akumulimi i të dhënave nuk kishte kuptim, kështu që vendosëm të përdorim një qasje tjetër. Vendosëm të organizojmë depozita të dhënash në kohë reale rreth entiteteve të synuara që dëshirojmë të klasifikojmë dhe të ruajmë vetëm ato të dhëna që lejojnë verifikimin e periudhave të fundit dhe më relevante. Kompleksiteti i këtyre përpjekjeve qëndron në faktin se sistemi ynë është heterogjen me disa depozita të dhënash dhe Module software që kërkojnë planifikim të kujdesshëm për të siguruar punën e koherente.
Konceptet konstruktive të sistemit tonë
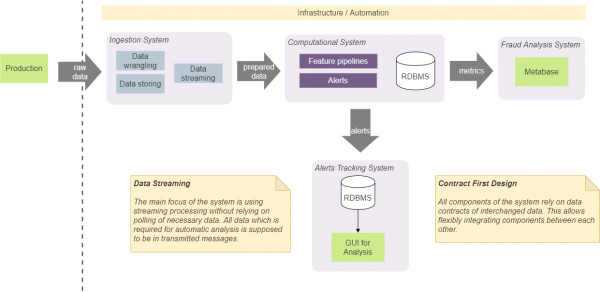
Ne kemi katër komponentë kryesorë në sistemin tonë: sistemi i pranuar (ingestion system), llogaritja (computational), analiza (BI analysis) dhe sistemi i gjurmimit (tracking system). Ata shërbejnë për qëllime të veçanta të izoluara, dhe ne i mbajmë ata të izoluar, duke ndjekur qasje të caktuara në zhvillim.
Dizajni i bazuar në kontrata
Së pari, ne u dakorduam që komponentët të mbështeten vetëm në struktura të caktuara të dhënash (kontrata) që transmetohen mes tyre. Kjo lejon integrimin e lehtë midis tyre dhe nuk imponon një përbërje (dhe rend) specifike të komponentëve. Për shembull, në disa raste, kjo na lejon të integrojmë drejtpërdrejt sistemin e pranimit me sistemin e ndjekjes së paralajmërimeve. Në këtë rast, do të bëhet sipas kontratës së rënë dakord për paralajmërimet. Kjo do të thotë se të dy komponentët do të integrohen duke përdorur një kontratë që mund të përdoret nga çdo komponent tjetër. Nuk do të shtojmë një kontratë shtesë për shtimin e paralajmërimeve në sistemin e ndjekjes nga sistemi i hyrjes. Ky qasje kërkon përdorimin e një sërë minimal të parapakët të kontratave dhe thjeshton sistemin dhe komunikimin. Në thelb, ne përdorim një qasje që quhet 'Dizajni i Parë me Kontratë', dhe e aplikojmë atë në kontratat e transmetimit të të dhënave. [2]
Streaming kudo
Ruajtja dhe menaxhimi i gjendjes në sistem gjithmonë do të çojë në kompliksitet në zbatimin e tij. Në përgjithësi, gjendja duhet të jetë e aksesueshme nga çdo komponent, ajo duhet të jetë konsistente dhe të ofron vlerën më të azhornuar për të gjithë komponentët, dhe duhet të jetë e besueshme me vlera të sakta. Për më tepër, prania e thirrjeve për ruajtjen e përhershme për të marrë gjendjen e fundit do të rrisë numrin e operacioneve të hyrjes-daljes dhe kompleksitetin e algoritmeve që përdoren në konvenerat tona në kohë reale. Për këtë arsye, ne vendosëm të heqim ruajtjen e gjendjes, sa më shumë të jetë e mundur, nga sistemi ynë. Ky qasje kërkon përfshirjen e të gjithë të dhënave të nevojshme në bllokun e të dhënave që po dërgohet (mesazhi). Shembuj, nëse na nevojitet të llogarisim numrin e përgjithshëm të disa vëzhgimeve (numri i operacioneve ose rasteve me karakteristika të caktuara), ne e llogarisim atë në memorje dhe krijojmë një rrjedhë të tillë vlerash. Modulët e varur do të përdorin ndarjen (partition) dhe grupimin (batch) për të copëtuar rrjedhën sipas entiteteve dhe për të operuar me vlerat më të fundit. Ky qasje e eliminon nevojën për të pasur një ruajtje të përhershme të diskut për të dhëna të tilla. Sistemi ynë përdor Kafka si broker mesazhesh, dhe ai mund të përdoret si bazë të dhënash me KSQL. [3] Por përdorimi i tij do ta lidhte shumë zgjidhjen tonë me Kafka, dhe ne vendosëm të mos e përdorim atë. Qasja jonë e zgjedhur lejon zëvendësimin e Kafka me një broker tjetër mesazhesh pa ndryshime serioze të brendshme në sistem.
Kjo koncept nuk do të thotë se ne nuk përdorim ruajtje disku dhe baza të dhënash. Për të verifikuar dhe analizuart performancën e sistemit, na nevojitet të ruajmë në disk një pjesë të konsiderueshme të të dhënave, që përfaqësojnë tregues dhe gjendje të ndryshme. Një pikë e rëndësishme këtu është se algoritmet në kohë reale nuk varen nga këto të dhëna. Në shumicën e rasteve, ne përdorim të dhënat e ruajtura për analizë autonome, debugs dhe ndjekjen e rasteve të veçanta dhe rezultateve që sjell sistemi.
Problemet e sistemit tonë
Ka janë disa probleme të caktuara që i kemi zgjidhur deri në një nivel të caktuar, por ato kërkojnë zgjidhje më të menduara. Tani do të doja të përmëndja ato këtu, sepse çdo pikë meriton një artikull të veçantë.
- Na nevojitet ende të përcaktojmë proceset dhe politikat që kontribuojnë në akumulimin e të dhënave të rëndësishme dhe relevante për analizën tonë automatike, zb discovery dhe hetimin e të dhënave.
- Zbatimi i rezultateve të analizës njerëzore në procesin e konfigurimit automatik të sistemit për ta përditësuar me të dhënat më të fundit. Kjo jo vetëm që përditëson modelin tonë, por gjithashtu përditëson proceset dhe përmirëson të kuptuarin tonë të të dhënave.
- Gjetja e balansit mes qasjes determinuese IF-ELSE dhe ML. Disa kanë thënë: «ML është një mjet për ata që janë në panik». Kjo nënkupton se do të dëshironit të përdorni ML kur nuk e kuptoni më se si të optimizoni dhe përmirësoni algoritmet tuaja. Në anën tjetër, qasja determinuese nuk lejon identifikimin e anomalive që nuk ishin parashikuar.
- Na nevojitet një mënyrë e thjeshtë për të provuar hipotezat tona ose korrelacionet midis metrikeve në të dhëna.
- Sistemi duhet të ketë disa nivele të rezultateve të vërteta pozitive (true positive). Rastet e mashtrimit janë vetëm një pjesë e të gjitha rasteve që mund të merren parasysh si pozitive për sistemin. Për shembull, analistët duan të marrin të gjitha rastet e dyshimta për kontroll dhe vetëm një pjesë e vogël e tyre janë mashtrim. Sistemi duhet të ofrojë efikasitet analistëve për të gjitha rastet, pavarësisht nëse janë mashtrime reale apo thjesht sjellje të dyshimta.
- Plani të dhënave duhet të lejojë marrjen e grupeve të dhënash për periudha të kaluara me llogaritjet e krijuara dhe të llogaritura në kohë reale.
- Zbatimi i thjeshtë dhe automatik i çdo komponenti të sistemit në të paktën tri mjedise të ndryshme: prodhim, eksperimentale (beta) dhe për zhvilluesit.
- Dhe e fundit, por jo më pak e rëndësishme. Na nevojitet të krijojmë një platformë të gjerë për testimin e performancës, ku mund të analizojmë modelet tona. [4]
Linket
Burimi: habr.com
