

VictoriaMetrics — një DBMS e shpejtë dhe e shkallëzueshme për ruajtjen dhe procesimin e të dhënave në formën e serive temporale (një regjistrim krijon një kohë dhe një grup vlerash të lidhura me këtë kohë, për shembull, të marra përmes një vrojtimi periodik të gjendjes së sensorëve ose mbledhjes së metrikeve).
Unë quhem Kolobaev Pavel. DevOps, SRE, LeroyMerlin, gjithçka si kod – kjo është gjithçka për ne: për mua dhe për punonjësit e tjerë të LeroyMerlin.
Ka një re të bazuar në OpenStack. Aty ka një lidhje të vogël për radar teknologjik.
Ajo është ndërtuar mbi harduerin e Kubernetes, si dhe mbi të gjitha shërbimet përcjellëse për OpenStack dhe logimin.
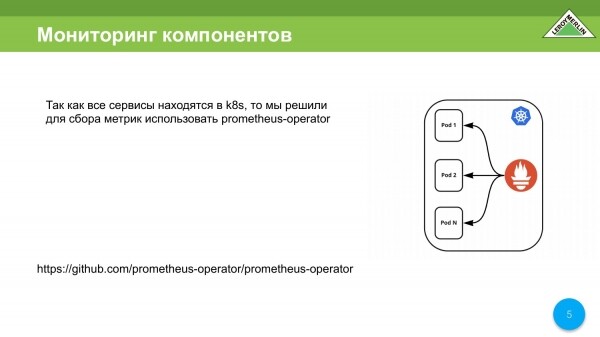
Schemi ishte kështu kur ishim duke zhvilluar. Kur e zhvilluam këtë, kishim një operator Prometheus, i cili ruante të dhënat brenda vetë klasterit K8s. Ai e gjen automatikisht atë që nevojitet për të zbuluar dhe e vendos atë poshtë vetes, për ta thënë në një farë mënyre.
Të gjitha të dhënat na nevojitet të nxirren jashtë klasterit Kubernetes, sepse nëse ndodh ndonjë gjë, duhet të kuptojmë se çfarë dhe ku është.
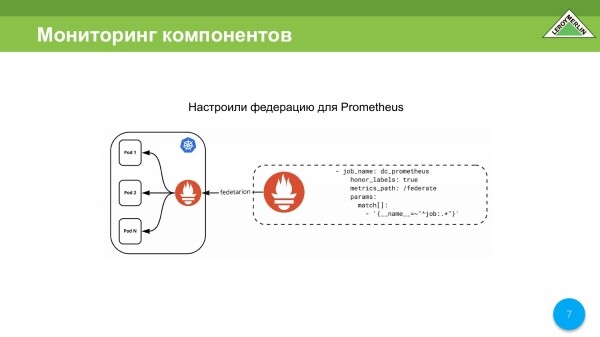
Zgjidhja e parë - ne përdorim federation, kur kemi një Prometheus të jashtëm, kur ne hyjmë në klasterin Kubernetes përmes mekanizmit të federation.
Por këtu ndodhin disa probleme të vogla. Në rastin tonë, problemet filluan kur kishim 250,000 metrika, dhe kur arritëm në 400,000 metrika, kuptuam që nuk mund të punonim kështu. Ne rritëm scrape_timeout në 25 sekonda.
Pse na duhej të bënim këtë? Prometheus fillon të numërojë kohën e skadimit nga momenti i fillimit të marrjes. Dhe nuk ka rëndësi që të dhënat akoma rrjedhin. Nëse gjatë këtij intervali të caktuar kohor të dhënat nuk u shkarkuan dhe sesioni nuk do të mbyllej në http, atëherë merret si një sesion dështak dhe të dhënat nuk arrijnë në Prometheus vetë.
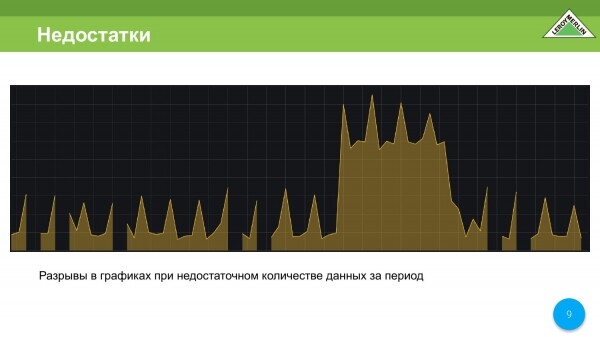
Grafikat që na janë të njohura, kur pjesa e të dhënave mungon. Grafikat janë të prishura dhe kjo nuk na kënaq.
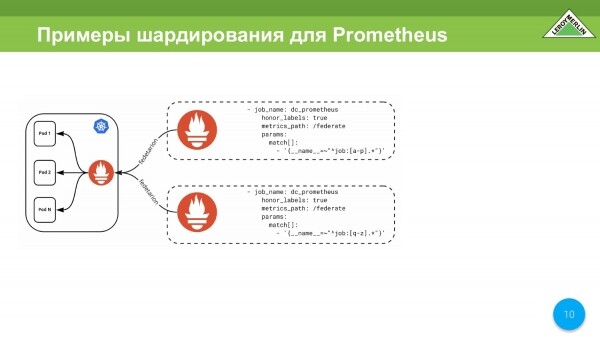
Zgjedhja tjetër – është shardimi mbi bazën e dy Prometheus të ndryshëm përmes të njëjtit mekanizëm të federation.
Për shembull, thjesht të marrim dhe t'i shardojmë sipas emrit. Kjo mund të përdoret gjithashtu, por ne vendosëm të shkonim më tutje.
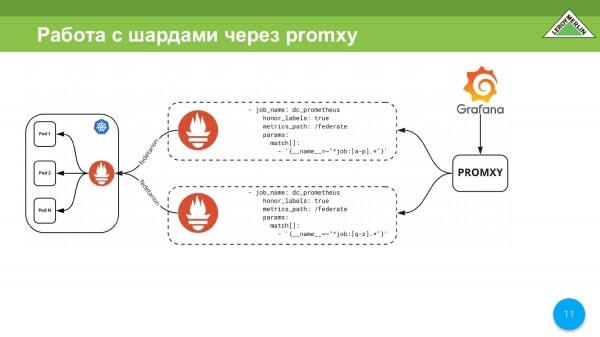
Do të na duhet tani t'i trajtojmë këto shard-e siç duhet. Mund të marrim promxy, i cili shkon në fushën e shard-it dhe mblidhet të dhënat. Ai punon me dy shard-e si me një pikë hyrëse të vetme. Kjo është e mundur të realizohet përmes promxy, por akoma është shumë e komplikuar.
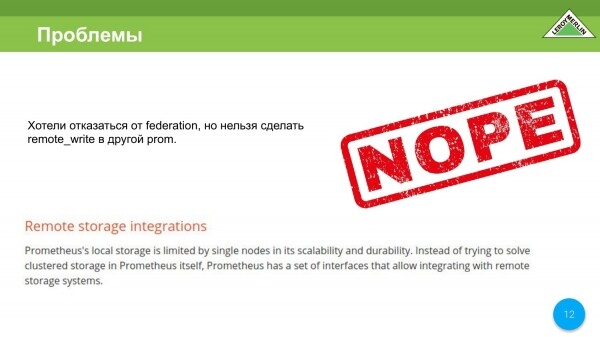
Zgjedhja e parë - ne duam të heqim dorë nga mekanizmi i federation, sepse ai është shumë i ngadalshëm.
Zhvilluesit e Prometheus janë të qartë: “Djem, përdorni TimescaleDB të tjera, sepse ne nuk do të mbështesim ruajtjen e gjatë të metricëve.” Kjo nuk është detyra e tyre. 
Ne e shkruajmë në letër se na nevojitet dalja përjashta, në mënyrë që të mos ruajmë gjithçka në një vend.
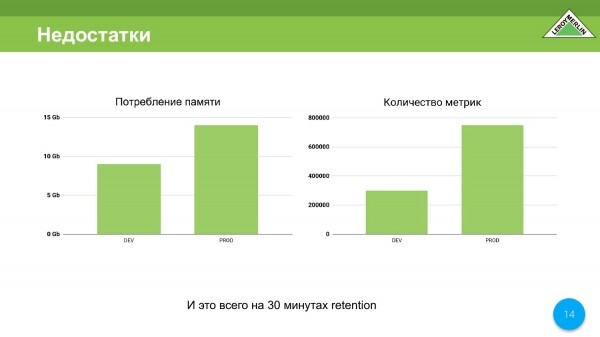
Disavantazhi i dytë është konsumimi i memorjes. Po, e kuptoj që shumë do të thonë se në vitin 2020 disa gigabajt memorje janë shumë pak, por mirëpo.
Tani kemi ambient dev dhe prodhimi. Në dev është rreth 9 gigabajt për 350,000 metrika. Në prodhim – rreth 14 gigabajt për 780,000 metrika. Ndërkohë, koha e ruajtjes është vetëm 30 minuta. Kjo është keq. Dhe tani do ta shpjegoj pse.
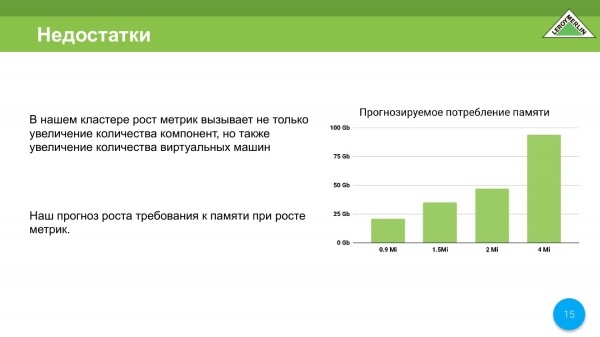
Ne bëjmë llogaritjen, pra me një milion e gjysmë metrikash, dhe ne jemi afër kësaj shifre, në fazën e projektimit, ne po marrim 35-37 gigabajt memorje. Por me 4 milion metrika ne na duhen tashmë rreth 90 gigabajt memorje. Pra, kjo është llogaritur sipas formules që ofrojnë zhvilluesit e Prometheus. Ne patëm një vështrim në korelacion dhe kuptuam se nuk duam të paguajmë disa milionë për një server vetëm për monitorim.
Numri i makinave do të rritet dhe ne gjithashtu monitorojmë edhe vetë makinat virtuale. Prandaj, sa më shumë makina virtuale, aq më shumë metrika të ndryshme dhe kështu me radhë. Do të kemi një rritje të veçantë të klasit tonë në lidhje me metrikat.
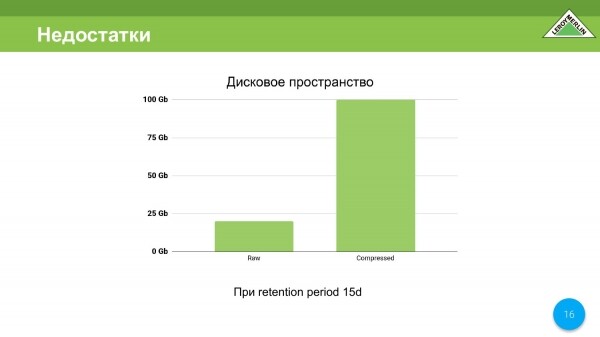
Me hapësirën diskore, këtu nuk është gjithçka aq e mërzitshme, por do të dëshironim të përmirësojmë. Në 15 ditë ne kemi marrë gjithsej 120 gigabajt, nga të cilat 100 janë të dhëna të kompresuara, 20 janë të dhëna të pa kompresuara, por gjithmonë do të dëshironim më pak.
Për rrjedhojë, ne po regjistrojmë një pikë tjetër – kjo është konsumimi i madh i burimeve, të cilat duam t'i kursejmë, sepse nuk duam që klasteri ynë i monitorimit të konsumojë më shumë burime se klasteri që merret me menaxhimin e OpenStack.
Ka një disavantazh tjetër tek Prometheus, që ne e kemi identifikuar, që është ndonjë kufizim mbi memorjen. Me Prometheus situata është shumë më e keqe, sepse atje nuk ka asnjë opsion të tillë. Përdorimi i kufizimeve në docker gjithashtu nuk është një mundësi. Nëse ndonjëherë RAF bie dhe aty ka 20-30 gigabajt, rikthimi do të jetë shumë i ngadalshëm.
Kjo është një arsye tjetër pse Prometheus nuk na përshtatet, pra nuk është e mundur të kufizohet konsumimi i memorjes.
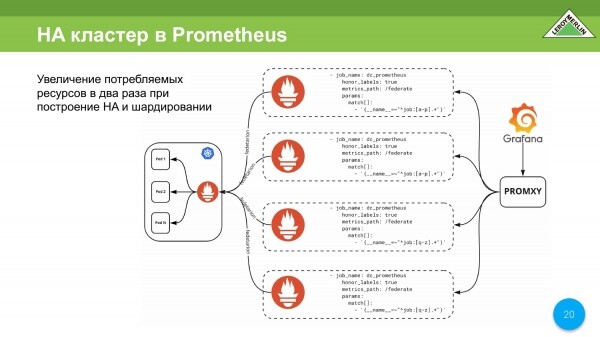
Mund të dalim në një skemë të tillë. Kjo skemë na nevojitet për të organizuar një klaster HA. Ne duam që metrike tona të jenë gjithmonë dhe kudo të aksesueshme, madje edhe në rast të rënies së serverit që i ruan këto metrika. Kështu na nevojitet të ndërtojmë një skemë të tillë.
Kjo skemë thotë se do të kemi dyfishim të shard-ëve, dhe për rrjedhojë, edhe dyfishim të shpenzimeve të burimeve të konsumuar. Ajo mund të skalohet pothuajse horizontalisht, por megjithatë, konsumimi i burimeve do të jetë i madh.
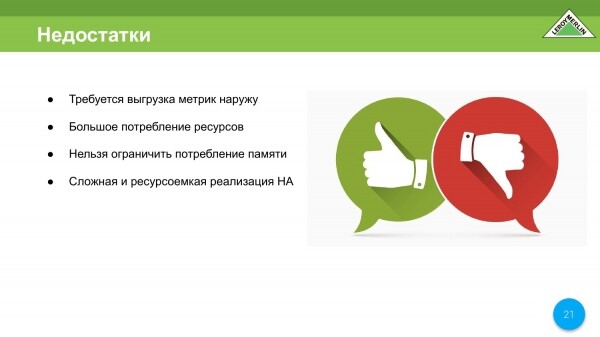
Disavantazhet renditur sipas asaj që i kemi shkruar vetë:
- Kërkohet shkarkimi i metrikeve jashtë.
- Konsum i madh burimesh.
- Nuk mund të kufizojmë konsumimin e memories.
- Zbatimi i HA është kompleks dhe kërkon shumë resurse.
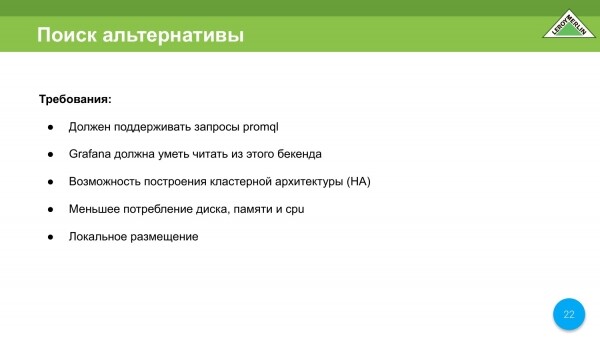
Vendosëm se do të largohemi nga Prometheus si ruajtje.
Për vete kemi përcaktuar edhe kërkesa të tjera që na nevojiten. Këto janë:
- Kjo është mbështetje për promql, sepse tashmë shumë gjëra janë shkruar për Prometheus: pyetje, alarme.
- Dhe pastaj kemi Grafana-n, e cila gjithashtu është shkruar nën Prometheus si backend. Nuk dëshirojmë të rishkruajmë dashboard-et.
- Ne duam të ndërtojmë një arkitekturë të mirë HA.
- Ne duam të zvogëlojmë konsumimin e çdo burimi.
- Ka edhe një nuancë të vogël. Ne nuk mund të përdorim sisteme të ndryshme cloud për grumbullimin e metrikeve. Nuk e dimë se çfarë do të shkojë në këto metrika për tani. Dhe pasi gjithçka mund të shkojë atje, na duhet të kufizohemi në vendosjen lokale.
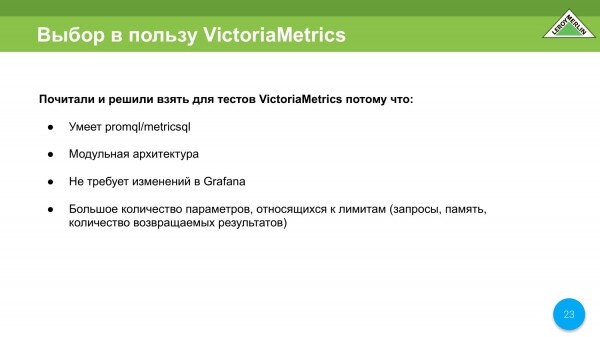
Zgjedhja ishte e vogël. Mblodhëm gjithçka mbi të cilin kishim ekspertizë. Shikuan faqen e Prometheus në seksionin e integrimit, lexuan shumë artikuj, shikuan se çfarë kishte në fakt. Dhe për vete zgjodhëm VictoriaMetrics si zëvendësim për Prometheus.
Pse? Sepse:
- Nuk ka promql.
- Ka arkitekturë modulare.
- Nuk kërkon ndryshime në Grafana.
- Dhe gjëja më e rëndësishme – ndoshta do të ofrojmë ruajtje metrikash brenda kompanisë sonë si një shërbim, prandaj paraprakisht po shikojmë në drejtimin e kufizimeve të ndryshme, në mënyrë që përdoruesit të mund të përdorin të gjitha burimet e klasterit në një mënyrë të kufizuar, sepse ka mundësi që ai të jetë multitenancy.
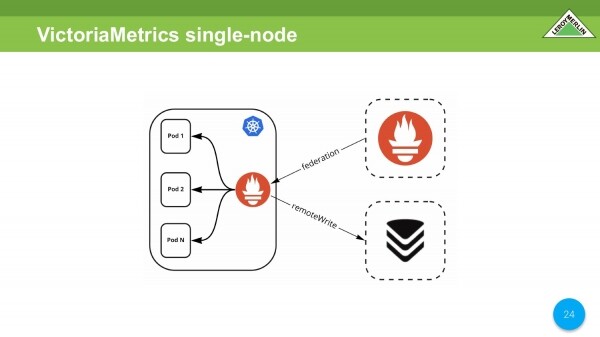
Po bëjmë krahasimin e parë. Merrni atë të njëjtin Prometheus brenda klasterit, i cili lidhet me një Prometheus të jashtëm. Shtohet përmes remoteWrite VictoriaMetrics.
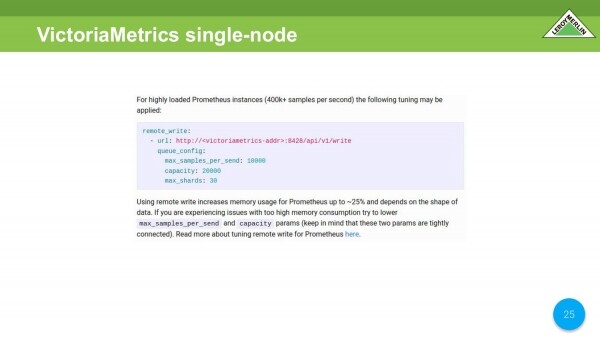
Të them drejtpërdrejt, këtu kemi kapur një rritje të vogël në konsumimin e CPU nga ana e VictoriaMetrics. Në wiki-n e VictoriaMetrics është shkruar se cilat parametrat përshtaten më mirë. I kemi verifikuar ato. Ato kanë ulur shumë mirë konsumin e CPU-së.
Në rastin tonë, konsumimi i memorie në Prometheus, i cili ndodhet në klasterin Kubernetes, është rritur pak.
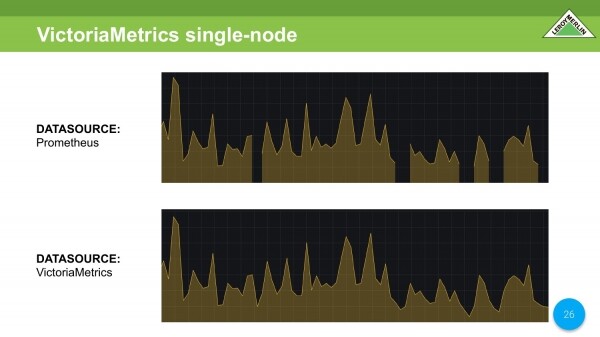
Po krahasojmë dy data source të të njëjtave të dhëna. Në Prometheus shohim të njëjtat të dhëna që mungojnë. Në VictoriaMetrics gjithçka është në rregull.
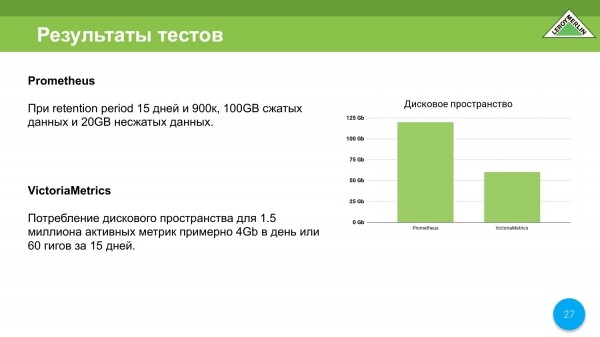
Rezultatet e testeve me hapësirën diskore. Ne në Prometheus morëm gjithsej 120 gigabajt. Në VictoriaMetrics po marrim tashmë 4 gigabajt në ditë. Ajo ka një mekanizëm ndryshe nga ai që jemi mësuar ta shohim në Prometheus. Kështu që të dhënat janë kompresuar mjaft mirë brenda një dite, brenda gjysmë ore. Ato janë kompresuar mirë brenda një dite, brenda gjysmë ore, megjithëse më pas do të përzihen të dhënat. Në përfundim, arritëm të kursejmë hapësirën diskore.
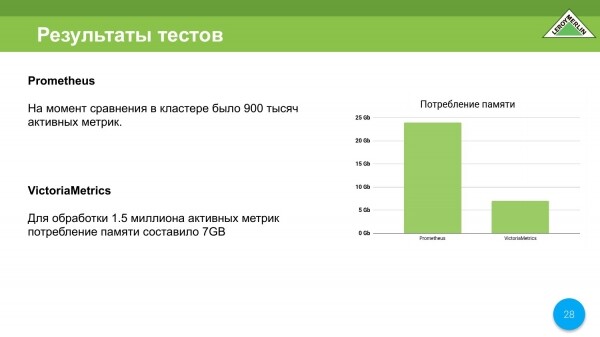
Po ashtu, ne kursejmë në konsumimin e burimeve të memories. Në momentin e testeve, Prometheus ishte aktivizuar në një makinë virtuale – 8 bërthama, 24 gigabajt. Prometheus konsumon praktikisht gjithçka. Ai ra për shkak të OOM Killer. Në të kishte vetëm 900,000 metrika aktive. Kjo është rreth 25,000-27,000 metrika në sekondë.
VictoriaMetrics ishte e aktivizuar në një makinë virtuale me dy bërthama dhe 8 gigabajt RAM. Na arriti të bëjmë që VictoriaMetrics të punonte mirë, duke rregulluar disa gjëra në makinën me 8 gigabajt. Në përfundim, ne kaluam në 7 gigabajt. Megjithatë, morëm një shpejtësi përcjelljeje të përmbajtjes, siç janë metrikat, madje edhe më të lartë se në Prometheus.
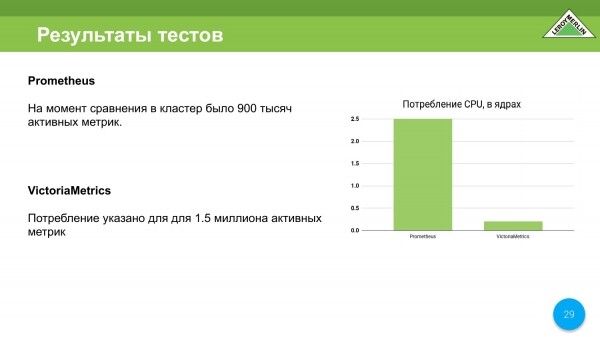
Në CPU është bërë shumë më mirë në krahasim me Prometheus. Këtu Prometheus konsumon 2.5 bërthama, ndërsa VictoriaMetrics vetëm 0.25 bërthama. Në fillim – 0.5 bërthama. Me kalimin e kohës, në përzierje arrin deri në një bërthamë, por kjo ndodh shumë, shumë rrallë.
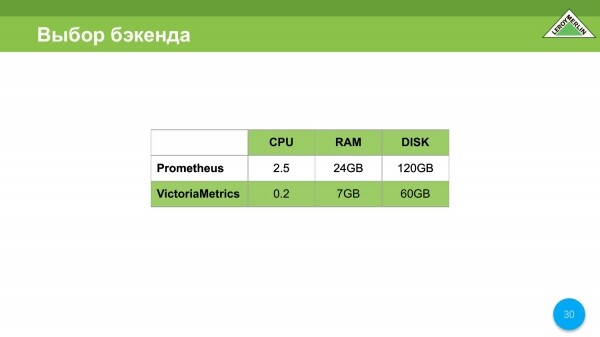
Në rastin tonë, ne zgjodhëm VictoriaMetrics për arsye të qarta, ne dëshironim të kursejmë dhe arritëm ta bëjmë atë.
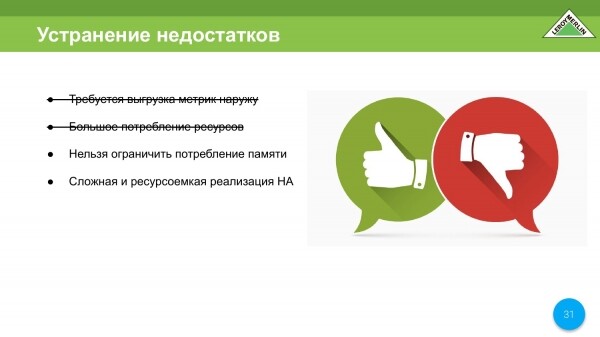
Ne përjashtojmë menjëherë dy pikë – shkarkimi i metrikave dhe konsumimi i madh i burimeve. Na mbetet të zgjidhim dy pika të tjera që i kemi lënë për veten tonë.
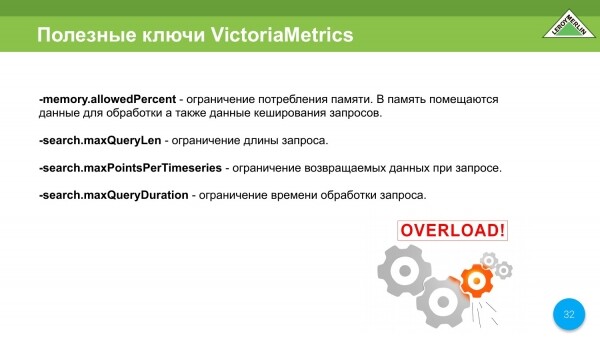
Këtu do të them menjëherë, ne po e shqyrtojmë VictoriaMetrics si një depo të metrikave. Por pasi do të ofrojmë ndoshta VictoriaMetrics si një depo për të gjithë Leroy, na nevojitet të kufizojmë ata që do ta përdorin këtë klaster, që të mos na dëmtojnë.
Ka një karakteristikë të shkëlqyer që lejon kufizimin në kohë, në sasi të dhënash dhe në kohën e ekzekutimit.
Ka gjithashtu një opsion të shkëlqyer që lejon kufizimin e konsumit të memories, duke na mundësuar të gjejmë atë ekuilibër që do të na japë një shpejtësi normale në punë dhe një konsum të arsyeshëm burimesh.
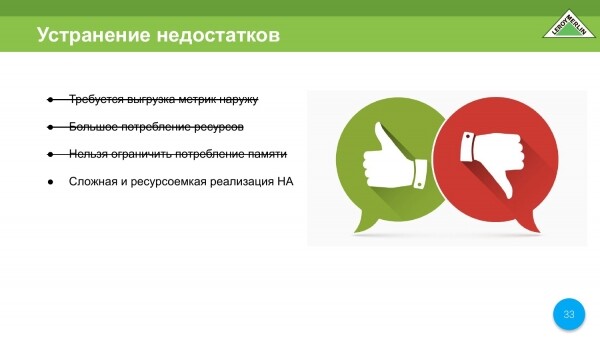
Minus një tjetër pikë, pra e heqim pikën – nuk mund të kufizohet konsumimi i memories.
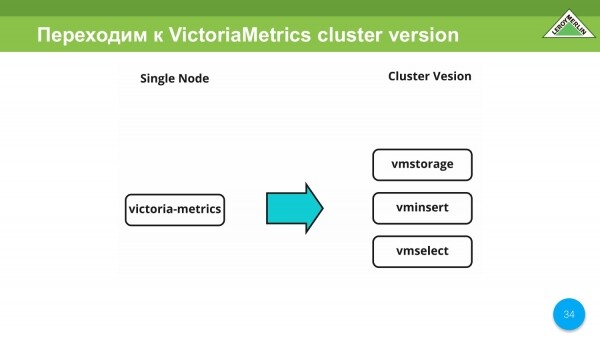
Në iteracionet e para ne testuam VictoriaMetrics Single Node. Tani po kalojmë në versionin e klasterit VictoriaMetrics.
Këtu kemi duar të lira për të shpërndarë shërbime të ndryshme në VictoriaMetrics në varësi të asaj që do të funksionojë dhe cilat burime do të konsumojë. Ky është një zgjidhje shumë fleksibile dhe e përshtatshme. Ne e kemi përdorur atë në praktikë.
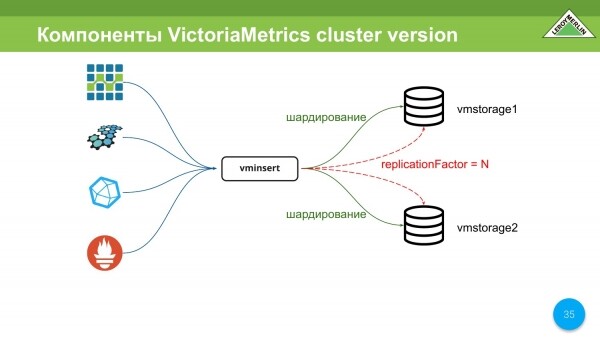
Komponentët kryesorë të versionit të klasterit VictoriaMetrics janë vmstorage. Mund të ketë N numra. Në rastin tonë deri tani ka 2.
Dhe kemi vminsert. Ky është një server proxy që na lejon të organizojmë sharding mes të gjithë storages që i kemi treguar atij dhe gjithashtu lejon një replikë, që do të thotë se do të keni si sharding ashtu edhe replikë.
Vminsert mbështet protokollet OpenTSDB, Graphite, InfluxDB dhe remoteWrite nga Prometheus.
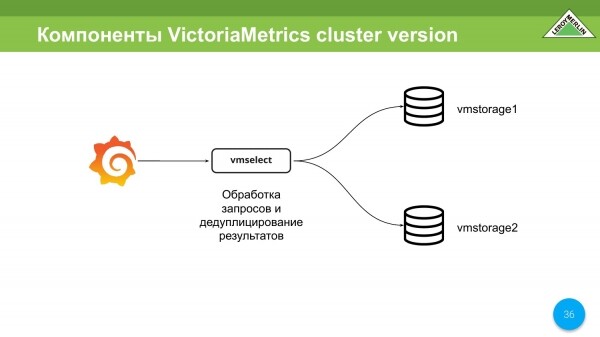
Ekziston gjithashtu vmselect. Detyra e tij kryesore është të shkojë në vmstorage, të marrë të dhënat prej tyre, të deduplice ato të dhëna dhe t'i dorëzojë klientit.
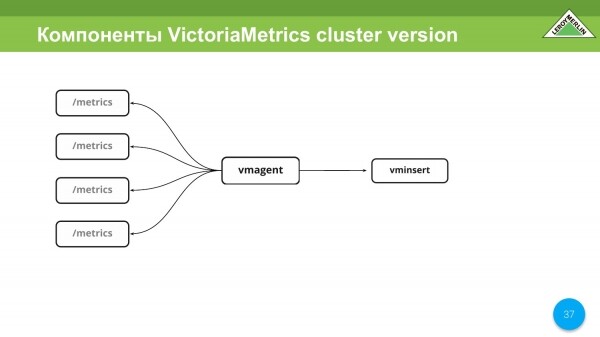
Ka një gjë të shkëlqyer si vmagent. Na pëlqen shumë. Ajo lejon të konfigurohet ashtu si Prometheus dhe po ashtu bën gjithçka si Prometheus. Pra, ai mbledh metrikat nga entitete dhe shërbime të ndryshme dhe i dërgon në vminsert. Më pas e gjithë kjo varet nga ju.
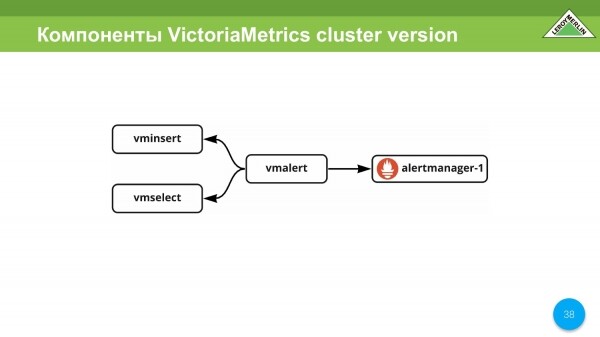
Një shërbim tjetër të shkëlqyer është vmalert, i cili lejon përdorimin e VictoriaMetrics si backend, merr të dhëna nga vminsert dhe dërgon informacionin e përpunuar në vmselect. Ajo përpunon alarmin dhe rregullat. Në rastin e alarmeve, ne marrim alarmin përmes alertmanager.
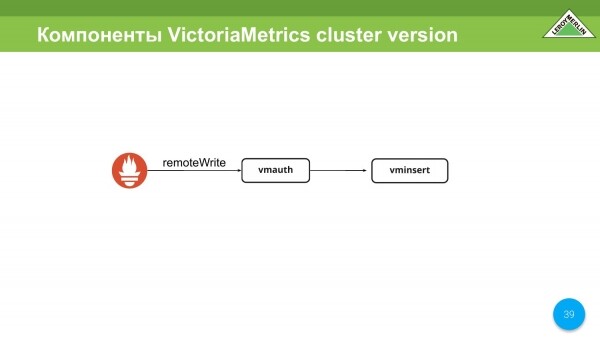
Ekziston një komponent wmauth. Ajo mund të përdoret, ndoshta, por ndoshta edhe jo (akoma nuk jemi vendosur për këtë) si sistem autorizimi në versionet multitenancy të klastereve. Mbështet remoteWrite për Prometheus dhe mund të autorizojë në bazë të URL-së, ose më saktë pjesës së dytë të saj, ku mundeni ose nuk mundeni të shkruani.
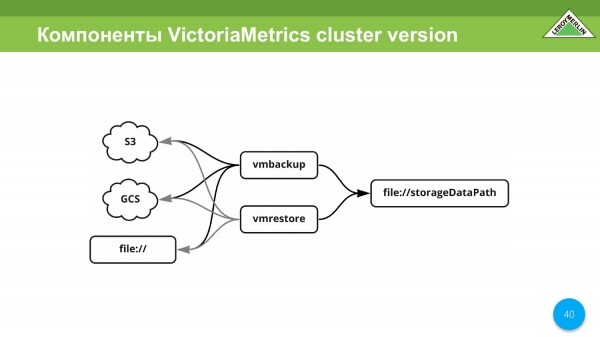
Ekzistojnë gjithashtu vmbackup, vmrestore. Këto, në thelb, janë rikuperimi dhe backup i të dhënave të gjitha. Ato mbështesin S3, GCS, file.
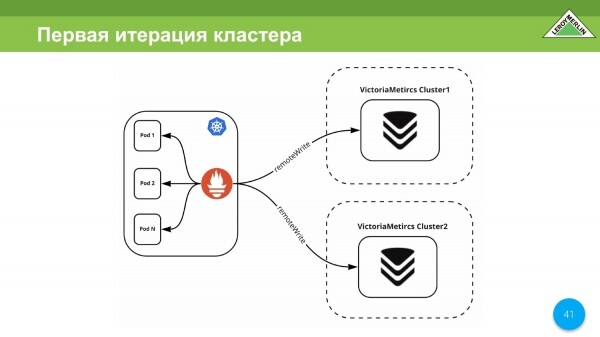
Iteracioni i parë i klasterit tonë u realizua gjatë karantinës. Në atë kohë nuk kishte një replikë, prandaj iteracioni ynë përbënte dy klasterë të ndryshëm dhe të pavarur, në të cilët përmes remoteWrite merrnim të dhëna.
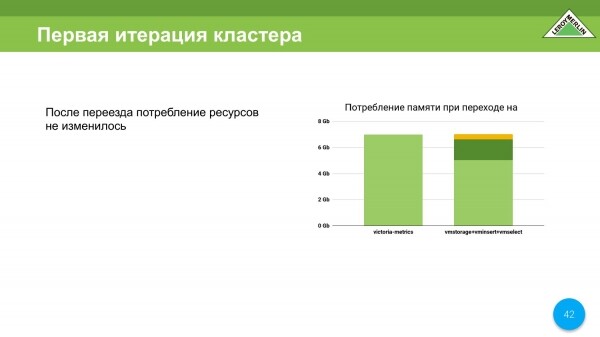
Këtu duhet të saktësoj se, kur kaluam nga VictoriaMetrics Single Node në Versionin e Klasterit VictoriaMetrics, ne u mbetem ende në të njëjtën konsumim burimesh, dmth. ndihma kryesore – kjo është memoria. Diku siç është ndarë konsumimi i burimeve, kështu janë ndarë të dhënat tona.
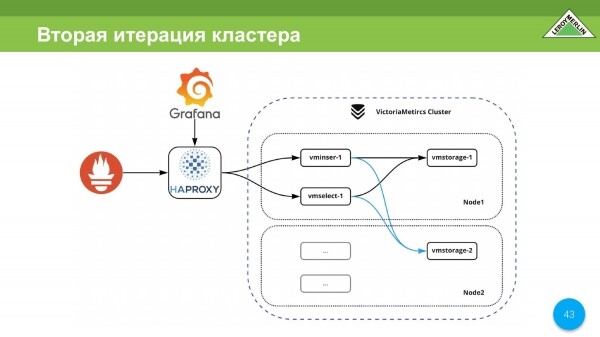
Këtu tashmë ishte shtuar një replikë. Ne e bashkuam gjithçka në një klaster relativisht të madh. Të dhënat tona janë të sharduara dhe gjithashtu të replikueshme.
I gjithë klasteri ka N pika hyrjeje, dmth. Prometheus mund të shtojë të dhëna përmes HAPROXY. Këtu kemi këtë pikë hyrjeje. Dhe përmes kësaj pike hyrjeje mund të hyjmë me Grafana.
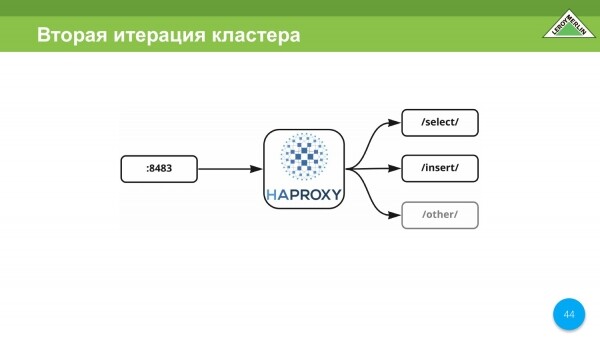
Në rastin tonë, HAPROXY është porta e vetme që proksionon select, insert dhe shërbime të tjera brenda këtij klasteri. Në rastin tonë nuk mund të bëhej një adresë e vetme, na duhej të krijonim disa pika hyrjeje, sepse vetë virtualet, mbi të cilat funksionon klasteri VictoriaMetrics, ndodhen në zona të ndryshme të një ofruesi të vetëm të shërbimeve cloud, dmth. jashtë cloud-it tonë, jo brenda.
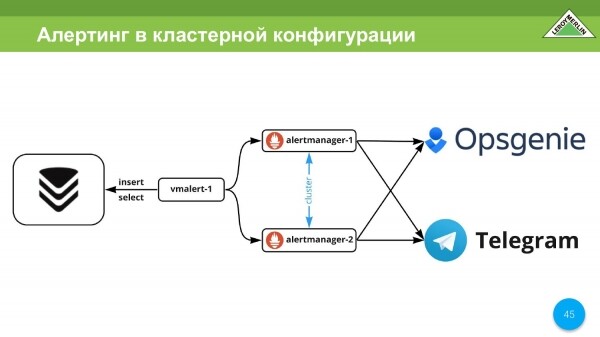
Kemi alertrim. Ne e përdorim atë. Ne përdorim alertmanager nga Prometheus. Si kanal për dërgimin e alerteve përdorim Opsgenie dhe Telegram. Në Telegram vijnë alerte nga dev, ndoshta diçka nga prodhimi, por më shumë diçka statistikore e nevojshme për inxhinierët. Opsgenie është për raste kritike. Këtu përfshihen thirrje, menaxhimi i incidenteve.
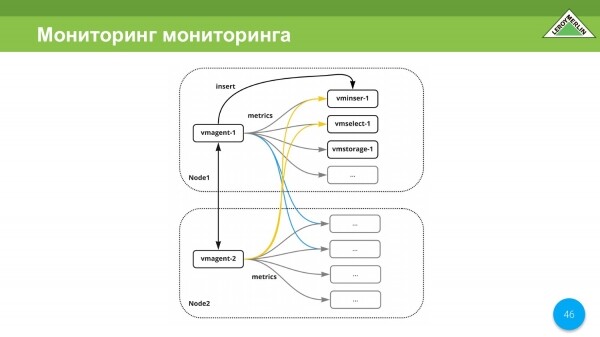
Pyetja e përhershme: "Kush e monitoron monitorimin?" Në rastin tonë, monitorimi monitoron vetë monitorimin, sepse ne përdorim vmagent në çdo nod. Dhe pasi nodet tona janë shpërndara në qendra të ndryshme të të dhënave të një ofruesi, çdo qendër ka kanalin e saj, ato janë të pavarura dhe madje nëse ndodhet një ndarje e trurit, ne do të marrim alerte. Po, do të jenë më shumë, por është më mirë të marrim më shumë alerte sesa asnjë.
Ne e mbyllim listën tonë me implementimin e HA.
Dhe më pas do të doja të theksoj përvojën e komunikimit me komunitetin VictoriaMetrics. Ajo rezultoi shumë pozitive. Djemtë janë të përgjegjshëm. Ata përpiqen të kuptojnë çdo rast që ofrohet.
Kam ngritur çështje në GitHub. Ato ishin zgjidhur shumë shpejt. Ka edhe disa çështje të tjera që nuk janë mbyllur plotësisht, por unë tashmë e shoh në kod se puna në këtë drejtim po vazhdon.
Dhimbja kryesore gjatë iteracioneve për mua ishte se kur shkëputja një nod, për 30 sekondat e para vminsert nuk mund të kuptonte se backend-i nuk ishte i pranishëm. Tani kjo është zgjidhur. Dhe për disa sekonda, të dhënat tashmë merren nga të gjitha nodet e mbetura dhe kërkesa nuk pret më për atë nodin e munguar.
Në një moment ne dëshironim që VictoriaMetrics të ishte operatori i VictoriaMetrics. E prisnim atë. Tani jemi në aktiv në ndërtimin e një lidhjeje mbi operatorin VictoriaMetrics për të marrë të gjitha rregullat e paracaktuar, etj., Prometheus, sepse ne e përdorim mjaft aktivisht rregullat që vijnë me operatorin Prometheus.
Ka propozime për përmirësimin e realizimit të klasterit. I kam paraqitur ato më lart.
Po ashtu, dëshiroj shumë që të ketë downsampling. Në rastin tonë, downsampling është nevojshëm ekskluzivisht për shikimin e trendeve. Në mënyrë të thjeshtë, mjafton një metrikë gjatë ditës. Këto trende janë të nevojshme për një vit, për tre, për pesë, për dhjetë vjet. Dhe një vlerë e metrikës është plotësisht e mjaftueshme.
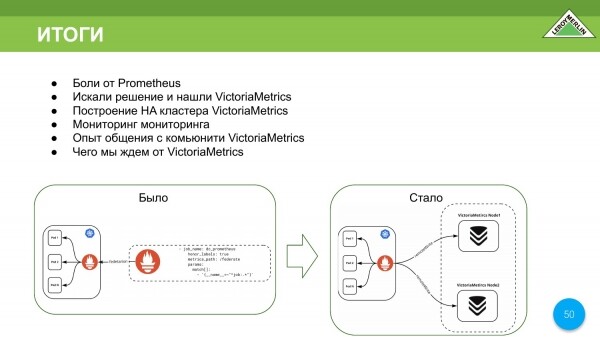
- Ne e kemi njohur dhimbjen, si dhe disa kolegë të tjerë, gjatë përdorimit të Prometheus.
- Ne zgjodhëm për vete VictoriaMetrics.
- Ajo shkallëzohet mjaft mirë si verticalisht, ashtu edhe horizontalisht.
- Ne mund të shpërndajmë komponentë të ndryshëm në një numër të ndryshëm nodash në klaster, të kufizojmë ato sipas sasisë së memories, të shtojmë memorie, etj.
Ne do ta përdorim VictoriaMetrics për vete, sepse na ka pëlqyer shumë. Kështu që ishte dhe siç është tani.
Një çift qr-kodesh për bisedën VictoriaMetrics, kontaktet e mia, radar teknik LeroyMerlin.
Burimi: habr.com
