

Tri vjetë më parë, Viktor Taranovski dhe Aleksej Milovidov nga Yandex në skenë HighLoad++ , treguan se sa i mirë është ClickHouse, dhe si ai nuk ngadalësohet. Ndërsa në skenën ngjitur ishte Aleksandër Zajcev me për kalimin në ClickHouse nga një tjetër sistem analizues dhe me përfundimin se ClickHouse, padyshim, është i mirë, por jo shumë i këndshëm për t'u përdorur. Kur në vitin 2016, kompania LifeStreet, në të cilën Aleksandri punonte atëherë, po transferonte një sistem analizues me shumë petabajtë në ClickHouse, kjo ishte një "rrugë nga tulla të verdha", e mbushur me rreziqe të panjohura — ClickHouse atëherë të ngjashme me një fushë mines.
Tri vjet më vonë ClickHouse është bërë shumë më mirë — gjatë kësaj kohe, Aleksandri themeloi kompaninë Altinity, e cila jo vetëm që ndihmon në kalimin në ClickHouse dhjetëra projekte, por gjithashtu përmirëson vetë produktin së bashku me kolegët nga Yandex. Tani ClickHouse nuk është një shëtitje pa brenga, por gjithashtu nuk është më një fushë mines.
Aleksandri merret me sisteme të shpërndara që nga viti 2003, ka zhvilluar projekte të mëdha në MySQL, Oracle dhe Vertica. Në konferencën e zhvilluar HighLoad++ 2019 Aleksandri, një nga pionierët në përdorimin ClickHouse, tregoi se çfarë përfaqëson tani ky sistem menaxhimi të të dhënave. Ne do të mësojmë për karakteristikat kryesore ClickHouse: si ai dallon nga sistemet e tjera dhe në cilat raste është më efektiv të përdoret. Me shembuj do të shqyrtojmë praktika të reja dhe të provuara nga projektet për ndërtimin e sistemeve mbi ClickHouse.
Retrospektivë: çfarë ndodhi 3 vjet më parë
Tri vjet më parë ne po transferonim kompaninë LifeStreet në ClickHouse nga një bazë të dhënash analitike tjetër, dhe migrimi i analizës së rrjetit të reklamave dukej kështu:
- Qershor 2016. Në OpenSource doli ClickHouse dhe filloi projekti ynë;
- Gusht. Proof Of Concept: një rrjet i madh reklamash, infrastrukturë dhe 200-300 terabajtë të dhënash;
- Tetor. Të dhënat e para në prodhim;
- Dhjetor. Ngarkesa e plotë produktive — 10-50 miliardë ngjarjesh në ditë.
- Qershor 2017. Migrimi i suksesshëm i përdoruesve në ClickHouse, 2.5 petabajtë të dhënash në një klaster prej 60 serverash.
Gjatë procesit të migrimit u rrit kuptimi se ClickHouse është një sistem i mirë, me të cilin është këndshme të punosh, por është një projekt të brendshëm i kompanisë Yandex. Prandaj ka nuanca: Yandex fillimisht do të merret me kërkesat e brendshme dhe vetëm më vonë me komunitetin dhe nevojat e përdoruesve të jashtëm, ndërsa ClickHouse nuk arrinte atëherë në nivelin e ndërmarrjes në shumë fusha funksionale. Prandaj, në mars 2017 themeluam kompaninë Altinity, për të bërë ClickHouse edhe më të shpejtë dhe më të rehatshëm jo vetëm për Yandex, por edhe për përdorues të tjerë. Dhe tani ne:
- Mësojmë dhe ndihmojmë në ndërtimin e zgjidhjeve mbi ClickHouse në mënyrë që klientët të mos hasin vështirësi dhe që zgjidhja përfundimisht të funksionojë;
- Sigurojmë mbështetje 24/7 ClickHouse-instalimeve;
- Zhvillojmë projekte të ecosistemit tonë;
- Aktivisht angazhohemi në vetë ClickHouse, duke përgjigjur në kërkesat e përdoruesve që duan të shohin tipare të caktuara.
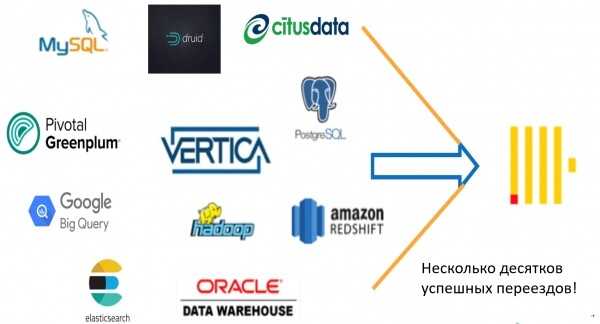
Natyrisht, ne ndihmojmë gjithashtu me kalimin në ClickHouse me MySQL, Vertica, Oracle, Greenplum, Redshift dhe sisteme të tjera. Ne kemi marrë pjesë në kalime të ndryshme, dhe të gjitha kanë qenë të suksesshme.
Pse duhet të kaloni në ClickHouse
Nuk ngadalëson! Kjo është arsyeja kryesore. ClickHouse — një bazë të dhënash shumë të shpejtë për skenarë të ndryshëm:
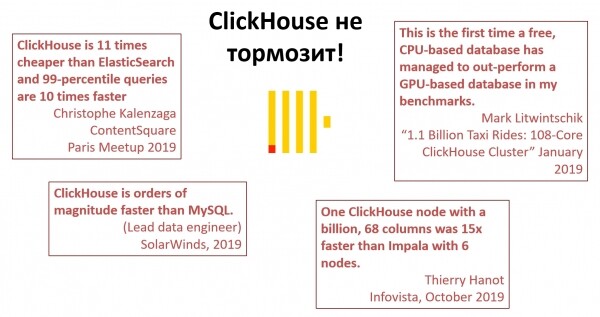
Citatet rastësore të njerëzve që punojnë për një kohë të gjatë me ClickHouse.
Shkallëzimi. Në një bazë tjetër të dhënash, mund të arrini performancë të mirë në një hardware të vetëm, por ClickHouse mund të shkallëzohet jo vetëm në mënyrë vertikale, por edhe horizontalisht, thjesht duke shtuar servera. Gjithçka nuk funksionon aq smooth sa do të dëshironit, por funksionon. Mund të rritni sistemin me rritjen e biznesit. Është e rëndësishme që nuk jemi të kufizuar nga zgjidhja tani dhe gjithmonë ka potencial për zhvillim.
Portabiliteti. Nuk ka varësi nga diçka të vetme. Për shembull, me Amazon Redshift është e vështirë të kalosh diku tjetër. Ndërsa ClickHouse mund ta instaloni në laptopin tuaj, server, ta vendosni në cloud, të shkoni në Kubernetes nuk ka kufizime për të shfrytëzuar infrastrukturën. Kjo është e sigurt për të gjithë dhe është një avantazh i madh që shumë baze të dhënash të ngjashme nuk mund ta lavdërojnë.
Fleksibiliteti. ClickHouse nuk ndalet në diçka të vetme, siç është Yandex.Metrika, por zhvillohet dhe përdoret në një numër gjithnjë e më të madh projektesh dhe industrish. Mund ta zgjeroni atë, duke shtuar mundësi të reja për të zgjidhur detyra të reja. Për shembull, besohet se ruajtja e log-eve në bazën e të dhënave është një lloj faux pas, prandaj për këtë është shpikur Elasticsearch. Por, falë fleksibilitetit të ClickHouse, gjithashtu mund të ruani log-e dhe shpesh kjo është madje më mirë sesa në Elasticsearch — në ClickHouse për këtë kërkohet 10 herë më shumë hardware.
Falë Open Source. Nuk ka nevojë të paguani për asgjë. Nuk ka nevojë të kontaktoni për të marrë leje për ta vendosur sistemin në laptopin ose serverin tuaj. Nuk ka pagesa të fshehura. Në të njëjtën kohë, asnjë teknologji tjetër Open Source baze të dhënash nuk mund të konkurrojë në shpejtësi me ClickHouse. MySQL, MariaDB, Greenplum — të gjitha ato janë shumë më të ngadalta.
Komuniteti, dinamikat dhe fun. ClickHouse një komunitet i shkëlqyer: takime, biseda dhe Aleksei Milovidov, i cili na ngroh të gjithëve me energjinë dhe optimizmin e tij.
Kalimi në ClickHouse
Për të kaluar në ClickHouse një tjetër sistem, ju nevojiten vetëm tri gjëra:
- Të kuptoni kufizimet ClickHouse dhe për çfarë nuk është i përshtatshëm.
- Të përdorni avantazhet e teknologjisë dhe karakteristikat e saj më të forta.
- Të eksperimentoni. Edhe duke kuptuar se si funksionon ClickHouse, nuk është gjithmonë e mundur të parashikohet kur ai do të jetë më i shpejtë, kur më i ngadaltë, kur më i mirë dhe kur më i keq. Prandaj provoni.
Problemi i kalimit
Ka vetëm një "por": nëse kaloni nga ClickHouse një sistem tjetër, zakonisht diçka nuk shkon siç duhet. Ne jemi mësuar me disa praktika dhe gjëra që funksionojnë në bazën tonë të të dhënave të preferuar. Për shembull, çdo person që punon me baza të dhënash SQL, e konsideron si të domosdoshme një grup funksionesh:transaksionet;
- kufizimet;
- koherenca;
- indekset;
- UPDATE/DELETE
- NULLs;
- milisekonda;;
- konsistenca automatike e tipave;
- bashkëveprimi i shumëfishtë;
- particionet arbitrare;
- mjetet për menaxhimin e klasterëve.
- Grupi është i domosdoshëm, por tre vjet më parë në
nuk kishte asnjë nga këto funksione! Tani nga ato që nuk ishin realizuar, ka mbetur më pak se gjysma: transaksionet, kufizimet, koherenca, milisekondat dhe automatizimi i tipave. ClickHouse Dhe e rëndësishmja është se në
disa praktika dhe qasje standarde nuk funksionojnë ose funksionojnë ndryshe nga ç'jemi mësuar. Gjithçka që shfaqet në ClickHouse , përputhet me " ClickHouseClickHouse way", dmth. funksionet ndryshojnë nga bazat e tjera të të dhënave. Për shembull:Indekset nuk përzgjidhen, por kalohen.
- nuk janë sinkron, por asinkron.
- NULLs Ka bashkëveprime të shumëfishta, por nuk ka planifikues kërkesash. Si realizohen ata, nuk është përgjithësisht shumë e qartë për njerëzit nga bota e bazave të të dhënave.
- Skenarët e ClickHouse
Në vitin 1960, matematicieni amerikan me origjinë hungareze
Wigner E. P. shkroi një artikull " The unreasonable effectiveness of mathematics in the natural sciences" ("Efektiviteti i paarsyeshëm i matematikës në shkencat natyrore") mbi faktin se bota rreth nesh për një arsye të caktuar përshkruhet mirë nga ligjet matematikore. Matematikë — një shkencë abstrakte dhe ligjet fizike, të shprehura në formën matematike nuk janë triviale, dhenxori në pah se kjo është shumë e çuditshme. shkroi një artikull " Sipas mendimit tim,
— është njëlloj çuditëri. Duke e rimodelluar Wigner-in, mund të themi kështu: është mahnitëse efekti i paarsyeshëm ClickHouse në aplikacione analitikë të shumëllojshme! ClickHouse Për shembull, le të marrim
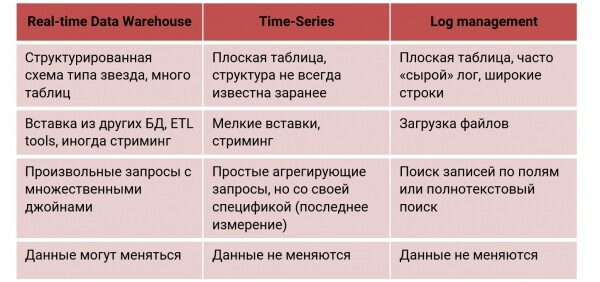
Real-Time Data Warehouse Depoja e Dhënash në Kohë Reale, në të cilin të dhënat ngarkohet praktikisht vazhdimisht. Ne duam të marrim kërkesa prej tij me vonesë një sekondë. Të lutem — përdorim ClickHouse, sepse për këtë skenar është dizajnuar. ClickHouse kështu përdoret jo vetëm në web, por edhe në analizat e marketingut dhe financiare, AdTech, si dhe në Fraud detection. Në Real-time Data Warehouse përdoret një skemë e kompleks strukturës tip «yll» ose «flokë», shumë tabela me JOIN (nganjëherë të shumëfishta), dhe të dhënat zakonisht ruhen dhe ndryshohen në ndonjë sistem.
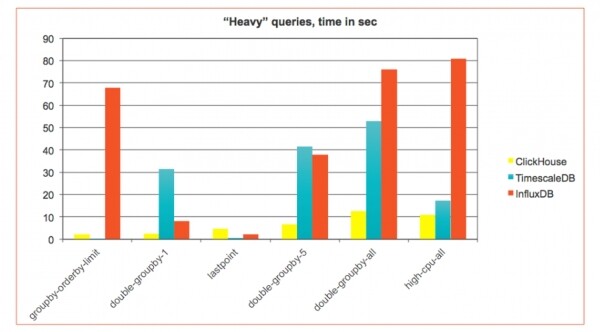
Le të marrim një skenar tjetër — Time Series: monitorimi i pajisjeve, rrjeteve, statistika e përdorimit, interneti i gjërave. Këtu ndeshemi me ngjarje të thjeshta të renditura sipas kohës. ClickHouse për këtë nuk u dizajnua fillimisht, por e tregoi veten mirë, prandaj kompanitë e mëdha e përdorin ClickHouse si një depo për informacionet e monitorimit. Për të studiuar nëse ClickHouse është i përshtatshëm për time-series, ne bëmë një benchmark mbi qasjen dhe rezultatet InfluxDB dhe TimescaleDB — bazat e të dhënave të specializuara time-series , edhe pa optimizim për këto detyra, fiton dhe në fushë të huaj: , që ClickHousezakonisht përdoret një tabelë e ngushtë — disa kolona të vogla. Nga monitorimi mund të vijnë shumë të dhëna, — miliona regjistrimeve në sekondë, — dhe zakonisht ato vijnë në kërcime të vogla (
Në time-series streaming). Prandaj, nevojitet një skenar tjetër i futjes, dhe vetë kërkesat — me ndonjë specifikë.real-time Log Management
. Grumbullimi i logeve në DB — kjo zakonisht është keq, por nëmund të bëhet me disa komente, siç u përmend më sipër. Shumë kompani e përdorin ClickHouse pikërisht për këtë. Në këtë rast përdoret një tabelë e gjerë dhe e sheshtë, ku ruajmë loget e plota (p.sh., në formën e ClickHouse ), ose i prenojmë në pjesë. Të dhënat ngarkohen zakonisht në grupe të mëdha (skedarë), dhe kërkohet ndonjë fushë. JSONPër secilën nga këto funksione zakonisht përdoren DB të specializuara.
një mund ta bëjë këtë të gjitha dhe aq mirë, sa e tejkalon ato në performancë. Le të shqyrtojmë tani në detaje ClickHouse skenerin, dhe si të «përgatisim» time-series për këtë skenar. ClickHouse Time-Series
Në këtë moment, ky është skenari kryesor për të cilin
në konsiderohet zgjidhja standarde. ClickHouse Time-series time-series — është një grup ngjarjesh të renditura në kohë, që paraqesin ndryshimet e një procesi në kohë. Për shembull, kjo mund të jetë frekuenca e rrahjeve të zemrës për një ditë ose numri i proceseve në një sistem. Çdo gjë që ofron tick të kohës me disa masa – është time-series:
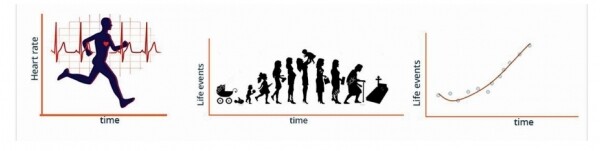
Më shumë nga këto lloje ngjarjesh vijnë nga monitorimi. Kjo mund të jetë jo vetëm monitorimi i webit, por edhe i pajisjeve reale: automjete, sisteme industriale, IoT, prodhimesh ose taksive të pa pilot, në bagazhin e të cilave Yandex tashmë po vendos ClickHouse-server.
Për shembull, ka kompani që mbledhin të dhëna nga anijet. Çdo disa sekonda sensorë nga një anije kontejner ndajnë qindra masa të ndryshme. Inxhinierët i studiojnë, ndërtojnë modele dhe përpiqen të kuptojnë sa efektivisht po shfrytëzohet anija, sepse anija kontejner nuk duhet të qëndrojë asnjë sekondë. Çdo qëndrim – është humbje parash, prandaj është e rëndësishme të parashikohet rruta në mënyrë që ndalesat të ishin minimale.
Aktualisht po vërehet një rritje e DB-ve të specializuara që mat time-series. Në uebfaqen DB-Engines për ndonjë arsye renditen databaza të ndryshme dhe mund të shihen sipas llojeve:
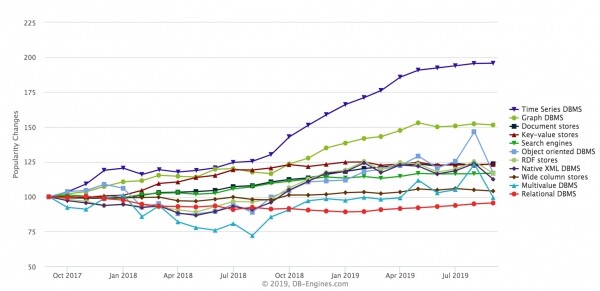
Lloji më në rritje është time-series. Gjithashtu po rriten DB të grafikëve, por time-series po rriten më shpejt vitet e fundit. Pjesëtare tipike të këtij familjeje DB janë InfluxDB, Prometheus, KDB, TimescaleDB (ndërtuar mbi PostgreSQL), zgjidhjet nga Amazon. ClickHouse këtu gjithashtu mund të përdoret, dhe përdoret. Do të jap disa shembuj publik.
Një nga pionierët është kompania CloudFlare (CDN-ofrues). Ata monitorojnë CDN nëpërmjet ClickHouse (DNS-kërkesat, HTTP-kërkesat) me një ngarkesë të madhe — 6 milion ngjarje në sekondë. Të gjitha kalojnë përmes Kafka, dërgohet në ClickHouse, i cili ofron mundësinë për të parë në kohë reale dashboardet e ngjarjeve në sistem.
Comcast — një nga liderët e telekomunikacioneve në SHBA: internet, televizion digjital, telefonia. Ata krijuan një sistem të ngjashëm menaxhimi CDN në kuadër të Open Source i projektit Apache Traffic Control për të punuar me të dhënat e tyre të mëdha. ClickHouse përdoret si backend për analizë.
Percona kanë integruar ClickHouse brenda PMM, për të ruajtur monitorimin e të ndryshmeve MySQL.
Kërkesat specifike
DB-ve time-series kanë kërkesat e tyre specifike.
- Vënia e shpejtë nga shumë agjentë.Duhet të vendosim shumë shpejt të dhëna nga shumë rrjedha. ClickHouse bën mirë këtë, sepse të gjitha vëniet e saj nuk janë bllokuese. Çdo insert — është një skedar i ri në disk, dhe mund të bëhen bufere të vogla në një mënyrë ose në një tjetër. Në ClickHouse është më mirë të vendosni të dhënat në paketa të mëdha, e jo një rresht të vetëm.
- Skema e përshtatshme. Në time-series ne zakonisht nuk e dimë strukturën e të dhënave deri në fund. Mund të ndërtojmë një sistem monitorimi për një aplikacion të caktuar, por atëherë është e vështirë ta përdorim për një aplikacion tjetër. Për këtë nevojitet një skemë më fleksibile. ClickHouse, e cila lejon ta bëjë këtë, edhe pse kjo është një bazë e tipizuar rreptësisht.
- Ruajtja efikase dhe "harresimi" i të dhënave. Zakonisht në time-series një volum gjigand të dhënash, prandaj duhet të ruhet sa më efektivisht. Për shembull, InfluxDB kompresimi i mirë – është karakteristika e tij kryesore. Por përveç ruajtjes, duhet edhe të jemi në gjendje të "harrojmë" të dhënat e vjetra dhe të bëjmë ndonjë downsampling — llogaritje automatike të agregateve.
- Kërkesa të shpejta për të dhënat e agreguara. Ndonjëherë është interesante të shohësh 5 minutat e fundit me saktësi deri në milisekonda, por në të dhënat mujore, granulariteti minutor ose sekondar mund të mos jetë i nevojshëm — statistika e përgjithshme është e mjaftueshme. Mbështetje e tillë është e nevojshme, ndryshe kërkesa për 3 muaj do të ekzekutohet shumë ngadalë edhe në ClickHouse.
- Kërkesat e tipit "pikën e fundit, deri në». Këto janë kërkesa tipike për time-series : shikojmë matjen ose gjendjen më të fundit të sistemit në një moment të caktuar t. Për DB nuk janë kërkesa shumë të këndshme, por duhet të mësojmë si t'i ekzekutojmë ato.
- "Lidhja" e serive temporale. time-series — është një seri temporale. Nëse ka dy seria temporale, shpesh ato duhet të bashkohen dhe korelacionohen. Nuk është e përshtatshme ta bësh këtë në të gjitha DB, veçanërisht me seria temporale që nuk janë të rregulluara: këtu — janë disa kohë, atje — disa të tjera. Mund të llogariten mesatarja, por ndoshta do të ketë ende një boshllëk, prandaj nuk është e qartë.
Le të shohim se si plotësohen këto kërkesa në ClickHouse.
Skema
Në ClickHouse skema për time-series mund të bëhet në mënyra të ndryshme, në varësi të shkallës së rregullshmërisë së të dhënave. Mund të ndërtojmë një sistem mbi të dhëna të rregullta, kur e dimë të gjitha metrikat paraprakisht. Për shembull, kështu bëri CloudFlare me monitorimin CDN — është një sistem i optimizuar mirë. Mund të ndërtojmë një sistem më të përgjithshëm, i cili monitoron të gjithë infrastrukturën, shërbime të ndryshme. Në rastin e të dhënave të pa-rregulluara, ne nuk e dimë paraprakisht se çfarë po monitorojmë — dhe ndoshta ky është rasti më i përgjithshëm.
Të dhëna të rregullta. Kolonat. Skema është e thjeshtë – kolona me llojet e nevojshme:
KRIJONI TABELËN cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* bashkëngjiteni dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Kjo është një tabelë e zakonshme që monitoron ndonjë aktivitet në ngarkesën e sistemit (user, sistem., i lirë, nice). E thjeshtë dhe e përshtatshme, por jo e çvendosur. Nëse duam një skemë më të përshtatshme, mund të përdorim array.
Të dhëna jo të rregullta. Array:
KRIJONI TABELËN cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Struktura Nested — është dy array: metrics.name dhe metrics.value. Këtu mund të ruhen të dhëna të tilla monitoruese të rastit si një array emrash dhe një array masash në çdo ngjarje. Për optimizim të mëtejshëm, në vend të një strukture të tillë mund të bëjmë disa. P.sh., një për filestream-vlerë, një tjetër për int-vlerë, sepse int duhet të ruajmë në mënyrë më efikase.
Por, kjo strukturë është më e vështirë për t'u aksesuar. Do të duhet të përdorim një konstrukcion të veçantë, përmes funksioneve speciale për të nxjerrë fillimisht vlerat nga indeksi dhe pastaj nga array:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Por kjo akoma funksionon mjaft shpejt. Një mënyrë tjetër për të ruajtur të dhëna jo të rregullta është sipas rreshtave.
Të dhëna jo të rregullta. Rreshtat. Në këtë mënyrë tradicionale pa array ruhen direkt emrat dhe vlerat. Nëse nga një pajisje vijnë menjëherë 5,000 masa — krijohen 5,000 rreshta në DB:
KRIJONI TABELËN cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
ClickHouse këtë e bën — ai ka zgjerime speciale ClickHouse SQL. Për shembull, maxIf — është një funksion special që llogarit maksimumin sipas metrike kur përmbushet një kusht. Mund të shkruhen disa shprehje të tilla në një kërkesë dhe menjëherë të llogaritet vlera për disa metrika.
Le të krahasojmë tri qasje:
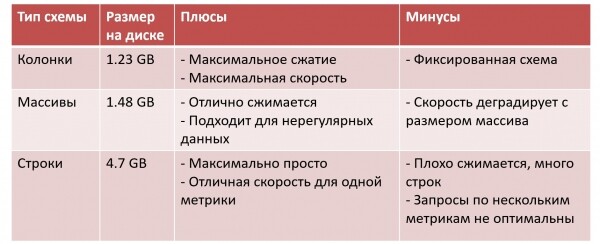
Këtu kam shtuar "Madhësia e të dhënave në disk" për një grup testues të dhënash. Në rastin e kolonave, kemi madhësinë më të vogël të të dhënave: kompresim maksimal, shpejtësi maksimale të kërkesave, por paguajmë me faktin se duhet ta regjistrojmë gjithçka menjëherë.
Në rastin e skemave, gjërat janë pak më keq. Të dhënat përsëri kompresohen mirë, dhe mund të ruajmë një skemë të papërfillshme. Por ClickHouse — baza e të dhënave kolonale, dhe kur fillojmë të ruajmë gjithçka në skema, ajo transformohet në një varg, dhe paguajmë për fleksibilitetin me efikasitetin. Për çdo operacion do të duhet të lexojmë të gjithë skemën në memorie, dhe pastaj të gjejmë elementin e nevojshëm — dhe nëse skema rritet, shpejtësia degradon.
Në një nga kompanitë që përdorin këtë qasje (për shembull, ), skemat ndahen në pjesë prej 128 elementësh. Të dhënat e disa mijëra metrike me një volum prej 200 TB të dhënash/në ditë ruhen në jo një, por në 10 ose 30 skema me logjikë të veçantë për ruajtje.
Qasja më e thjeshtë është me vargjet. Por të dhënat nuk kompresohen mirë, madhësia e tabelës rezulton e madhe, dhe kur kërkesat shkojnë përmes disa metrike, ClickHouse funksionon në mënyrë jo optimale.
Skema hibride
Le të supozojmë se kemi zgjedhur një skemë me skema. Por nëse e dimë se shumica e paneleve tona tregojnë vetëm metrike përdoruesi dhe sistemi, mund të materializojmë këto metrika nga skema në nivel tabelash në këtë mënyrë:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Gjatë futjes ClickHouse automatikisht do t'i llogarisë. Në këtë mënyrë mund të kombinojmë të këndshmen me të dobishmen: skema është fleksibël dhe e përgjithshme, por kolonat më të përdorura i kemi nxjerrë. Vërej se kjo nuk kërkoi të ndryshonim futjen dhe ETL, i cili vazhdon të fusë skemat në tabelë. Ne thjesht bëmë ALTER TABLE, shtuam disa kolona dhe rezultoi një skemë hibride dhe më të shpejtë, e cila mund të fillojë të përdoret menjëherë.
Kodekët dhe kompresimi
Për time-series është e rëndësishme, sa mirë e paketoni të dhënat, sepse sasia e informacionit mund të jetë verye e madhe. Në ClickHouse ka një grup mjetesh për të arritur një efekt kompresimi 1:10, 1:20, e ndonjëherë më shumë. Kjo do të thotë se të dhënat e paketuara me një volum prej 1 TB në disk zënë 50-100 GB. Një madhësi më e vogël është e mirë, të dhënat mund të lexohen dhe përpunohen më shpejt.
Për të arritur një nivel të lartë kompresimi, ClickHouse pajisni me kodekët e mëposhtëm:
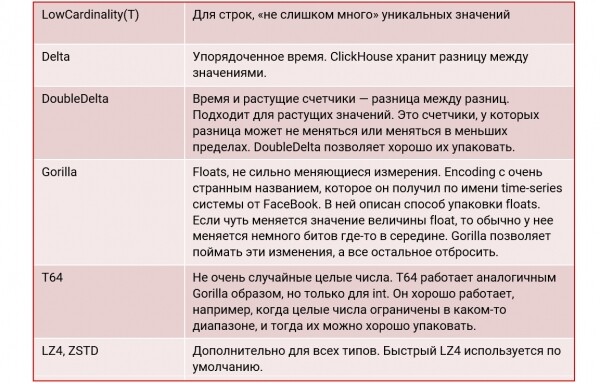
Shembuj të tabelës:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Këtu përcaktojmë kodekun DoubleDelta në një rast, në rastin tjetër — Gorilla, dhe patjetër shtojmë LZ4 kompresimin. Si rezultat, madhësia e të dhënave në disk zvogëlohet shumë:
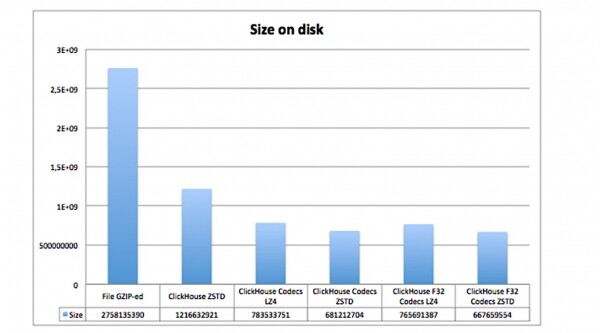
Këtu është treguar se sa hapësirë zënë të njëjtat të dhëna, por me përdorimin e kodekëve dhe kompresioneve të ndryshme:
- në skedarin GZIP në disk;
- në ClickHouse pa kodekë, por me kompresimin ZSTD;
- në ClickHouse me kodekë dhe kompresim LZ4 dhe ZSTD.
E dukshme se tabelat me kodekë zënë shumë më pak hapësirë.
Madhësia ka rëndësi
Po aq e rëndësishme është lloji i duhur i të dhënave:
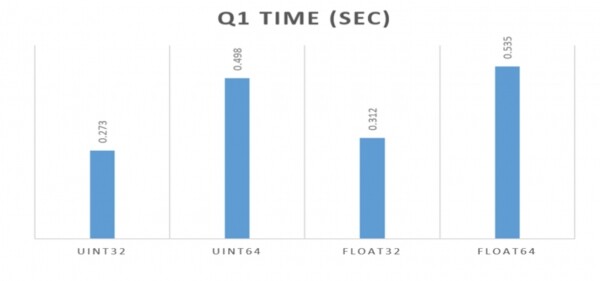
Në të gjitha shembujt më sipër, unë përdora Float64. Por nëse do të kishim zgjedhur Float32, atëherë do të ishte edhe më mirë. Kjo u demonstruar mirë nga ekipet nga Perkona në artikullin e lidhur më sipër. Është e rëndësishme të përdorësh llojin më të kompakt të mundshëm, që i përshtatet detyrës: madje në një masë më të vogël për madhësinë në disk, sesa për shpejtësinë e pyetjeve. ClickHouse është shumë ndjesore ndaj kësaj.
Nëse mund të përdorni int32 në vend të int64, prisni një rritje pothuajse dyfish të performancës. Të dhënat zënë më pak memorie, dhe gjithë "aritmetikën" e punës e bën shumë më shpejt. ClickHouse brenda vetes — një sistem i tipizuar shumë strikt, ai maksimalisht shfrytëzon të gjitha mundësitë që ofrojnë sistemet moderne.
Agregimi dhe Materialized Views
Agregimi dhe pamjet e materializuara lejojnë krijimin e agregateve për raste të ndryshme:
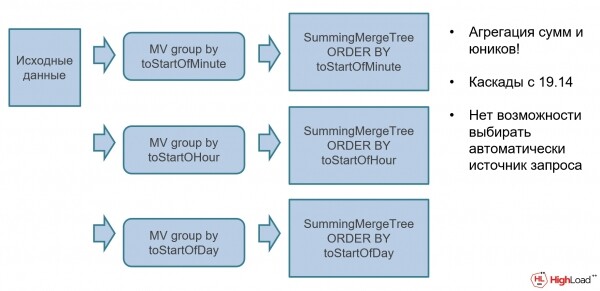
Për shembull, mund të keni të dhëna burimore të paagreguara, dhe mbi to mund të vendosni pamje të ndryshme materializuara me përllogaritje automatike përmes motorit të veçantë SummingMergeTree (SMT). SMT — është një strukturë e veçantë të dhënash që agregon automatikisht agregatet. Të dhënat bruto futen në bazën e të dhënave, ato agregohen automatikisht dhe menjëherë mund të përdoren për panelat.
TTL — «e harrojmë» të dhënat e vjetra
Si mund të «harrojmë» të dhënat që nuk na nevojiten më? ClickHouse e bën këtë. Gjatë krijimit të tabelave mund të specifikoni TTL shprehje: për shembull, të dhënat minutore i ruajmë për një ditë, ato ditore për 30 ditë, ndërsa ato javore ose mujore nuk i prekim kurrë:
KRIJO TABELË aggr_by_minute
…
TTL kohë + interval 1 ditë

KRIJO TABELË aggr_by_day
…
TTL kohë + interval 30 ditë

KRIJO TABELË aggr_by_week
…
/* pa TTL */
Multi-tier — ndajmë të dhënat sipas disqeve
Duke zhvilluar këtë ide, të dhënat mund të ruhen në ClickHouse në vende të ndryshme. Supozoni se duam të ruajmë të dhënat e nxehta për javën e fundit në një SSDdisk lokal shumë të shpejtë, ndërsa të dhënat më historike i vendosim në një vend tjetër. Në ClickHouse tani është e mundur:
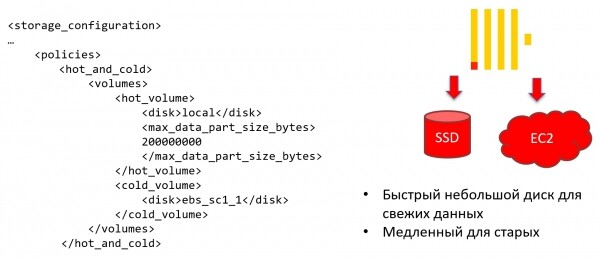
Mund të konfigurohet politika e ruajtjes (politika e ruajtjes) në mënyrë që ClickHouse të zhvendosë automatikisht të dhënat kur arrijmë disa kushte në një ruajtje tjetër.
Por nuk është vetëm kjo. Në nivelin e tabelës specifike mund të përcaktohen rregulla, kur pikërisht sipas kohës të dhënat kalojnë në ruajtje të ftohtë. Për shembull, për 7 ditë të dhënat qëndrojnë në një disk shumë të shpejtë, ndërsa gjithçka që është më e vjetër transferohet në një të ngadalshme. Kjo është e mirë pasi lejon sistemin të mbajë performancën maksimale, duke kontrolluar shpenzimet dhe pa ndjerë kosto për të dhënat e ftohta:
KRIJO TABELË
...
TTL data + INTERVAL 7 DITË TË VOLUMIT 'cold_volume',
data + INTERVAL 180 DITË FSHIJ
Mundësitë unike ClickHouse
Gati në çdo gjë në ClickHouse ka këto «pikat e veçanta», por ato zbehen nga ekskluziviteti — ajo që nuk ndodhet në bazat e tjera të të dhënave. Për shembull, këtu janë disa nga funksionet unike ClickHouse:
- Array. Në ClickHouse mbështetje shumë e mirë për array-t, si dhe mundësia për të kryer llogaritje komplekse mbi to.
- Strukturat agreguese të të dhënave. Kjo është një nga «karakteristikat e vrastarëve» ClickHouse. Pavarësisht se djemtë nga Yandex thonë se ne nuk duam të agregojmë të dhënat, të gjithë agregojnë në ClickHouse, sepse është e shpejtë dhe e përshtatshme.
- Përshtatjet e materializuara. Së bashku me strukturat agreguese të të dhënave, përshtatjet e materializuara lejojnë kryerjen e një real-time agregimi të lehtë.
- ClickHouse SQL. Kjo është një zgjerim i gjuhës SQL me disa karakteristika shtesë dhe ekskluzive që i ka vetëm në ClickHouse. Disa herë ishte si një zgjerim nga njëra anë, dhe nga ana tjetër një disavantazh. Tani, pothuajse të gjitha disavantazhet në krahasim me SQL 92 i kemi hequr, tani është vetëm një zgjerim.
- Lambda-shprehjet. A kanë ato ende ndonjë bazë të dhënash tjetër?
- ML-mbështetje. Kjo është e pranishme në baza të ndryshme të dhënash, në disa më mirë, në disa më keq.
- Kod i hapur. Ne mund të zgjerojmë ClickHouse bashkë. Tani në ClickHouse rreth 500 kontribues, dhe ky numër po rritet vazhdimisht.
Kërkesat e zgjuara
Në ClickHouse ka shumë mënyra të ndryshme për të bërë të njëjtën gjë. Për shembull, mund të kthejmë vlerën e fundit nga tabela në tri mënyra të ndryshme për CPU (ka edhe një të katërt, por ai është edhe më ekzotik).
E para tregon se sa e lehtë është të bësh në ClickHouse kërkesa, kur dëshiron të kontrollosh se tuple është e pranishme në një nënkërkesë. Kjo është ajo që personalisht më ka munguar shumë në baza të tjera të dhënash. Nëse dëshiroj të krahasoj ndonjë gjë me një nënkërkesë, atëherë në baza të tjera të dhënash mund të krahasoj vetëm një skalar, dhe për disa kolona duhet të shkruaj JOIN. Në ClickHouse mund të përdorësh tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Mënyra e dytë bën të njëjtën gjë, por përdor funksionin agregat argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
Në ClickHouse ka disa dhjetëra funksione agregate, dhe nëse përdoren kombinatorët, atëherë sipas ligjeve të kombinatorikës do të përfundojë me rreth një mijë. ArgMax -një nga funksionet që llogarit vlerën maksimale: kërkesa kthen vlerën usage_user, në të cilën arrihet vlera maksimale created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
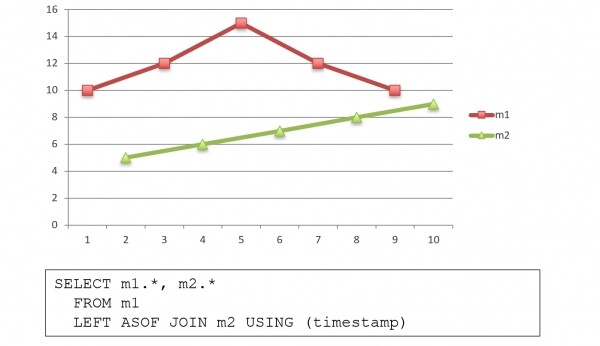
ASOF JOIN -"në lidhje" të rreshtave me kohë të ndryshme. Kjo është një funksion unik për bazat e dhënash, i cili gjendet gjithashtu vetëm në kdb+. Nëse ka dy seri kohore me kohë të ndryshme, ASOF JOIN lejon t'i zhvendosësh dhe t'i bashkosh ato në një kërkesë. Për çdo vlerë në një seri kohore gjendet vlera më e afërt në tjetrën, dhe ato kthehen në një rresht:
Funksionet analitike
Në standardin SQL-2003 mund të shkruhen kështu:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
Në ClickHouse kështu nuk mund të bëhet - ai nuk mbështet standardin SQL-2003 dhe ndoshta kurrë nuk do ta bëjë këtë. Në vend të kësaj në ClickHouse është e pranuar të shkruhet kështu:
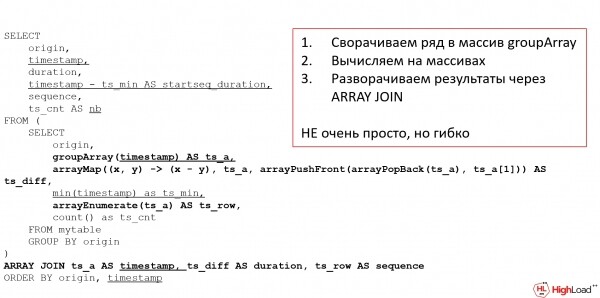
Premtova lambda – ja ato!
Kjo është një ekuivalente e një kërkese analitike në standardin SQL-2003: ajo llogarit diferencën mes dy timestamp, duration, numri rendor – gjithçka që zakonisht ne e konsiderojmë funksione analitike. Në ClickHouse ne i konsiderojmë përmes arrays: fillimisht e thellojmë të dhënat në një array, pastaj në array bëjmë gjithçka që duam, dhe më pas e kthyejmë përsëri. Kjo nuk është shumë e përshtatshme, kërkon dashuri për programimin funksional, si minimum, por është shumë fleksibël.
Funksione speciale
Për më tepër, në ClickHouse ka shumë funksione të specializuara. Për shembull, si të përcaktojmë se sa sesione kalojnë në të njëjtën kohë? Një detyrë tipike për monitorimin – të përcaktojmë ngarkesën maksimale nga një kërkesë. Në ClickHouse ka një funksion të veçantë për këtë qëllim:
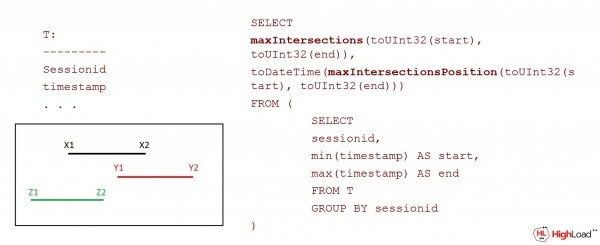
Në të vërtetë, për shumë qëllime në ClickHouse ka funksione speciale:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Ky nuk është një listë e plotë e funksioneve, gjithsej ka 500-600. Një sugjerim: të gjitha funksionet në ClickHouse janë në tabelën sistematike (jo të gjitha janë të dokumentuara, por të gjitha janë interesante):
select * from system.functions order by nameClickHouse vetë përmban shumë informacion në lidhje me veten, përfshirë log tables, query_log, logun e gjurmimit, logun e operacioneve me blloqe të të dhënave (part_log), logun e metrikave, dhe logun sistemor, i cili zakonisht shkruan në disk. Logu i metrikave është time-series në ClickHouse në të vërtetë ClickHouse: DB vetë mund të luajë rolin e saj time-series të bazave të të dhënave, duke “ngrënë” veten.
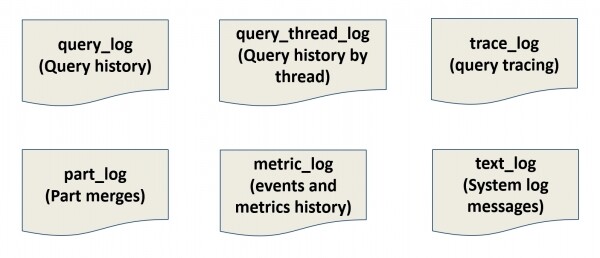
Kjo është gjithashtu një gjë unikë – pasi bëjmë punën mirë për time-series, pse nuk mund të ruajmë gjithçka që na nevojitet brenda vetes? Nuk na nevojitet Prometheus, ne ruajmë gjithçka brenda. Kemi lidhur Nëse tashmë e dini se çfarë është analiza e grupeve dhe se si ta bëni në SQL, kaloni menjëherë në seksionin e fundit. dhe monitorojmë veten. Sidoqoftë, nëse ClickHouse ra, atëherë ne nuk do ta shohim, – pse, – prandaj zakonisht nuk bëhet kështu.
Një klaster i madh ose shumë të vogla ClickHouse
Çfarë është më mirë – një klaster i madh ose shumë të vogla ClickHouse? Qasje tradicionale për DWH – është një klaster i madh, në të cilin ndahen skemat për çdo aplikacion. Shkuam te administratori i DB – na jepni një skemë, dhe na e dhanë:
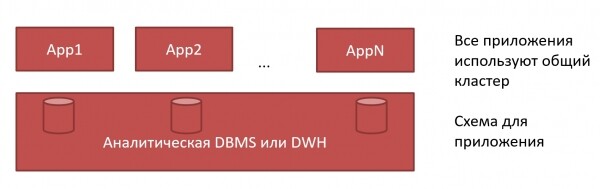
Në ClickHouse mund ta bëjmë ndryshe. Mund t'i japim çdo aplikacioni skemën e tij ClickHouse:
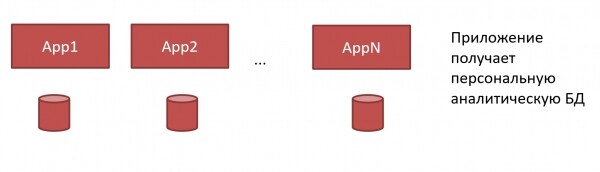
Nuk na nevojitet më një DWH monstruoz dhe adminstratorë të pakënaqur. Mund t'i japim çdo aplikacioni skemën e tij ClickHouse, dhe zhvilluesi mund ta bëjë vetë, pasi ClickHouse është shumë e thjeshtë për t'u instaluar dhe nuk kërkon administrim të komplikuar:
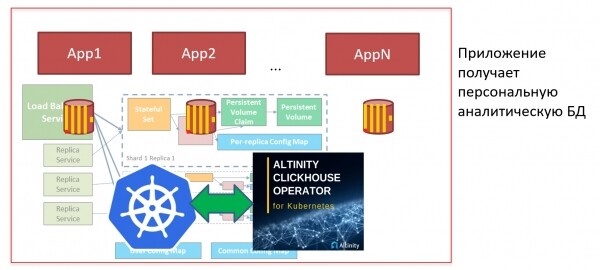
Por nëse kemi shumë ClickHouse, dhe duhet ta instalojmë shpesh, atëherë duam ta automatizojmë këtë proces. Për këtë mund të përdorim, për shembull, Kubernetes dhe clickhouse-operatorin. Në Kubernetes ClickHouse mund të instalohet "me një klik": mund të klikoj një buton, të nis një manifest dhe baza është gati. Mund të krijoj menjëherë një skemë, të filloj të ngarkoj metrikat, dhe pas 5 minutash kam një tabllo të gatshme Nëse tashmë e dini se çfarë është analiza e grupeve dhe se si ta bëni në SQL, kaloni menjëherë në seksionin e fundit.. Aq e thjeshtë është!
Çfarë në përfundim?
Pra, ClickHouse — kjo është:
- Shpejt. Kjo është e njohur për të gjithë.
- Thjesht. Pak e diskutueshme, por unë mendoj se është e vështirë në mësim, e lehtë në betejë. Nëse kupton se si ClickHouse funksionon, pastaj gjithçka është shumë e thjeshtë.
- Universale. Ai përshtatet për skenarë të ndryshëm: DWH, Kohë Njësive, Ruajtja e Logëve. Por kjo nuk është baza e të dhënave OLTP, prandaj mos u përpiqni të bëni atje inserte të shkurtra dhe lexime. Interesant
- . Ndoshta ai që punon me, ka përjetuar shumë minuta interesante në një kuptim të mirë dhe të keq. Për shembull, doli një version i ri, gjithçka ndaloi së funksionuari. Ose kur keni luftuar me një problem për dy ditë, por pas një pyetjeje në Telegram, problemi u zgjidh për dy minuta. Ose si në konferencë në prezantimin e Leosh Milovidov, screenshot-i nga ClickHouseshkaktoi ndalimin e transmetimit ClickHouse . Këto lloj gjërash ndodhin vazhdimisht dhe e bëjnë jetën tonë me HighLoad++të gjallë dhe interesante! ClickHouse Prezantimin mund ta shihni
Takimi i pritur i zhvilluesve të sistemeve me ngarkesë të lartë në .
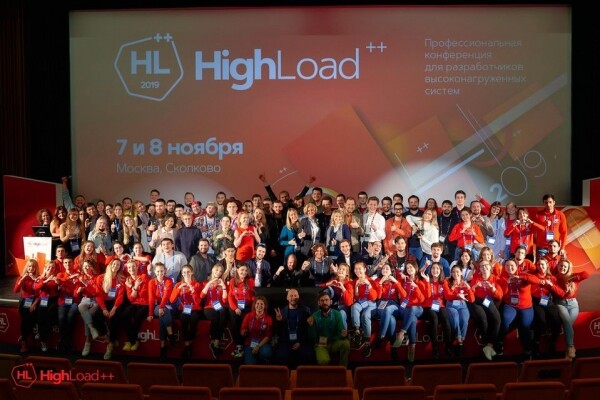
do të zhvillohet më 9 dhe 10 nëntor në Skolkovo. Më në fund do të jetë një konferencë offline (pavarësisht nga të gjitha masat e sigurisë), pasi energjia e HighLoad++ nuk mund të paketizohet në online. Për konferencën ne gjejmë dhe ju tregojmë raste të mundësive maksimale të teknologjive: HighLoad++ ka qenë, është dhe do të jetë vendi i vetëm ku mund të mësoni brenda dy ditësh se si janë ndërtuar Facebook, Yandex, VKontakte, Google dhe Amazon.
Duke mbajtur takimet tona pa ndërprerje që nga viti 2007, këtë vit do të takohemi për herë të 14-të. Gjatë kësaj kohe, konferenca është rritur 10 herë, vitin e kaluar ngjarja kryesore e industrisë mbajti 3339 pjesëmarrës, 165 folës të prezantimeve dhe takimeve, ndërsa në të njëjtën kohë u mbajtën 16 trajekta.
Vitin e kaluar kishim 20 autobusa, 5280 litra çaji dhe kafeje, 1650 litra lëng frutash dhe 10200 shishe ujë. Po ashtu 2640 kilogram ushqim, 16,000 pjatat dhe 25,000 gota. Përveç kësaj, me paratë e fituara nga riciklimi i letrës, mbollëm 100 fidanishte dushi 🙂
Biletat mund të blihen, merrni lajme rreth konferencës — , merrni lajme rreth konferencës — , dhe për të biseduar — në të gjitha rrjetet sociale: , , dhe .
Burimi: habr.com
