

Shën. përkth.: autorët e këtij artikulli janë inxhinierë nga një kompani e vogël çeke pipetail. Ata arritën të mbledhin një listë të mrekullueshme të [ndonjëherë banale, por akoma] të tillë aktuale probleme dhe keqkuptime që lidhen me përdorimin e klastereve Kubernetes.
Gjatë viteve të përdorimit të Kubernetes, na ka rastisur të punojmë me shumë klastere (si të menaxhuar ashtu edhe jo të menaxhuar - në GCP, AWS dhe Azure). Me kalimin e kohës, kemi filluar të vërejmë se disa gabime përsëriten vazhdimisht. Megjithatë, në këtë nuk ka asgjë për t'u turpëruar: ne vetë kemi bërë shumicën e tyre!
Artikulli përmbledh gabimet më të zakonshme, si dhe tregon se si t'i rregullojmë ato.
1. Burimet: kërkesat dhe kufijtë
Ky pikë padyshim meriton vëmendjen më të madhe dhe vendin e parë në listë.
Kërkesa e CPU zakonisht ose nuk është caktuar fare, ose ka një vlerë shumë të ulët (për të vendosur sa më shumë podë në çdo nod). Kështu, nodet ngarkohen. Gjatë ngarkesës së lartë, fuqitë procesorike të nodit janë plotësisht të angazhuara dhe ngarkesa e caktuar merr vetëm atë që 'kërkoi' përmes kufizimit të CPU. Kjo çon në rritjen e vonesave në aplikacion, kohëmatje dhe pasoja të tjera të pakëndshme. (Më shumë rreth kësaj lexoni në një përkthim tonin të fundit: '” — shën. përkth.)
BestEffort (ekstremisht jo e rekomanduar):
resources: {}Një kërkesë CPU ekstremisht e ulët (ekstremisht jo e rekomanduar):
   resources:
      Requests:
        cpu: "1m"
Nga ana tjetër, një kufi CPU mund të çojë në humbje të paarsyeshme të cikleve nga podët, edhe nëse procesori i nodit nuk është plotësisht i ngarkuar. Përsëri, kjo mund të çojë në rritjen e vonesave. Diskutimet vazhdojnë rreth parametrave CPU CFS quota në bërthamën Linux dhe kufizimit të CPU në varësi të kufijve të caktuar, si dhe çaktivizimit të kuotave CFS… Fatkeqësisht, kufijtë e CPU mund të shkaktojnë më shumë probleme sesa mund të zgjidhin. Më shumë rreth kësaj mund të mësoni në lidhjen më poshtë.
Teprica e alokimit (overcommiting) e memories mund të çojë në probleme më të mëdha. Arritja e kufirit të CPU sjell humbje të cikleve, ndërsa arritja e kufirit të memories sjell në 'vrasjen' e pod-it. A keni parë ndonjëherë OOMkill? Да, речь идет именно о нем.
A dëshironi të minimizoni mundësinë e këtij eventi? Mos shpërndani sasi të tepruara të memories dhe përdorni Guaranteed QoS (Quality of Service), duke vendosur kërkesat e memories të barabartë me kufizimin (si në shembullin më poshtë). Më shumë rreth kësaj lexoni në (inxhiner i lartë në Zalando).
Burstable (mundësi më të larta për të marrë OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Çfarë mund të ndihmojë potencialisht në konfigurimin e resurseve?
Me ndihmën e metrics-server mund të shikoni aktualen përdorim të resurseve CPU dhe kujtesës nga pod’ët (dhe kontejnerët brenda tyre). Gjasa është se tashmë po e përdorni atë. Thjesht ekzekutoni komandat e mëposhtme:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Megjithatë, ato tregojnë vetëm përdorimin aktual. Me to mund të merrni një ide të përafërt për rendin e madhësive, por në fund do të nevojitet historiku i ndryshimit të metrikave në kohë (për të përgjigjur në pyetje të tilla si: "Cila ishte ngarkesa maksimale e CPU?", "Cila ishte ngarkesa herët dje?") — etj. Për këtë mund të përdorni Prometheus, DataDog dhe vegla të tjera. Ato thjesht marrin metrikat nga metrics-server dhe i ruajnë, ndërsa përdoruesi mund t’i kërkojë ato dhe të ndërtojë grafikët e duhur.
mundëson të automatizohet këto procese. Ai ndjek historikun e përdorimit të procesorit dhe memories dhe rregullon kërkesat dhe kufizimet e reja në bazë të kësaj informacioni.
Përdorimi efektiv i kapacitetit të kompjuterëve është një detyrë e vështirë. Kjo është si të luash vazhdimisht Tetris. Nëse paguani shumë për kapacitetin e kompjuterëve me një përdorim të ulët mesatar (thjesht, ~10 %), rekomandojmë të jepni vëmendje produkteve bazuar në AWS Fargate ose Virtual Kubelet. Ato janë ndërtuar në modelin e faturimit serverless/pay-per-usage, që në këto kushte mund të jetë më e lirë.
2. Liveness dhe readiness probes
Sipas të dhënave standarde, kontrollimi i gjendjes liveness dhe readiness në Kubernetes nuk është i aktivizuar. Dhe ndonjëherë ata harrohen të aktivizohen...
Por si mund të inicioni një ripërshkrim të shërbimit në rast të një gabimi të pakorrigjueshëm? Dhe si e di balancuesi i ngarkesës që një pod është gati të pranojë trafik? Ose që ai është në gjendje të trajtojë më shumë trafik?
Shpesh këto prova ngatërrohen me njëra-tjetrën:
- Liveness — prova e "jetësisë", e cila ripërshtat pod'in në rast të një përfundimi të dështuar;
- Readiness — kontrollimi i gatishmërisë, në rast dështimi, çon në shkëputjen e pod-it nga shërbimi Kubernetes (këto mund të kontrollohen me
kubectl get endpoints) dhe trafikui nuk arrin tek ai deri sa kontrolli i ardhshëm të përfundojë me sukses.
Të dy këto kontrollime KRYHEN GJATË TË GJITHË CIKLIT TË JETËS SË POD’IT. Kjo është shumë e rëndësishme.
Një mit i zakonshëm është se provat e gatishmërisë fillojnë vetëm në fillim, në mënyrë që balancuesi i ngarkesës të mund të kuptojë se pod-i është gati (Gati) dhe mund të fillojë trajtimin e trafikëve. Megjithatë, kjo është vetëm një nga variantet e tyre të përdorimit.
Një tjetër — mundësia për të kuptuar se trafiku në pod është shumë i lartë dhe e ngarkon atë (ose pod-i kryen llogaritje që kërkojnë shumë burime). Në këtë rast, kontrolli i gatishmërisë ndihmon të reduktojë ngarkesën në pod dhe ta "ftohë" atë. Përfundimi me sukses i kontrollit të gatishmërisë në të ardhmen lejon të rritet përsëri ngarkesa mbi pod. Në këtë rast (nëse dështimi i kontrollit të gatishmërisë ndodh), dështimi i kontrollit të gatishmërisë do të ishte shumë kontraproduktiv. Përse të ribashkosh një pod që është në formë dhe punon me të gjitha forcat?
Prandaj, në disa raste, mungesa e plotë e kontrollimeve është më e mirë se sa aktivizimi i tyre me parametra të gabuar. Siç u tha më lart, nëse kontrolli i gatishmërisë kopjon kontrollin e gatishmërisë, atëherë je në një telashe të madhe. Një opsion mund të jetë të konfigurosh , ndërsa kontrollin e rrezikshëm të gatishmërisë.
Të dy llojet e kontrolleve nuk duhet të përfundojnë në dështim gjatë rënies së varësive të zakonshme, ndryshe kjo do të çojë në një dështim kaskadë (avullor) të të gjithë pod-ve. Me fjalë të tjera, .
3. LoadBalancer për çdo shërbim HTTP
Me shumë mundësi, keni shërbime HTTP në grumbull që dëshironi t'i kaloni në botën e jashtme.
Nëse hapni shërbimin si type: LoadBalancer, kontrollori i tij (varësisht nga ofruesi i shërbimeve) do të krijojë dhe negociojë një LoadBalancer të jashtëm (nuk është e nevojshme të funksionojë në L7, përkundrazi më shumë në L4), dhe kjo mund të ndikojë në koston (adresa e jashtme statike IPv4, burimet llogaritëse, tarifimi për sekondë) për shkak të nevojës për krijimin e një numri të madh të burimeve të tilla.
Në këtë rast, është shumë më logjike të përdorni një LoadBalancer të vetëm të jashtëm, duke hapur shërbimet si type: NodePort. Ose, madje më mirë, të vendosni diçka si nginx-ingress-controller (ose traefik), i cili do të veprojë si i vetëm. NodePort endpoint-it të lidhur me balancuesin e ngarkesës të jashtëm, dhe do të drejtojë trafikun në klaster duke përdorur ingress-burimet Kubernetes.
Shërbimet (mikro) brenda klasterit që ndërveprojnë me njëra-tjetrën mund të "komunikojnë" përmes shërbimeve të tipit ClusterIP dhe mekanizmit të integruar të zbulimit të shërbimeve përmes DNS. Vetëm mos përdorni DNS/IP-të e tyre publike, pasi kjo mund të ndikojë në vonesë dhe të rrisë kostot e shërbimeve në cloud.
4. Autoskalimi i klasterit pa marrë parasysh karakteristikat e tij
Kur shtoni ose largoni nyje nga klasteri, nuk duhet të mbështeteni në disa metrika themelore si përdorimi i CPU-së në këto nyje. Planifikimi i pod-it duhet të bëhet duke marrë parasysh shumë kufizimeve, si përputhjet e podëve/nyjeve, taints dhe tolerations, kërkesat për burime, QoS etj. Përdorimi i një autoscaler-i të jashtëm që nuk merr parasysh këto nuanca mund të çojë në probleme.
Imagjinoni se një pod duhet të planifikohet, por të gjitha kapacitetet e disponueshme të CPU-së janë kërkuar/ndara dhe pod bllokohet në gjendjen Ja disa mundësi (po supozoj se planifikuesi po funksionon normalisht):. Autoscaler-i i jashtëm sheh ngarkesën e mesatare aktuale të CPU-së (dhe jo të kërkuarën) dhe nuk inicion zgjerim (scale-out) — nuk shton një nyje tjetër. Si rezultat, ky pod nuk do të planifikohet.
Kjo për më tepër, anasjellshëm shkallëzimi (scale-in) — heqja e një nyjeje nga klasteri — gjithmonë është më e komplikuar për t'u realizuar. Imagjinoni se keni një pod stateful (me ruajtje të vazhdueshme të lidhur). Vëllimet e përhershme zakonisht i përkasin një zone të caktuar disponueshmërie dhe nuk replikohen në rajon. Pra, nëse autoscaler-i i jashtëm heq një nyje me këtë pod, planifikuesi nuk do të mund ta planifikojë këtë pod në një nyjë tjetër, pasi kjo mund të bëhet vetëm në atë zonë disponueshmërie ku gjendet ruajtja e vazhdueshme. Pod-i do të ngecë në gjendjen Ja disa mundësi (po supozoj se planifikuesi po funksionon normalisht):.
Në komunitetin Kubernetes ka një popullaritet të madh . Ai funksionon në klaster, mbështet API nga ofruesit kryesorë të shërbimeve cloud, merr parasysh të gjitha kufizimet dhe di të autoskalojë në rastet e përmendura më sipër. Gjithashtu, ai është në gjendje të kryejë scale-in duke ruajtur të gjitha kufizimet e vendosura, duke kursyer kështu para (të cilat përndryshe do të shpenzoheshin për kapacitete të padobishme).
5. Nxitimi i mundësive IAM/RBAC
Kujdesi për të përdorur përdorues IAM me sekrete të përhershme për mashinat dhe aplikacionetOrganizoni qasje të përkohshme duke përdorur role dhe llogari shërbimesh (llogaritë e shërbimit).
Ne shpesh përballemi me situata ku çelësat e aksesit (dhe sekretet) janë 'hardcode'-uar në konfigurimin e aplikacionit, si dhe me përjashtimin e rotacionit të sekreteve pavarësisht se kemi akses në Cloud IAM. Përdorni rolet IAM dhe llogaritë e shërbimeve në vend të përdoruesve, kurdoherë që është e përshtatshme.
Harrojeni kube2iam dhe kaloni menjëherë te rolet IAM për llogaritë e shërbimeve (siç përshkruhet në Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Një annotim. Nuk është aq e vështirë, apo jo?
Për më tepër, mos i jepni llogarive të shërbimeve dhe profileve të instancave privilegje admin dhe cluster-admin, nëse nuk është e nevojshme. Kjo është pak më e komplikuar të realizohet, veçanërisht në RBAC K8s, por me siguri ia vlen përpjekjet e investuara.
6. Mos u mbështetni në anti-affinity automatik për pod-et
Imagjinoni se keni tri replika të një deployment-i në një nod. Nod-i bie, dhe së bashku me të, edhe të gjitha replikat. Një situatë e pakëndshme, apo jo? Por pse të gjitha replikat ishin në një nod? A nuk duhet Kubernetes të sigurojë disponueshmëri të lartë (HA)?!
Fatkeqësisht, plani i Kubernetes nuk i respekton rregullat e ndarjes së ekzistencës (anti-affinity) për pod-et. Duhet të specifikohen qartë:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Kaq, tani pod-et do të planifikohen në nodet e ndryshme (kjo kusht kontrollohet vetëm gjatë planifikimit, por jo gjatë funksionimit të tyre — këtu vjen requiredDuringSchedulingIgnoredDuringExecution).
Këtu po flasim për podAntiAffinity në nodet e ndryshme: topologyKey: "kubernetes.io/hostname", — dhe jo në zona të ndryshme të disponueshmërisë. Për të realizuar një HA të plotë, duhet të thellohemi më shumë në këtë temë.
7. Injorimi i PodDisruptionBudget-ve
Imagjinoni se keni ngarkesë në production në një klasër Kubernetes. Periodikisht nodet dhe vetë klasri duhet të përditësohen (apo të dalin jashtë funksionimi). PodDisruptionBudget (PDB) është diçka si një marrëveshje garancie për shërbim mes administratëve të klasrit dhe përdoruesve.
PDB ndihmon në shmangien e ndërprerjeve të shërbimeve të shkaktuara nga mungesa e nodve:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
Në këtë shembull, si përdorues i grupit, i thoni administratorëve: "Hej, kam një shërbim zookeeper dhe, qoftë çfarëdo që bëni, do të doja që të paktën 2 kopje të këtij shërbimi të jenë gjithmonë të disponueshme."
Më shumë rreth kësaj mund të lexoni .
8. Përdorues të shumtë ose ambiente në një grup të përbashkët
Hapsirat e emrave të Kubernetes (namespaces) nuk ofrojnë izolim të fortë.
Është një keqkuptim i zakonshëm që nëse shpërndani ngarkesën jo-prodhuese në një hapësirë emrash dhe ngarkesën prodhuese në një tjetër, ato nuk do të ndikojnë njëra-tjetërMegjithatë, një nivel i caktuar izolimi mund të arrihet përmes kërkesave / kufijve të burimeve, vendosjes së kuotave, caktimit të priorityClass'ave. Një "izolim fizik" në planin e të dhënave sigurohet nga affinitetet, tolerimet, taints (ose nodeselectors), megjithatë një ndarje e tillë është mjaft e komplikuar për t'u realizuar.
Ata që duhet të kombinojnë të dyja llojet e ngarkesave në një grup do të duhet të pajtohen me kompleksitetin. Nëse nuk ka nevojë të tillë dhe ju lejon buxheti të krijoni një grup tjetër (thjesht në një cloud publik), atëherë më mirë është kështu. Kjo do të lejojë arritjen e një niveli shumë më të lartë të izolimit.
9. politika e trafikut të jashtëm: Grupi
Shpesh vërejmë se i gjithë trafiku brenda grupit vjen përmes një shërbimi si NodePort, për të cilin politikat e përcaktuara janë externalTrafficPolicy: Cluster. Kjo do të thotë se NodePort hapet në çdo nod në grup, dhe mund të përdoren ndonjëra prej tyre për të ndërlidhur me shërbimin e nevojshëm (grupi i pod'ave).
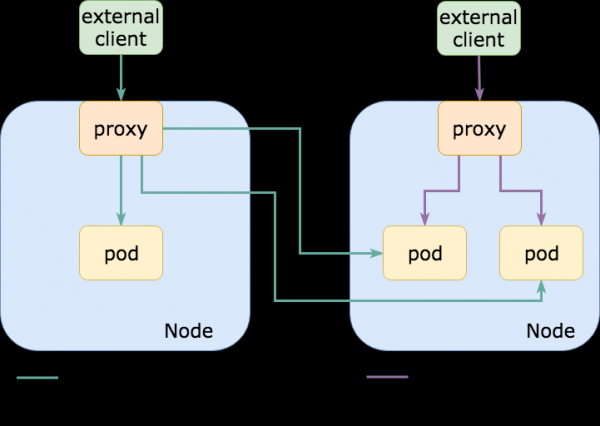
Megjithatë, pod'ët realë që lidhen me shërbimin e sipërpërmendur të NodePort zakonisht gjenden vetëm në një nëngrup të këtyre node'ave.Me fjalë të tjera, nëse lidhëm me një nod që nuk ka pod'in e nevojshëm, ai do të redirektojë trafikun në një nod tjetër, duke shtuar një segment kalimi (hop) dhe duke rritur vonesën (nëse node'ët janë në zona të ndryshme të disponueshmërisë / qendrave të të dhënave, vonesa mund të jetë mjaft e lartë; për më tepër, shpenzimet për trafikun e jashtëm do të rriten).
Nga ana tjetër, nëse për një shërbim të caktuar Kubernetes është caktuar politika externalTrafficPolicy: Local, atëherë NodePort hapet vetëm në ato node ku në të vërtetë janë të aktivizuar pod'ët e nevojshëm. Kur përdoret një balancues i jashtëm ngarkese, që kontrollon shëndetin (healthchecking) e endpoint'ëve (siç e bën AWS ELB), ai do të dërgojë trafikun vetëm në node't e nevojshme., që do të ndikojë pozitivisht mbi vonesat, nevojat për përpunim, faturat për egress (dhe kjo është e arsyeshme gjithashtu).
Ka shumë të ngjarë që tashmë po përdorni diçka si traefik ose nginx-ingress-controller si një pikë NodePort fundore (ose LoadBalancer, i cili gjithashtu përdor NodePort) për të drejtuar trafikun HTTP ingress, dhe aktivizimi i kësaj mund të ulë ndjeshëm vonesat gjatë kërkesave të tilla.
Në mund të mësoni më shumë rreth externalTrafficPolicy, avantazheve dhe disavantazheve të saj.
10. Mos u lidhni me klasterët dhe mos qenkeni abuzivë ndaj kontrollit të planit
Dikur, serverët zakonisht quheshin me emra të veçantë: , HAL9000 dhe Colossus… Sot, në vend të tyre, i kanë zëvendësuar identifikatorët e gjeneruar rastësisht. Megjithatë, zakoni është ruajtur, dhe tani emrat e veçantë u jepen klasterëve.
Një histori tipike (e bazuar në ngjarje reale): gjithçka filloi me një provë koncepti, kështu që klasteri kishte emrin e nderuar testimi… Kaluan vite, dhe ai ende përdoret në production, dhe të gjithë kanë frikë ta prekin atë.
Nuk ka asgjë qesharake në faktin se klasterët shndërrohen në kafshë të shtëpisë, prandaj rekomandojmë të hiqni këta gjëra nga përdorimi herë pas here, duke praktikuar gjithashtu rikuperimin nga dështimet (në këtë do t'ju ndihmojë — shën. përkth.)). Për më tepër, nuk do të dëmtonte as të merreshit me layerin e menaxhimit (kontrolli i planit). Frika për ta prekur atë — nuk është një shenjë shumë e mirë. Etcd vdes? O njerëz, jeni përfshirë vërtet!
Nga ana tjetër, nuk është e nevojshme të abuzoni me manipulimet me të. Me kalimin e kohës kontrolli i planit mund të bëhet i ngadalshëm.Me probabilitet të lartë, kjo lidhet me numrin e madh të objekteve të krijuara pa rotacion (një situatë e zakonshme kur përdoret Helm me cilësime të paracaktuara, për shkak të të cilave gjendja e tij në configmap/siglak nuk përditësohet — si rezultat, në layerin e menaxhimit grumbullohen mijëra objekte) ose me redaktimin e vazhdueshëm të objekteve kube-api (për përmasimin automatik, për CI/CD, për monitorimin, skedarët e ngjarjeve, kontrollorët, etj.).
Për më tepër, ne rekomandojmë të kontrolloni marrëveshjet SLA/SLO me ofruesin e Kubernetes të menaxhuar dhe të vini re garancitë. Ofertuesi mund të garantojë disponueshmërinë e layerit të menaxhimit (ose të nënkomponentëve të tij), por jo vonesën p99 të kërkesave që i dërgoni. Me fjalë të tjera, mund të vendosni kubectl get nodes, dhe përgjigjja do të merret vetëm pas 10 minutash, dhe kjo nuk do të përbënte shkelje të kushteve të marrëveshjes së shërbimit.
11. Bonusi: përdorimi i etiketës latest
Kjo tashmë është një klasik. Kohët e fundit, ne nuk hasim shpesh në teknika të tilla, pasi shumë, të mësuar nga përvoja e hidhur, ndaluan së përdoruri etiketën :latest dhe filluan të konsolidojnë (pin) versionet. Urime!
ECR ; rekomandojmë të njiheni me këtë veçori të shkëlqyer.
CV
Mos pritni që gjithçka të funksionojë me një magji: Kubernetes nuk është një panace për gjithçka. Një aplikacion i keq (dhe ndoshta do të bëhet edhe më keq). Papërgjegjshmëria do të çojë në kompleksitet të tepruar, ecuri të ngadaltë dhe stresuese të shtresës menaxhuese. Për më tepër, rrezikoni të mbeteni pa një strategji rikuperimi emergjente. Mos e prisni që Kubernetes "nga kutia" do të marrë përsipër garantimin e izolimit dhe disponueshmërisë së lartë. Merrni pak kohë për ta bërë aplikacionin tuaj me të vërtetë cloud native.
Të njohin përvojat e dështimeve të ndryshme të ekipeve mund të gjenden në nga Henning Jacobs.
Ata që dëshirojnë të shtojnë listën e gabimeve të përmendura në këtë artikull, mund të na kontaktojnë në Twitter (, ).
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «» (përmbledhje dhe video e prezantimit);
- «».
Burimi: habr.com
