

Ky është një mit, mjaft i përhapur në fushën e pajisjeve serverike. Në praktikë, megjithatë, zgjidhjet hiper-konverguese (kur gjithçka është në një) janë të nevojshme për shumë arsye. Historikisht, arkitekturën e parë e zhvilluan Amazon dhe Google për shërbimet e tyre. Në atë kohë, ideja ishte të krijohej një fermë kompjuterike nga nyje të njëjta, ku secila kishte disqe të saj. Të gjitha këto u bashkuan me ndihmën e një programi sistemor (hipervizori) dhe u ndanë në makina virtuale. Detyra kryesore — minimumi i përpjekjeve për mirëmbajtjen e një nyje dhe minimumi i problemeve gjatë shkallëzimit: thjesht blenë edhe një mijë ose dy të tilla servera dhe i lidhën përkrah. Në praktikë, kjo ndodh rrallë, dhe më shpesh flitet për numra më të vogla nyjesh dhe një arkitekturë pak ndryshe.
Por përfitimi mbetet i njëjtë — thjeshtësia e jashtëzakonshme e shkallëzimit dhe menaxhimit. Mangësia — detyrat e ndryshme konsumojnë burime në mënyrë të ndryshme, dhe diku do të ketë shumë disqe lokale, diku pak RAM dhe kështu me radhë, që do të thotë se me tipe të ndryshme detyrash do të bie përdorimi i burimeve.
Doli që paguani 10-15% më shumë për komoditetin e konfigurimit. Kjo shkaktoi mitin nga titulli. Ne kërkuam gjatë për mënyrën se si do të aplikohej teknologjia optimalisht, dhe e gjetëm. Çështja është se Cisco nuk kishte sistemet e saj të ruajtjes, por ata donin të përfshinin tregun e plotë të serverëve. Dhe ata krijuan Cisco Hyperflex — një zgjidhje me ruajtje lokale në nyje.
Dhe nga kjo papritmas doli një zgjidhje shumë e mirë për qendrat e dhënave rezervë (Disaster Recovery). Pse dhe si — tani do t'ju tregoj. Dhe do të tregoj testet e klasterit.
Aty ku nevojitet
Hiper-konvergjenca përfshin:
- Kalon disqet në nyje kompjuterike.
- Integrim i plotë i sistemit të ruajtjes së të dhënave me sistemin e virtualizimit.
- Kalon/integrimi me sistemin rrjetë.
Ky lidhje mundëson realizimin e shumë veçorive të sistemit të ruajtjes në nivelin e virtualizimit dhe gjithçka nga një dritare menaxhimi.
Në kompaninë tonë, projektet për projektimin e qendrave të të dhënave rezervë janë shumë të kërkuara, dhe shpesh zgjidhet pikërisht zgjidhja hiper-konverge për shkak të numrit të madh të opsioneve për replikim (deri në metrokast) nga kutia.
Në rastin e Qendrave të të Dhënave rezervë, zakonisht bëhet fjalë për një objekt të largët në një lokacion të ndryshëm në qytet apo mbase edhe në një qytet krejtësisht tjetër. Ai lejon rikthimin e sistemeve kritike në rast dështimi të pjesshëm ose të plotë të Qendrës kryesore të të Dhënave. Të dhënat nga prodhuesi repikohen vazhdimisht aty, dhe kjo replikim mund të ndodhi në nivel aplikacioni ose në nivel të pajisjes bllokuese (SHTD).
Prandaj tani do të flas për strukturën e sistemit dhe provat, dhe pastaj do të shqyrtoj disa skenarë të aplikimit real me të dhëna mbi kursimet.
Testet
Ekzemplari ynë përbëhet nga katër servera, çdo njëri prej të cilëve ka 10 disqe SSD me kapacitet 960 GB. Ka një disk të dedikuar për të ndihmuar operacionet e shkruarjes dhe ruajtjen e makinës virtuale shërbyese. Zgjidhja vetë është versioni i katërt. Versioni i parë ishte qartësisht i papërfunduara (sipas komenteve), versioni i dytë gjithashtu ishte disi i papërfunduar, versioni i tretë tashmë është mjaft i qëndrueshëm, dhe ky mund të quhet një version që ka përfunduar beta-testimin për publikun. Gjatë testimit nuk pashë probleme, gjithçka funkcjonon siç duhet.
Ndryshimet në v4Shumë bugs janë rregulluar.
Fillimisht, platforma mund të punojë vetëm me hipervizorin VMware ESXi dhe mbështeste një numër të vogël nodesh. Po ashtu, procesi i instalimit nuk përfundonte gjithmonë me sukses, shpesh duhej të rillevoj disa hapa, kishte probleme me përditësimin nga versionet e vjetra, dhe të dhënat në GUI nuk shfaqeshin gjithmonë saktë (edhe tani nuk jam i kënaqur me shfaqjen e grafikëve të performancës), ndonjëherë shfaqeshin probleme në kësulimin me virtualizimin.
Tani të gjitha problemet fillestare janë rregulluar, HyperFlex mbështet si ESXi ashtu edhe Hyper-V, plus kështu është e mundur:
- Krijimi i një klasteri të shpërndarë.
- Krijimi i një klasteri për zyrat pa përdorur Fabric Interconnect, nga dy në katër node (blejmë vetëm serverat).
- Mundësia për të punuar me SHTD të jashtme.
- Mbështetja për kontejnerët dhe Kubernetes.
- Krijimi i zonave të disponueshmërisë.
- Integrimi me VMware SRM, nëse funksionaliteti i integruar nuk është i kënaqshëm.
Arkitektura nuk e dallon shumë nga zgjidhjet e konkurentëve kryesorë, nuk kanë krijuar një biçikletë. Kjo funksionon në platformën e virtualizimit VMware ose Hyper-V. Ka një vendosje harduerike në serverët e zhvilluar vetë nga Cisco UCS. Ka ata që e urrejnë platformën për vështirësinë e saj relativisht të konfigurimit fillestar, shumë butona, një sistem të ndërlikuar të shablloneve dhe varësive, por ka edhe ata që e kanë përjetuar zen-in, e kanë kuptuar idenë dhe nuk duan më të punojnë me servera të tjerë.
Ne do të shqyrtojmë zgjidhjen për VMware, pasi kjo zgjidhje fillimisht u krijua për të dhe ka më shumë funksionalitet, ndërsa Hyper-V u përmirësua gjatë rrugës për të mos ngecur pas konkurentëve dhe për t'iu përmbajtur pritshmërive të tregut.
Ekziston një klaster i serverëve të ngarkuar me disqe. Ka disqe për ruajtjen e të dhënave (SSD ose HDD — sipas shijes dhe nevojave tuaja), si dhe një SSD-disk për keqshfrytëzimin. Kur të dhënat shkruhen në datastore, ato ruhen në shtresën e keqshfrytëzimit (SSD-disk i dedikuar dhe RAM e VM-së shërbyese). Paralelisht, blloku i të dhënave dërgohet në nodet e klasterit (numri i nodave varet nga faktori i replikimit të klasterit). Pas konfirmimit nga të gjitha nodet për shkrimin e suksesshëm, konfirmimi i shkrimit dërgohet në hipervizor dhe më pas — në VM. Të dhënat e shkruara deduplikohen, kompresohen dhe ruhen në disqet e ruajtjes në sfond. Në këtë mënyrë, një bllok i madh gjithmonë shkruhet në disqet e ruajtjes dhe rendësisht, çka ul ngarkesën në disqet e ruajtjes.
Deduplikimi dhe kompresimi janë aktivizuar gjithmonë, dhe nuk mund të çaktivizohen. Leximi i të dhënave ndodh direkt nga disqet e ruajtjes ose nga RAM-i i keqshfrytëzimit. Nëse përdoret një konfigurim hibrid, atëherë leximi gjithashtu keqshfrytëzohet në SSD-disk.
Të dhënat nuk lidhën me vendndodhjen aktuale të makinës virtuale dhe shpërndahen në mënyrë të barabartë mes nodave. Ky qasje lejon që të gjitha disqet dhe interfecet rrjetësore të ngarkohet njësoj. Dalin në pah një mangësi e dukshme: nuk mund të minimizohet maksimalisht vonesa e leximit, pasi nuk ka garanci për disponueshmërinë e të dhënave lokal. Por unë besoj se kjo është një sakrifice e vogël krahasuar me përfitimet që merrni. Për më tepër, vonesat në rrjet kanë arritur në nivele të tilla sa që praktikisht nuk ndikojnë në rezultatin përfundimtar.
Të gjitha logjika e punës së sistemit të depozitimit të diskut është përgjegjësi e një VM shërbimi të veçantë, Cisco HyperFlex Data Platform controller, e cila krijohet në secilën nodë ruajtjeje. Në konfigurimin tonë, VM shërbimi kishte të ndara tetë vCPU dhe 72 GB RAM, që nuk është pak. Kujtoj se vetë hosti ka 28 bërtha fizike dhe 512 GB RAM.
VM shërbimi ka qasje në diskët fizikë direkt përmes kalimit të SAS-kontrollerit në VM. Komunikimi me hipervizorin ndodh përmes një moduli të veçantë IOVisor, i cili kap operacionet e hyrjes dhe daljes, dhe me anë të një agjenti që lejon dërgimin e komandave në API të hipervizorit. Agjenti është përgjegjës për punën me snapshot-at dhe klonët e HyperFlex.
Në hipervizor, burimet diskore montohen si një NFS- ose SMB-share (varet nga tipi i hipervizorit, e guessoni se cili është cili). Dhe poshtë kapakut, kjo është një sistem i shpërndarë dosjesh që lejon shtimin e tiparëve të plotë të sistemeve të ruajtjes: ndarje e hollë e volumeve, kompresim dhe deduplication, snapshot-e me teknologjinë Redirect-on-Write, replikim sinkron/asinkron.
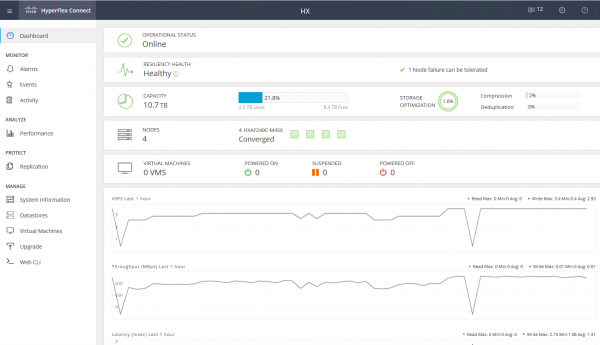
VM shërbimi ofron qasje në ndërfaqen WEB të menaxhimit të sistemit HyperFlex. Ka integrim me vCenter, dhe pjesa më e madhe e detyrave përditshme mund të kryhen nga aty, por datastoret, për shembull, janë më të lehta për t’i krijuar nga një ndërfaqe e veçantë webi, nëse keni kaluar tashmë në ndërfaqen HTML5 të shpejtë, ose duke përdorur një klient të plotë Flash me integrim të plotë. Në webin e shërbimit mund të shihni performancën dhe statusin e detajuar të sistemit.
Ekziston edhe një lloj tjetër nodi në klaster — nodet llogaritëse. Këto mund të jenë serverë rack ose blade pa disqe të instaluara. Në këta serverë mund të ekzekutoni VM, të dhënat e të cilave ruhen në serverët me disqe. Në aspektin e aksesit në të dhëna, nuk ka dallim mes typave të nodave, sepse arkitektura parashikon abstraksionin nga vendndodhja fizike e të dhënave. Marrëdhënia maksimale ndërmjet nodave llogaritëse dhe nodave të depozitimit është 2:1.
Përdorimi i nodave llogaritëse rrit fleksibilitetin në shkallëzimin e burimeve të klasterit: nuk është e nevojshme të blejmë nodet me disqe, nëse kemi nevojë vetëm për CPU/RAM. Për më tepër, mund të shtojmë një kosh blade dhe të arrijmë kursim në vendosjen e serverëve në raft.
Si rezultat, kemi një platformë hiper-konvergjente me këto tipare:
- Deri deri 64 nod në klasë (deri në 32 nod për ruajtje).
- Numri minimal i nodave në klasë është tri (dy për klasën Edge).
- Mekanizmi i tepërzëshme të dhënash: pasqyrimi me faktor replikimi 2 dhe 3.
- Metro-klasë.
- Replikimi asinkron i VM në një tjetër klasë HyperFlex.
- Orkestrimi i kalimit të VM në Qendrën e të Dhënave të largëta.
- Snapshotet native me teknologji Redirect-on-Write.
- Derisa 1 PB hapësirë e dobishme me faktor replikimi 3 dhe pa marrë parasysh deduplication. Faktori i replikimit 2 nuk merret parasysh sepse nuk është opsion për një shitje serioze.
Një tjetër avantazh i madh — thjeshtësia e menaxhimit dhe vendosjes. Të gjitha kompleksitetet e konfigurimit të serverëve UCS merr përsipër një VM të specializuar, të përgatitur nga inxhinierët Cisco.
Konfigurimi i tendës prova:
- 2 x Cisco UCS Fabric Interconnect 6248UP si komponentë të menaxhimit të klasës dhe rrjetit (48 porte, që punojnë në modalitetin Ethernet 10G/FC 16G).
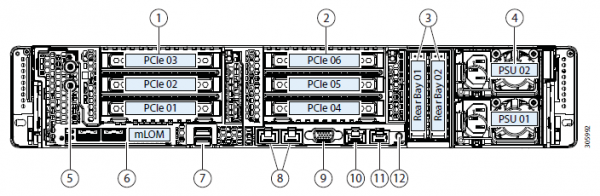
- Katër serverë Cisco UCS HXAF240 M4.
Karakteristikat e serverëve:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/rangu i dyfishtë/x4/1.2v
Network global log /dev/log local0 log /dev/log local1 notice chroot /var/lib/haproxy stats timeout 30s user haproxy group haproxy daemondefaults log global mode http option httplog option dontlognull timeout connect 5000 timeout client 50000 timeout server 50000frontend http_front bind *:80 stats uri /haproxy?stats default_backend http_backbackend http_back balance roundrobin server server_name1 private_ip1:80 check server server_name2 private_ip2:80 check
UCSC-MLOM-CSC-02 (VIC 1227). 2 porte 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Kaluesi i Pasthuar
Disket e Ruajtjes
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Më shumë mundësi konfigurimiPërveç harduerit të përzgjedhur, për momentin janë të disponueshme opsione të tjera:
- HXAF240c M5.
- Një ose dy CPU duke filluar nga Intel Silver 4110 deri në Intel Platinum I8260Y. E disponueshme gjenerata e dytë.
- 24 slot memorjeje, modules nga 16 GB RDIMM 2600 deri në 128 GB LRDIMM 2933.
- Nga 6 në 23 disqe për të dhëna, një disk kešimi, një disk sistemik dhe një disk për butimin.
Disku i Kapacitetit
- HX-SD960G61X-EV 960GB 2.5 Inch Enterprise Value 6G SATA SSD (1X qëndresë) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X qëndresë) SAS 3.8 TB.
- Disku i Kešimit
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Performancë Ekstreme & qëndresë.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Perf. NVMe SSD (3X qëndresë) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Perf. 12G SAS SSD (10X qëndresë) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Perf. 12G SAS SED SSD (10X qëndresë) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise performance 12G SAS SSD (3X qëndresë).
Disku i Sistemit / Regjistrit
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (Kërkon upgrade).
Disku i Butimit
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Koneksioni në rrjet përmes porteve Ethernet 40G, 25G ose 10G.
Si FI mund të jenë HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Testi vetë
Për testimin e sistemit të disqes përdora HCIBench 2.2.1. Kjo është një utilitar falas, që lejon automatizimin e krijimit të ngarkesës nga disa makina virtuale. Ngarkesa vetë gjenerohet nga fio i zakonshëm.
Klastri ynë përbëhet nga katër nod, faktor replikimi 3, të gjitha disqet Flash.
Për testim kam krijuar katër datastore dhe tetë makina virtuale. Për testet e shkrimit supozohet skenari kur disku mbështetës nuk mbushet.
Rezultatet e testeve janë si më poshtë:
100 % Lexim 100 % Rastësor
0 % Lexim 100 % Rastësor
Blloku/ thellësia e radhës
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Me arna të theksuara vlerat, pas të cilave nuk ka rritje të performancës, herë-herë edhe vërehet degradimi. Kjo është e lidhur me faktin që jemi duke u përballur me performancën e rrjetit/kontrollerëve/disqeve.
- Leximi sekuencial 4432 MB/s.
- Shkrimi sekuencial 804 MB/s.
- Në rastin e dështimit të një kontrolluesi (dështimi i makinës virtuale ose hostit), rënia e performancës është dyfish.
- Në rastin e dështimit të diskut të ruajtjes, rënia është një e tretë. Rindërtimi i disku merr 5% të burimeve të çdo kontrolluesi.
Në bllok të vogël ne ndeshim në performancën e kontrolluesit (makina virtuale), CPU e tij është ngarkuar në 100%, kur rritemi bllokun ne ndeshim në kapacitetin e porteve. 10 Gbit/s nuk është e mjaftueshme për të zbuluar potencialin e sistemeve AllFlash. Fatkeqësisht, parametrat e demo-stendit të ofruar nuk lejojnë verifikimin e funksionit në 40 Gbit/s.
Sipërfaqja ime nga testet dhe studimi i arkitekturës, nëpërmjet algoritmit që shpërndan të dhënat midis të gjitha hostëve, ne arrijmë një performancë të shkallëzueshme dhe të parashikueshme, por kjo është gjithashtu një kufizim kur lexojmë, pasi nga disqet lokale do të mund të nxirrnim më shumë, këtu mund të shpëtojmë një rrjet më të fuqishëm, për shembull, janë në dispozicion FI në 40 Gbit/s.
Gjithashtu, një disk për ruajtje dhe dedupikim mund të jetë një kufizim, në të vërtetë në këtë stend ne mund të shkruajmë në katër disqe SSD. Do të ishte mirë të kishim mundësinë për të rritur numrin e disqeve mbështetëse dhe të shihnim ndryshimin.
Përdorimi i vërtetë
Për organizimin e një Qendres të Dhënies së Shërbimit të Mbështetjes mund të përdoren dy qasje (nuk po shqyrtojmë vendosjen e backup-ëve në një lokacion të largët):
- Active-Passive. Të gjitha aplikacionet janë të vendosura në Qendrën Kryesore të Dateve. Replikimi është në mënyrë sinkrone ose asinkrone. Në rast se Qendra Kryesore e Dateve dështon, ne duhet të aktivizojmë rezervën. Kjo mund të bëhet manualisht/nga skriptet/aplikacionet e orkestrimit. Këtu do të arrijmë RPO, të krahasueshëm me frekuencën e replikimit, dhe RTO varet nga reagimi dhe aftësitë e administratorit dhe cilësisë së planit të kalimit.
- Active-Active. Në këtë rast ekziston vetëm replikimi sinkron, disponueshmëria e Qendrave të Dateve përcaktohet nga kuorumi/arbitri, i vendosur rreptësisht në një vend të tretë. RPO = 0, dhe RTO mund të arrijë 0 (nëse aplikacioni lejon) ose të jetë sa koha për të trajtuar dështimin e një nodi në klasterin e virtualizimit. Në nivelin e virtualizimit krijohet një klaster i zgjeruar (Metro), që kërkon një storage Active-Active.
Zakonisht shohim tek klientët një arhitekturë të realizuar tashmë me një storage klasik në Qendrën Kryesore të Dateve, prandaj projektimin e një tjetër për replikim. Siç e përmenda, Cisco HyperFlex ofron replikim asinkron dhe krijimin e një klasteri të zgjeruar të virtualizimit. Kjo do të thotë që nuk na nevojitet një storage dedikuar niveli Midrange dhe lart me funksione të shtrenjta replikimi dhe akses Active-Active në të dhëna në dy storage.
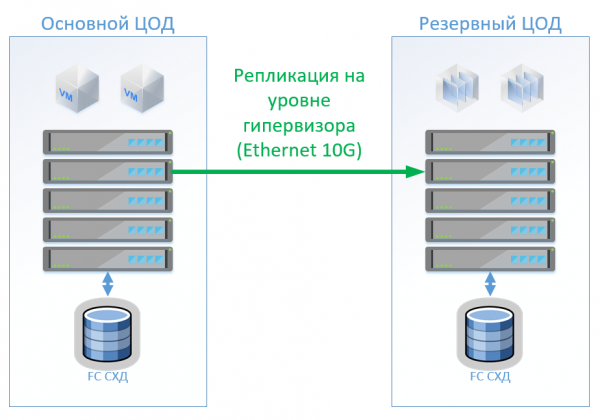
Scenari 1: Ne kemi Qendrat Kryesore dhe Rezervë të Dateve, platformën e virtualizimit në VMware vSphere. Të gjitha sistemet prodhues janë në Qendrën Kryesore të Dateve, dhe replikimi i makinerive virtuale kryhet në nivelin e hipervizorit, kjo do të lejojë që VM-të të mos mbahen të aktivizuara në Qendrën Rezervë të Dateve. Baza të dhënash dhe aplikacione të veçanta replikohen me ndihmën e mjeteve të ndërtuara dhe mbajmë VM-të të aktivizuara. Në rast dështimi të Qendrës Kryesore të Dateve, ne aktivizojmë sistemet në Qendrën Rezervë. Ne besojmë se kemi rreth 100 makineri virtuale. Ndërsa Qendra Kryesore e Dateve është aktive, në Qendrën Rezervë të Dateve mund të aktivizojmë mjedise testimi dhe sisteme tjera, të cilat mund të mbyllen në rastin e kalimit të Qendrës Kryesore të Dateve. Gjithashtu është një opsion kur kemi përdorim të replikimit të dyanshëm. Sipas pajisjeve, asgjë nuk do të ndryshojë.
Në rastin e arkitekturës klasike, ne do të vendosim një SHT me hibrid në çdo QTF me qasje përmes FibreChannel, tiering, deduplication dhe kompresion (por jo online), 8 serverë për çdo vend, me 2 switch-e FibreChannel dhe Ethernet 10G. Për replikimin dhe menaxhimin e kalimit në arkitekturën klasike mund të përdorim mjetet VMware (Replication + SRM) ose mjete të palëve të treta, të cilat do të jenë pak më të lira dhe ndonjëherë më të lehta për t'u përdorur.
Në figurë është paraqitur skema.
Në rastin e përdorimit të Cisco HyperFlex, rezulton kjo arkitekturë:
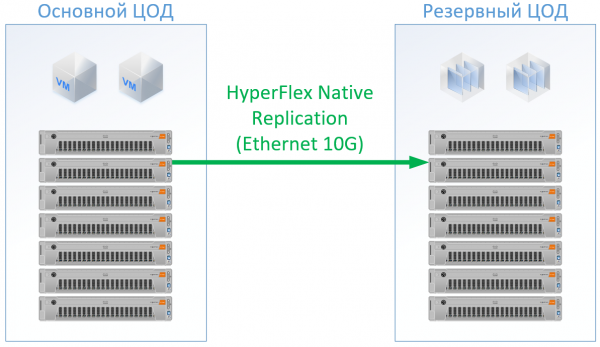
Për HyperFlex kam përdorur serverë me burime të mëdha CPU/RAM, pasi një pjesë e burimeve do të shkojë në VM-në e kontrolluesit HyperFlex, për CPU-në dhe memorien kam kaluar pak më shumë se ç'kishim planifikuar në konfigurimin HyperFlex, për të mos qenë shumë në favor të Cisco dhe për të garantuar burime për VM-të e tjera. Kështu, mund të heqim dorë nga switch-at FibreChannel dhe nuk do të na nevojiten porte Ethernet për çdo server, trafiku lokal do të kalojë brenda FI.
Si përfundim, rezultoi konfigurimi i mëposhtëm për çdo QTF:
Serverët
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
SCHED
SHT hibrid me FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x switch Ethernet 10G 12 porte
—
SAN
2 x switch FC 32/16Gb 24 porte
2 x Cisco UCS FI 6332
Licencat
VMware Ent Plus
Replikim dhe/o orkestrim kalimi VM
VMware Ent Plus
Për Hyperflex nuk kam planifikuar licencat e programeve për replikimin, pasi kjo është e disponueshme nga kuti.
Për arkitekturën klasike kam marrë një furnizues i cili ka treguar veten si një prodhues i kualitetit dhe të lirë. Për të dyja variantet kam aplikuar zbritjen standarde për zgjidhjen specifike, dhe në fund kam marrë çmimet reale.
Zgjidhja për Cisco HyperFlex doli 13% më e lirë.
Skema 2: krijimi i dy QTF-ve aktive. Në këtë skenar projektojmë një grumbull të shtrirë në VMware.
Arkitektura klasike përbëhet nga serverë virtualizimi, SAN (protokolli FC) dhe dy SHT që dinë të lexojnë dhe shkruajnë në atë, e shtrirë mes tyre. Në çdo SHT vendosim kapacitet të dobishëm për lok.
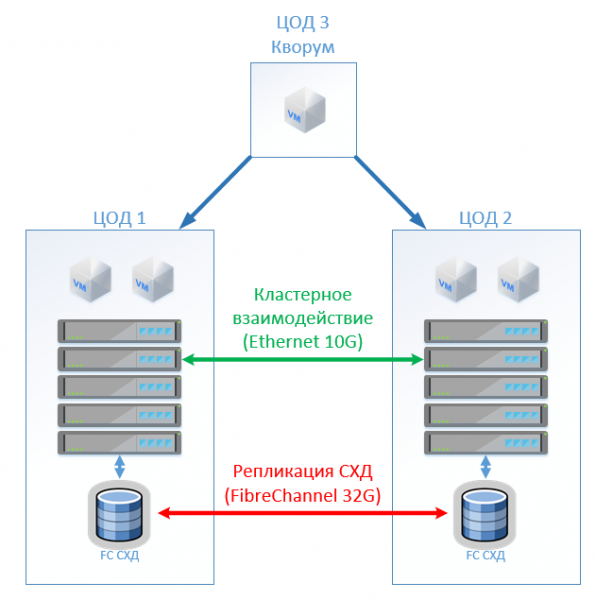
Me HyperFlex thjeshtë krijojmë Stretch Cluster me të njëjtin numër nodash në të dyja vendet. Në këtë rast përdoret faktori i replikimit 2+2.
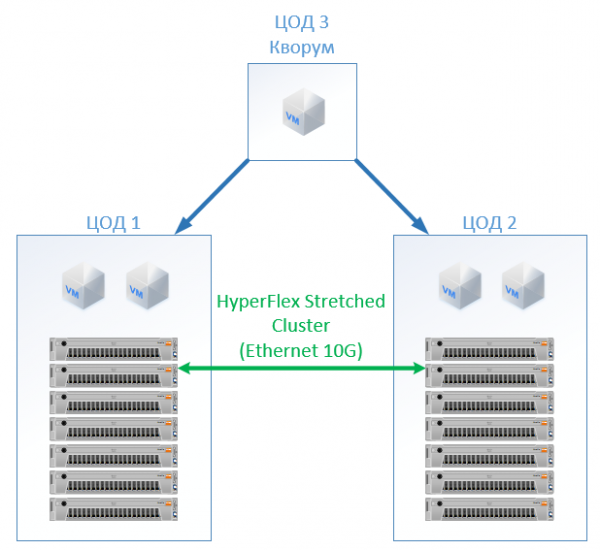
Rezultoi konfigurimi i mëposhtëm:
Arkitektura klasike
HyperFlex
Serverët
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
SCHED
2 x SHT AllFlash (150 TB SSD)
—
LAN
4 x switch Ethernet 10G 24 porte
—
SAN
4 x switch FC 32/16Gb 24 porte
4 x Cisco UCS FI 6332
Licencat
VMware Ent Plus
VMware Ent Plus
Në të gjitha llogaritë, nuk kam përfshirë infrastrukturën rrjetësore, shpenzimet për Qendrën e Të Dhënave etj.: ato do të jenë të njëjta për arkitekturën klasike dhe për zgjidhjen në HyperFlex.
Në koston, HyperFlex doli 5% më e shtrenjtë. Këtu duhet të theksohet se për burimet CPU/RAM kam pasur një disbalancë për Cisco, pasi në konfigurim plotesova kanalet e kontrollorëve të memories në mënyrë të barabartë. Kostoja është pak më e lartë, por jo në masë të madhe, që tregon qartë se hiper-konvergjenca nuk është domosdoshmërisht "lojë për të pasurit", por mund të konkurrojë me qasjen standarde për ndërtimin e Qendrave të Të Dhënave. Gjithashtu, kjo mund të jetë e interesuar për ata që tashmë kanë serverë Cisco UCS dhe infrastrukturën përkatëse për ta.
Nga pikat pozitive do të kemi mungesë të shpenzimeve për administrimin e SAN dhe SHTT, kompresim dhe deduplication online, një pikë të vetme hyrjeje për mbështetje (virtualizimi, serverë, gjithashtu - SHTT), kursim hapësire (por jo në të gjitha skenarët), dhe thjeshtim në funksionim.
Sa i përket mbështetjes, këtu e merrni atë nga një shitës - Cisco. Nëse gjykojmë nga përvoja ime me serverët Cisco UCS, më pëlqen, nuk kam pasur nevojë të hap HyperFlex, gjithçka ka funksionuar siç duhet. Inxhinierët përgjigjen shpejt dhe mund të zgjidhin jo vetëm probleme rutinë, por edhe raste të komplikuara. Ndërsa herë pas here i drejtohem atyre me pyetje si: "A mund ta bëj këtë, ta lidhem këtë?" ose "Kam konfiguruar diçka dhe nuk funksionon. Më ndihmoni!" - ata do të gjejnë durim për të gjetur udhëzimin e duhur dhe për t'ju treguar veprimet e duhura, nuk do të përgjigjen: "Ne zgjidhim vetëm probleme të harduerit".
Linket
- Emaili im është StGeneralov@croc.ru
Burimi: habr.com
