

Në prag të nisjes së kursit përgatitëm për ju përkthimin e një materiali tjetër të dobishëm.
Kodimi i Huffman-it është një algoritëm për kompresimin e të dhënave, i cili formulon idenë kryesore të kompresimit të skedarëve. Në këtë artikull do të flasim për kodimin me gjatësi fikse dhe variabël, kodet që dekodohen unikisht, rregullat e prefiksit dhe ndërtimin e pemës së Huffman-it.
E dimë se çdo simbol ruhet si një seri prej 0 dhe 1 dhe zë 8 bit. Kjo quhet kodim me gjatësi fikse, pasi çdo simbol përdor të njëjtin numër fikse bit për ruajtje.
Supozoni se kemi një tekst. Si mund të zvogëlojmë sasinë e hapësirës së kërkuar për ruajtjen e një simboli?
Ideja themelore është kodimi me gjatësi variabël. Mund të përdorim faktin se disa simbole në tekst shfaqen më shpesh se të tjerat (), për të zhvilluar një algoritëm që do të përfaqësojë të njëjtën seri simboresh me një numër më të vogël bitësh. Kur kodojmë me gjatësi variabël, ne i japim simboleve një numër të ndryshëm bitësh në varësi të frekuencës së shfaqjes së tyre në tekstin e caktuar. Në fund, disa simbole mund të zënë vetëm 1 bit, ndërsa të tjera 2, 3 apo më shumë. Problemi me kodimin me gjatësi variabël është vetëm në dekodimin e radhës.
Si, duke ditur sekuencën e bitëve, mund ta dekodojmë atë në mënyrë të qartë?
Le të marrim stringun «aabacdab». Ajo përmban 8 simbole, dhe për ta koduar me gjatësi fikse do të nevojiten 64 bit. Vërejtim se frekuenca e simboleve «a», «b», «c» dhe «d» është 4, 2, 1, 1 përkatësisht. Le të përpiqemi ta përfaqësojmë «aabacdab» me një numër më të vogël bitësh, duke përdorur faktin se «a» shfaqet më shpesh se «b», ndërsa «b» shfaqet më shpesh se «c» dhe «d». Fillimisht do ta kodojmë «a» me një bit, duke e cilësuar me 0, «b» do t'i japim një kod dy bitësh 11, dhe me tre bitë 100 dhe 011 do ta kodojmë «c» dhe «d».
Në përfundim do të kemi:
a
0
b
11
c
100
d
011
Pra, stringun «aabacdab» do ta kodojmë si 00110100011011 (0|0|11|0|100|011|0|11), duke përdorur kodet e paraqitura më lart. Megjithatë, problemi kryesor do të jetë në dekodimin. Kur të përpiqemi të dekodojmë stringun 00110100011011, do të përfundojmë me një rezultat të paqartë, pasi mund të përfaqësohet si:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
etj.
Për të shmangur këtë paqartësi, ne duhet të garantojmë se kodimi ynë plotëson konceptin e rregullit prefiks, i cili, nga ana e tij, nënkupton se kodet mund të dekodohen vetëm në një mënyrë unike. Rregulli prefiks garanton që asnjë kod nuk do të jetë prefiks i një tjetri. Me kod nënkuptojmë bitët që përdoren për të paraqitur një simbol të caktuar. Në shembullin e mësipërm 0 – është një prefiks 011, gjë që shkel rregullin prefiks. Pra, nëse kodet tona e plotësojnë rregullin prefiks, atëherë dekodimi mund të kryhet në mënyrë unike (dhe anasjelltas).
Le të rishikojmë shembullin e mësipërm. Këtë herë ne do të caktojmë për simbolet «a», «b», «c» dhe «d» kodet që plotësojnë rregullin prefiks.
a
0
b
10
c
110
d
111
Duke përdorur këtë kodim, vargu «aabacdab» do të kodifikohet si 00100100011010 (0|0|10|0|100|011|0|10). Ja 00100100011010 ne tashmë do të mund të dekodojmë në mënyrë unike dhe të kthehemi në vargun tonë origjinal «aabacdab».
Kodimi Huffman
Tani që e kuptuam kodimin me gjatësi të ndryshme dhe rregullin prefiks, le të flasim për kodimin Huffman.
Metoda bazohet në krijimin e pemëve binare. Në të, një nyje mund të jetë ose fundore, ose të brendshme. Fillimisht, të gjitha nyjet konsiderohen si gishta (fundore), të cilat paraqesin vetë simbolin dhe peshën e tij (pra, frekuencën e shfaqjes). Nyjet e brendshme përmbajnë peshën e simbolit dhe referojnë dy nyje pasardhëse. Sipas marrëveshjes së zakonshme, biti «0» përfaqëson ndjekjen e degës së majtë, ndërsa «1» – në të djathtë. Në një pemë të plotë N gishtash dhe N-1 nyje të brendshme. Rekomandohet që, gjatë ndërtimit të pemës Huffman, të përjashtohen simbolët e papërdorur për të marrë kodet me gjatësi optimale.
Ne do të përdorim një radhë me prioritete për të ndërtuar pemën Huffman, ku nyjes me frekuencën më të ulët do të i jepet prioriteti më i lartë. Më poshtë janë hapat e ndërtimit:
- Krijoni një nyje-gisht për çdo simbol dhe shtoni ato në radhën me prioritete.
- Ndërsa në radhë ka më shumë se një gisht bëni si në vijim:
- Hiqni dy nyje me prioritetin më të lartë (me frekuencën më të ulët) nga rada;
- Krijoni një nyje të re të brendshme, ku këto dy nyje do të jenë pasardhëse, dhe frekuenca e shfaqjes do të jetë e barabartë me shumën e frekuencave të këtyre dy nyjeve.
- Shtoni nyjen e re në radhen e prioriteteve.
- Nyja e vetme që mbetet do të jetë rrënja, dhe kështu do të përfundojë ndërtimi i pemës.
Supozoni se kemi një tekst që përbëhet vetëm nga shenja «a», «b», «c», «d» dhe «e», dhe frekuencat e shfaqjes janë 15, 7, 6, 6 dhe 5 përkatësisht. Më poshtë janë ilustruar hapat e algoritmit.
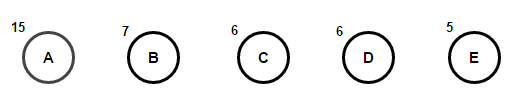
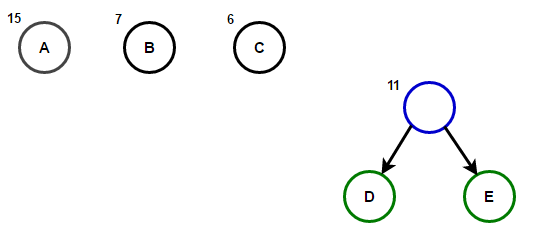
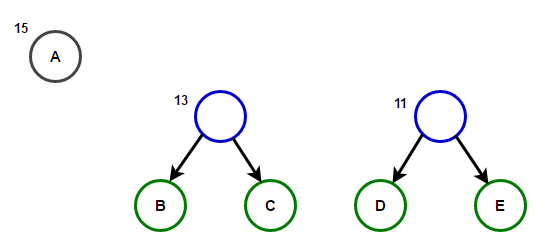
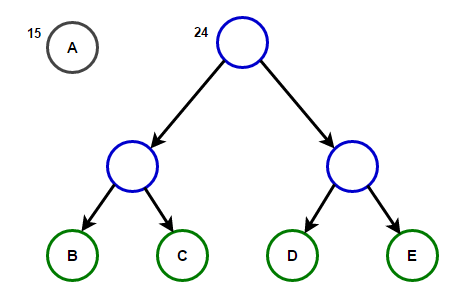
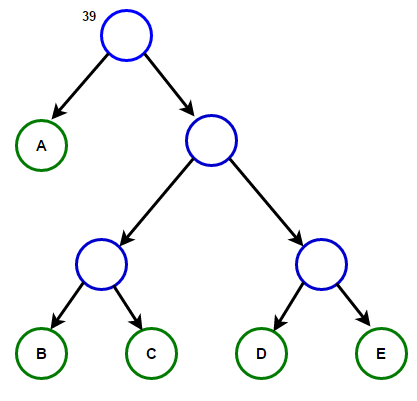
Rruga nga rrënja në çdo nod përfundimtar do të mbajë kodin optimal të prefiksit (i njohur gjithashtu si kodi i Huffmanit), që i përket simbolit të lidhur me këtë nod përfundimtar.
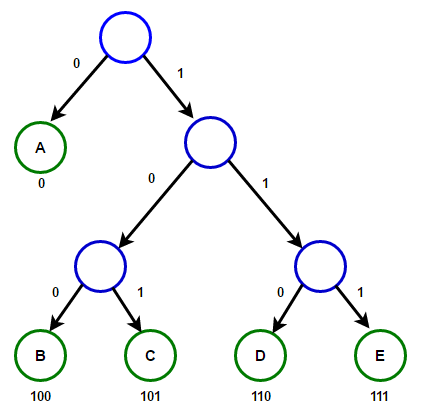
Pema e Huffmanit
Më poshtë do të gjeni implementimin e algoritmit të kompresimit të Huffmanit në gjuhët C++ dhe Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Një nod i pemës
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Shkruaj nëpër pemën Huffman dhe ruaj kodet Huffman
// në një hartë.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// u gjet një nod gjethe
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Shkruaj nëpër pemën Huffman dhe dekodo vargun e koduar
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// u gjet një nod gjethe
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Ndërton pemën Huffman dhe huffmanCode dhe dekodon tekstin e dhënë
public static void buildHuffmanTree(String text)
{
// numëron frekuencën e shfaqjes së çdo karakteri
// dhe e ruan atë në një hartë
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Krijo një radhë prioritare për të ruajtur nodet aktive të pemës Huffman
// Vini re se objektet me prioritet më të lartë kanë frekuencë më të ulët
PriorityQueue pq = new PriorityQueue((l, r) -> l.freq - r.freq);
// Krijoni një nod gjethe për çdo karakter dhe shtoni atë
// në radhën prioritare.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// bëje derisa të jetë më shumë se një nod në radhë
while (pq.size() != 1)
{
// Hiqni dy nodet me prioritet më të lartë
// (frekuencë më të ulët) nga radha
Node left = pq.poll();
Node right = pq.poll();
// Krijoni një nod të ri të brendshëm me këto dy nodet si fëmijë
// dhe me frekuencë të barabartë me shumën e frekuencave të dy nodëve
// Shtoni nodin e ri në radhën prioritare.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root ruan treguesin në rrënjën e Pemës Huffman
Node root = pq.peek();
// Shkruaj nëpër pemën Huffman dhe ruaj kodet Huffman në një hartë
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// printo kodet Huffman
System.out.println("Kodin e Huffman është : n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("nString origjinal ishte : n" + text);
// printo vargun e koduar
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("nVargu i koduar është : n" + sb);
// Shkruaj përsëri nëpër Pemën Huffman dhe këtë herë
// dekodo vargun e koduar
int index = -1;
System.out.println("nStringu i dekoduar është: n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Kodimi i Huffman është një algoritëm kompresimi të dhënash.";
buildHuffmanTree(text);
}
}Vërejtje: Memoria e përdorur nga vargu hyrës është 47 * 8 = 376 bit, ndërsa vargu i koduar zë vetëm 194 bit, pra të dhënat kompresohen rreth 48%. Në programin në C++ më sipër ne përdorim klasën string për të ruajtur vargun e koduar, për ta bërë programin të lexueshëm.
Duke qenë se struktura efikase e të dhënave për radhë prioritare kërkon O(log(N)) kohë për insertim, dhe në një pemë binar të plotë me N gjethe ndodhin 2N-1 nodi, dhe pema e Huffman-it është një pemë binar e plotë, algoritmi punon për O(Nlog(N)) kohë, ku N është numri i simboleve.
Burimet:
Burimi: habr.com
