

Nëse administroni një infrastrukturë virtuale të bazuar në VMware vSphere (ose ndonjë stek tjetër teknologjik), ndoshta shpesh dëgjoni nga përdoruesit ankesat: "Makinë virtuale po punon ngadalë!". Në këtë cikël artikujsh do të shqyrtoj metrikat e performancës dhe do të tregoj se çfarë dhe pse "ngadalëson" dhe si të bëni që të mos "ngadalësohet".
Do të shqyrtoj aspekte të mëposhtme të performancës së makinave virtuale:
- CPU,
- RAM,
- DISK,
- Rrjeti.
Të filloj me CPU.
Për analizën e performancës, do na duhen:
- VCenter Performance Counters – numërues të performancës, të cilat grafiket e të cilëve mund të shihni përmes vSphere Client. Informacioni mbi këta numërues është i disponueshëm në çdo version të klientit (klienti "i rëndë" në C#, klienti web në Flex dhe klienti web në HTML5). Në këto artikuj do të përdorim captura ekranesh nga klienti C#, thjesht sepse duken më mirë në miniaturë:)
- ESXTOP – një utilitar që niset nga komanda e linjës ESXi. Me ndihmën e tij, mund të merrni vlera të numëruesve të performancës në kohë reale ose t'i eksportoni këto vlera për një periudhë të caktuar në një skedar .csv për analizë të mëtejshme. Më pas do të flas për këtë mjet më në detaje dhe do të jap disa lidhje të dobishme në dokumentacionin dhe artikujt lidhur me temën.
Pak teori
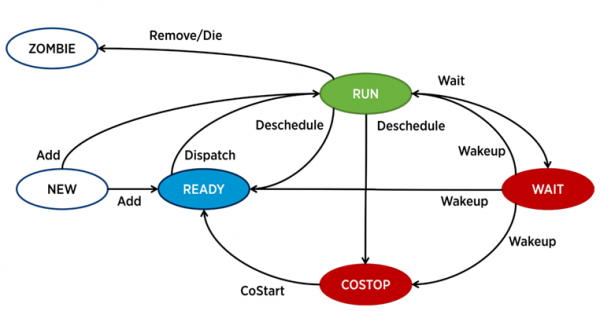
Në ESXi, çdo vCPU (në terminologjinë e VMware) përfaqësohet nga një proces i veçantë – world. Ka gjithashtu procese shërbimi, por nga këndvështrimi i analizës së performancës së VM-ve, ato janë më pak interesante.
Një proces në ESXi mund të ndodhet në njërën nga katër gjendjet:
- Ekzekuto – procesi bën ndonjë punë të dobishme.
- Pritja – procesi nuk bën asnjë punë (idle) ose po pret për input/output.
- Costop – një gjendje që ndodh në makinat virtuale me shumë bërthama. Ajo ndodh kur planifikuesi i CPU-së së hipervizorit (ESXi CPU Scheduler) nuk arrin të planifikojë ekzekutimin e përbashkët në bërthamat fizike të serverit të të gjitha bërthamave aktive të makinës virtuale. Në botën fizike, të gjitha bërthamat e procesorit punojnë paralelisht, sistemi operativ mysafir brenda VM-së pret një sjellje të ngjashme, prandaj hipervizori është i detyruar të ngadalësojë bërthamat e VM-së që kanë mundësi të përfundojnë ciklin më shpejt. Në versionet moderne të ESXi, planifikuesi i CPU-së përdor një mekanizëm të quajtur co-scheduling të relaksuar: hipervizori konsideron diferencën mes bërthamës më "të shpejtë" dhe bërthamës më "të ngadalshme" të makinës virtuale (skew). Nëse ky diferencë kalon një prag të caktuar, bërthama "e shpejtë" kalon në gjendjen costop. Nëse bërthamat e VM-së kalojnë shumë kohë në këtë gjendje, kjo mund të shkaktojë probleme me performancën.
- Gati – procesi kalon në këtë gjendje kur hipervizori nuk ka mundësi të alokojë burime për ekzekutimin e tij. Vlerat e larta të gatishmërisë (ready) mund të shkaktojnë probleme me performancën e VM-së.
Numrat kryesorë të performancës së CPU-së së makinës virtuale
Përdorimi i CPU-së, %. Tregon përqindjen e përdorimit të CPU-së për një periudhë të caktuar.
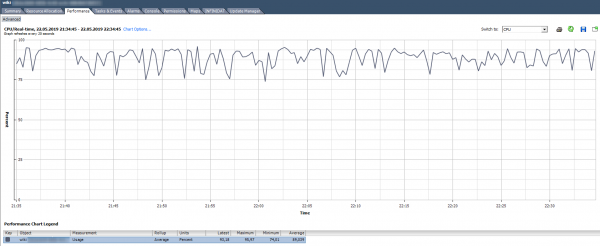
Si të analizohet? Nëse VM-ja përdor stabilisht CPU-në në 90% ose ka pika deri në 100%, atëherë kemi probleme. Problemet mund të shfaqen jo vetëm në "punën e ngadalshme" të aplikacionit brenda VM-së, por edhe në krijimin e paqëndrueshmërive të VM-së në rrjet. Nëse sistema i monitorimit tregon se VM-ja herë pas here “ndalon,” kushtoni vëmendje pikave në grafikun e Përdorimit të CPU-së.
Ekziston një Alarm standard që tregon ngarkesën e CPU-së së makinës virtuale:
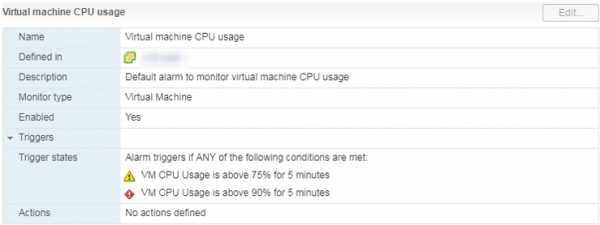
Çfarë të bëjmë? Nëse VM-ja vazhdimisht kalon përdorimin e CPU-së, atëherë mund të mendoni për rritjen e numrit të vCPU (për fat të keq, kjo nuk ndihmon gjithmonë) ose për transferimin e VM-së në një server me procesorë më të fuqishëm.
Përdorimi i CPU-së në Mhz
Në grafikët në vCenter, Përdorimi në % mund të shikohet vetëm për të gjithë makinën virtuale, nuk ka grafikë për bërthama të veçanta (ndërsa në Esxtop, vlerat në % për bërthamat ekzistojnë). Për çdo bërthamë mund të shikohet Përdorimi në MHz.
Si të analizohet? Ndonjëherë, aplikacioni nuk është optimizuar për arkitekturën shumë-nëndeshkuese: përdor 100% vetëm një bërthamë, ndërsa bërthamat e tjera qëndrojnë pa ngarkesë. Për shembull, me cilësimet e paracaktuara të backup-it, MS SQL fillon procesin vetëm në një bërthamë. Si rezultat, kopjimi i rezervave ngadalësohet jo për shkak të shpejtësisë së ngadalte të disqeve (për këtë fillimisht ankohej përdoruesi), por për shkak të kapacitetit të pamjaftueshëm të procesorit. Problemi u zgjidh duke ndryshuar parametrat: kopjimi i rezervave filloi të ekzekutohet paralelisht në disa skedarë (përkatësisht, në disa procese).
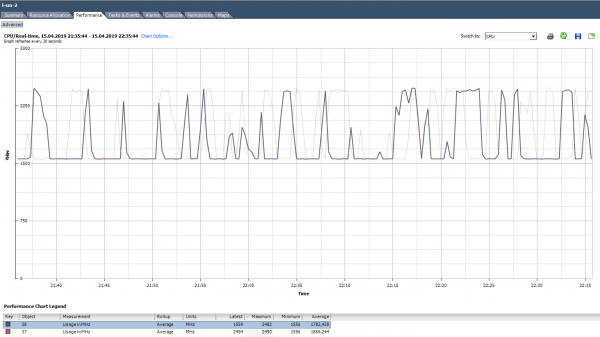
Shembulli i ngarkesës së pabarabartë të bërthamave.
Gjithashtu ndodh një situatë (siç duket në grafik) kur bërthamat janë të ngarkuara në mënyrë të pabarabartë dhe disa prej tyre kanë maja deri në 100%. Ashtu siç ndodh kur ngarkohet vetëm një bërthamë, alarmi për Përdorimin e CPU-së nuk do të aktivizohet (ai është për të gjithë VM-në), por do të ketë probleme me performance-n.
Çfarë të bëjmë? Nëse software-i në makinë virtuale ngarkon bërthamat në mënyrë të pabarabartë (përdor vetëm një bërthamë ose disa bërthama), nuk ka kuptim të rritet numri i tyre. Në këtë rast, është më mirë të zhvendosni VM-në në një server me procesorë më të fuqishëm.
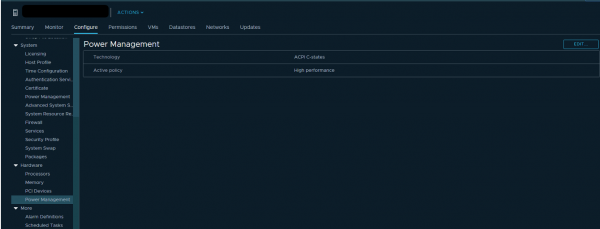
Gjithashtu mund të provoni të kontrolloni cilësimet e konsumit të energjisë në BIOS të serverit. Shumë administratorë aktivizojnë në BIOS modin High Performance dhe kështu çaktivizojnë teknologjitë e kursimit të energjisë C-states dhe P-states. Në procesorët moderne Intel përdoret teknologjia Turbo Boost, e cila rrit frekuencën e bërthamave individuale të procesorit për shkak të bërthamave të tjera. Por ajo funksionon vetëm kur teknologjitë e kursimit të energjisë janë të aktivizuara. Nëse i çaktivizojmë, procesori nuk mund të zvogëlojë konsumimin e energjisë të bërthamave që nuk janë të ngarkuara.
VMware rekomandon të mos çaktivizoni teknologjitë e kursimit të energjisë në servera, por të zgjidhni mënyra që maksimizojnë dorëzimin e kontrollit të konsumit të energjisë hiper-vizorit. Në të njëjtën kohë, në cilësimet e konsumit të energjisë të hiper-vizorit duhet të zgjidhni High Performance.
Nëse në infrastrukturën tuaj VM të veçanta (ose bërthama të VM) kërkojnë një frekuencë të rritur CPU, një konfigurim i saktë i konsumit të energjisë mund të përmirësojë ndjeshëm performancën e tyre.
CPU Ready (Gati)
Nëse bërthama e VM (vCPU) është në gjendje Gatshëm, ajo nuk po kryen punë të dobishme. Kjo gjendje ndodh kur hipervizori nuk gjen një bërthamë fizike të lirë për të caktuar procesin e vCPU të makinerisë virtuale.
Si të analizohet? Në përgjithësi, nëse bërthamat e makinerive virtuale janë në gjendje Gatshëm më shumë se 10% të kohës, atëherë do të vëreni probleme me performancën. Thjesht, më shumë se 10% të kohës VM pret disponueshmërinë e resurseve fizike.
Në vCenter mund të shihni 2 numërues që lidhen me Gatshmërinë e CPU:
- Gatshmëria,
- Gatshëm.
Vlerat e të dy numëruesve mund të shihen si për të gjithë VM-në, ashtu edhe për bërthamat e veçanta.
Gatshmëria tregon vlerën menjëherë në përqindje, por vetëm në kohë reale (të dhënat për orën e fundit, intervali i matjeve 20 sekonda). Ky numërues është më mirë të përdoret vetëm për të gjetur probleme "në gjurmët e nxehta".
Vlerat e numëruesit Gatshëm mund të shihen gjithashtu në një perspektivë historike. Kjo është e dobishme për të identifikuar tendencat dhe për një analizë më të thellë të problemit. Për shembull, nëse një makinë virtuale fillon të ketë probleme me performancën në një kohë të caktuar, mund të përputhet intervalet e rritjes së vlerës së Gatshëm CPU me ngarkesën totale në serverin ku funksionon kjo VM dhe të merren masa për të ulur ngarkesën (nëse DRS nuk ka arritur).
Gatshëm, ndryshe nga Gatshmëria, tregohet jo në përqindje, por në milisekonda. Ky është një numërues i llojit Summation, që do të thotë se tregon sa kohë gjatë periudhës së matjes bërthama e VM ishte në gjendje Gatshëm. Mund ta konvertosh këtë vlerë në përqindje përmes një formule të thjeshtë:
(vlera e sh summation të Gatshëm \/ (intervali i përditësimit të grafikëve në sekonda * 1000)) * 100 = Gatshëm %
Për shembull, për VM-në në grafikën më poshtë, vlera maksimale e Gatshëm për të gjithë makinerinë virtuale do të rezultojë si vijon:

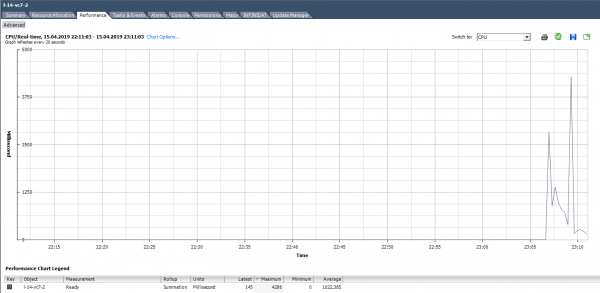
Kur llogaritni vlerën e Gatshëm në përqindje, duhen marrë parasysh dy çështje:
- Vlera Gatshëm për të gjithë VM-në – është shuma e Gatshëm për bërthamat.
- Intervali i matjes. Për kohë reale – është 20 sekonda, ndërsa, për shembull, në grafikët ditorë – është 300 sekonda.
Kur jeni duke kryer trajtim të problemeve, këto momente të thjeshta mund të lehtësisht të injorohen dhe të harxhohet kohë e çmuar për ndihmën në problemet që nuk ekzistojnë.
Ne do taë parashikojmë Ready bazuar në të dhënat nga grafiku më poshtë. (324474/(20*1000))*100 = 1622% për të gjithë VM. Nëse shohim sipas bërthamave, duket më e menaxhueshme: 1622/64 = 25% për bërthamë. Në këtë rast, zbulimi i një mashtrimi është mjaft i thjeshtë: vlera Ready është e paarsyeshme. Por nëse diskutohet rreth 10–20% për të gjithë VM me disa bërthama, atëherë vlera për secilën bërthamë mund të jetë brenda normales.
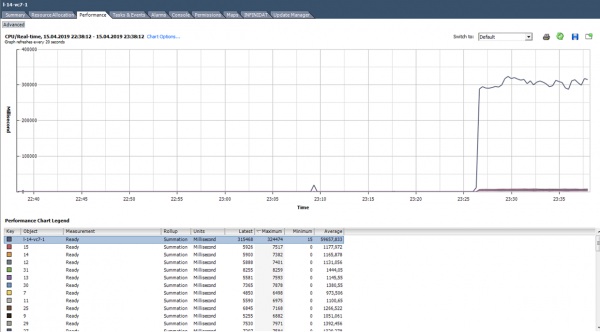
Çfarë të bëjmë? Një vlerë e lartë Ready tregon se serverit i mungojnë burimet e CPU për funksionimin normal të ndërtimeve virtuale. Në një situatë të tillë, mundësia e vetme është të zvogëloni mbivendosjen e procesorëve (vCPU:pCPU). Është e qartë se kjo mund të arrihet duke ulur parametrat e ndërtimeve ekzistuese ose duke migruar disa ndërtime në serverë të tjerë.
Co-stop
Si të analizohet? Ky numërues gjithashtu ka llojin Summation dhe përkthehet në përqindje në mënyrë të ngjashme me Ready:
(CPU co-stop summation value / (intervali standard i përditësimit të grafikëve në sekonda * 1000)) * 100 = CPU co-stop %
Këtu gjithashtu duhet të merret parasysh numri i bërthamave në VM dhe intervali i matjes.
Në gjendjen co-stop, bërthama nuk bën punë të dobishme. Me përzgjedhjen e duhur të madhësisë së VM dhe ngarkesë normale në server, numëruesi co-stop duhet të jetë afër zeros.
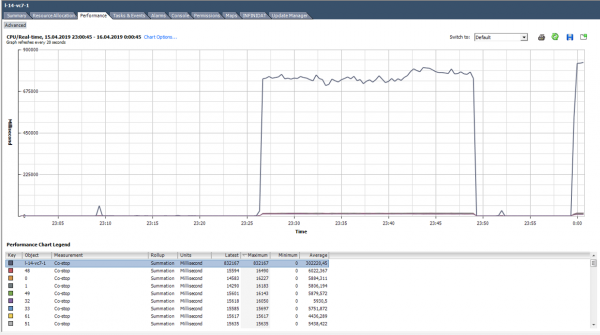
Në këtë rast, ngarkesa është dukshëm anormale :)
Çfarë të bëjmë? Nëse në një hipervizor punojnë disa VM me numra të mëdha bërthamash dhe ka mbivendosje mbi CPU, atëherë numëruesi co-stop mund të rritet, çka do të çojë në probleme me performancën e këtyre VM.
Po ashtu, co-stop do të rritet nëse për bërthamat aktive të një VM përdoren thredds në një bërthamë fizike të serverit me hyper-threading të aktivizuar. Kjo situatë mund të ndodhë, për shembull, nëse VM ka më shumë bërthama se ato fizike që ka serveri, ku ajo funksionon, ose nëse për VM është aktivizuar konfigurimi 'preferHT'. Rreth kësaj konfigurate mund të lexoni .
Për të shmangur problemet me performancën e VM për shkak të një co-stop të lartë, zgjidhni madhësinë e VM sipas rekomandimeve të prodhuesit të softuerit që funksionon mbi këtë VM, dhe sipas kapaciteteve të serverit fizik ku funksionon VM.
Mos shtoni bërthama për rezervë; kjo mund të shkaktojë probleme me performancën jo vetëm të vetë VM, por edhe të fqinjëve të saj në server.
Metrika të tjera të dobishme të CPU
Ekzekuto – sa kohë (ms) gjatë periudhës së matjes vCPU ka qenë në gjendjen RUN, që do të thotë se vërtet ka bërë punë të dobishme.
Përgjithësisht – sa sa është koha (ms) gjatë periudhës së matjes që vCPU ka qenë në gjendje të papërdorur. Vlerat e larta të Idle nuk janë një problem; thjesht vCPU nuk kishte «gjë për të bërë».
Pritja – sa kohë (ms) gjatë periudhës së matjes që vCPU ka qenë në gjendje Wait. Duke qenë se në këtë numër perfshihen IDLE, vlerat e larta të Wait gjithashtu nuk tregojnë për një problem. Nëse, megjithatë, IDLE është i ulët me një Wait të lartë, atëherë VM ka pritur përfundimin e operacioneve të hyrjes/daljes, e cila mund të tregojë për një problem me performancën e hard diskut ose ndonjë pajisje virtuale të VM.
Maksimal i limituar – sa kohë (ms) gjatë periudhës së matjes që vCPU ka qenë në gjendje Ready për shkak të një limiti të vendosur për burimet. Nëse performanca është pa shpjegim e ulët, është e dobishme të kontrolloni vlerën e këtij numri dhe limitin e CPU në cilësimet e VM. VM mund të ketë limite të vendosura, të cilat ju nuk i dini. Për shembull, kjo ndodh kur VM është klonuar nga një model, në të cilin ishte vendosur një limit për CPU.
Pritja e Swap – sa kohë gjatë periudhës së matjes që vCPU ka pritur për operacionet me VMkernel Swap. Nëse vlerat e këtij numri janë mbi zero, atëherë VM ka për siguri probleme me performancën. Më shumë mbi SWAP do të flasim në artikullin për numrat e memorie.
ESXTOP
Nëse numrat e performancës në vCenter janë të mirë për analizimin e të dhënave historike, analiza e menjëhershme e problemeve është më mirë të bëhet në ESXTOP. Këtu të gjitha vlerat janë të paraqitura në një formë të gatshme (nuk ka nevojë të përkthehet asgjë) dhe periudha minimale e matjes është 2 sekonda.
Ekrani i ESXTOP për CPU aktivizohet me çelësin «c» dhe duket si më poshtë:

Për lehtësinë, mund të lini vetëm proceset e makinave virtuale duke shtypur Shift-V.
Për të parë metrikat për çdo bërthamë të VM, shtypni «e» dhe futni GID e VM-së që ju intereson (30919 në screenshotin më poshtë):
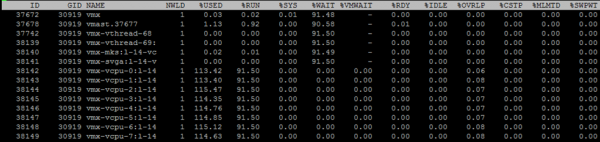
Së shpejti do ta kaloj mbi kolonat që janë paraqitur sipas parazgjedhjes. Kolona shtesë mund të shtohen duke shtypur «f».
NWLD (Numri i Botëve) – numri i proceseve në grup. Për të zgjeruar grupin dhe parë metrikat për çdo proces (për shembull, për çdo bërthamë të VM me shumë bërthama), shtypni “e”. Nëse në grup ka më shumë se një proces, vlerat e metrikave për grupin janë të barabarta me shumën e metrikave për proceset e veçanta.
%E PËRDORUR – sa cikle CPU e serverit përdor procesi ose grupi i proceseve.
%E EKZISTUES – sa sa ka në kohë të periudhës, procesi ka qenë në gjendje RUN, dmth ka kryer punë të dobishme. Ndryshon nga %USED në atë që nuk merr parasysh hyper-threading, frekuencën e shkallëzimit dhe kohën e kaluar në detyra sistematike (%SYS).
%SYS – koha e kaluar në detyra sistematike, për shembull: përpunimi i ndërprerjeve, hyrja/dalja, puna e rrjetit, etj. Vlera mund të jetë e lartë nëse në VM ka hyrje/dalje të madhe.
%OVRLP – sa kohë një bërthamë fizike, në të cilën po ekzekutohej procesi VM, kaloi në detyra të proceseve të tjera.
Këto metrika lidhen me njëra-tjetrën në mënyrën e mëposhtme:
%USED = %RUN + %SYS — %OVRLP.
Normalisht, metrika %USED është më informuese.
%WAIT – sa kohë gjatë periudhës procesi ka qenë në gjendje Wait. Pëfshin IDLE.
%IDLE – sa kohë gjatë periudhës procesi ka qenë në gjendje IDLE.
%SWPWT – sa kohë gjatë periudhës vCPU ka pritur operacionin me VMkernel Swap.
%VMWAIT – sa kohë gjatë periudhës vCPU ka qenë në gjendje pritjeje për një ngjarje (zakonisht hyrje/dalja). Nuk ka një numër të ngjashëm në vCenter. Vlerat e larta tregojnë për probleme me hyrje/dalje në VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Nëse VM nuk përdor VMkernel Swap, është e arsyeshme të shikoni %VMWAIT kur analizoni problemet me performancën, sepse kjo metrikë nuk merr parasysh kohën kur VM nuk ka bërë asgjë (%IDLE).
%RDY – sa kohë gjatë periudhës procesi ka qenë në gjendje Ready.
%CSTP – sa kohë gjatë periudhës procesi ka qenë në gjendje costop.
%MLMTD – sa kohë gjatë periudhës vCPU ka qenë në gjendje Ready për shkak të kufizimit të vendosur mbi burimet.
%WAIT + %RDY + %CSTP + %RUN = 100% – bërthama e VM është gjithmonë në një nga këto katër gjendje.
CPU në hipervizor
Në vCenter ka gjithashtu numërues të performancës CPU për hipervizorin, por ato nuk paraqesin ndonjë gjë interesante – është thjesht shuma e numëruesve për të gjitha VM në server.
Më lehtë është të shikoni gjendjen e CPU në server në skedën Përmbledhje:
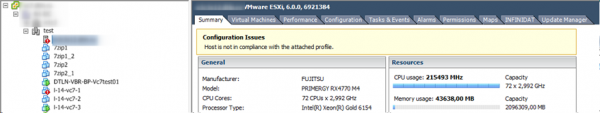
Për serverin, ashtu si për makinën virtuale, ka një Alarm standard:
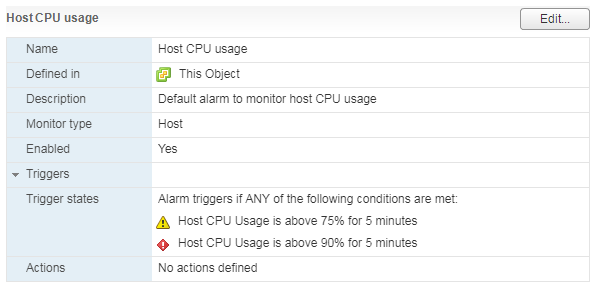
Kur ngarkesa në CPU të serverit është e lartë, VM-të që punojnë mbi të fillojnë të kenë probleme me performancën.
Në ESXTOP, të dhënat e ngarkesës së CPU-s së serverit paraqiten në pjesën e sipërme të ekranit. Përveç ngarkesës standarde të CPU-s, e cila është pak informuese për hipervizorët, ka edhe tre metrika të tjera:
CORE UTIL(%) – ngarkesa e bërthamës së serverit fizik. Ky numërator tregon se sa kohë, gjatë periudhës së matjes, bërthama ka kryer punë.
PCPU UTIL(%) – nëse është e aktivizuar hyper-threading, për çdo bërthamë fizike ka dy rrjedha (PCPU). Kjo metrikë tregon se sa kohë çdo rrjedh ka kryer punë.
PCPU USED(%) – e njëjta si PCPU UTIL(%), por merr parasysh shkallëzimin e frekuencës (ose uljen e frekuencës së bërthamës për qëllime kursimi energjie, ose rritjen e frekuencës së bërthamës përmes teknologjisë Turbo Boost) dhe hyper-threading.
PCPU_USED% = PCPU_UTIL% * frekuencën efektive të bërthamës / frekuencën nominale të bërthamës.
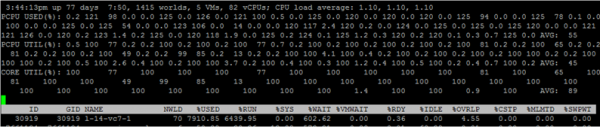
Në këtë screenshot, për disa bërthama për shkak të funksionimit të Turbo Boost, vlera USED është më e madhe se 100%, pasi frekuenca e bërthamës është më e lartë se ajo nominale.
Një fjalë për mënyrën se si llogaritet hyper-threading. Nëse proceset ekzekutohen 100% të kohës në të dy rrjedhat e bërthamës fizike të serverit, ndërsa bërthama punon me frekuencën nominale, atëherë:
- CORE UTIL për bërthamën do të jetë 100%,
- PCPU UTIL për të dy rrjedhat do të jetë 100%,
- PCPU USED për të dy rrjedhat do të jetë 50%.
Nëse të dy rrjedhat nuk kanë punuar 100% të kohës gjatë periudhës së matjes, atëherë në ato periudha, kur rrjedhat punonin paralelisht, PCPU USED për bërthamat ndahet në dy pjesë.
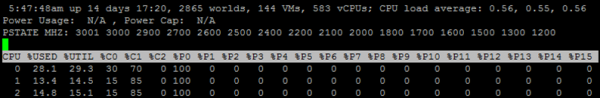
Në ESXTOP ka gjithashtu një ekran me parametrat e konsumit të energjisë të CPU-s së serverit. Këtu mund të shihni nëse serveri po përdor teknologjitë për kursim energjie: C-states dhe P-states. Aktivizohet me çelësin 'p':
Problemet standarde të performancës së CPU-s
Në fund, do të kaloj mbi arsyet tipike që shkaktojnë probleme me performancën e CPU-s në VM dhe do t'i jap disa këshilla të shkurtra për zgjidhjen e tyre:
Mungon frekuenca e bërthamës. Nëse nuk ka mundësi për të transferuar VM në bërthama më të fuqishme, mund të provoni të ndryshoni konfigurimet e konsumit të energjisë, në mënyrë që Turbo Boost të funksionojë më efikas.
Dimensionimi i gabuar i VM (shumë ose pak bërthama). Nëse vendosni pak bërthama, do të ketë një ngarkesë të lartë të CPU-s së VM. Nëse shumë, do të përballeni me një co-stop të lartë.
Rishpërndarje e madhe e CPU-s në server. Nëse VM ka një Ready të lartë, ulni rishpërndarjen e CPU-s.
Topologjia e gabuar NUMA në VM-të e mëdha. Topologjia NUMA, që e sheh VM (vNUMA), duhet të përputhet me topologjinë NUMA të serverit (pNUMA). Për diagnostikim dhe mundësitë e zgjidhjes së kësaj problemi, është shkruar, për shembull, në librin . Nëse nuk dëshironi të thelloheni dhe nuk keni kufizime licencash për OS-në e instaluar në VM, krijoni shumë sokete virtuale në VM me një bërthame. Nuk do të humbni shumë 🙂
Këtu për CPU-në kam përfunduar. Bëni pyetje. Në pjesën tjetër do flas për memorien operative.
Useful links
Burimi: habr.com
