

Përshëndetje, unë jam Dmitriy Logvinenko — Inxhinier të Dhënash në departamentin e analitikës së grupit të kompanive «Veze».
Do t'ju flas për një mjet të shkëlqyer për zhvillimin e proceseve ETL — Apache Airflow. Por Airflow është aq universale dhe shumëanshëm, sa duhet t'i kushtoni vëmendje edhe nëse nuk merresh me flukse të të dhënash, por keni nevojë për të nisur periodicisht ndonjë proces dhe të monitoroni përmbushjen e tij.
Dhe po, nuk do të flas vetëm, por do të tregoj gjithashtu: programi përmban shumë kod, screenshot-e dhe rekomandime.
Çfarë zakonisht shihni kur kërkoni fjalën Airflow / Wikimedia Commons
Përmbajtja
Hyrje
Apache Airflow — është si Django:
- është shkruar në Python,
- ka një panel administrimi të shkëlqyer,
- është pa kufi në zgjerim,
— vetëm më mirë, dhe është bërë krejtësisht për qëllime të tjera, siç është shkruar deri në kata:
- në ekzekutimin dhe monitorimin e detyrave në një numër të pakufizuar makinash (sa ju lejon Celery/Kubernetes dhe ndjenja juaj e përgjegjësisë)
- me gjenerimin dinamik të punëve nga një kod Python shumë të lehtë për t'u shkruar dhe kuptuar
- dhe me mundësinë për të lidhur çdo bazë të dhënash dhe API me ndihmën e komponenteve të gatshme, si dhe plugina të bëra në shtëpi (të cilat janë shumë të lehta për t'u bërë).
Ne përdorim Apache Airflow kështu:
- mbledhim të dhëna nga burime të ndryshme (marrëdhënie të shumta SQL Server dhe PostgreSQL, API të ndryshme me metrikat e aplikacioneve, madje edhe 1C) në DWH dhe ODS (për ne është Vertica dhe Clickhouse).
- si një avansuar
cronqë nxit proceset e konsolidimit të të dhënave në ODS, si dhe monitoron shërbimin e tyre.
Derisa një kohë të shkurtër më parë nevojat tona u ngopën nga një server i vogël me 32 CPU dhe 50 GB RAM. Në Airflow, për këtë arsye, punon:
- më shumë se 200 DAG-ë (në fakt flukset e punës, në të cilat ne kemi mbushur detyrat),
- në mesin e secilit mesatarisht 70 detyrash,
- kjo gjë përfundohet (poashtu mesatarisht) një herë në orë.
Dhe për atë se si ne u zgjeruam, do të shkruaj më poshtë, por tani le t'ia përcaktojmë përmendësh-qartë detyrën që do të zgjidhim:
Ka there tre SQL Server përdorues, çdo një me 50 baza të dhënash - instanca të një projekti, për pasojë, struktura e tyre është identike (gati kudo, muahaha), dhe do të thotë se në çdo njëri ka një tabelë të quajtur Orders (me fat që një tabelë me këtë emër mund të vendoset në çdo biznes). Ne marrim të dhënat, duke shtuar fushat ndihmëse (serveri burim, baza burim, identifikues i detyrës ETL) dhe naivisht do t'i hedhin ato në, le të themi, Vertica.
Le të shkojmë!
Pjesa kryesore, praktike (dhe pak teorike)
Pse na nevojitet ajo (dhe juve)
Kur pemët ishin të mëdha dhe unë isha thjesht SQL-punëtor në një shitës me pakicë rus, ne po zhvillonim proceset ETL aka rrjedhat e të dhënave me dy mjetet që kishim në dispozicion:
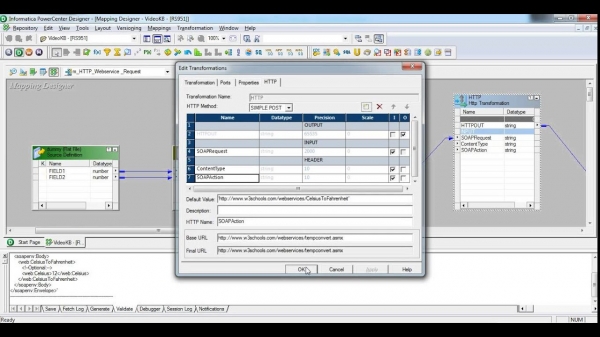
- Informatica Power Center — një sistem tepër i hollësishëm, jashtëzakonisht i fuqishëm, me harduerin e tij, versionimin e tij. Kam përdorur, më mirë të them, 1% të mundësive të tij. Pse? Së pari, ky ndërfaqe duket si nga fillimi i viteve 2000 dhe na jashtëzakonisht ushtroi presion. Së dyti, ky gjë është e projektuar për procese shumë të ndërlikuara, ri-përdorimin intensiv të komponentëve dhe të tjera gjëra të rëndësishme për ndërmarrjet. Për atë që kushton, si krah Airbus A380/ vit, ne do të heshtim.
Kujdes, një screenshot mund t'i dëmtojë të rinjtë nën 30 vjeç.

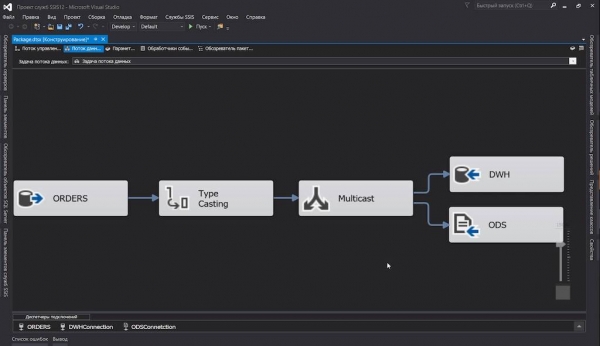
- SQL Server Integration Server — ky shok e kemi përdorur në rrjedhat tona brenda projektit. Ajo që është e vërtetë: ne tashmë po përdorim SQL Server dhe të mos përdorim mjete ETL të tij do të ishte disi e paarsyeshme. Lidhur me të gjitha, dhe ndërfaqja është e bukur, dhe raportet e performancës… Por nuk e duam këtë për produktet e softuerit, oh jo, jo për këtë. Ne mund të versionojmë të
dtsx(i cili është një XML me node që përzihen gjatë ruajtjes) ne mundemi, por çfarë dobi? A të bëjmë një paketë detyrash e cila do të transferonte qindra tabela nga një server në tjetrin? Ta zëmë se jo qindra, por 20 do t'ju bënte të humbni gishti tregues që klikoni mbi butonin e mausit. Por pamja e saj, padyshim është më moderne:
Patjetër që po kërkonim zgjidhje. Madje gati arritëm deri tek një gjenerator i vetë-shkruar të paketimeve SSIS…
... dhe pastaj më gjeti një punë e re. Aty më ndali Apache Airflow.
Kur zbulova se përshkrimi i proceseve ETL është një thjesht kod Python, nuk kisha parë ndonjëherë një gëzim të tillë. Ja, si u versionuan rrjedhat e të dhënave dhe u shkarkuan, dhe derdhja e tabelave me strukturë të përbashkët nga qindra baza të dhënash në një target bëri që të ishte një punë e thjeshtë e kodit Python në ekranet e 13'.
Krijojmë një klaster
Mos u bëjmë një kopësht të fëmijëve, dhe të flasim këtu për gjëra të qarta, si instalimi i Airflow, baza e të dhënave që keni zgjedhur, Celery dhe punë të tjera që përmenden në dokumenta.
Që të mund të fillojmë menjëherë me eksperimente, unë kam shkruar docker-compose.yml në të cilin:
- Do të ngrisim me të vërtetë Airflow: Planifikuesi, Serveri i Webit. Atje gjithashtu do të funksionojë Flower për monitorimin e detyrave të Celery (sepse tashmë është futur në
apache/airflow:1.10.10-python3.7, dhe ne s'kemi asgjë kundër); - PostgreSQL, në të cilin Airflow do të shkruajë informacionin e tij operativ (të dhënat e planifikuesit, statistikat e ekzekutimit etj.), ndërsa Celery do të regjistrojë detyrat e përfunduara;
- Redis, i cili do të veprojë si broker për detyrat e Celery;
- Punëtor Celery, i cili do të merret me ekzekutimin e detyrave direkt.
- Në dosjen
. /dagsne do të vendosim skedarët tanë me përshkrimin e DAG-ve. Ato do të kapen në flakë, kështu që nuk është e nevojshme të çaktivizoni tërë sistemin pas çdo gjesti të vogël.
Disa kode në shembuj nuk janë të plota (për të mos e ngarkuar tekstin), dhe ndonjëherë ato modifikohen gjatë procesit. Shembujt e plotë të punës mund të shikohen në depo. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Main container with Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, will be scaled using `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Vërejtje:
- Në ndërtimin e kompozitës, unë u mbështeta shumë në imazhin e njohur – sigurisht që duhet ta shikoni. Ndoshta nuk do t'ju nevojitet më asgjë tjetër në jetë.
- Të gjitha konfigurimet e Airflow janë të disponueshme jo vetëm përmes
airflow.cfg, por edhe përmes variablave të mjedisit (falë zhvilluesve), që unë e shfrytëzova armiqësisht. - Natyrisht, ai nuk është për prodhim: e kam bërë qëllimisht pa heartbeats në kontejnerët, dhe nuk kam shqetësuar për sigurinë. Por minimumi, i përshtatshëm për eksperimentet tona, e kam bërë.
- Vini re se:
- Folderi me DAG duhet të jetë i aksesueshëm si për planifikuesin ashtu edhe për punëtorët.
- E njëjta gjë vlen për të gjitha bibliotekat e jashtme — ato duhet të jenë të instaluara në makinat me planifikuesin dhe punëtorët.
Tani është e thjeshtë:
$ docker-compose up --scale worker=3Pasi të ngritët gjithçka, mund të shikoni ndërfaqet e uebit:
- Airflow:
- Flower:
Konceptet themelore
Nëse nuk kuptoni asgjë nga këto «dag» të gjitha, ja një fjalor të shkurtër:
- Planifikuesi — personi kryesor në Airflow, që kontrollon që robotët të punojnë, jo njeriu: monitoron orarin, përditëson dagët, nis detyrat.
Në fakt, në versionet e vjetra, ai kishte probleme me memorjen (jo, jo amnezi, por rrjedhje) dhe në konfigurime kishte një parametrin legaciy
run_duration— intervali i ripërsëritjes së tij. Por tani gjithçka është në rregull. - DAG (i njohur si «dag») — «graf me drejtime jo-ciklike», por kjo përkufizim nuk thotë shumë për shumicën, dhe në thelb është një enë për detyrat që ndërveprojnë me njëra-tjetrën (shih më poshtë) ose një analog Paketë në SSIS dhe Fleksibilitet në Informatica.
Përveç dagëve, mund të ketë edhe subdagë, por ndoshta nuk do të arrijmë të merremi me ta.
- Kalim i DAG — një dag i inicializuar, të cilit i është caktuar
execution_date. Kalimet e një dag-u mund të punojnë paralelisht (nëse natyrisht i keni bërë detyrat tuaja idempotente). - Operator — ato janë copa kodi që janë përgjegjëse për kryerjen e ndonjë veprimi të caktuar. Ka tre lloje operatorësh:
- action, siç është operatori ynë i dashur
PythonOperator, i cili është në gjendje të ekzekutojë çdo kod (të vlefshëm) Python; - transfer, që transferojnë të dhëna nga një vend në një tjetër, e thënë ndryshe,
MsSqlToHiveTransfer; - sensor do të lejojë të reagoni ose ngadalësojë ekzekutimin e dag-ut deri në ndodhin e një ngjarjeje.
HttpSensormund të thërrasë endpoint-in e specified, dhe kur pret përgjigjen e nevojshme, nis transferiminGoogleCloudStorageToS3Operator. Një mendje kurioze do të pyesë: «përse? Sepse është e mundur të bësh përsëritje direkt në operator!» Pastaj, për të mos mbushur pulin e detyrave me operatorë të ngrirë. Sensori aktivizohet, kontrollon dhe ndalet deri në përpjekjen tjetër.
- action, siç është operatori ynë i dashur
- Detyrë — operatorët e shpallur, pa marrë parasysh llojin e tyre dhe të lidhur me dag-u, ngrihen në gradën e detyrës.
- Instancë detyre — kur plani gjeneral vendosi se detyrat është koha të dërgohen në luftarët ekzekutues (direkt në vend, nëse përdorim
LocalExecutorapo në një nodë të largët në rastin eCeleryExecutor), ai u caktton kontekst (dmth, një set variables — parametrat e ekzekutimit), zhvillon shabllonet e komandave ose kërkesave dhe i vendos ato në pool.
Generojmë detyra
Së pari, do të shënojmë skemën e përgjithshme të dag-ut tonë, dhe më pas do të zhytim gjithnjë e më thellë në detaje, sepse ne po aplikojmë disa zgjidhje tejet të veçanta.
Kështu, në formën më të thjeshtë, një dag i tillë do të duket kështu:
from datetime import timedelta, datetime

from airflow import DAG
from airflow.operators.python_operator import PythonOperator

from commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Le të kuptojmë:
- Për sëpari importojmë bibliotekat e nevojshme dhe diçka tjetër;
sql_server_ds— ështëList[namedtuple[str, str]]me emrat e lidhjeve nga Airflow Connections dhe bazat e të dhënave nga të cilat do të marrim tabelën tonë;dagËshtë shpallja e dag-ut tonë, e cila duhet të jetë nëglobals(), ndryshe Airflow nuk do ta gjejë. Po ashtu, duhet të informojmë dag-un:- si e quajmë
ordersKy do të jetë emri që do të shfaqet në ndërfaqen e uebit, - se ai do të fillojë punën nga mesnata e 8 korrikut,
- dhe duhet të ekzekutohet, përafërsisht çdo 6 orë (për djemtë cool këtu në vend të
timedelta()lejohetcron-string0 0 0/6 ? * * *, për ata që nuk janë aq cool — një shprehje si@daily);
- si e quajmë
workflow()do të bëjë punën kryesore, por jo tani. Tani thjesht do ta hedhim kontekstin tonë në log.- Tani magjia e thjeshtë e krijimit të detyrave:
- kalojmë nëpër burimet tona;
- initializo
PythonOperator, e cila do të ekzekutojë zbrazëtinë tonëworkflow(). Mos harroni të jepni një emër unik (brenda dag-ut) për detyrën dhe të lidhni vetë dag-un. Flagprovide_contextdo të çojë në funksion disa argumente shtesë, të cilat ne do t'i mbledhim me kujdes me**context.
Derisa jemi në këtë pikë, çfarë kemi marrë:
- një dag të ri në ndërfaqen e uebit,
- njëqind e pesëdhjetë detyra, të cilat do të ekzekutohen paralelisht (nëse konfigurimet e Airflow, Celery dhe fuqisë së serverëve lejojnë).
Më saktësisht, pothuajse kemi arritur.
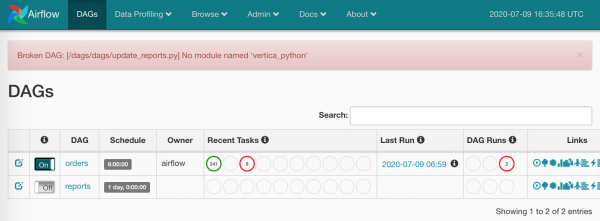
Kush do të vendosë varësitë?
Për ta thjeshtuar këtë, unë e kam futur në docker-compose.yml procesimin requirements.txt në të gjitha nodet.
Tani, le të fillojmë:
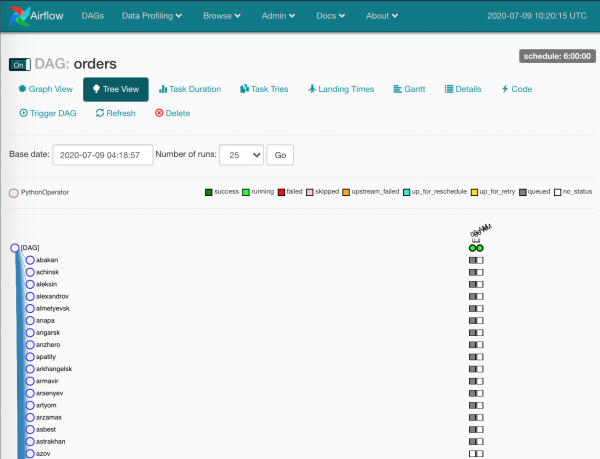
Katrorët gri — instancat e detyrës, të përpunuara nga planifikuesi.
Pak po presim, detyrat po kapen nga punëtorët:
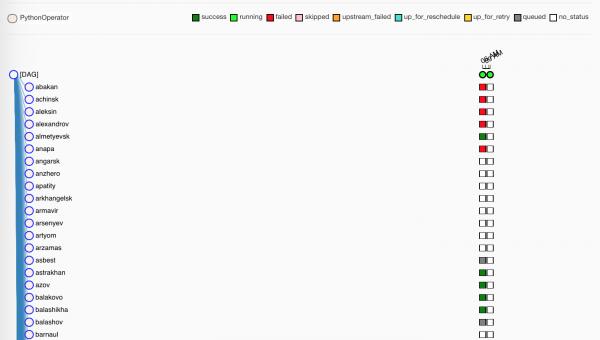
Gjelbërt, natyrisht, - janë të përfunduara me sukses. Të kuq — jo aq me sukses.
Në fakt, në prodhimin tonë nuk ka asnjë dosje
. /dags, e cila sinkronizohet midis makinave — të gjitha dag-të ndodhen nëgitnë Gitlab-in tonë, dhe CI Gitlab vendos azhurnimet në makina kur është bërë bashkimi nëmaster.
Pak për Flower
Ndërsa punëtorët po përfundjnë detyrat tona zbrazëta, le të kujtojmë një instrument tjetër që mund të na tregojë diçka — Flower.
Faqja e parë me informacion të përmbledhur për nodet-punëtorë:
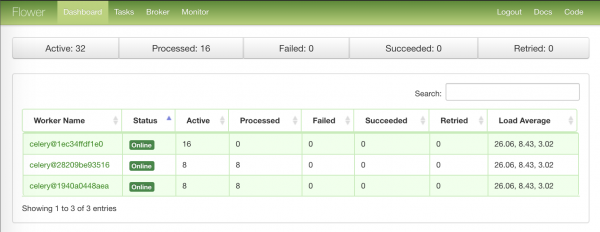
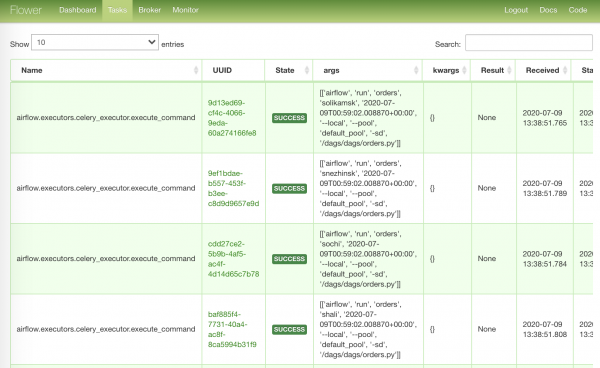
Faqja më e ngarkuar me detyra që kanë nisur punën:
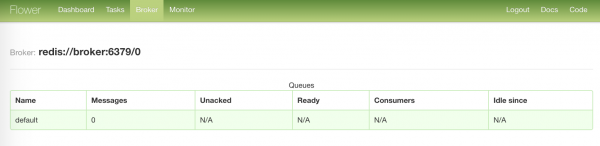
Faqja më e mërzitshme me statusin e brokerit tonë:
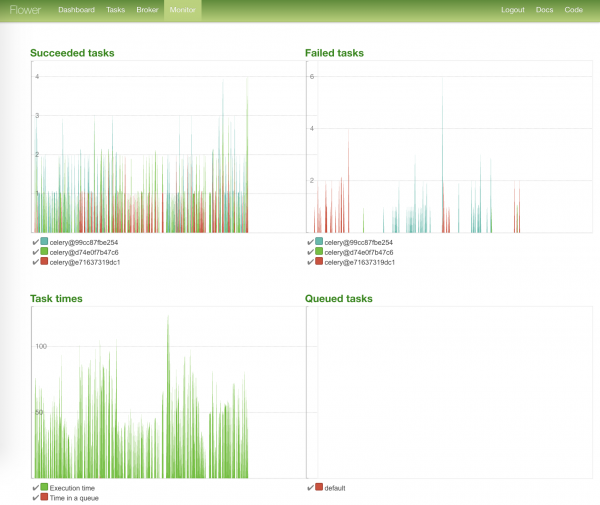
Faqja më e ndritshme — me grafikët e gjendjes së detyrave dhe kohës së ekzekutimit të tyre:
Ngarkojmë atë që nuk është ngarkuar
Pra, të gjitha detyrat u përfunduan, mund të marrim të lënduarit.
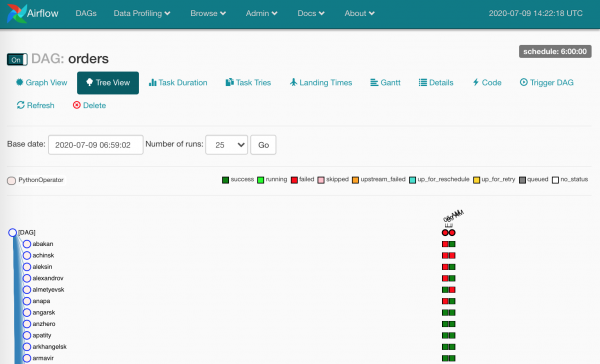
Dhe ka pasur mjaft të lënduar — për arsye të ndryshme. Në rastin e përdorimit të duhur të Airflow, këto katrorë flasin për faktin se të dhënat sigurisht që nuk arritën.
Duhet të shikojmë logun dhe të rindezim instancat e taskëve që kanë rënë.
Duke klikuar në çdo katror, do të shohim veprimet e disponueshme:
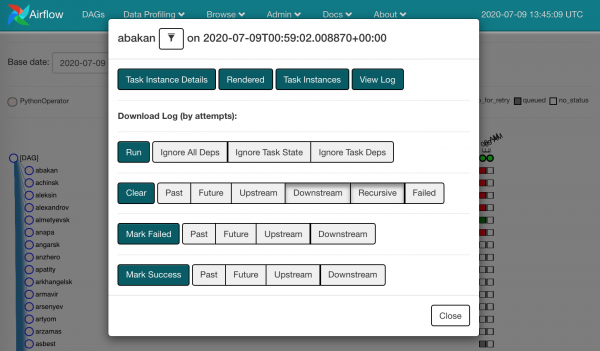
Mund të marrim dhe të bëjmë Clear për atë që ka rënë. Kjo do të thotë, harrojmë se diçka ka shkuar keq dhe ajo instancë e njëjtë do të kthehet në planifikues.
E qartë, që të veprosh kështu me të gjitha katrorët e kuq nuk është shumë human — nuk është kjo ajo çfarë presim nga Airflow. Natyrisht, ne kemi armën tonë të shkatërrimit në masë: Browse/Task Instances
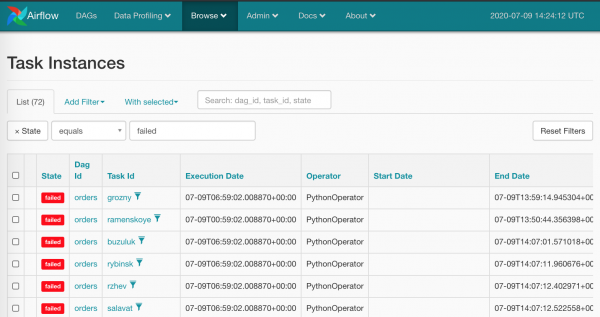
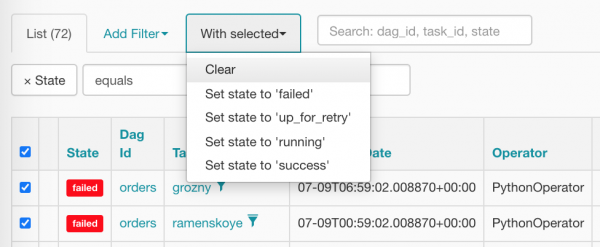
Do të zgjedhim të gjitha njëherësh dhe do të zbresim duke shtypur pikën e duhur:
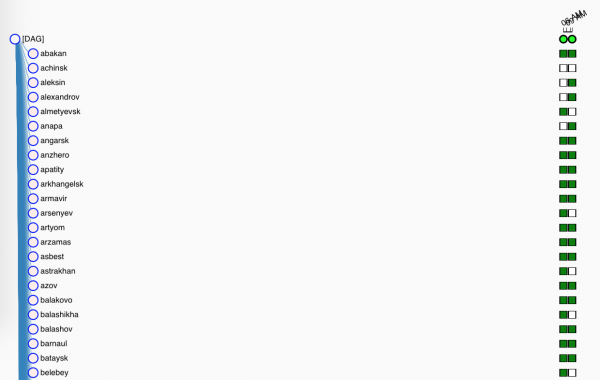
Pas pastrimit, taksitë tona duken kështu (ato tashmë presin me padurim kur planifikuesi do t'i planifikojë):
Koneksionet, huki dhe variabla të tjera
Është koha për të parë DAG-un tjetër, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='Raportet DWH të përditësuara',
    html_content=dedent("""Gospodë të mirë, raportet janë përditësuar"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, zgjohet, ne kemi rënë {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Ați făcut vreodată un raport de actualizare? Este din nou aceeași poveste: avem o listă de surse din care să extragem datele; avem o listă în care să le așezăm; să nu uităm să semnalizăm când totul s-a întâmplat sau s-a stricat (păi, asta nu e despre noi, nu?).
Haideți să trecem din nou prin fișier și să vedem lucrurile noi neclare:
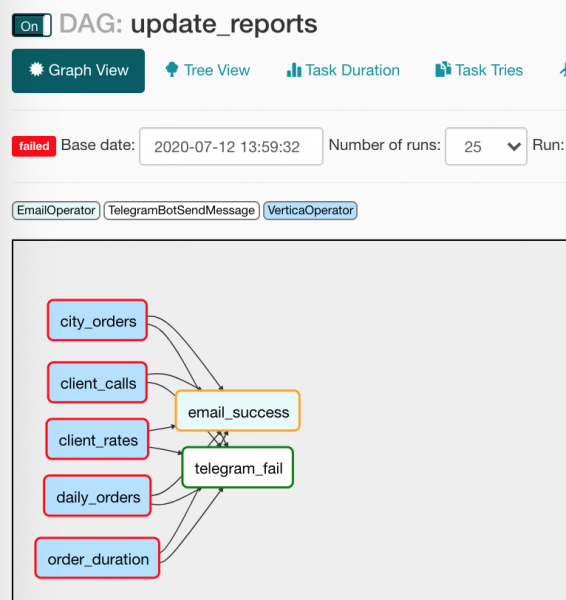
from commons.operators import TelegramBotSendMessage— nimic nu ne împiedică să facem propriile noastre operatore, iar noi am profitat de acest lucru făcând o mică înfășurare pentru a trimite mesaje în Descheiat. (Vom vorbi mai jos despre acest operator);default_args={}— DAG-ul poate oferi aceleași argumente tuturor operatoarelor sale;to='{{ var.value.all_the_kings_men }}'— câmptonu va fi hardcodat, ci generat dinamic cu ajutorul Jinja și al unei variabile cu lista de emailuri pe care am așezat-o cu grijă înAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— condiția de declanșare a operatorului. În cazul nostru, mesajul va ajunge la șefi doar dacă toate dependențele au rulat cu succes;tg_bot_conn_id='tg_main'— argumenteconn_idacceptă identificatorii conexiunilor pe care le creăm înAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— mesajele în Telegram vor pleca doar în cazul în care există sarcini căzute;task_concurrency=1— interzicem lansarea simultană a mai multor instanțe de sarcină pentru aceeași sarcină. În caz contrar, vom obține lansarea simultană a mai multorVerticaOperator(care se uită la aceeași tabelă);report_update >> [email, tg]— totulVerticaOperatorse va aduna în trimiterea unui email și a unui mesaj, iată așa:

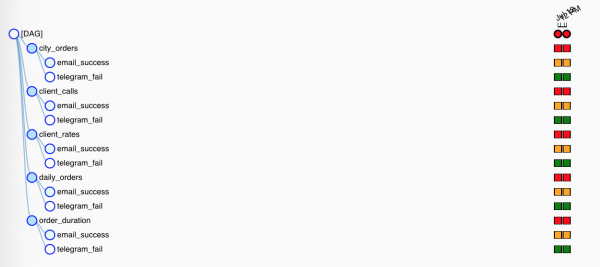
Dar, deoarece condțiile de declanșare a operatoarelor de notificare sunt diferite, va funcționa doar unul. În Tree View, totul arată puțin mai puțin clar:

Voi spune câteva cuvinte despre macro-uri și prietenii lor — variabile.
Macro-urile sunt marcaje Jinja care pot introduce diferite informații utile în argumentele operatoarelor. De exemplu, astfel:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se va desfășura în conținutul variabilei de context execution_date în format YYYY-MM-DD: 2020-07-14. Cel mai plăcut este că variabilele de context sunt legate de un anumit instantaneu de sarcină (cadrul din Tree View), iar la repornirea plasează marcajele în aceleași valori.
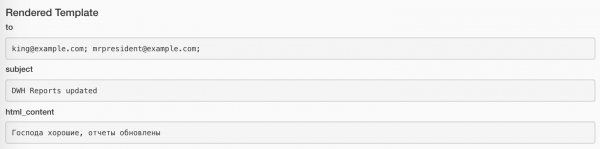
Valorile atribuite pot fi vizualizate folosind butonul Rendered pe fiecare instanță de sarcină. Iată cum arată sarcina cu trimiterea emailului:
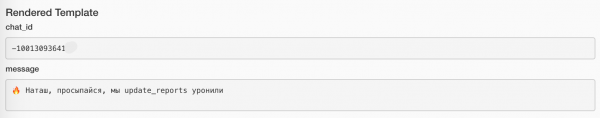
Iată cum arată sarcina cu trimiterea mesajului:
Lista e plotave të integruara për versionin më të fundit është këtu:
Për më tepër, me ndihmën e plugjineve, ne mund të shpallim makro të tijat, por kjo është një histori krejt tjetër.
Përveç gjërave të paracaktuara, ne mund të zëvendësojmë vlerat e variablave tanë (më lart në kod kam bërë tashmë këtë). Le të krijojmë disa: Admin/Variables Pika të shumta:
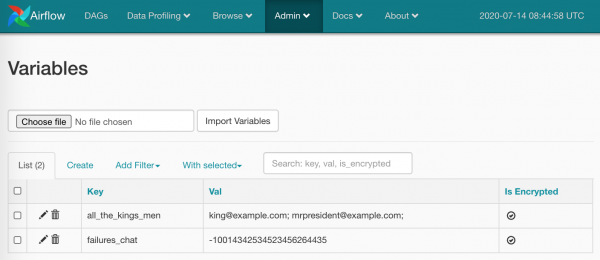
Gjithçka është gati për tu përdorur:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Një vlerë mund të jetë scalare, por mund të jetë dhe JSON. Në rastin e JSON-it:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
thjesht përdorim rrugën për çelësin përkatës: {{ var.json.bot_config.bot.token }}.
Do të them një fjalë të vetme dhe do të tregoj një ekran për lidhet. Këtu gjithçka është elementare: në faqen Admin/Connections krijojmë lidhjen, vendosim atje emrat tanë të përdoruesve/faqet dhe parametra më specifik. Ja si:
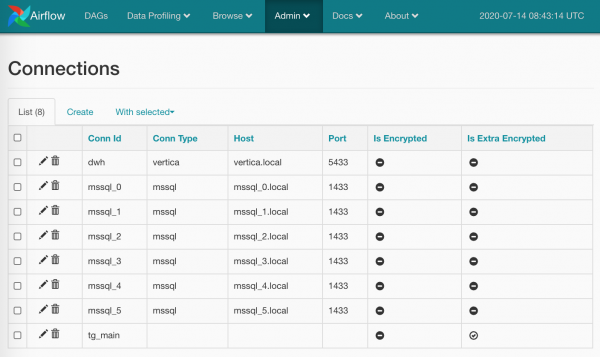
Fjalëkalimet mund të jenë të kriptuara (më me imtësi se në variantin e paracaktuar), ose mund të mos specifikohet lloji i lidhjes (siç bëra unë për tg_main) — çështja është se lista e llojeve është e ngulitur në modelet Airflow dhe nuk mund të zgjerohet pa u ndaluar në burimet (nëse ndonjëherë kam harruar diçka — ju lutem më korrigjoni), por është e thjeshtë të marrim kredencialet vetëm me emrin.
Dhe gjithashtu është e mundur të bësh disa lidhje me të njëjtin emër: në një rast të tillë, metoda BaseHook.get_connection(), e cila na sjell lidhjet sipas emrit, do të kthejë një të rastit nga disa të ngjashëm (do të ishte më logjike të bënte Round Robin, por këtë do ta lëmë në përgjegjësinë e zhvilluesve të Airflow).
Variablat dhe Lidhjet janë padyshim mjete të shkëlqyera, por është e rëndësishme të mos humbasësh ekuilibrin: cilat pjesë të proceseve të tua i ruani realisht në kod, dhe cilat i besoni ruajtjes nga Airflow. Nga njëra anë, ndërrimi i shpejtë i vlerës, për shembull, e-maili i dërguesit, mund të jetë i përshtatshëm përmes UI. Nga ana tjetër, kjo është në fund të fundit një kthim në përdorimin e miut, nga të cilin ne (unë) dëshironim të ishim të lirë.
Puna me lidhjet është një nga detyrat hukut. Në të vërtetë hook-et e Airflow janë pika lidhjeje me shërbime dhe biblioteka të jashtme. Për shembull, JiraHook do të hapë për ne një klient për ndërveprim me Jira (mund të lëvizim detyra andej këndej), dhe me ndihmën e SambaHook mund të dërgoni një skedar lokal në pikën smb.Dhe ne po afrohemi për të parë se si është bërë
Shpjegojmë operatorin personalizuar
TelegramBotSendMessage commons/operators.py
Kodi me vetë operatorin: me operatorin vetë:
nga importimi i Union

nga airflow.operators import BaseOperator

nga commons.hooks import TelegramBotHook, TelegramBot

klasa TelegramBotSendMessage(BaseOperator):
    """Dërgo mesazh në chat_id duke përdorur TelegramBotHook

    Shembuj:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} ka dështuar :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Dërgo "{self.message}" në bisedën {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Këtu, si gjithçka tjetër në Airflow, gjërat janë shumë të thjeshta:
- Trashëguam nga
BaseOperator, e cila implementon shumë gjëra specifike për Airflow (shikoni për më shumë kur të keni kohë) - Deklaruam fushat
template_fields, në të cilat Jinja do të kërkojë makros për përpunim. - Organizuam argumentet e duhura për
__init__(), vendosëm parametra të paracaktuar, kur është nevoja. - Nuk harrojmë as për inicializimin e prindit.
- Hapëm hooking përkatës
TelegramBotHook, morëm objektin-klient prej tij. - E përcaktuam (override) metodën
BaseOperator.execute(), e cila do të thirret nga Airflow kur të jetë koha për të ekzekutuar operatorin — aty e realizojmë veprimin kryesor, pa harruar të regjistrohemi. (Regjistrohemi, për fat të keq, pikërisht nëstdoutdhestderr— Airflow do ta kapë, do ta mbajë bukur, do ta rregullojë dhe do ta vendosë atje ku duhet.)
Le të shohim se çfarë kemi në commons/hooks.py. Pjesa e parë e skedarit, me hooking vetë:
nga importimi i Union

nga airflow.hooks.base_hook import BaseHook
nga requests_toolbelt.sessions import BaseUrlSession

klasa TelegramBotHook(BaseHook):
    """Huku i API të Telegram Bot

    Shënim: shtoni një lidhje me Conn Type bosh dhe mos harroni
    të plotësoni Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Nuk e di se çfarë mund të shpjegoj këtu, vetëm do të theksoj momentet e rëndësishme:
- Ne trashëgojmë, mendojmë për argumentet — në shumicën e rasteve do të ketë vetëm një:
conn_id; - E përcaktojmë metodat standarde: unë u kufizova në
get_conn(), në të cilin marr parametrat e lidhjes sipas emrit dhe thjesht nxjerr seksioninextra(kjo është fusha për JSON), në të cilën unë (sipas udhëzimeve të mia!) vendosa token e Telegram-botit:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Po krijoj një ekzemplar të
TelegramBot, duke i dhënë atij tani një token të caktuar.
Kjo është gjithçka. Mund të marr klientin nga hooku me anë të TelegramBotHook().clent ose TelegramBotHook().get_conn().
Dhe pjesa e dytë e skedarit, në të cilën unë bëj një mikro-kapsulë për Telegram REST API, në mënyrë që të mos sjell të njëjtin për një metodë të vetme sendMessage.
class TelegramBot:
    """Përfaqësuesi i API-së së Telegram Bot

    Shembuj:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Përshëndetje, dashuri')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Përshëndetje, dashuri', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Rruga e duhur është të bashkosh gjithçka këtë:
commons/operators.py,TelegramBotHook,TelegramBot— në një plugin, ta vendosësh në një depo publike, dhe ta ofrosh në Open Source.
Ndërsa po studiojmë të gjitha këto, azhurnimet e raportit tonë kishin arritur të mblidhen dhe të më dërgojnë një mesazh gabimi në kanal. Do shkoj të kontrolloj se çfarë ka ndodhur përsëri…
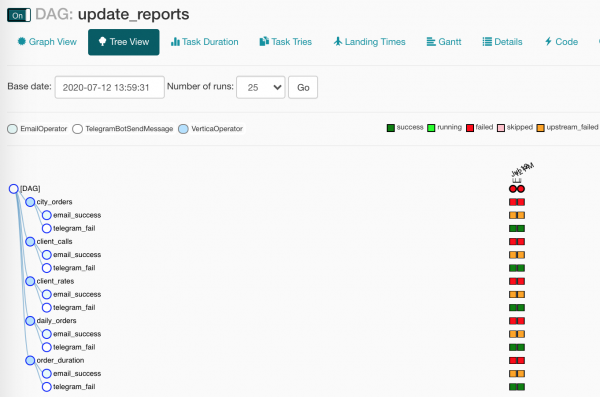
Në DAG-un tonë diçka ka shkuar keq! E ndonjëherë kjo ishte ajo që prisnim? Pikërisht!
A do të derdhësh?
A besoni se unë kam humbur diçka? Duket se propozova të transferoj të dhënat nga SQL Server në Vertica, e këtu kam devijuar nga tema, i paaftë!
Kjo veprim ishte e qëllimshme, thjesht isha i detyruar t'ju shpjegoja disa terminologji. Tani mund të vazhdojmë.
Plani ynë ishte kështu:
- Të bëjmë një DAG
- Të gjenerojmë detyra
- Të shohim se si është gjithçka e bukur
- Të caktojmë numrat e sesioneve për ngarkimet
- Të marrim të dhënat nga SQL Server
- Të vendosim të dhënat në Vertica
- Të mbledhim statistika
Prandaj, për ta nisur të gjithë këtë, kam bërë një shtesë të vogël në docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Aty jemi duke ngritur:
- Vertica si host
dwhme cilësimet më të zakonshme, - tre instance SQL Server,
- mbushim bazat në fund me disa të dhëna (asnjëherë mos shikoni në
mssql_init.py!)
E aktivizojmë gjithçka me një komandë disi më të komplikuar se herën e kaluar:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Çfarë ka gjeneruar gjeneratori ynë të mrekullueshëm, mund ta shohim, duke përdorur opsionin Data Profiling/Ad Hoc Query:
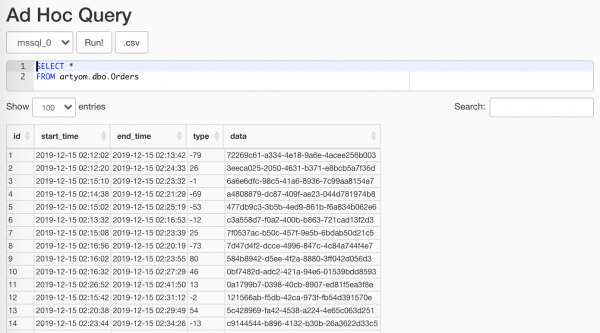
E rëndësishme, mos e tregoni këtë analistëve
Nuk do të ndalem në detaje mbi seancat ETL unë nuk do, aty është krejtësisht e thjeshtë: krijojmë bazën, në të një tavëll, e mbështjellim gjithçka me menaxherin e kontekstit, dhe tani e bëjmë kështu:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
nga sys import stderr

klasa Sesioni:
    """Seanca ETL workflow

    Shembuj:
        me Sesioni(emri_detyrës) si seancë:
            print(seancë.id)
            seancë.suksesshëm = True
            seancë.rreshtat_e_ngarkuar = 15
            seancë.koment = 'Shumë mirë'
    """

    def __init__(self, lidhja, emri_detyrës):
        vetë.lidhja = lidhja
        vetë.lidhja.autocommit = True

        vetë._emri_detyrës = emri_detyrës
        vetë._id = None

        vetë.rreshtat_e_ngarkuar = None
        vetë.suksesshëm = None
        vetë.koment = None

    def __enter__(self):
        kthehu vetë.hap()

    def __exit__(self, tipi_exc, vlera_exc, tb_exc):
        nëse any(tipi_exc, vlera_exc, tb_exc):
            vetë.suksesshëm = False
            vetë.koment = f'{tipi_exc}: {vlera_exc}n{tb_exc}'
            print(tipi_exc, vlera_exc, tb_exc, file=stderr)
        vetë.mbyll()

    def __repr__(self):
        kthehu (f'')

    @property
    def emri_detyrës(self):
        kthehu vetë._emri_detyrës

    @property
    def id(self):
        kthehu vetë._id

    def _ekzekuto(self, pyetje, *args):
        me vetë.lidhja.cursor() si kursori:
            kursori.execute(pyetje, args)
            kthehu kursori.fetchone()[0]

    def _krijo(self):
        pyetje = """
            KRIJO TABELËN NËSE NUK EKZISTON sesione (
                id          SERIAL       JO NULL KRYESORE,
                emri_detyrës   VARCHAR(200) JO NULL,

                filluar     TIMESTAMPTZ  JO NULL DEFAULT current_timestamp,
                përfunduar    TIMESTAMPTZ           DEFAULT current_timestamp,
                sukses      BOOL,

                rreshtat_e_ngarkuar INT,
                koment     VARCHAR(500)
            );
            """
        vetë._ekzekuto(pyetje)

    def hap(self):
        pyetje = """
            SHTO NË sesione (emri_detyrës, përfunduar)
            VLERAT (%s, NULL)
            KTHIM ID;
            """
        vetë._id = vetë._ekzekuto(pyetje, vetë.emri_detyrës)
        print(vetë, 'hapur')
        kthehu vetë

    def mbyll(self):
        nëse jo vetë._id:
            ngrije SesionClosedError('Seanca nuk është e hapur')
        pyetje = """
            UPDATE sesione
            SHTO
                përfunduar = DEFAULT,
                sukses      = %s,
                rreshtat_e_ngarkuar = %s,
                koment     = %s
            KU
                id = %s
            KTHIM ID;
            """
        vetë._ekzekuto(pyetje, vetë.suksesshëm, vetë.rreshtat_e_ngarkuar,
                      vetë.koment, vetë.id)
        print(vetë, 'mbyllur',
              ', sukses: ', vetë.suksesshëm,
              ', Ngarkuar: ', vetë.rreshtat_e_ngarkuar,
              ', koment:', vetë.koment)

klasa SesionError(Exception):
    kaloni

klasa SesionClosedError(SesionError):
    kaloni
Ka ardhur koha të marrim të dhënat tona nga gjysma e qindrave të tabelave tona. Le t'i marrim ato me disa rreshta të thjeshtë:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

pyetje = f"""
    ZGJIDH
        id, koha_e_fillimit, koha_e_përfundimit, tipi, të dhënat
    NGA dbo.Orders
    KU
        CONVERT(DATE, koha_e_fillimit) = '{dt}'
    """

df = pd.read_sql_query(pyetje, source_conn)- Me anë të hook ne do të marrim nga Airflow
pymssql-konnektimin - Në pyetje do të vendosim një kufizim në formën e datës - në funksion, do ta sjellë nëpërmjet shablonit.
- Ne e japim pyetjen tonë
pandas, e cila do të nxjerrë për neMundësia e qasjes në të dhëna në formatin çelës-vlerë ose grupe kolonesh (— do na nevojitet më pas.
Unë përdor zëvendësimin
{dt}në vend të parametrave të pyetjes%sjo sepse unë jam një Buratino i keq, por sepsepandasnuk mund ta përballojëpymssqldhe ia jep të funditparams: Lista, ndonëse ai dëshiron shumëtuple.
Gjithashtu, vini re se zhvilluesipymssqlvendosi të mos e mbështesë më, dhe është koha për t'u zhvendosur nëpyodbc.
Le të shohim se me çfarë Airflow i ka mbushur argumentet funksioneve tona:
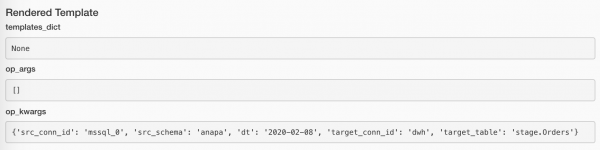
Nëse nuk ka të dhëna, atëherë nuk ka kuptim të vazhdojmë. Por është e çuditshme të mendohet se ngarkimi ishte i suksesshëm. Por kjo gjithashtu nuk është gabim. A-a-a, çfarë të bëjmë?! Ja çfarë:
if df.empty:
    raise AirflowSkipException('Nuk ka rreshta për të ngarkuar')
AirflowSkipException do t'i thotë Airflow, që në fakt nuk ka gabim, dhe ne do ta kalojmë detyrën. Në ndërfaqe, nuk do të ketë katror të gjelbër e as të kuq, por një ngjyrë pink.
Le të hedhim për të dhënat tona disa kolona:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Pikërisht:
- Baza e të dhënave nga e cila morëm porositë,
- Identifikuesi i sesionit tonë të ngarkimit (do të jetë ndryshe për çdo detyrë),
- Hashi nga burimi dhe identifikuesi i porosisë — për të pasur një identifikues unik të porosisë në bazën përfundimtare (ku të gjitha do të bashkohen në një tabelë).
Kanë mbetur vetëm dy hapa: ngarkoni gjithçka në Vertica. Dhe, është e çuditshme, një nga mënyrat më efektive për ta bërë këtë është përmes CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Ne po krijojmë një marrës të posaçëm
StringIO. pandasdo ta grumbullojë në të tonëMundësia e qasjes në të dhëna në formatin çelës-vlerë ose grupe kolonesh (në formën eCSV-rreshta.- Do të hapim një lidhje me Vertica-n tonë të dashur përmes hooks.
- Dhe tani me ndihmën e
copy()do t'i dërgojmë të dhënat tona drejtpërdrejt në Vertica!
Do të marrim nga driver-i se sa rreshta janë ngarkuar, dhe do të informojmë menaxherin e sesionit se gjithçka është në rregull:
session.loaded_rows = cursor.rowcount
session.successful = True
Kjo është gjithçka.
Në prodhim ne krijojmë tabelën target manualisht. Këtu, unë e lejoj veten një automatik të vogël:
create_schema_query = f'KRIJO SKEMË NËSE NUK EKSPLOZOJ {target_schema};'
create_table_query = f"""
    KRIJO TABELË NËSE NUK EKSPLOZOJ {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Me ndihmën e
VerticaOperator()krijoj skemën e bazës së të dhënave dhe tabelën (nëse ato nuk ekzistojnë, natyrisht). E rëndësishme është të vendosni saktë varësitë:
për conn_id, schema në sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Të shohim përfundimet
— Ja, — tha miu, — nuk është e vërtetë se tani
A e ke verifikuar se në pyll unë jam kafsha më e frikshme?
Julia Donaldson, "Gruffalo"
Mendoj se po të bënim me kolegët e mi një garë: kush e krijon dhe e nis më shpejt një proces ETL nga fillimi: ata me SSIS dhe miun e tyre dhe unë me Airflow… Dhe pastaj do të krahasonim lehtësinë e mbajtjes… Euh, mendoj se do të pajtoheshit që unë do t'i kaloj në çdo aspekt!
Nëse flasim pak më seriozisht, Apache Airflow - për shkak se përshkrimi i proceseve bëhet në formën e kodit programor - e bëri punën time shumë më të lehtë dhe më të këndshme.
Papërjashtim, zgjerueshmëria e pafundme: si në planin e plugin-eve, ashtu dhe predispozita për shkallëzim - ju jep mundësinë të aplikoni Airflow praktikisht në çdo fushë: qoftë në ciklin e plotë të mbledhjes, përgatitjes dhe përpunimit të të dhënave, qoftë në nisjen e raketave (në Mars, sigurisht).
Pjesa përfundimtare, informuese dhe referuese
Gramat për të cilat ne i mbledhëm për ju
start_date. Po, ky është një meme lokal tani. Nëpërmjet argumentit kryesor të DAG-utstart_datekalojnë të gjithë. Në mënyrë të shkurtër, nëse e vendosni nëstart_datedatën aktuale, dhe nëschedule_intervalnë një ditë, atëherë DAG-u do të nisë nesër jo më herët.start_date = datetime(2020, 7, 7, 0, 1, 2)Dhe më shumë asnjë problem.
Kjo është gjithashtu e lidhur me një gabim tjetër ekzekutimi:
Task is missing the start_date parameter, i cili shpesh tregon se keni harruar të lidhni operatorin me DAG-un.- E gjithë në një makinë. Po, dhe bazat (e Airflow-it dhe mbulesës sonë), serveri i web-it, planifikuesi dhe punëtorët. Dhe madje ka funksionuar. Por me kalimin e kohës, numri i detyrave në shërbime u rrit, dhe kur PostgreSQL filloi të kthejë përgjigje për indeksin për 20 ms në vend të 5 ms, ne e morëm dhe e larguam.
- LocalExecutor. Po, ne jemi ende në të, dhe tani jemi afër skajit. LocalExecutor na ka mjaftuar deri tani, por tani ka ardhur koha të zgjerohemi me të paktën një punëtor, dhe do të duhet të punojmë për të kaluar në CeleryExecutor. Dhe duke marrë parasysh që me të mund të punoni edhe në një makinë, nuk ka asgjë që ndalon përdorimin e Celery as në serverin që "natyrisht, kurrë nuk do të shkojë në prodhim, e betohem!"
- Mos përdorimi i mjeteve të integruara:
- Connections për ruajtjen e kredencialeve të shërbimeve,
- SLA Misses për t'iu përgjigjur detyrave që nuk përfunduan me kohë,
- XCom për exchange të metadonnées (thashë metagtë dhënave!) midis detyrave të DAG-ut.
- Keqpërdorimi i postës. Çfarë mund të themi këtu? Janë konfiguruar njoftime për të gjitha përsëritjet e detyrave të rëna. Tani në Gmail tim të punës kam >90k email-a nga Airflow, dhe ndërfaqja web e postës refuzon të marrë dhe fshijë më shumë se 100 njësi njëherësh.
Më shumë gurë nën ujë:
Mjetet për automatizim edhe më të madh
Për të punuar edhe më shumë me mendje sesa me duar, Airflow na ka përgatitur këto:
- — akoma ka statusin Eksperimental, që nuk e pengon të punojë. Me të është e mundur jo vetëm të marrim informacion mbi DAG-ët dhe detyrat, por të ndalojmë/nisim një DAG, të krijojmë një DAG Run apo një pool.
- — përmes dhomës së komandave, shumë mjete janë të disponueshme, të cilat jo vetëm që janë të papraktyse për tu përdorur përmes WebUI, por në fakt nuk ekzistojnë aspak. Për shembull:
backfillnevojitet për të rinisur instancat e detyrave.
Për shembull, vijnë analistët, thonë: "E ke, shok, një problem në të dhënat nga 1 deri në 13 janar! Niset nga fillimi!". Dhe ti bën:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Kujdesi i bazës:
initdb,resetdb,upgradedb,checkdb. run, i cili lejon të niset një instancë detyre, duke injoruar të gjitha varësitë. Më shumë, është e mundur ta nisim atë përmesLocalExecutor, madje edhe nëse ke një klastër Celery.- Përshkruan në mënyrë të ngjashme
test, por nuk shkruan asgjë në bazë. connectionslejon krijimin në masë të lidhjeve nga shell.
- — një mënyrë bastante hardcore për të ndërvepruar, e cila është e destinuar për pluginat, jo për të bërë punë manuale. Por kush na ndalon të shkojmë në
/home/airflow/dags, të nisëipythondhe të fillojmë të çmendemi? Mund, për shembull, të eksportojmë të gjitha lidhjet me këtë kod:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Lidhja me bazën e të dhënave të metadata Airflow. Nuk rekomandoj të shkruani në të, por është shumë më e shpejtë dhe më e lehtë të nxjerrësh statuset e detyrave për metrika të ndryshme specifike sesa përmes ndonjë API.
Të themi, jo të gjitha detyrat tona janë idempotente dhe ndonjëherë mund të bjerë dhe kjo është në rregull. Por disa grumbuj — kjo është e dyshimtë, dhe duhet të kontrollojmë.
Kujdes, SQL!
ME last_executions SI (
Zgjidhni
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        MBI (
            PARTITION BY task_id, dag_id
            RENDIT
            execution_date DESC) SI rn
Nga public.task_instance
KU
    execution_date > tani() - INTERVAL '2' DITË
),
failed SI (
    Zgjidhni
        task_id,
        dag_id,
        execution_date,
        state,
        Rasti Kur rn = row_number() MBI (
            PARTITION BY task_id, dag_id
            RENDIT
            execution_date DESC)
                 ATËHERË E VËRTETË
        SI last_fail_seq
    Nga last_executions
    KU
        state IN ('failed', 'up_for_retry')
)
Zgjidhni
    task_id,
    dag_id,
    count(last_fail_seq)                       SI të pasuksesshme,
    count(Rasti Kur last_fail_seq
        DHE state = 'failed' ATËHERË 1 END)       SI dështuar,
    count(Rasti Kur last_fail_seq
        DHE state = 'up_for_retry' ATËHERË 1 END) SI up_for_retry
Nga failed
GRUPI NGA
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Linket
E natyrshme, dhjetë të parët lidhjet nga rezultatet e google janë përmbajtja e dosjes Airflow nga bookmark-at e mia.
- — sigurisht, duhet të filloni me dokumentacionin zyrtar, por kush lexon udhëzime?
- — së paku lexoni rekomandimet nga krijuesit.
- — fillimi: ndërfaqja e përdoruesit në imazhe
- — janë mirëshpjeguar konceptet bazë, nëse (në rast se!) nuk kuptoni ndonjë gjë nga unë.
- — një udhëzues i shkurtër për konfigurimin e klasterit Airflow.
- — një artikull pothuajse i ngjashëm, ndoshta me më shumë formalizëm, por më pak shembuj.
- — për punën në lidhje me Celery.
- — për idempotencën e detyrave, ngarkimin sipas ID-së në vend të datës, transformimet, strukturën e skedarëve dhe shumë gjëra interesante.
- — varësitë e detyrave dhe Rregulli i Aktivizimit, të cilin e përmenda vetëm kaq me përbuzje.
- — si të tejkaloni disa “funksionon ashtu siç duhet” në planifikues, të ngarkoni të dhëna të humbura dhe të renditni prioritetet e detyrave.
- — kërkesa të dobishme SQL për të dhënat e Airflow.
- — ka një seksion të dobishëm për krijimin e sensorëve të personalizuar.
- — një shënim interesant i shkurtër për ndërtimin e infrastrukturës në AWS për Shkencën e të Dhënave.
- — gabime të zakonshme (kur dikush megjithatë nuk lexon udhëzimet).
- — buzëqeshni, siç e bëjnë njerëzit ndihmesën në ruajtjen e fjalëkalimeve, ndërsa mund të përdorni thjesht Lidhjet.
- — përçimi i fshehtë i DAG, hedhja e kontekstit në funksion, përsëri për varësitë, dhe njëherësh për kalimin e ekzekutimeve të detyrave.
- — rreth përdorimit
argumenteve defaultdheparamsnë shabllone, si dhe për Variablat dhe Lidhjet. - — një tregim se si përgatitet planifikuesi për Airflow 2.0.
- — një artikull disi i vjetër për implementimin e klastri tonë në
docker-compose. - — detyra dinamike duke përdorur shabllone dhe përçim konteksti.
- — njoftime standarde dhe të personalizuara përmes email-it dhe Slack.
- — Degëzimet e detyrave, makros dhe XCom.
Dhe linket e përfshira në artikull:
- — vendosje të disponueshme për t'u përdorur në shabllone.
- — Gabime të zakonshme gjatë krijimit të DAG-eve.
- —
docker-composepër eksperimente, debug dhe jo vetëm. - — mbështetje Python për Telegram REST API.
Burimi: habr.com
