

Në vitin 2017, ne fituam një konkurs për zhvillimin e një bërthame transaksionale për biznesin e investimeve të Alfa-Bank dhe filluam punën (në HighLoad++ 2018 me një prezantim rreth bërthamës së biznesit të investimeve) Vladimir Drynkin, drejtori i drejtimit të bërthamës transaksionale të biznesit të investimeve të Alfa-Bank). Ky sistem duhet të agregojë të dhënat mbi transaksionet nga burime të ndryshme në formate të ndryshme, t’i sjellë të dhënat në një format të unifikuar, t’i ruajë ato dhe t’u sigurojë akses.
Gjatë zhvillimit, sistemi ka evoluar dhe është pasuruar me funksionalitete, dhe në një moment ne kuptuam që po formohej diçka shumë më e madhe se një software aplikativ që është krijuar për të zgjidhur një grup të caktuar problemi: kemi krijuar një sistem për ndërtimin e aplikacioneve të shpërndara me ruajtje persistenteEksperienca që fituam shërbeu si bazë për një produkt të ri — (TDG).
Dua të flas për arkitekturën e TDG dhe për ato zgjidhje që arritëm gjatë zhvillimit, t’ju njoh me funksionalitetin kryesor dhe të tregoj se si produkti ynë mund të bëhet baza për ndërtimin e zgjidhjeve përfundimtare.
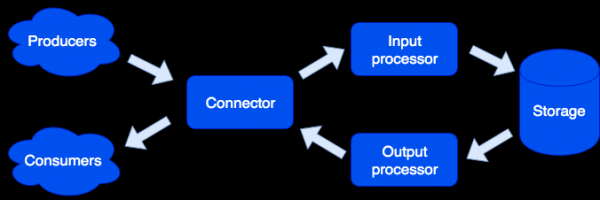
Arkitektonikisht ne e ndamë sistemin në pjesë të veçanta rollet, çdo njëra e cila është përgjegjëse për zgjidhjen e një grupi të caktuar problemi. Një instancë e aktivizuar e aplikacionit implementon një ose disa lloje rolesh. Në klaster mund të ketë disa rolet e një tipi:
Connector
Connectori është përgjegjës për lidhjen me botën e jashtme; detyra e tij është të pranojë kërkesën, ta analizojë atë dhe, nëse ka sukses, të dërgojë të dhënat për përpunim në input processor. Ne mbështesim formatet HTTP, SOAP, Kafka, FIX. Arkitektura lejon thjesht shtimin e mbështetjes për formate të reja, mbështetja për IBM MQ do të jetë në dispozicion së shpejti. Nëse analiza e kërkesës përfundon me ndonjë gabim, connectori do të kthejë një gabim; në rastin tjetër, do të përgjigjet se kërkesa është përpunuar me sukses, edhe nëse ndodhi ndonjë gabim gjatë përpunimit të mëtejshëm. Kjo është bërë në mënyrë specifike, për t'u punuar me sistemet që nuk dinë të përsërisin kërkesat — ose përkundrazi, e bëjnë këtë shumë ngulmërisht. Në mënyrë që të mos humbasim të dhëna, përdoret një rresht korrigjimi: objekti fillimisht kalon në këtë rresht dhe vetëm pas përpunimit të suksesshëm, hiqet prej tij. Administratori mund të marrë njoftime për objektet që janë lënë në rreshtin e korrigjimit dhe pas rregullimit të gabimeve programore ose harduerike, të përpiqet për herë të dytë.
Input processor
Input processor klasifikon të dhënat e marra sipas karakteristikave të tyre dhe thërret trajtuesit përkatës. Trajtuesit janë kod në gjuhën Lua, që запускаются в песочнице, kështu që ata nuk mund të ndikojnë në funksionimin e sistemit. Në këtë etapë, të dhënat mund të formohen në pamjen e dëshiruar dhe gjithashtu, nëse është e nevojshme, të fillohet një numër të arbitrueshëm të detyrave, të cilat mund të realizojnë logjikën e nevojshme. Për shembull, në produktin MDM (Menaxhimi i të Dhënave Master), i ndërtuar mbi Tarantool Data Grid, kur shtohet një përdorues i ri, për të mos ngadalësuar përpunimin e kërkesës, krijimi i një rekordi të artë fillohet si një detyrë e veçantë. SandBox mbështet kërkesat për lexim, ndryshim dhe shtim të të dhënave, dhe lejon kryerjen e disa funksioneve në të gjitha rolet e tipit storage dhe agregimin e rezultatit (map/reduce).
Trajtuesit mund të përshkruhen në skedarë:
sum.lua

local x, y = unpack(...)
return x + y
Dhe pastaj, të shpallura në konfigurim:
functions:
  sum: { __file: sum.lua }
Pse Lua? Lua është një gjuhë shumë e thjeshtë. Duke u bazuar në përvojën tonë, pas disa orësh të njohjes me të, njerëzit fillojnë të shkruajnë kod që zgjidh problemin e tyre. Dhe kjo nuk janë vetëm zhvilluesit profesionalë, por për shembull, analistët. Për më tepër, për shkak të jit-kompilatorit, Lua punon shumë shpejt.
Storage
Storage ruan të dhënat e qëndrueshme. Para ruajtjes, të dhënat kalojnë verifikimin për t'u siguruar që i përgjigjen skemës së të dhënave. Për të përshkruar skemën përdorim një format të zgjeruar. . Shembull:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Nga kjo përshkrim automatikisht gjenerohet DDL (Data Definition Language) për DBMS Tarantool dhe skema për qasje në të dhëna.
Përkrahja e replikimit asinkron të të dhënave (në planet është shtimi i asinkronit).
Output processor
Herë pas here nevojitet njoftimi i konsumatorëve të jashtëm për mbërritjen e të dhënave të reja, për këtë ekziston roli i Output processor. Pas ruajtjes së të dhënave, ato mund të dërgohen në përpunuesin përkatës (për shembull, për t'i sjellë ato në formatin që kërkon konsumatori) — dhe pas kësaj dërgohen në connector për dërgim. Këtu përdoret gjithashtu një radhë riparimi: nëse objekti nuk është pranuar nga askush, administratori mund të provojë përsëri më vonë.
Zgjerimi
Rollet e connector, input processor dhe output processor nuk kanë gjendje, gjë që na lejon të shkallëzojmë sistemin horizontalisht, duke shtuar thjesht shembuj të rinj të aplikacionit me rolin e tipit të nevojshëm. Për shkallëzim horizontal, storage përdor e organizimit të klasterit duke përdorur bucket-a virtuale. Pas shtimit të një serveri të ri, një pjesë e bucket-ave nga serverët e vjetër kalon në mënyrë të sfonduar te serveri i ri; kjo ndodh në mënyrë transparente për përdoruesit dhe nuk ndikon në funksionimin e sistemit të tërë.
Vetitë e të dhënave
Objektet mund të jenë shumë të mëdha dhe të përmbajnë objekte të tjera. Ne sigurojmë atomizmin e shtimit dhe përditësimit të të dhënave, duke ruajtur objektin me të gjitha varësitë në një bucket virtual. Kështu përjashtohet "shpërndarja" e objektit në shumë servera fizikë.
Versionimi mbështetet: çdo përditësim i objektit krijon një version të ri, dhe ne gjithmonë mund të bëjmë një prirje të përkohshme dhe të shohim si dukej bota atëherë. Për të dhënat që nuk kërkojnë një histori të gjatë, ne mund të kufizojmë numrin e versioneve ose madje të ruajmë vetëm një - të fundit, që do të thotë se në fakt fikim versionimin për një lloj të caktuar. Gjithashtu, është e mundur të kufizohet historia me kohë: për shembull, të fshihen të gjitha objektet e një lloji më të vjetër se 1 vit. Mbështetet edhe arkivimi: ne mund të shkarkojmë objektet që janë më të vjetra se koha e caktuar, duke liruar hapësirë në klaster.
Detyrat
Nga veçoritë interesante, vlen të përmendet mundësia e ekzekutimit të detyrave në një orar, në kërkesë të përdoruesit, ose programatisht nga sandbox:
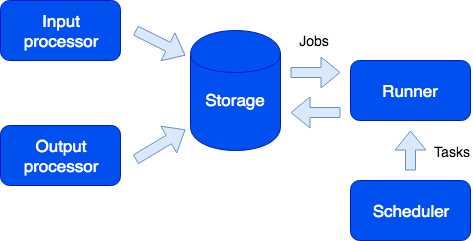
Këtu shohim një rol tjetër - runner. Ky rol nuk ka gjendje, dhe nëse është e nevojshme, mund të shtohen instanca shtesë të aplikacionit me këtë rol në klaster. Përgjegjësia e runner është ekzekutimi i detyrave. Siç është thënë, nga sandbox është e mundur të krijohen detyra të reja; ato ruhen në radhë në storage dhe më pas ekzekutohen në runner. Ky tip detyrash quhet Job. Gjithashtu kemi një tip detyrash të quajtur Task - këto janë detyra të përcaktuara nga përdoruesi dhe ekzekutohen sipas një orari (përdoret sintaksa cron) ose sipas kërkesës. Për të ekzekutuar dhe ndjekur këto detyra, kemi një menaxher të përshtatshëm të detyrave. Për të bërë këtë funksionalitet të disponueshëm, është e nevojshme të aktivizohet roli scheduler; ky rol ka gjendje, prandaj nuk është shkallëzues, megjithatë kjo nuk kërkohet; ai, si të gjitha rolet e tjera, mund të ketë një replike që fillon të funksionojë, nëse master-i papritur dështon.
Logger
Një rol tjetër i quajtur logger. Ai mbledh logjet nga të gjitha anëtarët e klasterit dhe ofron një ndërfaqe për shkarkimin dhe shikimin e tyre përmes ndërfaqes në ueb.
Shërbimet
Vlen të përmendet se sistemi lejon krijimin e lehtë të shërbimeve. Në skedarin e konfigurimit, mund të specifikoni se cilat kërkesa t'i dërgoni në trajtuesin e shkruar nga përdoruesi, i cili ekzekutohet në sandbox. Në këtë trajtues, mund, për shembull, të ekzekutoni ndonjë kërkesë analitike dhe të ktheni rezultatin.
Shërbimi përshkruhet në skedarin e konfigurimit:
services:
   sum:
      doc: "shton dy numra"
      function: sum
      return_type: int
      args:
         x: int
         y: int
API GraphQL krijohet automatikisht dhe shërbimi bëhet i disponueshëm për thirrje:
query {
   sum(x: 1, y: 2)
}
Kjo do të çojë në thirrjen e trajtuesit sum, i cili do të kthejë rezultatin:
3
Profilizimi i kërkesave dhe metrikat
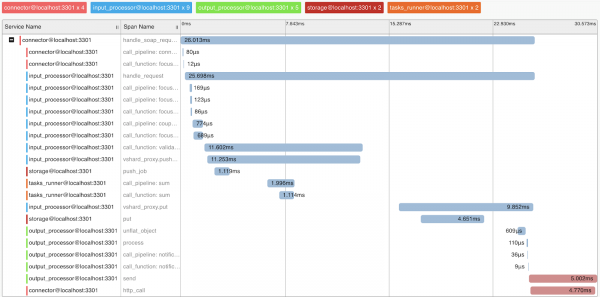
Për të kuptuar funksionimin e sistemit dhe për të profilizuar kërkesat, kemi implementuar mbështetje për protokollin OpenTracing. Sistemi mund të dërgojë informacion mbi kërkesat në veglat që mbështesin këtë protokoll, si Zipkin, duke i ndihmuar të kuptoni se si u ekzekutua kërkesa:
Natyrisht, sistemi ofron metrika të brendshme, të cilat mund të mblidhen me ndihmën e Prometheus dhe të vizualizohen me Grafana.
Deploy
Tarantool Data Grid mund të bëhet deploy nga RPM-paketat ose arkivat, me ndihmën e utilitarëve të dorëzuar ose Ansible, gjithashtu ka mbështetje për Kubernetes ().
Aplikacionet që implementojnë logjikën e biznesit (konfigurimi, trajtuesit) ngarkohen në klasterin e deponuar Tarantool Data Grid në formën e një arkivi përmes UI-së ose me një skenar, përmes API-së që ne ofrojmë.
Shembuj aplikacionesh
Cilat aplikacione mund të krijohen me ndihmën e Tarantool Data Grid? Në të vërtetë, shumica e detyrave të biznesit janë të lidhura me përpunimin e rrjedhës së të dhënave, ruajtjen dhe qasjen mbi to. Prandaj, nëse keni rrjedha të mëdha të të dhënash që duhen ruajtur me besueshmëri dhe për të pasur qasje në to, produkti ynë mund t'ju kursejë shumë kohë në zhvillim dhe t'ju lejojë të përqendroheni në logjikën tuaj të biznesit.
Për shembull, ne duam të mbledhim informacion rreth tregut të pasurive të paluajtshme, në mënyrë që më vonë, për shembull, të kemi informacion mbi ofertat më të volitshme. Në këtë rast, ne do të identifikojmë detyrat e mëposhtme:
- Robotët që mbledhin informacion nga burime të hapura do të jenë burimet tona të dhënash. Këtë detyrë e ndihmoni duke përdorur zgjidhje të gatshme ose duke shkruar kod në çdo gjuhë.
- Më pas, Tarantool Data Grid do të marrë dhe ruajë të dhënat. Nëse formati i të dhënave nga burime të ndryshme ndryshon, mund të shkruani kod në gjuhën Lua që do të realizojë përshtatjen në formatin e njëjtë. Gjatë fazës së përpunimit paraprak, gjithashtu mund të filtroni ofertat e përsëritura ose të përditësoni në bazën e të dhënave informacionin mbi agjentët që veprojnë në treg.
- Tani tashmë keni një zgjidhje të shkallëzueshme në kluster, të cilën mund ta mbushni me të dhëna dhe të bëni kërkesa për të dhëna. Më tej, ju mund të implementoni funksionalitete të reja, siç është shkruani një shërbim që do të bëjë një kërkesë për të dhënat dhe do të japë ofertën më të favorshme për 24 orë — kjo do të kërkojë disa rreshta në skedarin e konfigurimit dhe pak kod në Lua.
Çfarë ndodh më tej?
Prioriteti ynë është rritja e lehtësisë së zhvillimit përmes . Për shembull, kjo është një IDE me mbështetje për profilizimin dhe debugimin e trajtuesve që punojnë në një ambient të mbyllur.
Gjithashtu, ne i kushtojmë shumë vëmendje çështjeve të sigurisë. Aktualisht jemi duke kaluar për procesin e çertifikimit nga FSTEK i Rusisë, për të konfirmuar nivelin e lartë të sigurisë dhe për të përmbushur kërkesat e paraqitura për çertifikimin e produkteve softuerike që përdoren në sistemet informative të të dhënave personale dhe sistemet informative shtetërore.
Burimi: habr.com
