

Përshëndetje të gjithëve. Unë punoj si administrator sistemesh në OK dhe jam përgjegjës për funksionimin e qëndrueshëm të portalit. Dua të flas për mënyrën si e ndërtuam procesin e automatizuar të zëvendësimit të disqeve, dhe pastaj si e përjashtuam administratorin nga ky proces dhe e zëvendësuam atë me një bot.
Ky artikull është një lloj transliterimi në HighLoad+ 2018
Ndërtimi i procesit të zëvendësimit të disqeve
Së pari disa numra
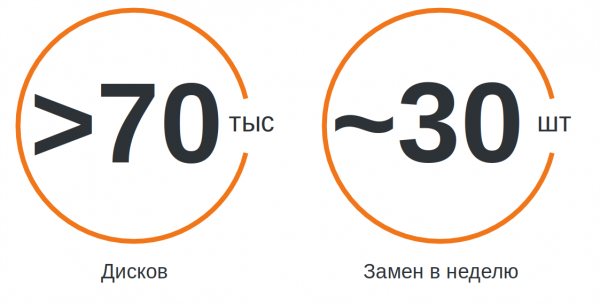
OK është një shërbim gjigant që përdoret nga miliona njerëz. Ajo shërbehet nga rreth 7,000 servera, të cilët ndodhen në 4 data center të ndryshëm. Në servera ka më shumë se 70,000 disqe. Nëse i vendosim njëri mbi tjetrin, do të kemi një kullë me lartësi më shumë se 1 km.
Disqet e forta janë komponenti i serverit që dështojnë më shpesh. Me këto volume, na duhet të zëvendësojmë rreth 30 disqe në javë, dhe kjo procedurë është bërë një rutinë që nuk është shumë e këndshme.
Incidente
Në kompaninë tonë kemi një menaxhim të plotë të incidenteve. Çdo incident e regjistrojmë në Jira, dhe pastaj e zgjidhim dhe e shqyrtojmë. Nëse incidenti kishte një efekt për përdoruesit, ne domosdoshmërish mblidhemi dhe mendojmë se si të reagojmë më shpejt në raste të tilla, si të ulin efektin dhe sigurisht si të parandalojmë përsëritjen.
Këto disqe nuk janë përjashtim. Shtypjet e tyre monitorohen nga Zabbix. Ne monitorojmë mesazhet në Syslog për gabime në shkrim/lexim, analizojmë gjendjen e HW/SW-raid, dhe mbajmë nën kontroll SMART-in, për SSD llogarisim konsumimin.
Si ishin disqet më parë
Kur në Zabbix aktivizohet ndonjë tregues, ndodhet një incident në Jira dhe automatikisht i caktohet inxhinierëve të përshtatshëm në data center. Ne e bëjmë këtë për të gjitha incidentet HW, që do të thotë ato që kërkojnë ndonjë punë fizike me pajisjet në data center.
Inxhinieri i data centerit është ajo që zgjidh problemet e lidhura me harduerin, është përgjegjës për instalimin, mirëmbajtjen dhe heqjen e serverave. Pasi të marrë biletën, inxhinieri fillon punën. Në raftet e disqeve ai i zëvendëson disqet vetë. Por nëse nuk ka akses te pajisja e nevojshme, inxhinieri kërkon ndihmë nga administratorët e sistemit të shërbimit. Së pari, duhet të përjashtohet disku nga rotacioni. Për këtë, nevojiten ndryshimet e nevojshme në server, të ndalen aplikacionet, dhe të shkëputet disku.
Administrator i sistemit mund të mbajë këtë portal gjatë orarit të punës. Ai heton incidentet, merret me riparimin dhe ndihmon zhvilluesit të përfundojnë detyra të vogla. Ai nuk merret vetëm me disqet e forta.
Më parë, inxhinierët e qendrës së të dhënave komunikonin me administratorin e sistemit në biseda. Inxhinierët dërgonin lidhje të biletimeve në Jira, dhe administratori i shihte ato, duke mbajtur një log të punëve në një shënim. Por për detyra të tilla bisedat ishin të pakëndshme: informacioni aty nuk ishte i strukturuar dhe humbte shpejt. Për më tepër, administrator mund të kishte shkëputur punën për një kohë dhe të mos përgjigjej, ndërsa inxhinieri priste përpara serverit me një grumbull disqesh.
Por ajo që ishte më e keqja ishte se administratorët nuk e shihnin panoramën e plotë: çfarë incidenteve ekzistojnë me disqet dhe ku mund të shfaqeshin probleme. Kjo ndodhte sepse ne i jepnim të gjitha incidente HW inxhinierëve. Po, ishte e mundur të shfaqeshin të gjitha incidentet në panelin e administratorit. Por ato ishin shumë, dhe administratorët angazhoheshin vetëm për disa prej tyre.
Për më tepër, inxhinieri nuk mund të rendiste saktë prioritete, sepse ai nuk dinte asgjë për qëllimin e serverëve të veçantë, për renditjen e informacionit në drives.
Procedura e re e zëvendësimit
E para që bëmë ishte të nxirrnim të gjitha incidentet e disqeve në një lloj të veçantë "HW-disk" dhe të shtonim fushat "emri i pajisjes bllokuese", "mënyra" dhe "tipi i disqit", në mënyrë që kjo informacion të ruhej në biletë dhe të mos ishte e nevojshme ta ndanim vazhdimisht në biseda.
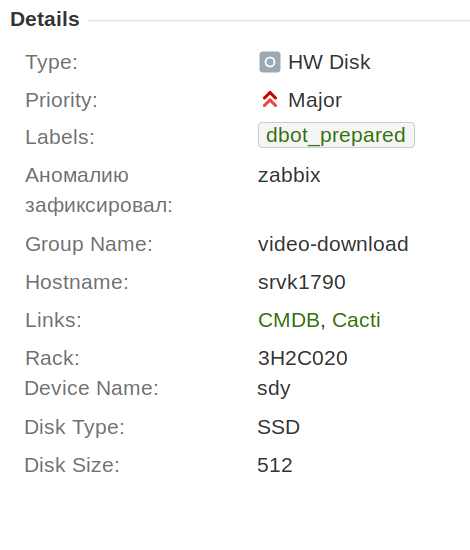
Gjithashtu, u dakorduam që brenda një incidenti do të zëvendësonim vetëm një disk. Kjo e thjeshtoi ndjeshëm më pas procesin e automatizimit, mbledhjen e statistikave dhe punën.
Përveç kësaj, kemi shtuar fushën "administrator përgjegjës". Aty vendoset automatikisht administratori i detyrës. Kjo është shumë e dobishme, sepse tani inxhinieri gjithmonë e sheh kush është përgjegjës. Nuk është e nevojshme të shikosh në kalendar dhe të kërkosh. Ky fushë saktësisht lejoj që të renditen në panelin e administratorit biletat, për të cilat ndoshta do të nevojitet ndihma e tij.
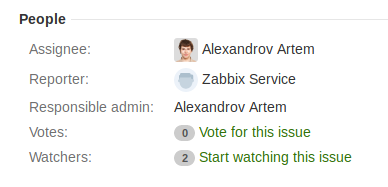
Për të siguruar që të gjithë pjesëmarrësit të përfitojnë sa më shumë nga ndryshimet, ne krijuam filtrat dhe panelin e kontrollit, duke i informuar ata për to. Kur njerëzit kuptojnë ndryshimet, ata nuk distancohen nga to si nga diçka të panevojshme. Është e rëndësishme për inxhinierët të dinë numrin e raftit ku ndodhet serveri, madhësinë dhe llojin e disku. Për administratorin, fillimisht, është e rëndësishme të kuptojë se çfarë grupi serverësh po trajtohet dhe çfarë efekti mund të ketë zëvendësimi i diskut.
Prania e fushave dhe shfaqja e tyre është e këndshme, por nuk na ka shpëtuar nga nevoja për të përdorur biseda. Për këtë, duhej të ndryshonim procesin e punës.
Më parë, ai ishte kështu:
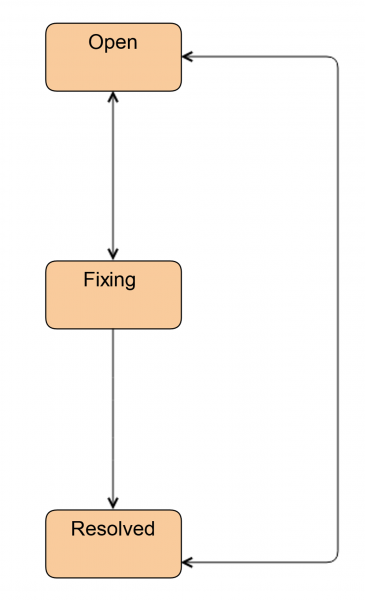
Sot inxhinierët punojnë kështu kur nuk kërkojnë ndihmën e administratorit.
E para që bëmë ishte të regjistronim statusin e ri Investigate. Ky status është përbërëzohet kur inxhinieri ende nuk e ka vendosur nëse do të ketë nevojë për administratorin apo jo. Përmes këtij statusi, inxhinieri mund t'i kalojë tiketën administratorit. Për më tepër, me këtë status ne e etiketojmë tiketën kur kërkohet zëvendësimi i diskut, por disku i kërkuar nuk është në vend. Kjo ndodh në rastet e CDN dhe vendeve të largëta.
Gjithashtu, ne shtuam statusin Gati. Tiketa kalon në këtë status pas zëvendësimit të diskut. Kjo do të thotë se gjithçka është bërë, por në server po sinkronizohet HW/SW RAID. Kjo mund të zgjasë mjaft kohë.
Nëse administratorët angazhohen në punë, skema paksa komplikohet.
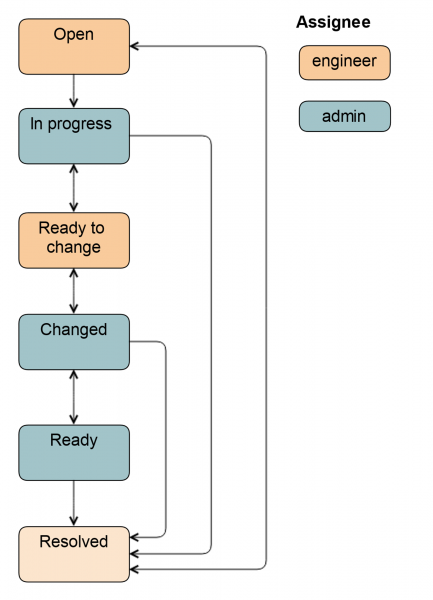
Nga statusi Hapur tiketa mund të kalojë si nga administratori sistemit ashtu edhe nga inxhinieri. Në statusin In progress administratori e nxjerr diskun nga rotacioni, në mënyrë që inxhinieri ta nxjerrë thjesht: aktivizon ndriçimin, e çmonton diskun, ndalon aplikacionet, në varësi të grupit të caktuar të serverëve.
Pastaj, tiketën e kalojmë në Ready to change: ky është një sinjal për inxhinierin se disku mund të nxirret. Të gjitha fushat në Jira janë plotësuar tashmë, inxhinieri e di se çfarë lloji dhe madhësie disku është. Këto të dhëna vendosen ose automatikisht në statusin e mëparshëm ose nga administratori.
Pas zëvendësimit të diskut, tiketa kalon në statusin Changed. Kontrollohet që disku i duhur është vendosur, bëhet formatimi, aktivizohet aplikacioni dhe disa detyra për rikuperimin e të dhënave. Gjithashtu, tiketa mund të kalojë në statusin Gati, në këtë rast përgjegjës do të mbetet administratori, sepse ai e kishte futur diskun në rotacion. Schemi i plotë duket kështu.
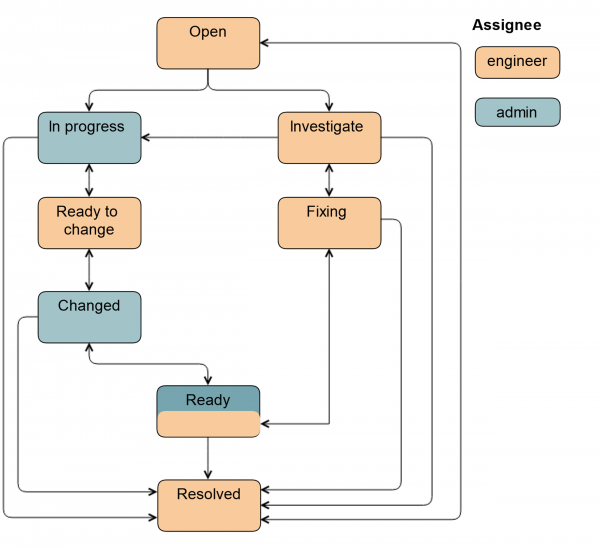
Shtimi i fushave të reja na ka lehtësuar ndjeshëm jetën. Djemtë filluan të punojnë me informacion të strukturuar, dhe tani është e qartë se çfarë duhet bërë dhe në cilën fazë. Prioritetet tani janë shumë më relevante, pasi tani ato caktohen nga administratorët.
Nuk ka më nevojë për biseda. Sigurisht, administratori mund t'i shkruajë inxhinierit 'këtë duhet ta zëvendësosh më shpejt', ose 'është mbrëmje, do të arrish të zëvendësosh?'. Por tashmë nuk komunikojmë çdo ditë në biseda rreth këtyre çështjeve.
Diskët tani ndërrohen me grupime. Nëse administratori vjen pak më herët në punë, ka kohë të lirë dhe asgjë nuk ka ndodhur, ai mund të përgatitë disa serverë për zëvendësim: të caktojë fushat, të nxjerrë diskët nga rotacioni dhe t'ia kalojë detyrën inxhinierit. Inxhinieri vjen pak më vonë në qendrën e të dhënave, sheh detyrën, merr nga depo diskët e nevojshëm dhe menjëherë i ndërron. Si rezultat, shpejtësia e ndërrimit është rritur.
Eksperienca e nxjerrë nga ndërtimi i Workflow.
- Kur ndërtoni procedurën, duhet të mbledhni informacion nga burime të ndryshme.
Disa nga administratoret tanë nuk e dinin se inxhinieri ndërron diskët vetë. Disa mendonin se inxhinierët mbikëqyrin sinkronizimin e MD RAID, përderisa disa prej tyre as nuk kishin akses për këtë. Disa inxhinierë kryesorë e bënin këtë, por jo gjithmonë, sepse procesi nuk ishte i përshkruar asnjëherë. - Procedura duhet të jetë e thjeshtë dhe e kuptueshme.
Njerëzit e kanë të vështirë të mbajnë në mend shumë hapa. Statuset më të rëndësishme ngjitur në Jira duhet të shfaqen në ekranin kryesor. Mund t'i rindërtoni, për shembull, 'In progress' ne e quajmë 'Ready to change'. Statuset e tjera mund të fshihen në një menu rënës, për të mos irrituar sytë. Por më mirë është të mos i kufizoni njerëzit, t'u jepni mundësinë për të bërë kalime.
Shpjegoni vlerën e novacioneve. Kur njerëzit kuptojnë, ata e pranojnë më mirë procedurën e re. Për ne ishte shumë e rëndësishme që njerëzit të mos klikojnë vazhdimisht në të gjithë procesin, por të ecin përmes tij. Më pas ndërtuam automatizimin mbi këtë. - Prit, analiza, kuptim.
Na nevojitëm rreth një muaji për të ndërtuar procedurën, realizimin teknik, takimet dhe diskutimet. Ndërsa për implementimin — më shumë se tri muaj. Kam parë se si njerëzit fillojnë ngadalë të përdorin novacionin. Në fazat e para kishte shumë negativitet. Por ai ishte krejtësisht i pavend në lidhje me procedurën vetë dhe realizimin e saj teknik. Për shembull, një administrator përdorte jo Jira, por një plugin të Jira në Confluence, dhe disa gjëra nuk ishin të arritshme për të. I treguam Jira-n, produktiviteti i administratorit u rrit si në detyrat e përgjithshme ashtu edhe në zëvendësimin e disqeve.
Automatizimi i zëvendësimit të disqeve
Ne iu afruam disa herë automatizimit të zëvendësimit të disqeve. Kishim tashmë disa përgatitje, skenarë, por të gjitha ato punonin ose në një mënyrë interaktive ose manuale, duke kërkuar aktivizimin. Dhe vetëm pas implementimit të procedurës së re kuptuam se saktësisht ajo na kishte munguar.
Tani që procesi i zëvendësimit është ndarë në etapa, me secilën etapë që ka një përfaqësues të caktuar dhe një listë veprimesh, mund të përfshijmë automatizimin gradualisht, e jo menjëherë në tërësi. Për shembull, etapa më e thjeshtë — Ready (kontrolli i sinkronizimit të RAID/ të dhënave) mund të delegohet lehtësisht te boti. Kur boti të mësojë pak, mund t'i jepet një detyrë më përgjegjëse — futja e disqeve në rotacion etj.
Zoologjia e konfigurimeve
Para se të flasim për botin, le të bëjmë një ekskursion të vogël në zoologjinë tonë të instalimeve. Së pari, kjo është e lidhur me përmasat gjigande të infrastrukturës tonë. Së dyti, për çdo shërbim ne përpiqemi të zgjedhim konfigurimin optimal të harduerit. Kemi rreth 20 modele të RAID-it harduerik, kryesisht LSI dhe Adaptec, por hasen edhe HP dhe DELL me versione të ndryshme. Çdo kontrollor RAID ka utilitarin e tij të menaxhimit. Grupi i komandave dhe rezultati nga ato mund të ndryshojnë nga versioni në version për çdo kontrollor RAID. Atje ku nuk përdoren RAID-harduerike, mund të përdoret mdraid.
Gati të gjitha instalimet e reja i bëjmë pa rezervimin e disqeve. Ne përpiqemi të shmangim përdorimin e RAID-it harduerik dhe softuerik, pasi rezervojmë sistemet tona në nivelin e qendrave të të dhënave dhe jo në ato të serverëve. Por natyrisht, ka shumë serverë legjacy që duhet të mbahen.
Në disa raste, disqet në kontrollorët RAID kalojnë si pajisje raw, ndonjëherë përdoren JBOD. Ka konfiguracione me një disk sistemik në server, dhe nëse ai duhet të zëvendësohet, nevojitet riciklimi i serverit me instalimin e sistemit operativ dhe aplikacioneve, duke përdorur versionet e njëjta, pastaj shtohen skedarët e konfigurimit dhe aplikacionet lançohet. Ka gjithashtu shumë grupe serverësh, ku rezervimi bëhet jo në nivelin e sistemit të diskëve, por direkt në aplikacionet vetë.
Në total, ne kemi mbi 400 grupe unike serverësh, në të cilët punojnë rreth 100 aplikacione të ndryshme. Për të përballuar një numër kaq të madh variantesh, na duhej një mjet shumëfunksional automatizimi. Preferueshëm me një DSL të thjeshtë, në mënyrë që ta mbështesë jo vetëm ai që e shkruajti.
Ne zgjodhëm Ansible, sepse ai është pa agjent: nuk ishte e nevojshme të përgatitemi infrastruktura, fillim i shpejtë. Për më tepër, ai është shkruar në Python, i cili është pranuar si standart në ekip.
Skema e përgjithshme
Le të shqyrtojmë skemën e përgjithshme të automatizimit përmes një incidenti. Zabbix detekton se disku sdb ka dështuar, ndizet një trigger, krijohet një tiket në Jira. Administratori e shqyrton atë, e kupton se nuk është një dublikatë dhe as një false positive, që do të thotë se disku duhet të zëvendësohet, dhe e kalon tiketën në In progress.
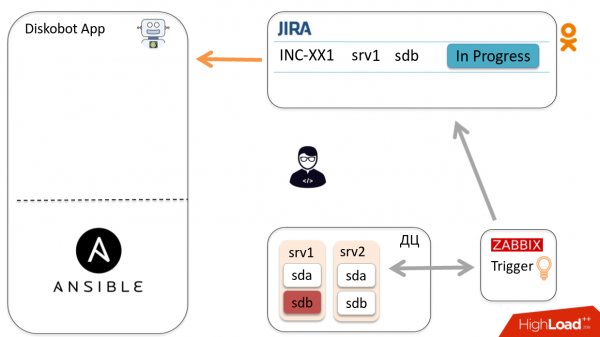
Aplikacioni DiskoBot, i shkruar në Python, pyet periodikisht Jira për tiket të reja. Ai vëren se ka një tiket të re In progress, aktivizohet thread-i përkatës, i cili nis playbook-un në Ansible (kjo bëhet për çdo status në Jira). Në këtë rast aktivizohet Prepare2change.
Ansible dërgohet në host, e nxjerr disku nga rotacioni dhe raporton statusin aplikacionit përmes Callbacks.
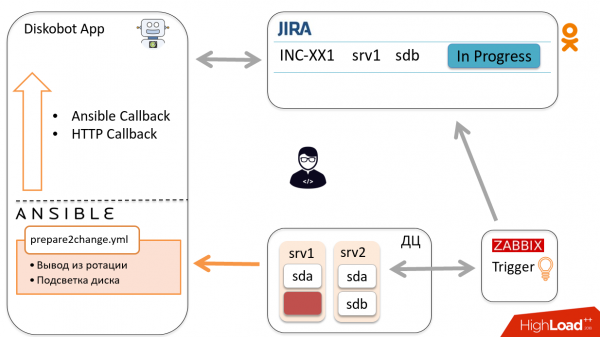
Përmes rezultateve, boti automatikisht e kalon tiketën në Ready to change. Inxhinieri merr një njoftim dhe shkon të ndryshojë disku, pas së cilës e kalon tiketën në Changed.
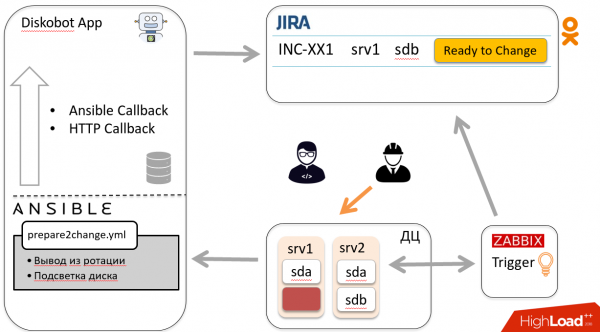
Sipas skemës së përshkruar më lart, tiketë kthehet përsëri te boti, ai aktivizon një playbook tjetër, shkon në host dhe e fut disku në rotacion. Boti e mbyll tiketën. Hurra!
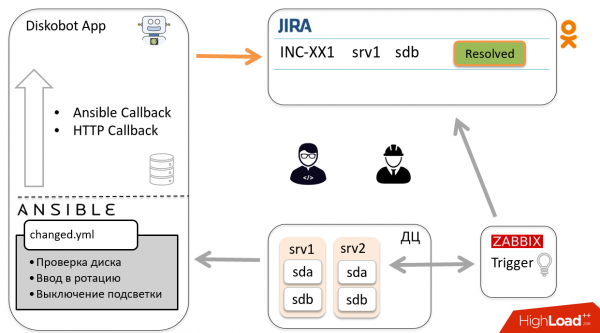
Tani le të flasim për disa përbërës të sistemit.
Diskobot
Ky aplikacion është shkruar në Python. Ai zgjedh tiketët nga Jira sipas JQL. Në varësi të statusit të tiketës, ajo kalon te procesori përkatës, i cili nga ana e tij nis playbook-un Ansible në përputhje me statusin.
JQL dhe intervalet e sondazhit janë përcaktuar në skedarin e konfigurimit të aplikacionit.
jira_states:
  investigate:
    jql: '… status = Open dhe "Disk Size" është EMPTY'
    interval: 180

  inprogress:
    jql: '…  dhe "Disk Size" nuk është EMPTY dhe "Device Name" nuk është EMPTY'

  ready:
    jql: '… dhe (labels not in ("dbot_ignore") ose labels është EMPTY)'
    interval: 7200
Për shembull, ndër tiket e statusit In progress, zgjidhen vetëm ato të cilat kanë të mbushura fushat Disk size dhe Device name. Device name është emri i pajisjes bllokuese që nevojitet për të realizuar playbook-in. Disk size është i nevojshëm që inxhinieri të dijë se sa i madh është disku i nevojshëm.
Ndërsa për tiket me statusin Ready, filtrohen tiket me etiketën dbot_ignore. Vlen të theksohet se etiketat Jira i përdorim si për filtrime të tilla, ashtu edhe për të shënuar dublikacionet e tiket-ve dhe për të mbledhur statistika.
Në rast të dështimit të playbook-it, Jira i jep etiketën dbot_failed, për të mundësuar zgjidhjen e mëvonshme.
Interaksioni me Ansible
Aplikacioni ndërvepron me Ansible përmes . Në playbook_executor ne transferojmë emrin e skedarit dhe një grup variablash. Kjo lejon që projekti Ansible të ruhet si skedarë të zakonshëm yml, dhe jo të përshkruhet në kodin Python.
Po ashtu në Ansible përmes *extra_vars* transferohen emri i pajisjes bllokuese, statusi i tiket-it, si dhe callback_url, i cili përmban çelësin e çështjes — ai përdoret për callback në HTTP.
Për çdo ekzekutim gjenerohet një inventory përkohshëm, që përbëhet nga një host dhe një grup, në të cilin bën pjesë ky host, që të zbatohen group_vars.
Ja një shembull i një detyre, në të cilën është realizuar HTTP callback.
Ne marrim rezultatin e ekzekutimeve të playbook-eve përmes callback(-eve). Ato janë të dy llojeve:
- , ai ofron të dhëna mbi rezultatet e ekzekutimit të playbook-it. Atje përshkruhen detyrat që janë nisur, të realizuara me sukses ose jo. Ky callback thirret pas përfundimit të ekzekutimit të playbook-it.
- HTTP callback për të marrë informacion gjatë ekzekutimit të playbook-it. Në detyrën Ansible realizojmë një kërkesë POST/GED në drejtim të aplikacionit tonë.
Përmes HTTP callback(-eve) transferohen variablat, të cilat janë përcaktuar gjatë ekzekutimit të playbook-it dhe që dëshirojmë t'i ruajmë dhe përdorim në ekzekutimet e ardhshme. Këto të dhëna i shkruajmë në sqlite.
Po ashtu përmes HTTP callback ne lëmë komente dhe ndryshojmë statusin e tiket-it.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Si dhe shumë detyra të ngjashme, ne e kemi ndarë atë në një skedar të zakonshëm dhe e përfshijmë kur është e nevojshme, në mënyrë që të mos e përsërisim vazhdimisht në playbook. Këtu figuron callback_url, në të cilin janë të koduara çelësi i çështjes dhe emri i hostit. Kur Ansible ekzekuton këtë POST kërkesë, boti kupton se ka ardhur në kuadër të një incidenti të caktuar.
Ja një shembull nga playbook, në të cilin ne nxorrëm diskun nga pajisja MD:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Kjo detyrë e transferon bileten e Jira në statusin "Ready to change" dhe shton një koment. Gjithashtu, në variablin mdam_data ruhet lista e pajisjeve md, nga të cilat është hequr disku, dhe në parted_info – është dump-i i particionit nga parted.
Kur inxhinieri të vendosë një disk të ri, ne mund ta përdorim këtë variabël për të rikuperuar dump-in e particioneve, si dhe për ta regjistruar disku në ato pajisje md, nga të cilat është hequr.
Ansible check mode
Ta fillosh automatizimin ishte e frikshme. Prandaj ne vendosëm të ekzekutojmë të gjithë playbookët në modalitetin
, në të cilin Ansible nuk kryen ndonjë veprim në serverë, por vetëm i imiton ato.
Ky përfundim ekzekutohet përmes një moduli të veçantë callback, dhe rezultati i ekzekutimit të playbook-it ruhet në Jira si një koment.
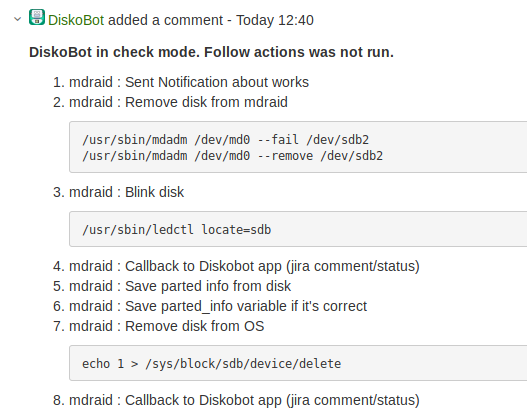
Së pari, kjo lejon të validosh punën e botit dhe playbook-ëve. Së dyti, rriti besimin e administratorëve ndaj botit.
Pasi kaluam validimin dhe kuptuam se mund të ekzekutonim Ansible jo vetëm në modalitetin dry run, ne krijuam në Jira butonin Run Diskobot për të ekzekutuar të njëjtin playbook me të njëjtat variabla në të njëjtin host, por në modalitetin normal.
Për më tepër, butoni përdoret për ekzekutimin e përsëritur të playbook-ut në rast se dështon.
Struktura e Playbooks
Kam përmendur se, në varësi të statusit të tiketës në Jira, boti ekzekuton playbook të ndryshme.
Së pari, kështu është shumë më e lehtë të organizosh hyrjen.
Së dyti, në disa raste kjo është thjesht e nevojshme.
Për shembull, gjatë zëvendësimit të diskut sistemor duhet fillimisht të shkojmë në sistemin e dispeçimit, të krijojmë një detyrë, dhe pas zbatimit të saktë të dispeçimit, serveri do të jetë i disponueshëm për ssh, dhe mund të vendosim aplikacionin mbi të. Nëse do të bënim të gjitha këto në një playbook, Ansible nuk do të ishte në gjendje ta ekzekutonte atë për shkak të papërshtatshmërisë së hostit.
Ne përdorim roli të Ansible për çdo grup serverësh. Këtu shihet se si janë organizuar playbookët në një prej tyre.
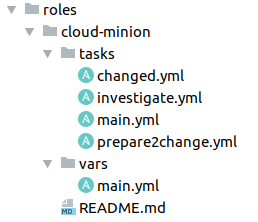
Kjo është e përshtatshme, sepse menjëherë kuptohet se ku ndodhen caktimet. Në main.yml, i cili është hyrja për rolin Ansible, mund të kemi thjesht një përfshirje sipas statusit të tiketës ose caktime të përbashkëta që janë të nevojshme për të gjithë, për shembull, kalimi i identifikimit ose marrja e tokenit.
Investigation.yml
Fillon për tiketët në statusin Investigation dhe Open. Më e rëndësishmja për këtë playbook është emri i pajisjes bllokuese. Kjo informacion nuk është gjithmonë e disponueshme.
Për ta marrë këtë informacion, analizojmë përmbledhjen e Jira, vlerësimin përfundimtar nga trigeri i Zabbix. Aty mund të jetë emri i pajisjes bllokuese — e kemi fatin. Mund të jetë gjithashtu një pikë montimi, — atëherë duhet të shkojmë në server, të analizojmë dhe llogarisim diskun e nevojshëm. Po ashtu, trigeri mund të transmetojë adresën scsi ose ndonjë informacion tjetër. Por ndodh edhe kështu, që nuk ka asnjë gjurmë, dhe duhet të analizojmë.
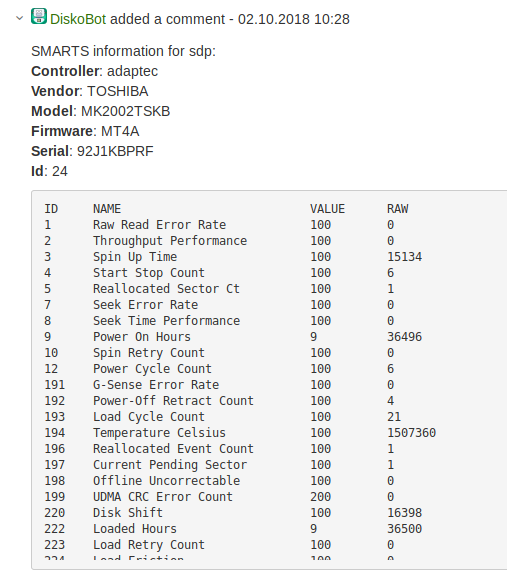
Pasi të kemi zbuluar emrin e pajisjes bllokuese, mbledhim informacion rreth tipit dhe madhësisë së diskut për të plotësuar fushat në Jira. Po ashtu, marrim informacion mbi prodhuesin, modelin, firmware, ID-në, SMART, dhe gjithçka e futim në koment në tiketën e Jira. Administratorit dhe inxhinierit tani nuk u nevojitet të kërkojnë këto të dhëna. 🙂
prepare2change.yml
Tërheqja e diskut nga rotacioni, përgatitja për zëvendësim. Faza më e vështirë, përgjegjëse. Pikërisht këtu mund të ndalni aplikacionin, kur nuk mund të ndalet. Ose të nxirrni diskun, i cili kishte mungesa kopjash, duke ndikuar kështu te përdoruesit, duke humbur ndonjë të dhënë. Këtu kemi më shumë kontrole dhe njoftime në bisedë.
Në rastin më të thjeshtë, është fjala për heqjen e diskut nga HW/MD RAID.
Në situata më të komplikuara (në sistemet tona të ruajtjes), kur rezervimi bëhet në nivel aplikacioni, është e nevojshme të shkojmë në aplikacion përmes API, të njoftojmë për heqjen e diskut, ta deaktivizojmë atë dhe të fillojmë rikuperimin.
Ne tani po migrojmë masivisht në , dhe nëse serveri është në re, atëherë Diskobot i drejtohet API-së së re, i thotë se do të punojë me këtë minion — serverin ku janë aktivizuar kontejnerët — dhe kërkon "migro të gjitha kontejnerët nga ky minion". Dhe për më tepër, aktivizon ndriçimin e diskut, që inxhinieri të shohë menjëherë se cili duhet të nxirret.
changed.yml
Pas zëvendësimit të diskut, në radhë të parë verifikojmë disponueshmërinë e tij.
Inxhinierët nuk i vendosin gjithmonë disqet e reja, prandaj kemi shtuar një kontroll të vlerave SMART që na përmbushin.
Cilat janë atributet që shqyrtojmëNumri i Sektorëve të Rialokuar (5) < 100
Numri i Sektorëve në Prishti Aktual (107) == 0
Nëse disku nuk kalon kontrollin, inxhinieri njoftohet për një zëvendësim të përsëritur. Nëse gjithçka është në rregull, ndriçimi është i fikur, shënohet dhe disku futet në rotacion.
ready.yml
Rasti më i thjeshtë: kontrolli i sinkronizimit HW/SW raid ose përfundimi i sinkronizimit të të dhënave në aplikacion.
API e aplikacioneve
Kam përmendur disa herë se shpesh boti i qaset API e aplikacioneve. Sigurisht, jo të gjitha aplikacionet kishin metodat e nevojshme, prandaj duhej t'i rregulloja ato. Këtu janë metodat më të rëndësishme që përdorim:
- Status. Statusi i klasterit ose disku për të kuptuar nëse mund të punojmë me të;
- Start/stop. Aktivizimi-deaktivimi i diskut;
- Migrate/restore. Migrimi dhe rikthimi i të dhënave gjatë dhe pas zëvendësimit.
Eksperienca e nxjerrë nga Ansible
Më pëlqen shumë Ansible. Por shpesh, kur shoh në projekte të ndryshme opon-source dhe shoh si shkruajnë playbook, më duket pak e frikshme. Kërkesat logjike komplekse nga when/loop, mungesa e fleksibilitetit dhe idempotencës për shkak të përdorimit të shpeshtë të shell/command.
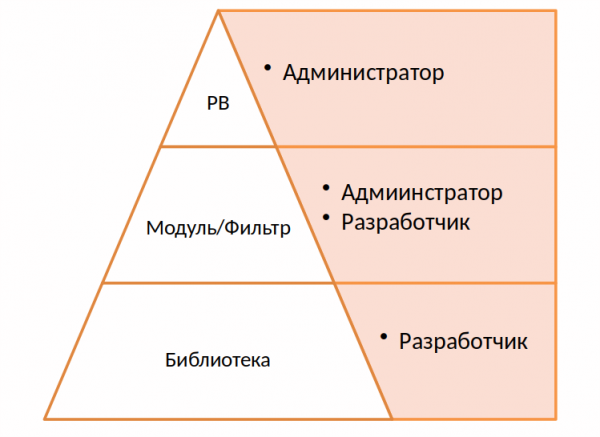
Ne e kemi vendosur ta thjeshtojmë gjithçka, duke shfrytëzuar avantazhin e Ansible - modularitetin. Në nivelin më të lartë janë playbook, që mund t'i shkruajë çdo administrator, zhvillues i jashtëm, i cili di pak për Ansible.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Nëse ndonjë logjikë është e vështirë të realizohet në playbook, e nxjerrim atë në modulin ose filtrin e Ansible. Skriptet mund të shkruhen si në Python, ashtu edhe në çdo gjuhë tjetër.
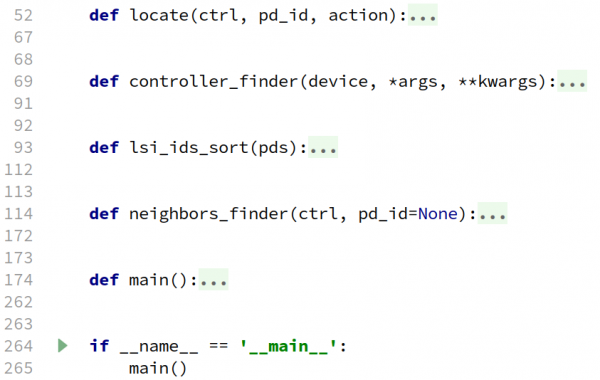
Ata janë të lehtë dhe të shpejtë për t'u shkruar. Për shembull, moduli i ndriçimit të diskut, shembulli i përdorimit të të cilit është dhënë më lart, përbëhet nga 265 rreshta.
Në nivelin më të ulët është biblioteka. Për këtë projekt ne shkruam një aplikacion të veçantë, një lloj abstarctions mbi RAID-të harduerike dhe sofuerike, të cilat kryejnë kërkesat përkatëse.
Pikat më të forta të Ansible janë thjeshtësia dhe playbook-të e kuptueshme. Unë mendoj se duhet të përfitojmë prej saj dhe të mos gjenerojmë skedarë të tmerrshëm YAML dhe një numër të madh kushtesh, kodesh shell dhe loops.
Nëse dëshironi të përsërisni përvojën tonë me Ansible API, mbani parasysh dy gjëra:
- Me playbook_executor dhe playbook nuk mund të kalojmë një timeout. Ka një timeout për sesionet ssh, por nuk ka një timeout për playbook. Nëse përpiqemi të ndalojmë një disk që nuk ekziston më në sistem, playbook do të ekzekutohet pafundësisht, prandaj ishte e nevojshme ta vendosim fillimin e tij në një wrapper të veçantë dhe ta ndalim sipas timeout-it.
- Ansible funksionon mbi baza fork-procesesh, kështu që API-ja e tij nuk është e sigurt për rrjedha. Ne fillojmë të gjitha playbook-et tona njërrugës.
Si rezultat, arritëm të automatizojmë zëvendësimin e rreth 80% të disqeve. Në përgjithësi, shpejtësia e zëvendësimit u dyfishua. Sot, administratori thjesht shikon incidentin dhe merr vendimin nëse duhet të ndryshohet disku apo jo, dhe pastaj bën një klik.
Por tani po fillojmë të përballemi me një problem tjetër: disa administratori të rinj nuk dinë se si të ndrojnë disqet. 🙂
Burimi: habr.com
