

Si mund të shndërrohen kërkesat e biznesit në struktura konkrete të të dhënave, duke marrë si shembull projektimin «nga e para» të një baze të dhënash për një mesazher.
- Pjesa 1: projektojmë skeletin e bazës
Baza jonë nuk do të jetë aq e madhe dhe e shpërndarë, ose , por mjaftueshëm e mirë — funksionale, e shpejtë dhe që të funksionojë në një server të vetëm PostgreSQL — që, për shembull, të mund të vendoset një instancë e veçuar e shërbimit diku nga pala tjetër.
Prandaj nuk do të trajtojmë çështjet e sharding, replikimit dhe sistemeve të shpërndara gjeografikisht, por do të përqendrohemi te zgjidhjet skematike brenda DB.
Hapi 1: Pak specifikë biznesi
Sistemin tonë të mesazheve nuk do ta projektojmë në mënyrë abstrakte, por do ta integrojmë në mjedisin e një . Kjo do të thotë se njerëzit te ne nuk «thjesht shkëmbejnë mesazhe», por komunikojnë mes tyre në kontekstin e zgjidhjes së detyrave të caktuara të biznesit.
Po çfarë lloj detyrash ka biznesi?.. Le ta shohim në shembullin e Vasilit — drejtues i departamentit të zhvillimit.
- «Nikolai, për këtë detyrë patch-i duhet që sot!»
Kjo do të thotë se korrespondenca mund të zhvillohet në kontekstin e një dokumenti. - «Kolja, a luajmë DotA në mbrëmje?»
Pra, edhe mes të njëjtit çift bashkëbiseduesish komunikimi mund të zhvillohet njëkohësisht mbi tema të ndryshme. - «Pjetr, Nikolai, shikoni në attachment listën e çmimeve për serverin e ri.»
Pra, një mesazh mund të ketë disa marrës. Ndërkohë, mesazhi mund të përmbajë skedarë të bashkëngjitur. - «Semjon, hidhi edhe ti një sy.»
Dhe duhet të ekzistojë mundësia që në një korrespondencë tashmë ekzistuese të ftohet një pjesëmarrës i ri.
Le të ndalemi për momentin te kjo listë nevojash «të qarta».
Pa kuptuar specifikën praktike të detyrës dhe kufizimet që ajo vendos, të projektohet një efikase skemë DB për zgjidhjen e saj është praktikisht e pamundur.
Hapi 2: Skema minimale logjike
Në aspektin skematik, për momentin gjithçka ngjan shumë me korrespondencën email — një mjet tradicional për zhvillimin e biznesit. Po, në aspektin «algoritmik» shumë detyra biznesi i ngjajnë njëra-tjetrës, prandaj edhe mjetet për zgjidhjen e tyre do të kenë strukturë të ngjashme.
Le të fiksojmë skemën logjike të marrëdhënieve mes entiteteve që kemi marrë deri tani. Për ta bërë modelin tonë më të lehtë për t’u kuptuar, do të përdorim variantin më të thjeshtë të paraqitjes së një pa ndërlikime me notacionet UML ose IDEF:
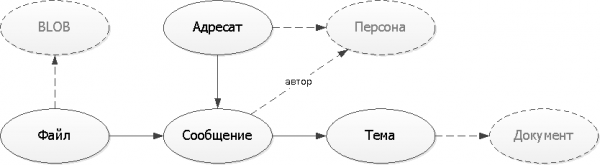
Në shembullin tonë, personi, dokumenti dhe “trupi” binar i skedarit janë entitete “të jashtme” që ekzistojnë më vete edhe pa shërbimin tonë. Prandaj, më tej do t’i trajtojmë thjesht si disa referenca “diku” sipas UUID.
Vizatojini skemat sa më thjesht të jetë e mundur — shumica e atyre që do t’ua tregoni nuk janë ekspertë në leximin e UML/IDEF. Por vizatojini patjetër.
Hapi 3: Skicojmë strukturën e tabelave
Për emrat e tabelave dhe fushaveMund të kesh qëndrime të ndryshme ndaj emrave “rusë” të fushave dhe tabelave, por kjo është çështje shijeje. Meqë nuk ka zhvillues të huaj, ndërsa PostgreSQL na lejon t’u japim emra qoftë edhe me hieroglife, nëse ato vendosen në thonjëza, ne preferojmë t’i emërtojmë objektet qartë dhe pa mëdyshje, që të mos ketë interpretime të ndryshme.
Meqenëse mesazhet te ne i shkruajnë shumë njerëz njëkohësisht, disa prej tyre madje mund ta bëjnë këtë në regjim offline, ndaj varianti më i thjeshtë është të përdorim UUID si identifikues jo vetëm për entitetet e jashtme, por edhe për të gjitha objektet brenda shërbimit tonë. Madje ato mund të gjenerohen edhe në anën e klientit — kjo do të na ndihmojë të mbështesim dërgimin e mesazheve gjatë mungesës afatshkurtër të disponueshmërisë së DB-së, ndërsa gjasat për kolizion janë jashtëzakonisht të vogla.
Struktura paraprake e tabelave në bazën tonë do të duket kështu:
Tabelat : RU
CREATE TABLE "Тема"(
  "Тема"
    uuid
      PRIMARY KEY
, "Документ"
    uuid
, "Название"
    text
);

CREATE TABLE "Сообщение"(
  "Сообщение"
    uuid
      PRIMARY KEY
, "Тема"
    uuid
, "Автор"
    uuid
, "ДатаВремя"
    timestamp
, "Текст"
    text
);

CREATE TABLE "Адресат"(
  "Сообщение"
    uuid
, "Персона"
    uuid
, PRIMARY KEY("Сообщение", "Персона")
);

CREATE TABLE "Файл"(
  "Файл"
    uuid
      PRIMARY KEY
, "Сообщение"
    uuid
, "BLOB"
    uuid
, "Имя"
    text
);
Tabelat : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Më e thjeshta gjatë përshkrimit të formatit është të filloni ta “shpalosni” grafikun e lidhjeve nga tabelat që nuk referojnë vetë askënd.
Hapi 4: Përcaktojmë nevojat jo të dukshme
Ka mbaruar, e projektuam bazën, ku mund të shkruhet shumë mirë dhe disi të lexohet.
Le ta vëmë veten në vendin e përdoruesit të shërbimit tonë — çfarë do të dëshironim të bënim me ndihmën e tij?
- Mesazhet e fundit
Ky i renditur kronologjikisht sipas kritereve të ndryshme, regjistri i mesazheve “të mia”. Ku unë jam një nga marrësit, ku jam autori, ku më kanë shkruar dhe unë nuk jam përgjigjur, ku nuk më janë përgjigjur mua, … - Pjesëmarrësit e korrespondencës
Kush merr pjesë në këtë bisedë kaq të gjatë?
Struktura jonë na lejon t’i zgjidhim të dyja këto detyra "në parim", por jo shpejt. Problemi është se për renditjen brenda detyrës së parë është e pamundur të krijohet një indeks, i përshtatshëm për secilin pjesëmarrës (dhe do të duhet të nxirren të gjitha regjistrimet), ndërsa për zgjidhjen e së dytës duhet të nxirren absolutisht të gjitha mesazhet sipas temës.
Detyrat e paparashikuara të përdoruesve mund t’i vënë një kryq të madh performancës.
Hapi 5: Denormalizim i arsyeshëm
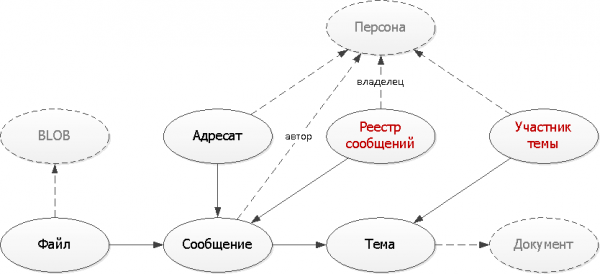
Të dyja problemet tona mund të zgjidhen me tabela shtesë, në të cilat do të dublojmë një pjesë të të dhënave, të nevojshme për të ndërtuar mbi to indekse që i përshtaten detyrave tona.
Tabelat : RU
CREATE TABLE "РеестрСообщений"(
  "Владелец"
    uuid
, "ТипРеестра"
    smallint
, "ДатаВремя"
    timestamp
, "Сообщение"
    uuid
, PRIMARY KEY("Владелец", "ТипРеестра", "Сообщение")
);
CREATE INDEX ON "РеестрСообщений"("Владелец", "ТипРеестра", "ДатаВремя" DESC);

CREATE TABLE "УчастникТемы"(
  "Тема"
    uuid
, "Персона"
    uuid
, PRIMARY KEY("Тема", "Персона")
);
Tabelat : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Këtu kemi përdorur dy qasje tipike që zbatohen gjatë krijimit të tabelave ndihmëse:
- Shumëzimi i regjistrimeve
Nga një regjistrim burimor i mesazhit formojmë menjëherë disa regjistrime pasuese në lloje të ndryshme regjistrash për pronarë të ndryshëm — si për dërguesin, ashtu edhe për marrësin. Kështu, secili regjistër tashmë mbështetet te një indeks, sepse në skenarin tipik do të duam të shohim vetëm faqen e parë. - Unifikimi i regjistrimeve
Sa herë dërgohet një mesazh brenda një teme të caktuar, mjafton të kontrollohet nëse një regjistrim i tillë ekziston tashmë. Nëse jo, e shtojmë në "fjalorin" tonë.
Në pjesën tjetër të artikullit do të flasim për në strukturën e bazës sonë të të dhënave.
Burimi: habr.com
