

Kemi projektuar me sukses strukturën e bazës sonë të PostgreSQL për ruajtjen e bisedave; një vit kaloi dhe përdoruesit e mbushin atë aktivisht, tashmë ajo ka miliona regjistrimesh, dhe… diçka filloi të ngadalësohet.
- Pjesa 2: e segmentojmë «live»
Çështja është se ndërsa rritet volumi i tabelës, rritet gjithashtu edhe "thellësia" e indekseve — ndonëse në mënyrë logarithmike. Por me kalimin e kohës, kjo e detyron serverin që për të ekzekutuar të njëjtat detyra leximi/shkrimi të përpunojë shumë më tepër faqe të dhënash, sesa në fillim.
Këtu ndihmon sektorizimi.
Dua të theksoj se nuk është fjala për sharding, pra shpërndarjen e të dhënave midis bazave të ndryshme ose serverëve. Sepse, madje edhe duke ndarë të dhënat në disa servera, nuk do t'i shpëtoni dot problematikës së "mbledhjes" së indekseve me kalimin e kohës. E qartë është se nëse mund të lejoni vetes të aktivizoni një server të ri çdo ditë, atëherë problemet tuaja do të jenë tashmë krejtësisht jashtë fushës së bazës specifike të të dhënave.
Ne do të shqyrtojmë jo skriptet specifike për realizimin e sektorization "në harduer", por vetë qasjen — çfarë dhe si duhet "prerë në copa", dhe ku të çon një dëshirë e tillë.
Koncepti
Sërish, të përcaktojmë qëllimin tonë: ne duam të bëjmë të mundur që sot, nesër dhe pas një viti, numri i të dhënave lexueshme të PostgreSQL gjatë çdo operacioni leximi/shkrimi të mbetet afërsisht i njëjtë.
Për çdo të dhënë që akumulohet kronologjikisht (mesazhe, dokumente, regjistrime, arkiva, …) një zgjedhje e natyrshme si çelësi për sektorization është data/orari i ngjarjes. Në rastin tonë, ngjarja e tillë është momentin e dërgimit të mesazhit.
Vërejmë se përdoruesit praktikisht gjithmonë punojnë vetëm me "të fundit" të dhëna të tilla — lexojnë mesazhet e fundit, analizojnë regjistrimet e fundit,… Jo, sigurisht, ata mund të shfletojnë edhe më tej prapa në kohë, por e bëjnë këtë shumë rrallë.
Nga këto kufizime, bëhet e qartë se zgjidhja optimale për mesazhet do të jetë "ditarëve" të sektorëve — sepse pothuajse gjithmonë përdoruesi ynë do të lexojë atë që i ka ardhur "sot" ose "dje".
Nëse ne gjatë ditës shkruajmë dhe lexojmë praktikisht vetëm në një sektor, atëherë kjo na ofron gjithashtu një përdorim më efektiv të memories dhe diskeve — pasi të gjitha indikatoret e sektorit lehtë hyjnë në RAM, ndryshe nga "të mëdhenjtë dhe të shëndoshët" në të gjithë tabelën.
hap pas hapi
Në përgjithësi, gjithçka e thënë më sipër tingëllon si një fitim i vazhdueshëm. Dhe ai është i arritshëm, por për këtë na duhet të punojmë shumë — sepse zgjidhja për të ndarë një nga entitetet sjell nevojën për "ndarjen" e lidhur me të.
Mesazhi, pronat e tij dhe projekcionet
Duke qenë se vendosëm të ndajmë mesazhet sipas datave, është gjithashtu e arsyeshme të ndajmë entitetet-pronë të lidhura me to (skedarët e bashkëngjitur, lista e adresat) dhe po ashtu sipas datës së mesazhit.
Duke qenë se një nga detyrat tona tipike është pikërisht shqyrtimi i regjistrave të mesazheve (të pa lexuar, të hyra, të gjitha), është logjike t'i "përfshijmë" ato në ndarjen sipas datave të mesazheve.
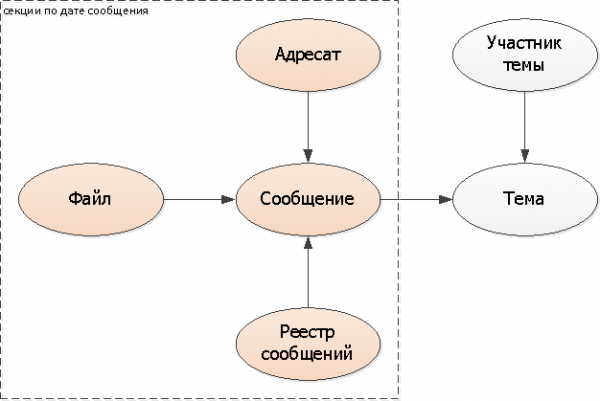
Shtojmë çelësin e ndarjes (datën e mesazhit) në të gjitha tabelat: adresat, skedari, regjistrat. Në vetë mesazhin nuk është e nevojshme të shtohet, por mund të përdoret ekzistuesja DataOra.
Temat
Duke qenë se tema është një për disa mesazhe, nuk është e mundur ta "ndajmë" atë në të njëjtën model, duhet të mbështetet në diçka tjetër. Në rastin tonë përshtatet perfekten data e mesazhit të parë në bisedë - që është momenti i krijimit, pra, i temës.
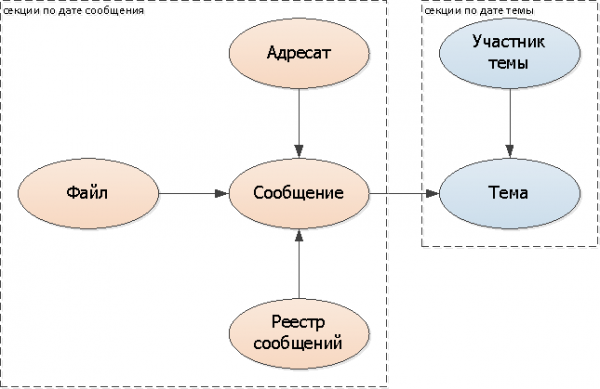
Shtojmë çelësin e ndarjes (datën e temës) në të gjitha tabelat: tema, pjesëmarrësi.
Por tani na dalin menjëherë dy probleme:
- në cilën seksion të kërkojmë mesazhet sipas temës?
- në cilën seksion të kërkojmë temën nga mesazhi?
Sigurisht, mund të vazhdojmë të kërkojmë në të gjitha seksionet, por kjo do të ishte shumë e dëshpëruar dhe do të shfuqizonte të gjitha fitimet tona. Prandaj, për të ditur ku të kërkojmë konkretisht, do të bëjmë lidhje logjike/kursorë në seksione:
- në mesazh do të shtojmë një fushë me datën e temës
- temës do t'i shtojmë grupin e datave të mesazheve të kësaj bisedë (mund të jetë një tabelë e veçantë, ose dhe një masiv datash)
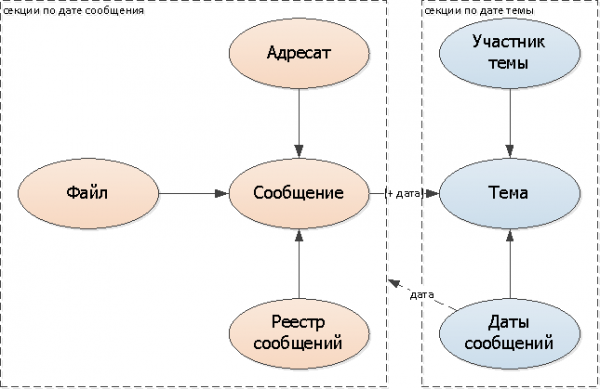
Duke qenë se modifikimet e listës së datave të mesazheve për çdo bisedë të veçantë do të jenë të pakta (sepse pothuajse të gjitha mesazhet bien në 1-2 ditë të ngjitura), do të ndalem në këtë variant.
Sipas përmbledhjes, struktura e bazës sonë mori këtë formë duke marrë parasysh ndarjen:
Tabelat: RU, nëse ndjeshmëria ndaj cirilikës në emrat e tabelave/fushave është e keqe, është më mirë të mos shikoni
-- seksionet sipas datës së mesazhit
CREATE TABLE "Mesazh_YYYYMMDD"(
  "Mesazh"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "DataTemës"
    date
, "Autori"
    uuid
, "DataKohë" -- përdorim si datë
    timestamp
, "Teksti"
    text
);

CREATE TABLE "Adresat_YYYYMMDD"(
  "DataMesazhit"
    date
, "Mesazh"
    uuid
, "Personi"
    uuid
, PRIMARY KEY("Mesazh", "Personi")
);

CREATE TABLE "Skedari_YYYYMMDD"(
  "DataMesazhit"
    date
, "Skedari"
    uuid
      PRIMARY KEY
, "Mesazh"
    uuid
, "BLOB"
    uuid
, "Emri"
    text
);

CREATE TABLE "RegjistriMesazheve_YYYYMMDD"(
  "DataMesazhit"
    date
, "Pronari"
    uuid
, "LlojiRegjistrit"
    smallint
, "DataKohë"
    timestamp
, "Mesazh"
    uuid
, PRIMARY KEY("Pronari", "LlojiRegjistrit", "Mesazh")
);
CREATE INDEX ON "RegjistriMesazheve_YYYYMMDD"("Pronari", "LlojiRegjistrit", "DataKohë" DESC);

-- seksionet sipas datës së temës
CREATE TABLE "Tema_YYYYMMDD"(
  "DataTemës"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Dokumenti"
    uuid
, "Emri"
    text
);

CREATE TABLE "PjesëmarrësiTemës_YYYYMMDD"(
  "DataTemës"
    date
, "Tema"
    uuid
, "Personi"
    uuid
, PRIMARY KEY("Tema", "Personi")
);

CREATE TABLE "DatatMesazheveTemës_YYYYMMDD"(
  "DataTemës"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Data"
    date
);
Këtu po kursejmë një qindarkë
Por, nëse ne nuk përdorim në bazë të shpërndarjes së vlerave të fushës (përmes triggereve dhe trashëgimisë ose PARTITION BY), por «manualmente» në nivelin e aplikacionit, atëherë mund të vërehet se vlera e çelësit të seksionimit tashmë ruhet në emrin e vetë tabelës.
Prandaj, nëse jeni aq të shqetësuar për volumin e të dhënave të ruajtur, atëherë këto «fusha të tepërta» mund të hiqen dhe të adresohet direkt në tabela specifike. Megjithatë, të gjitha zgjedhjet nga disa seksione në këtë rast do të duhet të kalojnë në anën e aplikacionit.
Burimi: habr.com
