

Fjalë hyrëse
Unë e prezantova këtë dokument në anglisht në konferencën GopherCon Rusia 2019 në Moskë dhe në rusisht në mitap në Nizhny Novgorod. Fjala është për indeksin bitmap — më pak i zakonshëm se B-tree, por jo më pak interesant. Po ndaja e fjalimit në konferencë në anglisht dhe transkriptin tekstual në rusisht.
Ne do të shqyrtojmë se si funksionon indeksi bitmap, kur është më i mirë, kur është më inferior ndaj indekseve të tjera dhe në cilat raste është ndjeshëm më i shpejtë se ato; do të shohim në cilat DBMS-popullore tashmë ekzistojnë indekse bitmap; do të përpiqemi të shkruajmë të tonin në Go. Dhe për "desert" do të përdorim biblioteka të gatshme për të krijuar një bazë të dhënash specializuar super të shpejtë.
Shpresoj shumë që punimet e mia do t'i dalin të vlefshme dhe interesante për ju. Le të fillojmë!
Hyrje

Përshëndetje të gjithëve! Tani është ora gjashtë pasdite, ne të gjithë jemi shumë të lodhur. Një kohë e mrekullueshme për të folur për teorinë e mërzitshme të indekseve të bazave të të dhënave, apo jo? Mos u shqetësoni, do të kem disa rreshta kodi burimor këtu e aty. 🙂
Nëse flasim seriozisht, dokumenti është i mbushur me informacion, dhe nuk kemi aq shumë kohë. Prandaj, le të fillojmë.
Sot do të flas për këtë:
- çfarë janë indekset;
- çfarë është indeksi bitmap;
- ku përdoret dhe ku nuk përdoret dhe përse;
- një implementim i thjeshtë në Go dhe pak luftë me kompilatorin;
- një implementim pak më pak të thjeshtë, por shumë më produktiv në Go-assembler;
- «problemet» e indekseve bitmap;
- implementimet ekzistuese.
Pra, çfarë janë indekset?
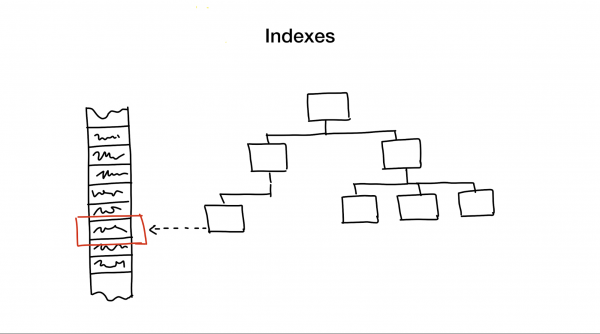
Indeksi është një strukturë e veçantë të dhënash, që ne e ruajmë dhe e përditësojmë në përputhje me të dhënat kryesore. Përdoret për të përshpejtuar kërkimin. Pa indekset, kërkimi do të kërkonte një kalim të plotë përmes të dhënave (procesi i quajtur skanim i plotë), dhe ky proces ka kompleksitet linear algoritmik. Por bazat e të dhënave zakonisht përmbajnë një sasi të madhe të dhënash dhe kompleksiteti linear është shumë i ngadaltë. Idealisht, duam të arrijmë një kompleksitet logarimor ose konstant.
Kjo është një temë e madhe dhe komplekse, e mbushur me nuanca dhe kompromise, por, duke shqyrtuar disa dekada zhvillim dhe hulumtim të bazave të ndryshme të të dhënave, jam i gatshëm të pohoj se ekzistojnë vetëm disa qasje të përdorura gjerësisht për krijimin e indekseve të BDs.
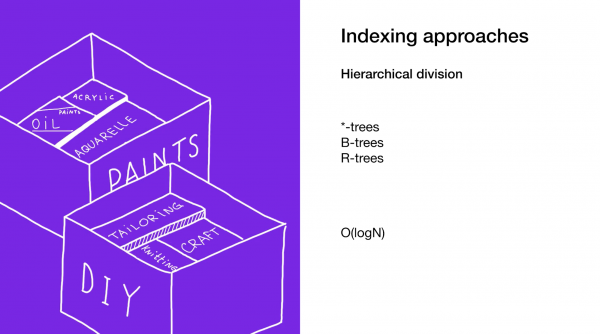
Qasja e parë përfshin reduktimin hierarkik të fushës së kërkimit, duke e ndarë atë në pjesë më të vogla.
Zakonisht ne e bëjmë këtë duke përdorur lloje të ndryshme pemësh. Një shembull mund të jetë një kuti e madhe me materiale në garderobën tuaj, në të cilën ndodhen kuti më të vogla me materiale të ndara sipas temash të ndryshme. Nëse ju nevojiten materiale, ju me siguri do të kërkoni në kutinë me etiketën "Materialet", dhe jo në atë me etiketën "Biskota", apo jo?
Qasja e dytë përfshin identifikimin e menjëhershëm të elementit të nevojshëm ose grupit të elementeve. Ne e bëjmë këtë në hartat hash ose në indekset e rikthimit. Përdorimi i hartave hash është shumë i ngjashëm me shembullin e mëparshëm, vetëm se në vend të një kutie me kuti, ju keni në garderobën tuaj shumë kuti të vogla me objekte përfundimtare.
Qasja e tretë është të eliminohet nevoja për kërkim. Këtë e bëjmë me filtra Bloom ose filtra cuckoo. Të parët japin një përgjigje menjëherë, duke ju liruar nga nevoja për të bërë kërkime.
Qasja e fundit përfshin shfrytëzimin e plotë të kapaciteteve që na ofron hardueri modern. Këtë e bëjmë me indekset bitmap. Po, kur i përdorim, ndonjëherë na duhet të kalojmë përmes të gjithë indeksit, por ne e bëjmë këtë shumë efikase.
Siç e thashë, tema e indekseve të DB është e gjerë dhe e mbushur me kompromise. Kjo do të thotë se ndonjëherë mund të përdorim disa qasje njëherësh: nëse na nevojitet ta përshpejtojmë kërkimin edhe më tej ose nëse është e nevojshme të mbulojmë të gjitha llojet e kërkimit.
Sot do t'ju tregoj për qasjen më pak të njohur nga ato të përmendura — për indekset bitmap.
Kush jam unë që të flas për këtë temë?
Unë punoj si lider i ekipit në Badoo (ndoshta ju e njifni më mirë produktin tonë të tjetër — Bumble). Ne tashmë kemi më shumë se 400 milion përdorues në mbarë botën dhe shumë funksione që meritojnë që të gjejnë çiftin më të mirë për ta. Ne e bëjmë këtë përmes shërbimeve të personalizuara, duke përdorur gjithashtu indekset bitmap.
Pra, çfarë është indeksi bitmap?
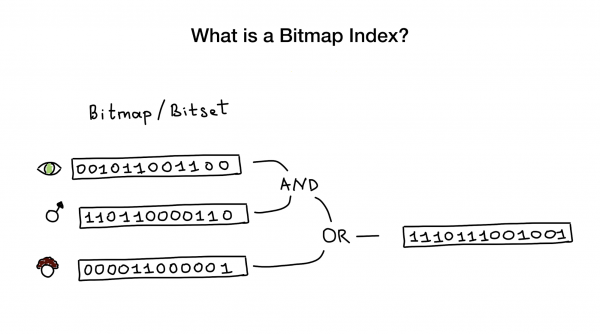
Indekset bitmap, siç sugjeron edhe emri, përdor bitmap ose bitset për të implementuar një indeks kërkimi. Nga një lartësi zogjsh, ky indeks përbëhet nga një ose më shumë nga këta bitmap, që përfaqësojnë entitete të ndryshme (si njerëzit) dhe karakteristikat e tyre ose parametrat (moshë, ngjyrë sysh etj.), dhe nga një algoritëm që përdor operacione bitore (AND, OR, NOT) për të përgjigjur në kërkesat e kërkimit.
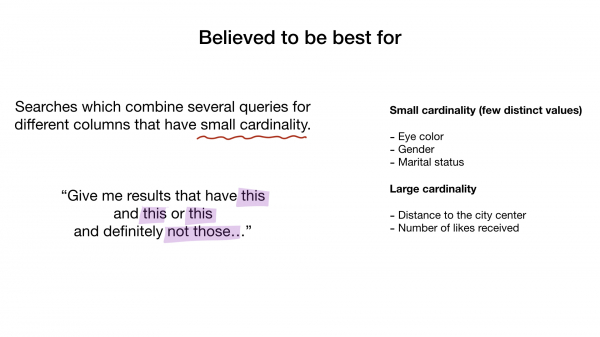
Na thuhet se indekset bitmap janë më të përshtatshme dhe shumë produktive për rastet kur ekziston kërkesa që bashkon kërkesa mbi shumë kolona me kardinalitet të ulët (imagjinoni "ngjyrën e syve" ose "statusin gjinor" kundrejt diçkaje si "distanca nga qendra e qytetit"). Por më vonë do t'ju tregoj se ato funksionojnë gjithashtu shumë mirë në rastin e kolonave me kardinalitet të lartë.
Le të shqyrtojmë një shembull të thjeshtë të indekseve bitmap.
Imagjinoni se kemi një listë restorantesh në Moskë me tipare binarë si këto:
- pranë metro (near metro);
- ka parkim privat (has private parking);
- ka tarracë (has terrace);
- pranon rezervime (accepts reservations);
- është i përshtatshëm për veganët (vegan friendly);
- i shtrenjtë (expensive).
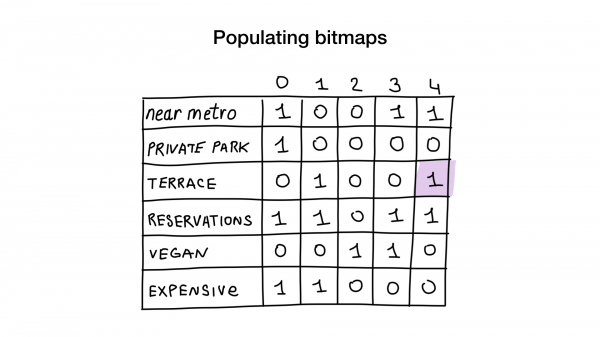
Le t'i japim çdo restoranti një numër rendor, duke filluar nga 0 dhe të alokojmë hapësirë për 6 bitmap (një për secilën karakteristikë). Pastaj ne do t'i mbushim këto bitmap në varësi të asaj nëse restoranti ka këtë pronë apo jo. Nëse restoranti 4 ka tarracë, atëherë bita nr. 4 në bitmapin "ka tarracë" do të vendoset në 1 (nëse nuk ka tarracë, atëherë në 0).
Tani kemi indekset bitmap më të thjeshta të mundshme, dhe mund t'i përdorim ato për të përgjigjur në kërkesa si:
- "Më trego restorantet që janë të përshtatshëm për veganët";
- "Më trego restorantet e lira me tarracë, ku mund të rezervoj një tavolinë."
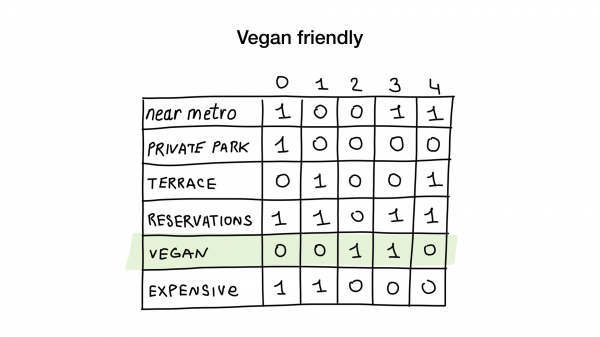
Si? Le të shohim. Kërkesa e parë është shumë e thjeshtë. Gjithçka që na nevojitet është të marrim bitmapin "është i përshtatshëm për veganët" dhe ta kthejmë atë në një listë restorantesh, të cilët biterat e tyre janë vendosur.
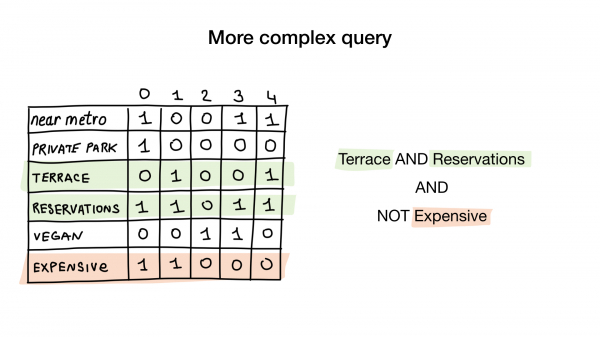
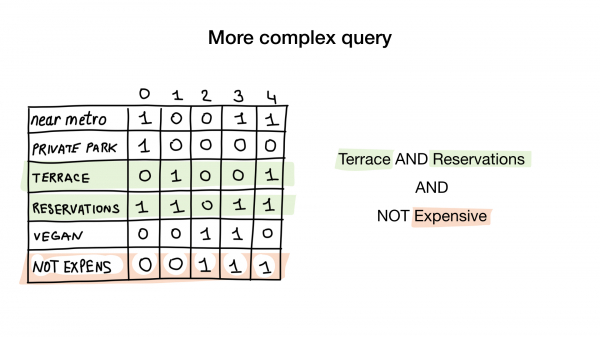
Kërkesa e dytë është pak më e komplikuar. Na nevojitet të përdorim operacionin bitor NOT mbi bitmapin "i shtrenjtë" për të marrë një listë restorantesh të lira, pastaj do ta AND-ojmë atë me bitmapin "mund të rezervosh tavolinë" dhe më pas do ta AND-ojmë rezultatin me bitmapin "ka verandë". Bitmapi përfundimtar do të përmbajë një listë të vendeve që përputhen me të gjitha kriteret tona. Në këtë shembull ka vetëm restorantin "Junosti".
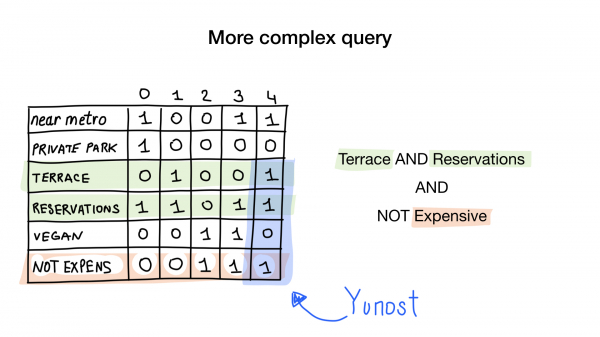
Ka shumë teori këtu, por mos u shqetësoni, do të shohim kodin shumë shpejt.
Ku përdoren indeksat bitmap?
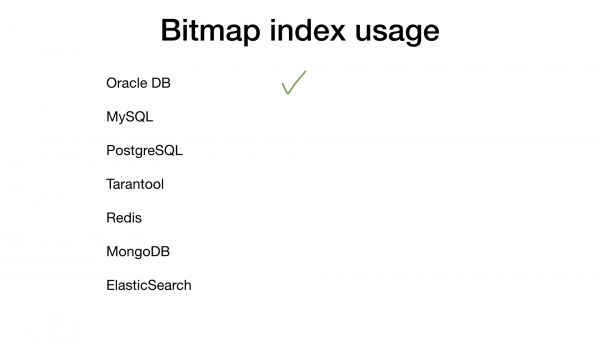
Nëse e "gugëloni" indeksin bitmap, 90% e përgjigjeve do të lidhen në një farë mënyre me Oracle DB. Por sigurisht, edhe sistemet e tjera të menaxhimit të të dhënave e mbështesin një gjë të tillë, apo jo? Jo krejt.
Le të kalojmë nëpër listën e dyshuarve kryesorë.
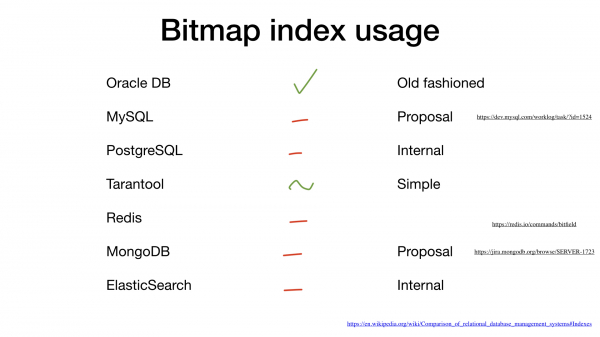
MySQL ende nuk e mbështet indeksin bitmap, por ka një Propozim për ta shtuar këtë mundësi ().
PostgreSQL nuk mbështet indeksat bitmap, por përdor bitmap të thjeshtë dhe operacione bitore për të bashkuar rezultatet e kërkimit nga disa indekse të tjera.
Tarantool ka indekse bitset, ai mbështet kërkimin e thjeshtë mbi to.
Redis ka fusha bitore të thjeshta) pa mundësi për të kërkuar mbi to.
MongoDB ende nuk mbështet indeksat bitmap, por gjithashtu ka një Propozim për të shtuar këtë mundësi
Elasticsearch përdor bitmap brenda).
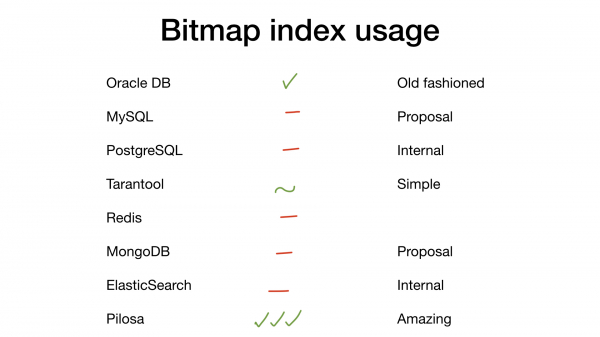
- Por në shtëpinë tonë erdhi një fqinj i ri: Pilosa. Kjo është një bazë të dhënash e re, jo-relacionale, e shkruar në Go. Ajo ka vetëm indekse bitmap dhe bazohet krejtësisht mbi to. Ne do të flasim për të më vonë.
Implementimi në Go
Por pse indeksat bitmap përdoren kaq rrallë? Para se të përgjigjem në këtë pyetje, do të doja t'ju tregoj implementimin e një indeksi bitmap shumë të thjeshtë në Go.
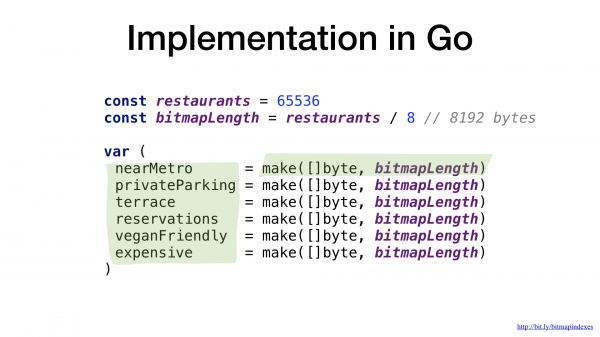
Bitmapet, në thelb, paraqiten thjesht si copa të të dhënave. Në Go, le të përdorim slice të bajtave për këtë.
Ne kemi një bitmap për një karakteristikë restoranti, dhe çdo bit në bitmap tregon nëse një restaurant specifik ka këtë pronë apo jo.
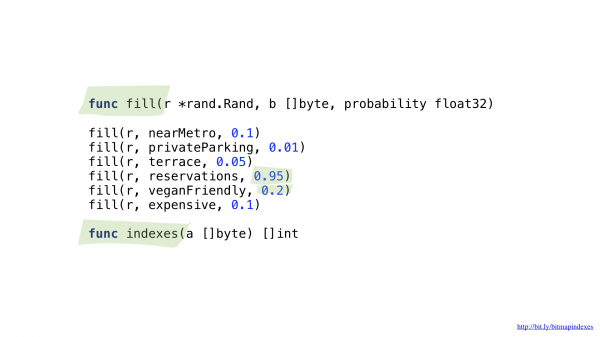
Na nevojiten dy funksione ndihmëse. Njëra do të përdoret për të mbushur bitmapet tona me të dhëna të rastit. Të rastit, por me një probabilitet të caktuar që restoranti ka secilën pronë. Për shembull, mendoj se në Moskë ka shumë pak restorante ku nuk mund të rezervosh një tavolinë, dhe më duket se rreth 20% e vendeve janë të përshtatshme për veçanët.
Funksioni i dytë do të shndërrojë bitmapin në një listë restorantesh.
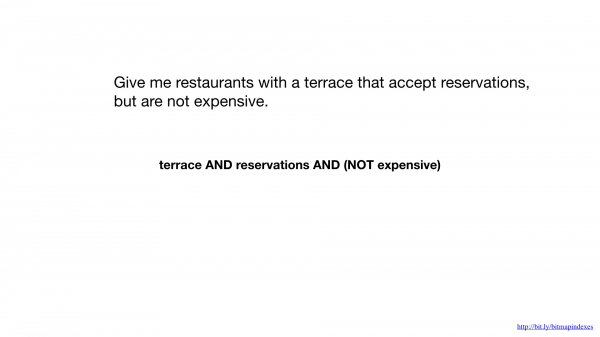
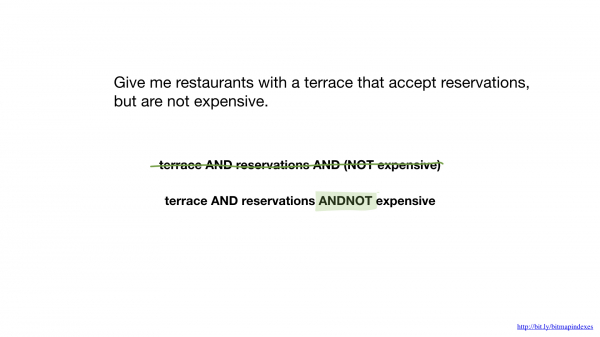
Për të përgjigjur në kërkesën "Më trego restorantet e lira që kanë verande dhe ku mund të rezervosh një tavolinë", na nevojiten dy operacione bitmap: NOT dhe AND.
Mund ta thjeshtojmë pak kodin tonë duke përdorur një operacion më të ndërlikuar AND NOT.
Kemi funksione për secilën nga këto operacione. Të dy shkojnë përmes slice-ve, marrin elementët përkatës nga secili, i bashkojnë ato me operacionin bitmap dhe vendosin rezultatin në një slice rezultues.
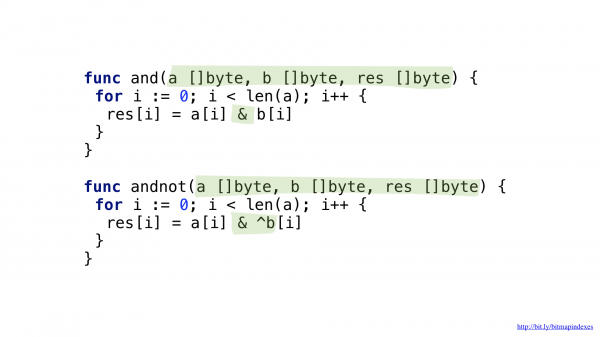
Dhe tani mund të përdorim bitmapet dhe funksionet tona për të përgjigjur në kërkesën e kërkimit.
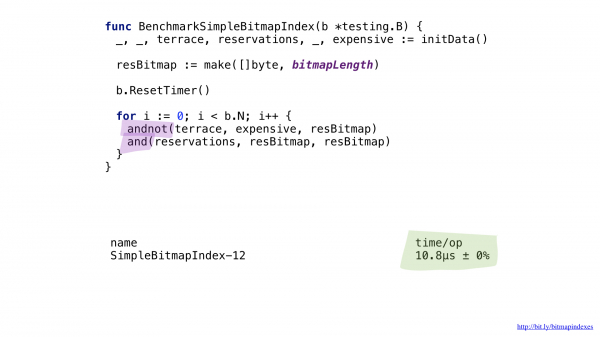
Kjo performancë nuk është kaq e lartë, edhe pse funksionet janë shumë të thjeshta dhe kemi kursyer mjaft duke mos u kthyer një slice rezultues të ri me çdo thirrje funksioni.
Pasi bëra disa profilime me pprof, vura re se kompajleri Go kaloi një optimizim shumë të thjeshtë, por shumë të rëndësishëm: inlining e funksioneve.
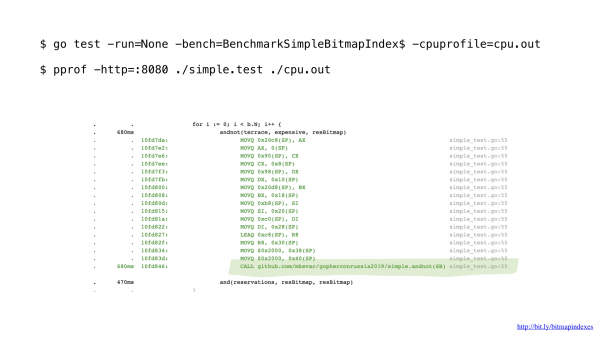
E vetmja gjë është se kompajleri Go ka një frikë të madhe nga ciklet që shkojnë përmes slice-ve dhe refuzon të inlinojë funksionet që përmbajnë këto cikle.
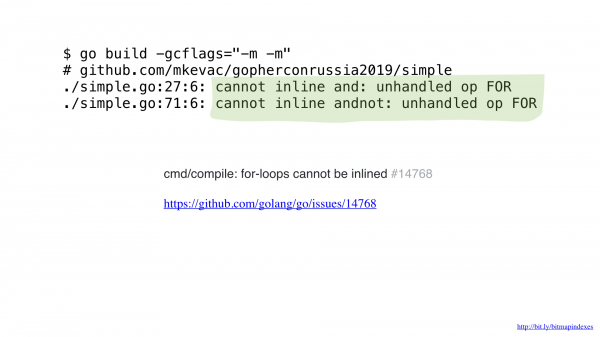
Por unë nuk kam frikë dhe mund ta mashtroj kompajlerin duke përdorur goto në vend të ciklit, si në kohët e vjetra.
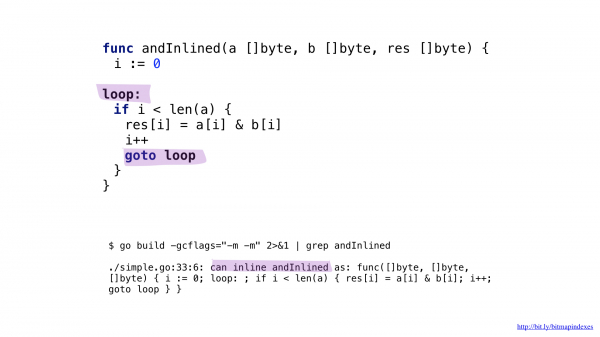
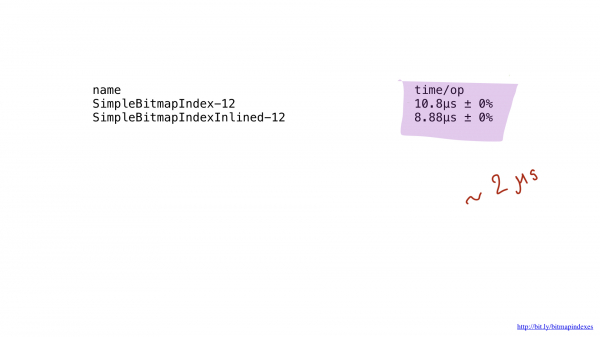
Dhe, siç e shihni, tani kompajleri gëzohet kur inlinë funksionin tonë! Si rezultat, arrijmë të kursejmë rreth 2 mikrosekonda. Mjaft mirë!
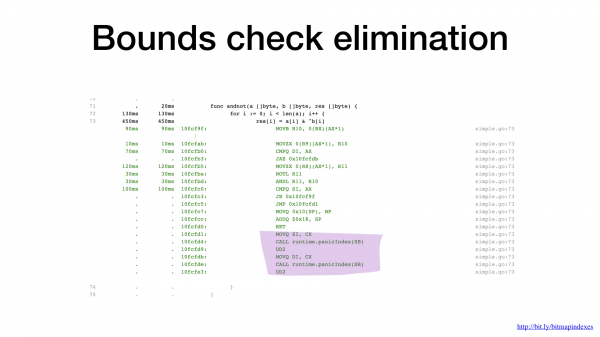
Ngushtica e dytë është e dukshme nëse e shikoni me kujdes daljen e assembler-it. Kompajleri shtoi një kontroll për kufijtë e slice-it brenda ciklit tonë më të nxehtë. E vetmja gjë është se Go është një gjuhë e sigurt, kompajleri ka frikë se tre argumentet e mia (tri slice) kanë përmasa të ndryshme. Sepse atëherë do të ketë një mundësi teorike për ndodhin e ashtuquajturit overflow i buffers.
Le të qetësojmë kompilatorin, duke i treguar se të gjitha slices kanë të njëjtën madhësi. Mund ta bëjmë këtë duke shtuar një kontroll të thjeshtë në fillim të funksionit tonë.
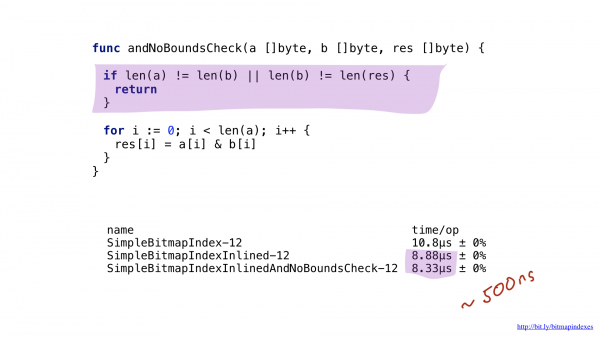
Duke e parë këtë, kompilatori me gëzim e kalon kontrollin dhe në fund ne kursejmë edhe 500 nanosekonda.
Bashkëngjitje të mëdha
Ok, kemi arritur të nxjerrim njëfarë performancë nga implementimi ynë të thjeshtë, por ky rezultat është, në të vërtetë, shumë më i keq se sa është e mundur me harduerin aktual.
Gjithçka që bëjmë janë operacione themelore bitesh, dhe procesorët tanë i ekzekutojnë ato shumë efikasht. Por, fatkeqësisht, ne "ushqejmë" procesorin tonë me pjesë shumë të vogla pune. Funksionet tona ekzekutojnë operacione në nivel byte. Mund ta rregullojmë shumë lehtë kodin tonë që të punojë me copa 8-byte, duke përdorur slices të UInt64.
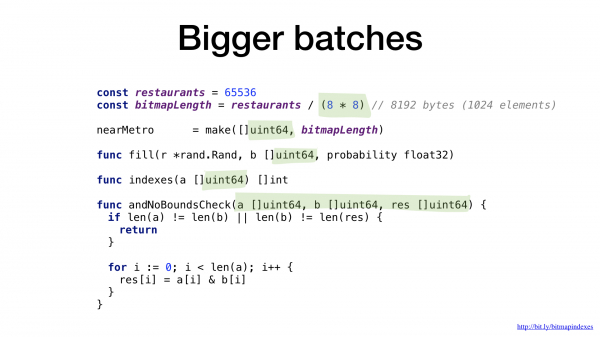
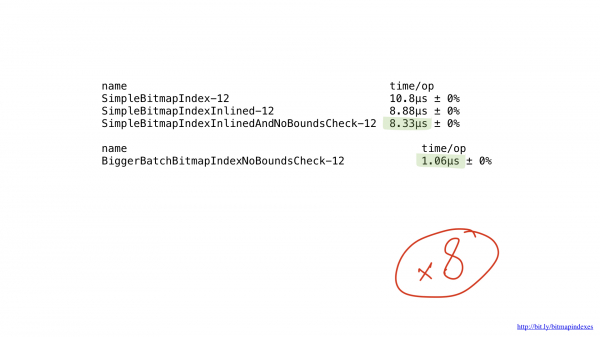
Siç e shihni, ky ndryshim i vogël e përshpejtoi programin tonë tetë herë për shkak të rritjes së bashkësisë në tetë herë. Fitimi mund të quhet linear.
Implementimi në assembler
Por kjo nuk është fundi. Procesorët tanë mund të punojnë me copa 16, 32 dhe madje edhe 64 byte. Këto operacione "të gjera" quhen single instruction multiple data (SIMD; një instrukcion, shumë të dhëna), dhe procesi i konvertimit të kodit në këtë mënyrë në mënyrë që ta përdorë këto operacione quhet vektorizim.
Fatkeqësisht, kompilatori Go nuk është aspak një student i shkëlqyer në vektorizim. Momentalisht, mënyra e vetme për vektorizimin e kodit në Go është ta merrni dhe ta shkruani operacionin manualisht duke përdorur assemblerin Go.
Assembleri Go është një krijesë e çuditshme. Me siguri e dini që assembleri është diçka që është shumë e lidhur me arkitekturën e kompjuterit për të cilën shkruani, por në Go nuk është kështu. Assembleri Go është më shumë si një IRL (intermediate representation language) ose gjuhë përfaqësuese: është praktikisht e pavarur nga platforma. Rob Pike bëri një në këtë temë disa vite më parë në GopherCon në Denver.
Përveç kësaj, Go përdor një format të çuditshëm Plan 9, i cili ndryshon nga formatet e njohura AT&T dhe Intel.
Mund të thuhet me besim se të shkruash manualisht assemblerin Go nuk është një veprimtari e këndshme.
Por, fatmirësisht, tashmë ekzistojnë dy mjete të nivelit të lartë që na ndihmojnë në shkruarjen e assemblerit Go: PeachPy dhe avo. Të dyja mjetet gjenerojnë Go-assembler nga kod i nivelit më të lartë të shkruar në Python dhe Go përkatësisht.
Këto mjete e thjeshtojnë gjëra si alokimin e regjistrit (zgjedhja e regjistrit të procesorit), shkruhen cikle, dhe në përgjithësi e lehtësojnë procesin e hyrjes në botën e programimit në assembler në Go.
Ne do të përdorim avo, kështu që programet tona do të jenë pothuajse programe normale në Go.
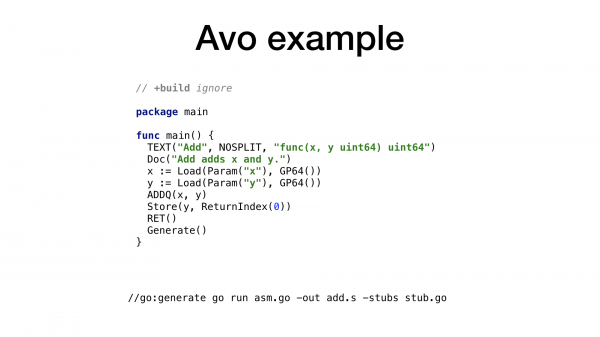
Ja si duket shembulli më i thjeshtë i një programi avo. Ne kemi një funksion main() që përcakton brenda vetes një funksion Add(), i cili ka për qëllim të shtojë dy numra. Këtu janë funksione ndihmës për të marrë parametrat sipas emrit dhe për të marrë një nga regjistrat e lirë dhe të përshtatshëm të procesorit. Çdo operacion në procesor ka funksionin e tij përkatës në avo, siç duket nga ADDQ. Dhe për fund, ne shohim një funksion ndihmës për ruajtjen e vlerës rezultuese.
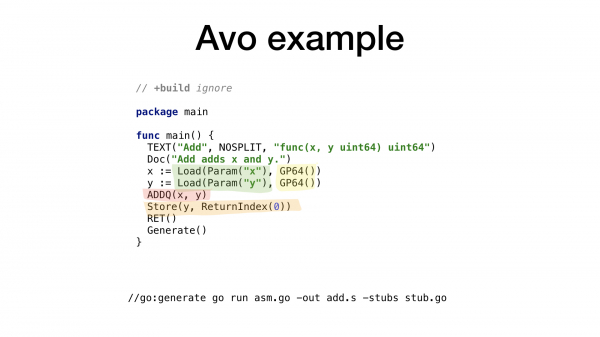
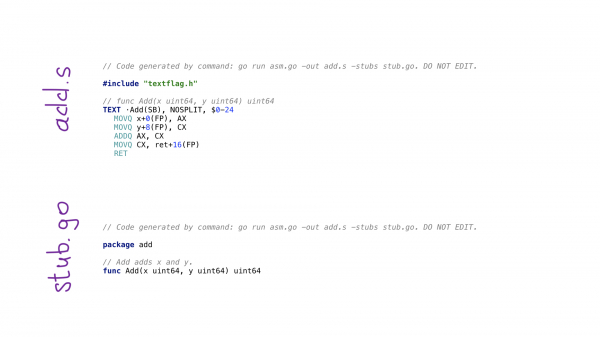
Duke thirrur go generate, do të ekzekutojmë programin në avo dhe në fund do të gjenerohen dy skedarë:
- add.s me kodin rezultues në assemblerin Go;
- stub.go me titujt e funksioneve për lidhjen e dy botëve: Go dhe assembler.
Tani, kur kemi parë se çfarë dhe si e bën avo, le të shohim funksionet tona. Unë kam realizuar dhe versionet skalar dhe vektor (SIMD) të funksioneve.
Së pari, le të shohim versionet skalar.
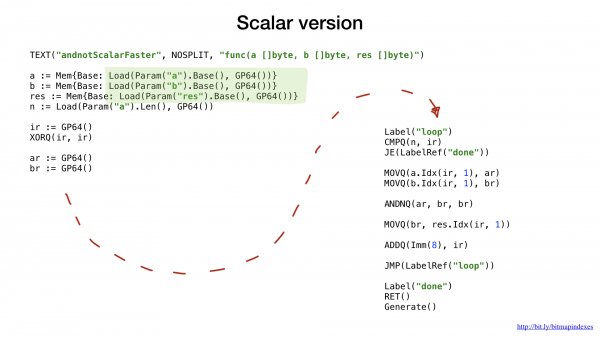
Siç bëmë në shembullin e mëparshëm, ne kërkojmë të na ofrohet një regjistër të lirë dhe të saktë të regjistrave të përgjithshëm, nuk na nevojitet të llogarisim zhvendosjet dhe përmasat për argumentet. Të gjitha këto avo e bën për ne.
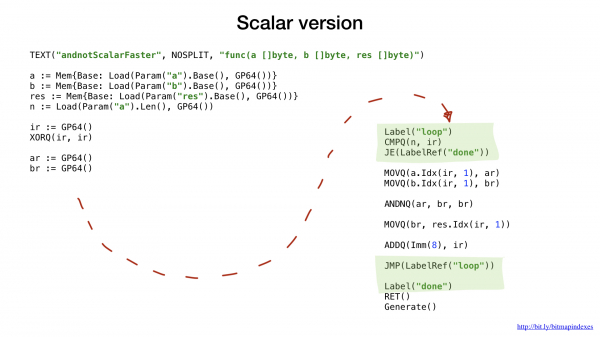
Më parë kemi përdorur etiketat dhe goto (ose kërcime) për të përmirësuar performancën dhe për të mashtruar kompilatorin Go, por tani po e bëjmë këtë nga fillimi. E vërteta është se ciklet janë një koncept më i lartë. Në assembler kemi vetëm etiketa dhe kërcime.
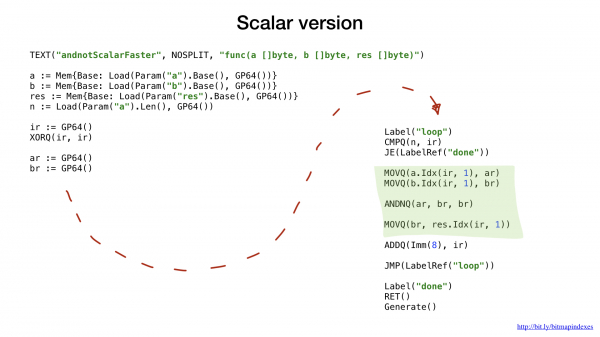
Kodi i mbetur duhet të jetë tashmë i njohur dhe i qartë. Ne imitojmë ciklin me etiketa dhe kërcime, marrim një pjesë të vogël të të dhënave nga dy skedarët tanë, i kombinojmë ata me një operacion bit i (AND NOT në këtë rast) dhe pastaj e vendosim rezultatin në skedarin rezultues. Kaq.
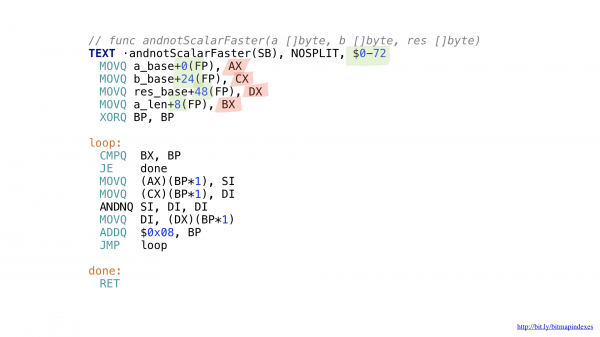
Këtu është kodi përfundimtar në assembler. Nuk na nevojitej të llogaritnim zhvendosjet dhe përmasat (të theksuara me gjelbër) ose të kemi kujdes për regjistrat e përdorur (të theksuar me të kuqe).
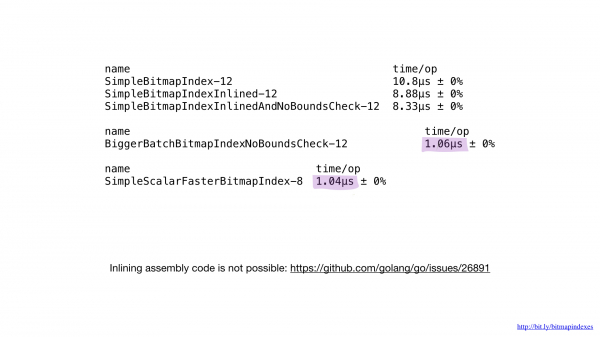
Nëse e krahasojmë performancën e implementimit në assembler me performancën e implementimit më të mirë në Go, ne do të shohim se ato janë të njëjta. Dhe kjo është e pritshme. Sepse ne nuk bëmë asgjë të veçantë — ne vetëm riprodhuam atë që do të bënte kompileri Go.
Fatkeqësisht, ne nuk mund ta detyrojmë kompilerin të bej inlining funksionet tona të shkruara në assembler. Deri më sot, kompileri Go nuk ka një mundësi të tillë, megjithatë kërkesa për ta shtuar atë ka qenë aktive për një kohë të gjatë.
Pikërisht për këtë arsye, nuk është e mundur të marrim ndonjë përfitim nga funksionet e vogla në assembler. Na nevojitet ose të shkruajmë funksione më të mëdha, ose të përdorim paketën e re math/bits, ose të anashkalojmë assemblerin.
Tani le të shikojmë versionet vektoriale të funksioneve tona.
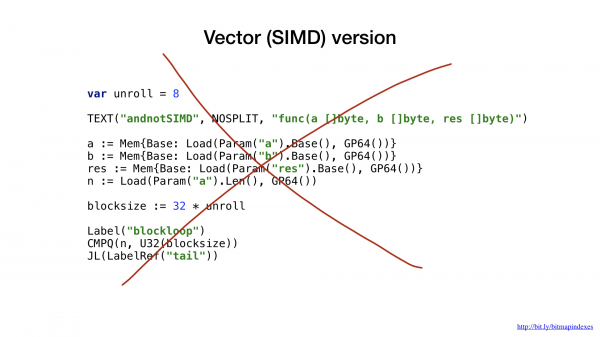
Për këtë shembull, vendosa të përdor AVX2, kështu që ne do të përdorim operacione që punojnë me copa 32-byte. Struktura e kodit është shumë e ngjashme me versionin skalar: ngarkimi i parametrave, kërkesa për një regjistër të lirë të përgjithshëm dhe të tjera.
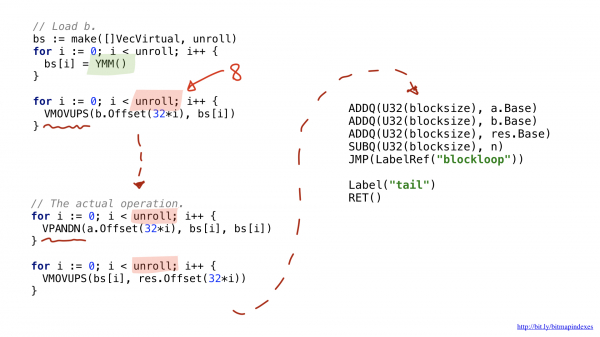
Një nga inovacionet e reja ka të bëjë me atë se operacionet e gjera vektoriale përdorin regjistra të veçantë të gjerë. Në rastin e copave 32-byte, këto janë regjistrat me prefiks Y. Prandaj ju shihni funksionin YMM() në kod. Nëse do të përdorja AVX-512 me copa 64-bit, prefiksi do të ishte Z.
Inovacioni i dytë lidhet me faktin se vendosa të përdor një optimizim që quhet zvogëlim i ciklit (loop unrolling), domethënë të bëj tetë operacione cikli manualisht para se të hidhem në fillim të ciklit. Ky optimizim zvogëlon numrin e branch-eve në kod, dhe është i kufizuar nga numri i regjistrave të lirë të disponueshëm.
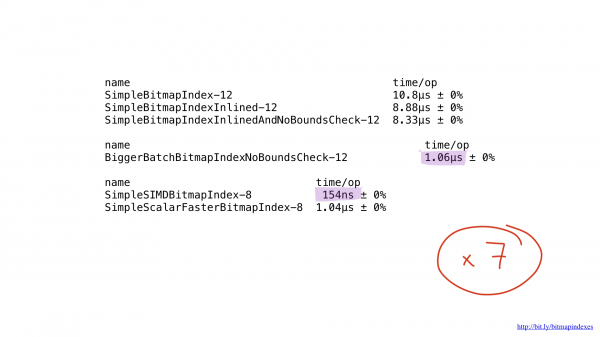
Por çfarë ndodh me performancën? Ajo është të shkëlqyer! Ne arritëm një përshpejtim prej rreth shtatë herë krahasuar me zgjidhjen më të mirë në Go. Mbresëlënëse, apo jo?
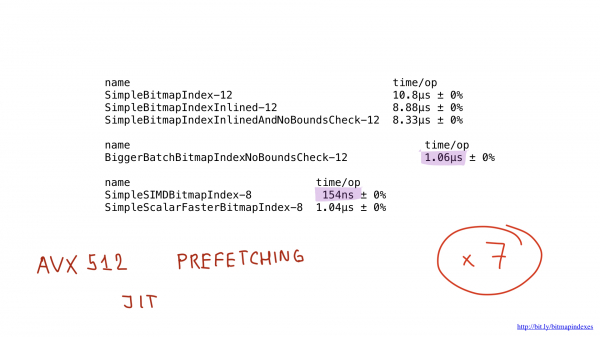
Por edhe kjo implementim potencielisht mund të përshpejtohet duke përdorur AVX-512, prefetching ose JIT (kompilues në kohë reale) për planifikuesin e kërkesave. Por kjo është sigurisht një temë për një raport të veçantë.
Problemet e indekseve bitmap
Tani që ne kemi shqyrtuar implementimin e thjeshtë të indeksit bitmap në Go dhe një implementim shumë më të produktiv në assembler, le të flasim përfundimisht për atë se pse indekset bitmap përdoren kaq rrallë.
Në punimet e vjetra shkencore përmenden tre probleme të indekseve bitmap, por punimet më të reja shkencore dhe unë pohojmë se ato tashmë nuk janë të rëndësishme. Nuk do të shtyjmë thellë në secilin nga këto probleme, por do t'i shqyrtojmë sipërfaqësisht.
Problemi i kardinalitetit të lartë
Pra, na thuhet se indekset bitmap i përshtaten vetëm fushave me kardinalitet të vogël, që do të thotë që ato kanë pak vlera (p.sh., gjinia ose ngjyra e syve), dhe arsyeja është se përfaqësimi i zakonshëm i këtyre fushave (një bit për vlerë) në rastin e kardinalitetit të lartë do të marrë shumë hapësirë dhe, më shumë, këto indekse bitmap do të ishin të mbushura pak (rrallë).
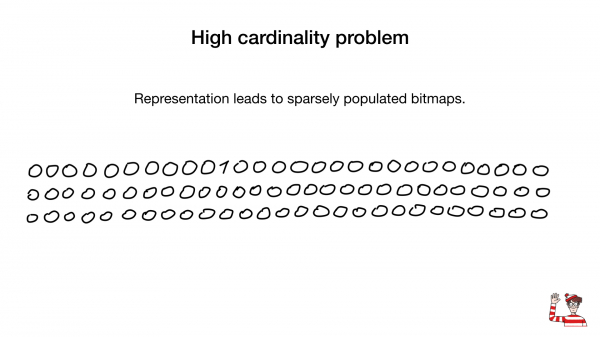
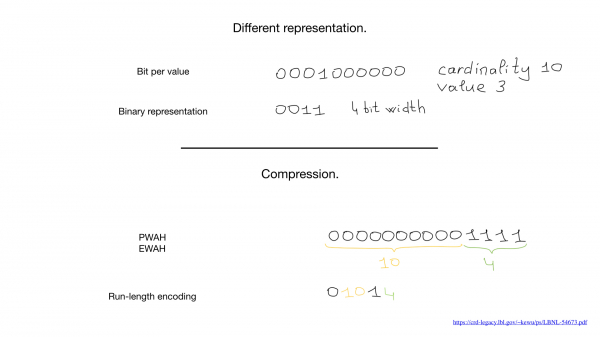
Ndonjëherë mund të përdorim një përfaqësim tjetër, për shembull përfaqësimin standard që përdorim për numrat. Por pikërisht shfaqja e algoritmeve të kompresimit e ndryshoi gjithçka. Gjatë dekadave të fundit, shkencëtarët dhe studiuesit kanë shpikur një numër të madh algoritmesh kompresimi për bitmapet. Avantazhi i tyre kryesor është se nuk është e nevojshme të dekompresojmë bitmapet për të kryer operacione bitore — mund të kryejmë operacione bitore direkt mbi bitmapet e kompresuara.
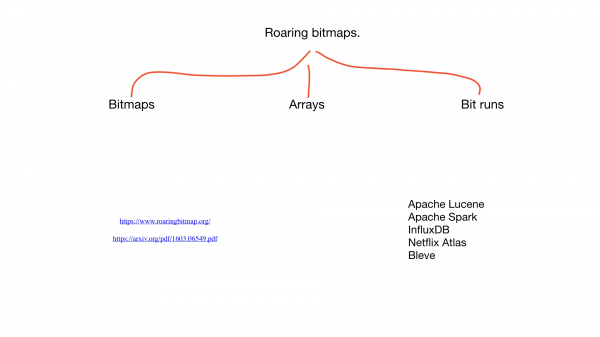
Kohët e fundit kanë filluar të shfaqen edhe qasje hibrid, siç janë bitmapet roaring. Ato përdorin njëkohësisht tre përfaqësime të ndryshme për bitmapet — vetë bitmapet, array-t dhe atë që quhet bit runs — dhe balancojnë midis tyre për të maksimizuar performancën dhe minimizuar konsumin e memories.
Mund të takoni bitmapet roaring në aplikacionet më të njohura. Padyshim, ekziston një sasi e madhe implementimesh për gjuhë të ndryshme programimi, duke përfshirë më shumë se tre implementime për Go.
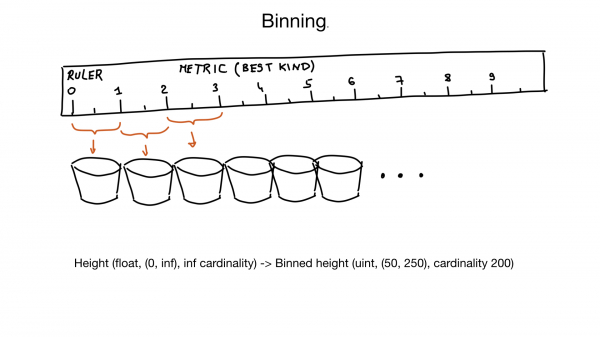
Një qasje tjetër që mund të na ndihmojë të përballojmë kardinalitetin e lartë quhet grupimi (binning). Imagjinoni se keni një fushë që përfaqëson lartësinë e njeriut. Lartësia është një numër me presje të lëvizshme, por ne, njerëzit, nuk mendojmë për të kështu. Për ne nuk ka diferencë nd between lartësia 185.2 cm dhe 185.3 cm.
Duket se mund të grupojmë vlera të ngjashme në grupe brenda 1 cm.
Dhe nëse gjithashtu e dimë se ka shumë pak njerëz që kanë lartësi më të vogël se 50 cm dhe më shumë se 250 cm, atëherë ne mund, në thelb, ta kthejmë një fushë me kardinalitet të pafund në një fushë me kardinalitet prej rreth 200 vlerash.
Sigurisht, nëse është e nevojshme, mund të bëjmë filtrimin e mëtejmë më vonë.
Problemi i kapacitetit të lartë të transmetimit
Problemi tjetër i indekseve bitmap është se përditësimi i tyre mund të jetë shumë i kushtueshëm.
Baza të dhënash duhet të ofrojnë mundësinë për të përditësuar të dhënat në momentin kur potencialisht qindra kërkesa të tjera po kërkojnë për këto të dhëna. Kemi nevojë për lok si për të shmangur problemet me qasjen e përbashkët në të dhëna apo probleme të tjera të aksesit të përbashkët. Dhe atje ku ka një lok të madh, ka një problem — kontestimi i lokut, kur ky lok bëhet ngushticë.
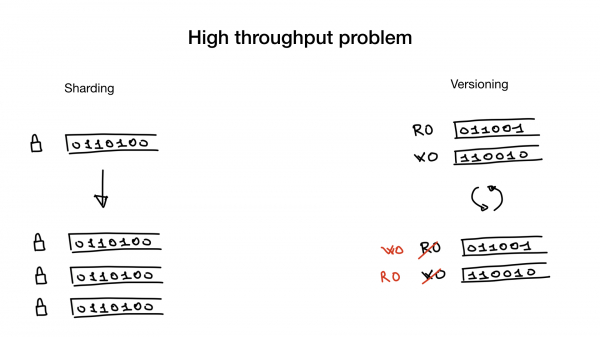
Ky problem mund të zgjidhet ose të kalojë përmes sharding-ut ose përdorimit të indekseve të versionuara.
Sharding-u është një koncept i thjeshtë dhe i njohur. Ju mund të bëni sharding të indekseve bitmap ashtu siç do të bëni sharding për çdo të dhënat tjetër. Në vend të një loku të madh, do të merrni shumë lokë të vegjël dhe kështu do të eliminoni kontestimin e lokut.
Mënyra e dytë për të zgjidhur problemin është përdorimi i indekseve të versionuara. Ju mund të keni një kopje të indeksit që e përdorni për të kërkuar ose lexuar, dhe një tjetër për të shkruar ose përditësuar. Dhe në një interval të caktuar kohor (për shembull, çdo 100 ms ose 500 ms) ju i duploni dhe i ndërroni vendet. Sigurisht, ky qasje është e zbatueshme vetëm në ato raste kur aplikacioni juaj mund të punojë me një indeks kërkimi që ka një vonesë të vogël.
Këto dy qasje mund të përdoren njëkohësisht: ju mund të keni një indeks të versionuar të sharding-uara.
Kërkesat më të ndërlikuara
Problemi i fundit me indekset bitmap është se, siç na thonë, ato nuk janë shumë të përshtatshme për tipe më të ndërlikuara kërkesash, për shembull kërkesave "në interval".
Dhe në të vërtetë, nëse mendojmë për këtë, operacionet bitore si AND, OR etj. nuk janë shumë të përshtatshme për kërkesat si "Më trego hotellet me çmime dhome nga 200 në 300 dollarë për natë".
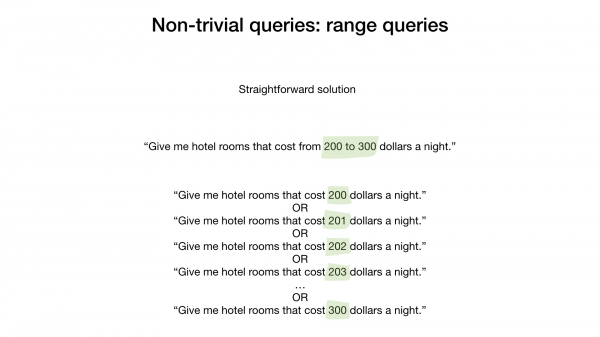
Një zgjidhje naive dhe shumë të pamenduar do të ishte të merrnin rezultatet për çdo vlerë dollarësh dhe t'i bashkoni ato me operacionin bitor OR.
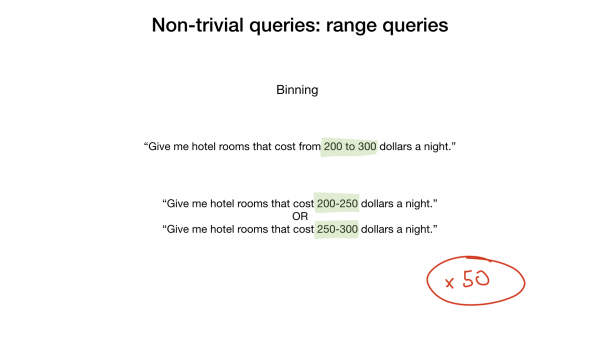
Një zgjidhje pak më e saktë do të ishte të përdornim grumbullim. Për shembull, në grupe prej 50 dollarësh. Kjo do ta përshpejtonte procesin tonë 50 herë.
Por problemi, gjithashtu, zgjidhet lehtësisht duke përdorur një përfaqësim të krijuar posaçërisht për këtë lloj kërkese. Në punimet shkencore, kjo quhet bitmap me kodim range.
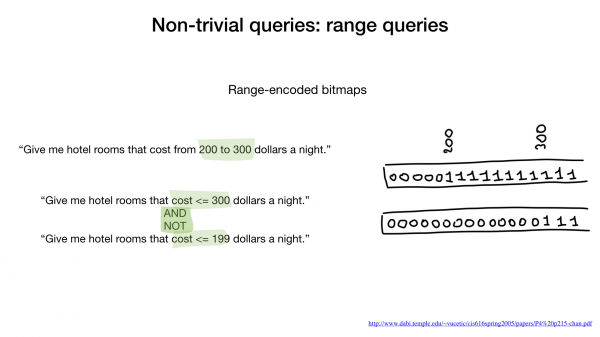
Në një përfaqësim të tillë, ne nuk thjesht vendosim një bit për një vlerë të caktuar (për shembull, 200), por vendosim atë vlerë dhe gjithçka që është më e lartë. 200 dhe më lart. E njëjta gjë për 300: 300 dhe më lart. Dhe kështu me radhë.
Duke përdorur këtë përfaqësim, ne mund të përgjigjemi ndaj këtij lloji kërkese duke kaluar përmes indeksit vetëm dy herë. Së pari, ne do të marrim një listë hotelesh ku çmimi i dhomës është më pak se 300 dollarë, e më pas do ta heqim atë nga lista ku çmimi është më pak se 199 dollarë. E kryer.
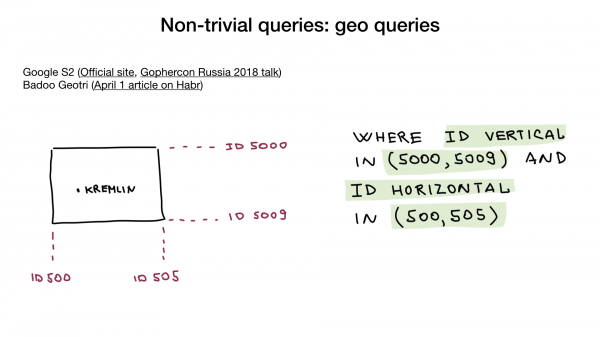
Do të habiteni, por madje kërkesat gjeografike janë të mundshme duke përdorur indeksat bitmap. Hile është të përdorni një përfaqësim gjeografik që rrethon koordinatën tuaj përmes një figure gjeometrike. Për shembull, S2 nga Google. Figura duhet të jetë e mundur të paraqitet si tre ose më shumë vijat që prishin, të cilat mund të numërohen. Kështu ne mund ta kthejmë kërkesën tonë gjeografike në disa kërkesa 'për intervalin' (për këto vijat e numëruara).
Zgjidhje të gatshme
Shpresoj se ju kam interesuar pak dhe që keni marrë një mjet të dobishëm në arsenalin tuaj. Nëse ndonjëherë do t'ju nevojitet të bëni diçka të ngjashme, do të dini drejtimin se ku të shikoni.
Megjithatë, nuk kanë të gjithë kohë, durim dhe burime për të krijuar indeksat bitmap nga e para. Sidomos ato më të avancuara, duke përdorur SIMD, për shembull.
Fatmirësisht, ka disa zgjidhje të gatshme që do t'ju ndihmojnë.
Bitmaps Roaring
Në radhë të parë, ka bibliotekën e asaj fabulante të bitmaps roaring për të cilën kam folur më parë. Ajo përmban të gjitha kontenierët e nevojshëm dhe operacionet bitore që keni nevojë për të krijuar një indeks bitmap të plotë.
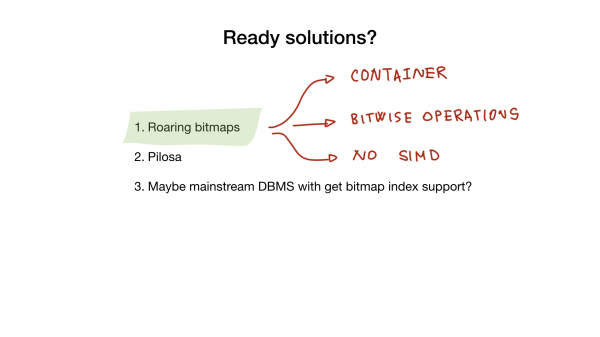
Për fat të keq, për momentin asnjë nga realizimet Go nuk përdor SIMD, çka do të thotë se realizimet Go kanë performancë më të ulët se ato në C, për shembull.
Pilosa
Një produkt tjetër që mund t'ju ndihmojë është DBMS Pilosa, i cili në thelb ka vetëm indeksat bitmap. Ky është një zgjidhje relativisht e re, por po pushton zemrat me një shpejtësi të madhe.
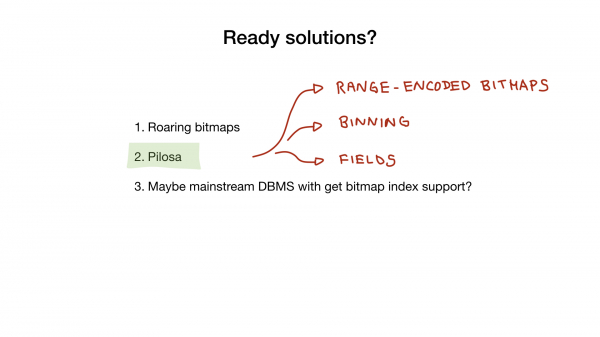
Pilosa përdor bitmap-e të roaring brenda vetes dhe ju jep mundësinë t'i përdorni ato, duke e thjeshtuar dhe shpjeguar të gjitha ato gjëra për të cilat kam folur më lart: grupimi, bitmap-e me kodim range, konceptin e fushës dhe kështu me radhë.
Le të shohim shpejt një shembull të përdorimit të Pilosa për të përgjigjur në një pyetje që ju është njohur më parë.
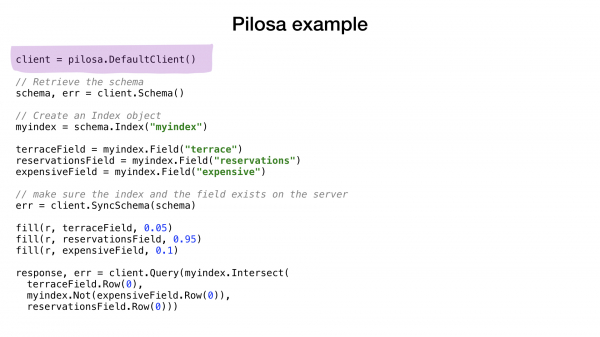
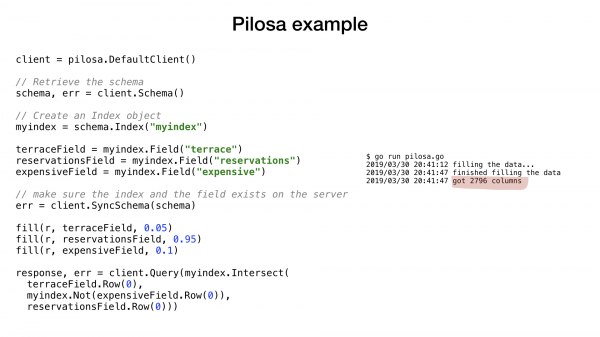
Shembulli është shumë i ngjashëm me atë që keni parë më parë. Ne krijojmë një klient për serverin Pilosa, krijojmë një indeksp dhe fushat e nevojshme, pastaj mbushim fushat tona me të dhëna të rastësishme me probabilitet dhe, në fund, realizojmë kërkesën e njohur.
Pas kësaj, përdorim NOT në fushën "expensive", pastaj e ndërpërsejmë rezultatin (ose AND-ojmë) me fushën "terrace" dhe me fushën "reservations". Dhe në fund, marrim rezultatin përfundimtar.
Shpresoj shumë që në të ardhmen e afërt këtë lloj indeksi të ri — bitmap-indeksi — do ta kemi gjithashtu në DBMS si MySQL dhe PostgreSQL.
Përfundim
Nëse ende nuk jeni zgjuar, faleminderit. Më duhej të preka shpejt shumë tema për shkak të kohës së kufizuar, por shpresoj që prezantimi ishte i dobishëm dhe ndoshta edhe motivues.
Është mirë të dihet për bitmap-indeksin, edhe nëse nuk ju nevojiten menjëherë. Le të jenë një mjet tjetër në kutinë tuaj.
Ne kemi shqyrtuar truket e ndryshme për rritjen e performancës për Go dhe ato gjëra që kompajleri Go ende nuk i trajton shumë mirë. Kjo është absolutisht diçka e dobishme për çdo programues në Go.
Kjo është gjithçka që doja të flisja. Faleminderit!
Burimi: habr.com
