

Aktualisht, shërbimi "Bitrix24" nuk ka qindra gigabit trafik, as një park të madh serverash (edhe pse ekzistojnë disa). Por për shumë klientë, ai është instrumenti kryesor i punës në kompani, një aplikacion që është thelbësor për biznesin. Prandaj, nuk duhet të dështojë. Por çfarë nëse ndodhi një rënie dhe shërbimi u rikuperua kaq shpejt sa askush nuk e vuri re? Si realizohet kjo mbrojtje pa humbje të cilësisë së punës dhe numrit të klientëve? Aleksandër Demidov, drejtor i drejtimit të shërbimeve cloud të "Bitrix24", na tregoi për blogun tonë se si është evoluar sistemi i rezervimit në 7 vitet e ekzistencës së produktit.
Ne lançuam "Bitrix24" 7 vjet më parë në formatin SaaS. Sfidën kryesore, ndoshta, e kishte në këtë: para lançimit të tij në publik si SaaS, ky produkt ekzistonte thjesht në formatin e zgjidhjes me kutinë. Klientët e blejnë nga ne, e instalonin në serverat e tyre, krijonin portalin korporativ - një zgjidhje e përbashkët për komunikimin mes punonjësve, ruajtjen e skedarëve, menaxhimin e detyrave, CRM, gjithë këto. Dhe ne vendosëm në vitin 2012 që do të donim ta lançonim këtë si SaaS, duke e administruar vetë, duke siguruar qëndrushmëri dhe besueshmëri. Eksperiencën e kemi fituar gjatë procesit, sepse deri në atë kohë thjesht nuk e kishim - ishim vetëm prodhues të programeve, jo ofrues shërbimesh.
Kur lancuam shërbimin, e dinim se gjëja më e rëndësishme ishte të siguronim qëndrushmëri, besueshmëri dhe përhershmëri të aksesit në shërbim, sepse nëse keni një faqe të zakonshme, një dyqan, për shembull, dhe ajo dështon për një orë - ju vetëm vuani, humbni porosi, humbni klientë, por për klientin tuaj - për të nuk është shumë kritike. Sigurisht, ai do të shqetësohet, por do të shkojë dhe do të blejë në një tjetër faqe. Por nëse është një aplikacion, mbi të cilin mbështetet e gjithë puna brenda kompanisë, komunikimi, vendimmarrja, ajo që është thelbësore - është të fitojmë besimin e përdoruesve, pra, të mos i lëmë ata pas dhe të mos dështojmë. Sepse e gjithë puna mund të ndalet nëse diçka brenda nuk funksionon.
Bitrix.24 si SaaS
Prototipi i parë e kemi mbledhur një vit para lançimit publik, në vitin 2011. E mbledhëm për rreth një javë, e shikuam, e testuam – madje ishte funksional. Domethënë, mund të hynim në formë, të shkruanim emrin e portalit, dhe krijohej një portal i ri, duke u hapur baza e përdoruesve. E shikuam, e vlerësuam produktin në përgjithësi, e mbyllëm, dhe kaluam një vit duke e përmirësuar. Sepse kishim një detyrë të madhe: nuk donim të bënim dy baza kode të ndryshme, nuk donim të mbështetnim veçmas produktin kutinë, veçmas zgjidhjet cloud – donim të bënim gjithçka brenda një kodi.
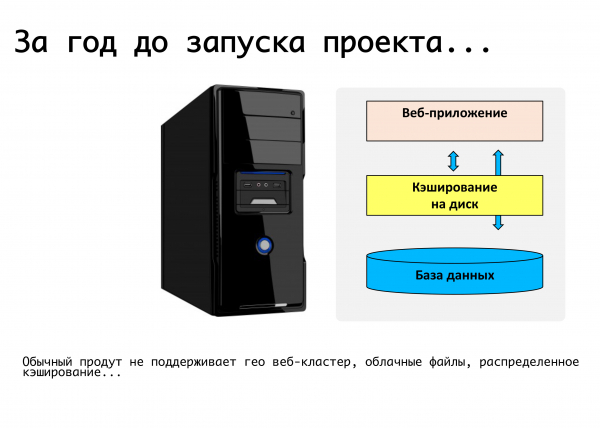
Një aplikacion tipik web në atë kohë është një server, në të cilin shkojmë një kod php, baza mysql, skedarët ngarkohen, dokumentet, fotografitë vendosen në dosjen upload – dhe gjithçka funksionon. Fatkeqësisht, nuk është e mundur të lansosh një shërbim web kritik që mbështetet në këtë. Aty nuk mbështetet caching i shpërndarë, nuk mbështetet replikimi i bazave të të dhënave.
Ne formuluam kërkesat: të jemi në gjendje të vendosim në lokacione të ndryshme, të mbështesim replikimin, në ideal të vendosim në qendra të dhënash që janë gjeografikisht të shpërndara. Të ndahet logjika e produktit dhe, konkretisht, ruajtja e të dhënave. Të jemi në gjendje të zgjeroheshim dinamikisht sipas ngarkesës, statikën ta transferojmë tërësisht. Nga këto arsyetim, u formuan në thelb kërkesat për produktin që ne pikërisht gjatë vitit i përmirësuam. Në këtë kohë, në platformën që rezultoi të ishte e njëjtë – për zgjidhjet kutinë, për shërbimin tonë të vet – realizuam mbështetje për gjërat që na ishin të nevojshme. Mbështetje për replikimin mysql në nivelin e produktit: domethënë, zhvilluesi që shkruan kod – nuk mendohet se si do të shpërndahen kërkesat e tij, ai përdor API-në tonë, dhe ne dimë të shpërndajmë saktësisht kërkesat për të shkruar dhe për të lexuar mes masterave dhe slaveve.
Ne realizuam mbështetje në nivelin e produktit për ruajtjet e objektit cloud të ndryshme: google storage, amazon s3 – përveç kësaj, mbështetje për open stack swift. Kjo ishte e përshtatshme për ne si shërbim dhe për zhvilluesit që punojnë me zgjidhje kutie: nëse ata përdorin thjesht API-në tonë për punë, ata nuk mendojnë se ku në fund do të ruhen skedarët, në sistemin lokal të skedarëve apo do të përfundojnë në ruajtjen e skedarëve të objektit.
Në fund vendosëm menjëherë që do të rezervonim në nivelin e tërë qendrës së të dhënave. Në vitin 2012, ne u lansuam plotësisht në Amazon AWS, pasi kishim përvojë të punës me këtë platformë — faqja jonë e vetme ishte aty. Na tërheqte fakti që në çdo rajon në Amazon ka disa zona disponueshmërie — në thelb, (në terminologjinë e tyre) disa qendra të të dhënave, të cilat janë më shumë ose më pak të pavarura nga njëra-tjetra dhe na lejojnë të rezervojmë në nivelin e tërë qendrës së të dhënave: nëse ajo ndonjëherë dështon, bazat replikohen master-master, serverët e aplikacioneve të uebit janë të rezervuar, dhe statika është transferuar në sistemin e ruajtjes objektive s3. Ngarkesa balancohet — në atë kohë nga elb i Amazon, por pak më vonë erdhëm tek balancuesit tanë, sepse na duhej një logjikë më e komplikuar.
Çfarë donim - atë morëm...
Të gjitha gjërat bazike që ne donim të siguroheshim - qëndrueshmëria e vetë serverëve, aplikacioneve ueb, bazave të të dhënave - gjithçka funksiononte mirë. Scenari më i thjeshtë: nëse na dështon ndonjë nga aplikacionet e uebit, atëherë gjithçka është e thjeshtë - ato fikën nga balancimi.
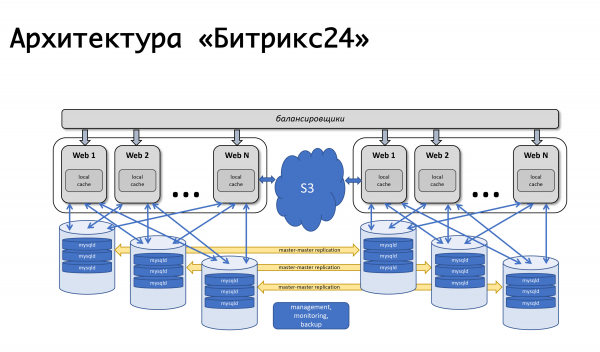
Makinat e dalë jashtë funksionit balancuesi (atëherë ishte elb i Amazon) i shënonte automatikisht si unhealthy, ndalte shpërndarjen e ngarkesës te ato. Punonte auto-skalimi i Amazon: kur ngarkesa rritej, makina të reja shtoheshin në grupin e auto-skalimit, ngarkesa shpërndahej te makinat e reja - gjithçka ishte mirë. Me balancuesit tanë logjika është më pak e njëjtë: nëse ndodh diçka me serverin e aplikacioneve, ne heqim kërkesat nga ai, heqim këto makina, nisëm të reja dhe vazhdojmë të punojmë. Schema për gjithë këto vite ka ndryshuar pak, por vazhdon të funksionojë: ajo është e thjeshtë, e qartë, dhe nuk ka asnjë vështirësi me këtë.
Ne punojmë në mbarë botën, kulmet e ngarkesës te klientët janë krejtësisht të ndryshme, dhe, në thelb, duhet të kemi mundësinë të kryejmë ato ose ato punime shërbimi me çdo komponent të sistemit tonë në çdo kohë – pa u vënë re nga klientët. Prandaj kemi mundësinë të fikim nga puna bazën e të dhënave, duke shpërndarë ngarkesën në qendrën e dytë të të dhënave.
Si si ndihmoni që të gjithçka të funksionojë? — Ne transferojmë trafikun në qendrën e të dhënave që punon — nëse ka një emergjencë në qendrën e të dhënave, atëherë e bëjmë plotësisht, nëse janë punët tona të planifikuara me ndonjë bazë specifike, atëherë ne transferojmë pjesën e trafikut që shërben për ato klientë në qendrën e dytë të të dhënave dhe ndërpresim replikimin. Nëse ne na nevojiten makina të reja për aplikacionet web, pasi është rritur ngarkesa në qendrën e dytë të të dhënave, ato fillojnë automatikisht. Përfundojmë punët, rivendosim replikimin dhe kthejmë gjithë ngarkesën prapa. Nëse na duhen të kryejmë ndonjë punë të dyfishtë në qendrën e dytë të të dhënave, për shembull, të instalojmë përditësime sistemike ose të ndërruam cilësimet në bazën e të dhënave të dytë, atëherë, në përgjithësi, përsërisim të njëjtat procedura, thjesht në drejtimin tjetër. Dhe nëse ka një emergjencë, ne vepruam në mënyrë të thjeshtë: në sistemin e monitorimit përdorim mekanizmin e event-handlers. Nëse disa kontrolla aktivizohen dhe statusi kalon në kritike, atëherë nisi ky handler, përpunuesi, i cili mund të ekzekutojë logjikën përkatëse. Për çdo bazë të dhënash kemi të përshkruar se cili server është për të dhe ku duhet transferuar trafiku në rast se ajo nuk është e qasshme. Ne — siç ndodhi historikisht — përdorim në një formë ose një tjetër Nagios ose ndonjë nga degëzimet e tij. Në parim, mekanizma të tillë ka pothuajse në çdo sistem monitorimi, nuk po përdorim diçka më të komplikuar deri tani, por ndoshta një ditë do ta bëjmë. Tani monitorimi aktivizohet në rast të papërshtatshmërisë dhe ka mundësinë për të transferuar diçka.
A kemi rezervuar gjithçka?
Ne kemi shumë klientë nga SHBA, shumë klientë nga Evropa, shumë klientë që janë më afër Lindjes — Japoni, Singapor dhe kështu me radhë. Sigurisht, një pjesë e madhe e klientëve është në Rusi. Pra, puna nuk përfshin vetëm një rajon. Përdoruesit dëshirojnë reagim të shpejtë, ka kërkesa për respektimin e ligjeve të ndryshme lokale, dhe brenda çdo regjioni ne rezervojmë dy qendra të të dhënave, plus ka disa shërbime shtesë që gjithashtu janë të përshtatshme të vendosen brenda një rajoni — për klientët që punojnë në atë rajon. Menaxherët REST, serverët e autorizimit, janë më pak kritikë për punën e klientit si një e tërë, për ta mund të kaloni me një vonesë të pranueshme, por nuk dëshirojmë të shpikim biçikleta, si t'i monitorojmë dhe çfarë të bëjmë me to. Prandaj, ne përpiqemi maksimalisht të përdorim zgjidhjet ekzistuese, dhe jo të zhvillojmë ndonjë kompetencë për produkte shtesë. Diku përdorim thjesht kalimin në nivelin dns, dhe përveç kësaj, caktimin e shërbimit e përcaktojmë me të njëjtin dns. Në Amazon ka shërbimin Route 53, por kjo nuk është vetëm dns, ku mund të regjistroni disa shënime dhe mbaroi — ai është shumë më fleksibël dhe i përshtatshëm. Nëpërmjet tij, mund të krijoni shërbime të shpërndara gjeo-me gjeolokacione, kur me ndihmën e tij përcaktoni nga erdhi klienti dhe i jepni ato ose ato shënime — me ndihmën e tij mund të ndërtoni arkitektura failover. Po ashtu kontrollet e shëndetit konfigurohen në vetë Route 53, ju caktoni endpointet që monitorohen, caktoni metrikat, caktoni se me çfarë protokollesh të përcaktoni "jetësinë" e shërbimit — tcp, http, https; caktoni periodicitetin e kontrolleve që përcaktojnë, nëse shërbimi është aktiv apo jo. Dhe në vetë dns, ju shkruani se çfarë do të jetë primar, çfarë do të jetë sekondar, ku do të kaloni nëse funksionon kontrolli i shëndetit brenda route 53. Të gjitha këto mund të bëhen me disa mjetet të tjera, por ajo që është e përshtatshme — e konfiguroni një herë dhe pastaj nuk mendojmë fare për se si bëhen kontrollimet, si ndodh kalimi: gjithçka funksionon vetë.
E para "por": si dhe me çfarë rezervojmë vetë route 53? Bëhet fjalë, ndonjëherë ndodh ndonjë incident me të? Fatmirësisht, asnjëherë nuk kemi hasur në këtë problem, por përsëri, do të kem një rrëfim përse menduam se duhet të rezervonim. Këtu po e mbulojmë terrenin paraprakisht. Disa herë në ditë, ne bëjmë një eksport të plotë të të gjitha zonave që kemi krijuar në route 53. API i Amazon e lejon të dhënat të dërgohen në JSON, dhe ne kemi ngritur disa serverë rezervë ku e konvertojmë, e eksportojmë në formë konfigurimesh dhe kemi, thjesht, një konfigurim backup. Në rast se ndodh ndonjë gjë, ne mund ta rindërtojmë atë me dorë shpejt, pa humbur të dhënat e konfigurimeve dns.
Porosia e dytë: çfarë tjetër nuk është rezervuar në këtë skenar? Balancuesi vetë! Ne kemi ndarjen e klientëve sipas rajoneve bërë shumë thjesht. Kemi disa domenë si bitrix24.ru, bitrix24.com, .de — tani janë rreth 13 të ndryshëm, të cilët punojnë në zona shumë të ndryshme. Arritëm në përfundimin se në çdo rajon ka balancues të vet. Kështu është më e lehtë të ndahen sipas rajoneve, në varësi të ngarkesës maksimale në rrjet. Nëse ka një gabim në nivelin e ndonjë balancuesi, ai thjesht përjashtohet nga përdorimi dhe hiqet nga dns. Nëse ndodh ndonjë problem me grupin e balancuesve, ata rezervohen në platformat e tjera, dhe kalimi midis tyre bëhet me anë të route53, sepse për shkak të ttl të shkurtër, kalimi ndodh maksimumi brenda 2, 3, 5 minutash.
Porosia e tretë: çfarë tjetër nuk është rezervuar? S3, e saktë. Ne, kur vendosim skedarët që ruajmë për përdoruesit në s3, kemi besuar sinqerisht se është mbi çdo kërkesë dhe nuk ka nevojë për rezervim atje. Por historia tregon se ndodhin ndryshe gjërat. Në përgjithësi, Amazon e përshkruan S3 si një shërbim thelbësor, sepse vetë Amazon përdor S3 për ruajtjen e imazheve të makinave, konfigurimeve, imazheve AMI, snapshot-eve... Dhe nëse S3 dështon, siç ka ndodhur një herë gjatë këtyre 7 viteve që e përdorim bitrix24, ai merr me vete shumë gjëra — pamundësinë e fillimit të virtualkave, gabim në funksionimin e api-së dhe kështu me radhë.
Edhe S3 mund të dështojë - ndodhi njëherë. Prandaj, ne arritëm në skemën e ardhshme: disa vite më parë nuk kishte ruajtje publike të objekteve serioze në Rusi, dhe ne po shqyrtonim mundësinë për të bërë diçka tonën... Për fat, nuk e filluam këtë, pasi do të ishim në vështirësi me ekspertizën që nuk e kishim dhe sigurisht do të kishim gabuar. Tani, ka ruajtje që janë të pajtueshme me s3 nga Mail.ru, ka nga Yandex dhe disa ofrues të tjerë. Në fund, arritëm në përfundimin se dëshironim të kishim, nga njëra anë, rezervim dhe, nga ana tjetër, mundësinë për të punuar me kopje lokale. Për rajonin konkret rus, ne përdorim shërbimin Mail.ru Hotbox, i cili është i pajtueshëm me s3 përmes api. Nuk na nevojiteshin ndryshime të mëdha në kodin e brendshëm të aplikacionit, dhe ne krijuam mekanizmin e mëposhtëm: në s3 ka sinjale, të cilat aktivizohen kur krijohen/fshihen objekte, Amazon ka një shërbim të tillë si Lambda - kjo është një mënyrë për të ekzekutuar kod pa server, e cila do të ekzekutohet kur të aktivizohen ato sinjale të caktuara.
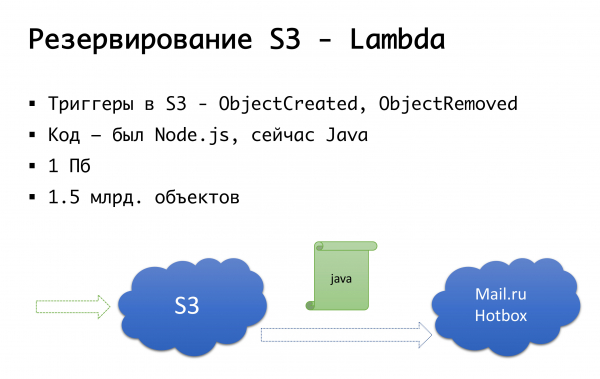
E bëmë shumë thjesht: nëse aktivizohet një sinjal, ne ekzekutojmë kodin që kopjon objektin në ruajtjen e Mail.ru. Për të filluar plotësisht punën me kopjet lokale të të dhënave, na nevojitet gjithashtu një sinkronizim prapavijë, në mënyrë që klientët që ndodhen në segmentin rus të mund të punojnë me ruajtjen e cila është më afër tyre. Mail sapo ka përfunduar shtesat e sinjalizimeve në ruajtjen e tij - do të jetë e mundur për të ekzekutuar sinkronizimin prapavijë në nivelin e infrastrukturës, për momentin ne e bëjmë këtë në nivelin e kodit tonë. Nëse shohim se një klient ka vendosur një skedar, atëherë ne në nivelin tonë të kodit vendosim një ngjarje në radhë, e procesojmë atë dhe kryejmë replikimin prapavijë. Çfarë është problematike: nëse ndodhin ndonjë aktivitet me objektet tona jashtë produktit tonë, do të thotë me ndihmën e disa mjeteve të jashtme, ne nuk do ta marrim parasysh. Prandaj ne po presim deri në fund, kur të shfaqen sinjalizimet në nivelin e ruajtjes, që në mënyrë të pavarur nga vendi ku e ekzekutuam kodin, objekti që na erdhi të kopjohet në anën tjetër.
Në nivelin e kodit, për çdo klient regjistrojmë të dy depozitat: njëra konsiderohet kryesore, tjetra si rezervë. Nëse gjithçka shkon mirë, punojmë me atë depozitë që është më afër: pra, klientët tanë që janë në Amazon, përdorin S3, ndërsa ata që punojnë në Rusi, përdorin Hotbox. Nëse ndizet sinjali, duhet të aktivizohet failover, dhe ne i kalojmë klientët në një depozitë tjetër. Ne mund ta vendosim këtë sinjal në mënyrë të pavarur sipas rajoneve dhe t’i switchojmë aty-këtu. Në praktikë akoma nuk e kemi përdorur, por mekanizmi është parashikuar dhe mendojmë se një herë do na nevojitet kalimi dhe do të jetë i dobishëm. Një herë ka ndodhur tashmë.
O, por Amazon u largua nga ju...
Ky prill shënon përvjetorin e fillimit të bllokimeve të Telegram në Rusi. Operatori më i goditur nga kjo është Amazon. Dhe, fatkeqësisht, kompanitë ruse të cilat punonin për të gjithë botën kanë pasur më shumë humbje.
Nëse kompania është globale dhe Rusia për të është një segment shumë i vogël, 3-5% — kështu ose ndryshe, mund të sakrifikohen.
Nëse kjo është një kompani që punon vetëm në Rusi — jam i sigurt se duhet të pozicionohet lokal — thjesht për përdoruesit do të jetë më e lehtë, komode, dhe do të ketë më pak rreziqe.
Dhe nëse kjo është një kompani që punon globalisht, dhe ka përafërsisht një numër të barabartë klientësh nga Rusia dhe nga vende të tjera? Lidhshmëria e segmenteve është e rëndësishme, dhe ata duhet të punojnë së bashku në një mënyrë ose në një tjetër.
Në fund të marsit 2018, Roskomnadzor dërgoi një letër operatoreve më të mëdhenj, duke njoftuar se kishin ndërmend të bllokonin disa miliona IP të Amazon, për të bllokuar… mesazherin Zello. Falë këtyre operatorëve, ata përhapën letrën, dhe ndodhi e kuptuar se lidhshmëria me Amazon mund të prisheshin. Ishte e premte, ne u futëm në panik te kolegët tanë nga servers.ru, me fjalët: “Miq, na duhen disa servera, që do të jenë jo në Rusi, jo në Amazon, por, për shembull, diku në Amsterdam”, për të pasur mundësi të paktën për ndonjë mënyrë të vendosim atje tonat. vpn dhe proxy për disa endpointë, të cilët nuk mund t'i ndihmojmë në asnjë mënyrë, për shembull, endpointët e atij s3 — nuk mund të përpiqemi të krijojmë një shërbim të ri dhe të marrim një IP tjetër, ne gjithmonë duhet të arrijmë atje. Në disa ditë ne e konfiguram këto serverë, i ngritëm, dhe në përgjithësi, deri në momentin e fillimit të bllokimeve ishim përgatitur. Është interesante se RKN, duke parë bujën dhe panikun e shkaktuar, tha: "Jo, tani nuk do të bllokojmë asgjë". (Por kjo ishte pikërisht deri në momentin kur filluan të bllokonin Telegram). Pas konfigurimit të mundësive për të kaluar bllokimin dhe duke kuptuar se blokoja nuk u vendos, megjithatë, ne nuk e analizuam shumë këtë situatë. Thjesht për rast emergjente.
Dhe kështu, në vitin 2019 ne jetojmë në kushte bllokimesh. Unë dje në mbrëmje po shikoja: rreth një milion IP vazhdojnë të bllokohen. Megjithatë, Amazon u rivendos në tërësi, gjatë pikës arriti deri në 20 milion adresash… Në përgjithësi, realiteti është se lidhshmëria, një lidhshmëri e mirë — mund të mos ekzistojë. Papritur. Ajo mund të mos ekzistojë për arsye teknike — zjarre, ekskavatorë, çdo gjë e tillë. Ose, siç e pamë, për arsye jo krejtësisht teknike. Prandaj, ndoshta, dikush i madh dhe i fuqishëm, me AS-të e tij, mund të menaxhojë ndryshe, — direkt lidhje dhe gjëra të tjera tashmë në nivelin l2. Por, në variantin e thjeshtë, si ne apo ndokush më i vogël, është e dobishme të kemi rezervar në nivelin e serverëve, të ngritur diku tjetër, me VPN të konfigurara paraprakisht, proxy, me mundësinë për të kaluar shpejt në konfigurimin e atyre segmenteve që janë kritike për lidhshmërinë tuaj. Kjo na ka ndihmuar disa herë, kur filluan bllokimet e Amazon, ne e kaluam në rastin më të keq pikërisht trafikun S3, por gradualisht gjithçka u zgjidh.
Si të rezervohet… një të gjithë ofruesin?
Aktualisht, ne nuk kemi një skenar për rënien e të gjithë Amazon. Ne kemi një skenar të ngjashëm për Rusinë. Ne kemi përdorur një furnizues në Rusi, nga i cili zgjodhëm disa vende. Dhe një vit më parë, përballëm me një problem: pavarësisht se ishin dy qendra të të dhënave, në nivelin e konfigurimit të rrjetit të furnizuesit mund të kishte probleme që do të preknin të dyja qendrat e të dhënave. Dhe mund të përjetonim mungesë aksesi në të dy vendet. Sigurisht, ashtu ndodhi. Ne përfundimisht rivlerësuam arkitekturën tonë. Ajo nuk ka ndryshuar shumë, por tani në Rusi kemi dy vende që nuk janë tek një furnizues, por tek dy të ndryshëm. Nëse ndonjëherë ndodh një defekt në njërin, ne mund të kalojmë te tjetri.
Hipotetikisht, ne për Amazon jemi duke shqyrtuar mundësinë e rezervimit në nivelin e një furnizuesi tjetër; ndoshta Google, ndoshta dikush tjetër... Por deri tani kemi vëzhguar në praktikë se nëse ndodhin aksidente në nivelin e një zone të disponueshmërisë të Amazon, aksidentet në nivelin e një regioni të tërë janë një fenomen mjaft të rrallë. Prandaj, teorikisht kemi një ide se ndoshta do të bëjmë rezervimin "Amazon - jo Amazon", por në praktikë, deri tani nuk ka ndodhur.
Një fjalë për automatizimin
A është gjithmonë e nevojshme automatizimi? Këtu është e përshtatshme të kujtojmë efektin Dunning-Kruger. Në boshtin "x" janë njohuritë dhe eksperienca që ne grumbullojmë, dhe në boshtin "y" - besimi në veprimet tona. Fillimisht nuk dimë asgjë dhe nuk jemi të sigurt. Më pas, dimë ca dhe bëhemi mega të sigurt - kjo quhet "pikë e marrëzisë", e ilustruar mirë me imazhin "budallallëku dhe guximi". Pastaj, kemi mësuar pak dhe jemi gati të shkojmë në betejë. Më pas, hasim ndonjëherë në disa probleme serioze, përfundojmë në luginën e dëshpërimit, kur duket se dimë diçka, por në të vërtetë nuk dimë shumë. Pastaj, me sa më shumë përvojë, bëhemi më të sigurtë.
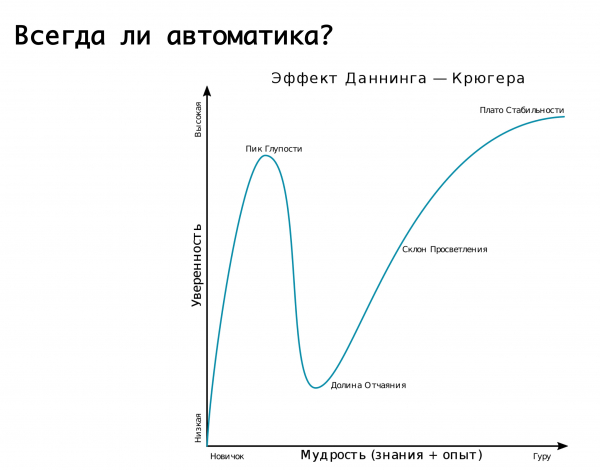
Logjika jonë për kalimet e ndryshme automatike në aksidente të caktuara përshkruhet shumë mirë nga kjo grafike. Ne filluam — nuk dinim asgjë, pothuajse gjithë punët bënin manualisht. Më pas, e kuptuam se mund të instalonim automatizim për gjithçka dhe, në thelb, të flinim qetë. Papritmas, përballëm një ndarje të madhe: na ndodhi një false positive dhe ne kalonim trafikun aty-këtu, kur, me të vërtetë, është e panevojshme ta bëjmë këtë. Si pasojë, ndodhnin probleme me replikimin ose diçka tjetër — kjo është vallja e dëshpërimit. Dhe pastaj arrijmë në kuptimin se duhet t'i qasemi gjithçkaje me mend. Kjo do të thotë se ka kuptim të mbështetemi në automatizim, duke parashikuar mundësinë e gabimeve të rreme. Por! nëse pasojat mund të jenë shkatërruese, atëherë është më mirë t'i lëmë ato në duar të ekipit të ndihmës, inxhinierëve në detyrë, të cilët do të sigurojnë dhe verifikojnë, me të vërtetë, nëse ka një aksident dhe se veprimet e nevojshme do të kryhen me dorë...
Përfundim
Gjatë 7 vjetëve, ne kaluam nga panika panikisht kur ndodhte ndonjë rënie, në kuptimin se problemet nuk ekzistojnë, por ka vetëm detyra që duhet t'i zgjidhni — dhe që është e mundur. Kur ndiheni për të ndërtuar një shërbim, shikoni atë nga një këndvështrim më të lartë, vlerësoni të gjitha rreziqet që mund të ndodhin. Nëse i parashikoni ato menjëherë — atëherë parashikoni rezerva dhe mundësinë e ndërtimit të një infrastrukture të qëndrueshme, sepse çdo pikë që mund të dështoje dhe të çonte në mosfunksionimin e shërbimit — sigurisht do ta bëjë këtë. Edhe nëse ju duket se disa elemente të infrastrukturës sigurisht nuk do të dalin jashtë funksionit — si p.sh. s3, prapëseprapë, mbani mend se ata mund të dështojnë. Dhe të paktën në teori, keni një ide për atë që do të bëni me ta nëse diçka ndodh. Keni një plan për menaxhimin e rreziqeve. Kur mendoni se të bëni gjithçka me automatizim ose manualisht — vlerësoni rreziqet: çfarë do të ndodhë nëse automatizimi fillon të kalojë gjithçka — a do të çojë kjo në një situatë akoma më të keqe krahasuar me një aksident? Ndoshta, në disa raste, duhet të përdorni një kompromis të arsyeshëm midis përdorimit të automatizimit dhe reagimit të inxhinierëve në detyrë, të cilët do të vlerësojnë situatën reale dhe do të kuptojnë nëse duhet të kalojnë diçka menjëherë ose "po, por jo tani".
Një kompromis i arsyeshëm mes përsosmërisë dhe forcave reale, kohës, parave që mund të shpenzoni për skemën që do të keni në fund.
Ky tekst është një version i zgjeruar dhe i plotësuar i raportit të Aleksandër Demidov në konferencë .
Burimi: habr.com
