

Në vjeshtën e vitit 2019, ekipi i Cloud në iOS në Mail.ru përjetoi një ngjarje të pritur me padurim. Baza kryesore e të dhënave për ruajtjen e qëndrueshme të gjendjes së aplikacionit u bë një zgjidhje mjaft ekzotike për botën mobile. (LMDB). Nëse dëshironi, ofrohet një përmbledhje e detajuar e saj në katër pjesë. Së pari, do të flasim për arsyet e kësaj zgjedhjeje jo triviale dhe të vështirë. Më pas, do të shqyrtojmë tre kolonat e arkitekturës LMDB: skedarët e mapuar në memorie, B+-druri, qasja copy-on-write për realizimin e transaksionalitetit dhe multiversionit. Për fund, do të shqyrtojmë aspektet praktike. Në të, do të shohim se si të dizajnojmë dhe realizojmë një skemë të bazës mbi një API të ulët key-value, duke përfshirë tabelat indeks.
Përmbajtja
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivimi për zbatimin
Njëherë në vitin 2015, ne u shqetësuam për të matur se sa shpesh ndërfaqja e aplikacionit tonë kishte vonesa. Ne e morëm këtë sipas rekomandimeve. Kemi pasur një rritje të ankesave se ndonjëherë aplikacioni ndalonte së reaguar ndaj veprimeve të përdoruesit: butonat nuk përgjigjeshin, listat nuk rrodheshin, etj. Ndërsa flas për mekanikën e matjeve, në AvitoTech, kështu që këtu jap vetëm rendin e shifrave.
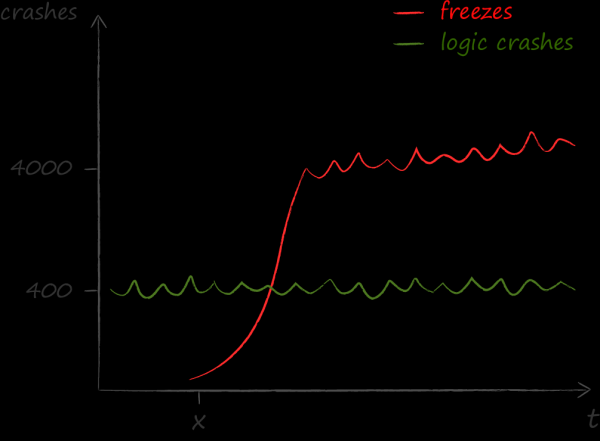
Rezultatet e matjeve ishin një shok i ftohtë për ne. U zbulua se problemet, të shkaktuara nga ngritjet, ishin shumë më të shumta se çdo problem tjetër. Nëse përpara realizimit të këtij fakti, treguesi kryesor teknik i cilësisë ishte pa crash, pas kësaj fokusi në freeze free.
Pas ndërtimit dhe pas realizimit të dhe të shkaqeve të tyre, u bë e qartë armiku kryesor - logjika e rëndë biznesore, e cila ekzekutohej në rrjedhën kryesore të aplikacionit. Reagimi natyror ndaj këtij problemi ishte dëshira e ndezur për ta shpërndarë atë në rrjedhat e punës. Për zgjidhjen sistematike të kësaj problemi, ne u mbështetëm në arkitekturën shumëthjeshtore mbi bazën e aktorëve të lehtë. I dedikova në Twitter-in kolektiv dhe . Në kuadër të narrativës aktuale, dëshiroj të theksoj ato aspekte të zgjidhjes që ndikuan në zgjedhjen e bazës së të dhënave.
Modeli aktorëve të organizimit të sistemit supozon se shumëthithmëria bëhet thelbi i tij i dytë. Objektet e modelit në të pëlqejnë të kalojnë kufijtë e thread-eve. Dhe ata e bëjnë këtë jo ndonjëherë dhe në disa vende, por praktikisht vazhdimisht dhe kudo.
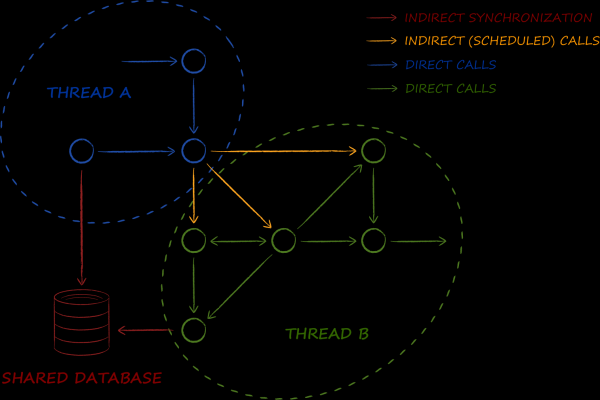
Baza e të dhënave është një nga komponentët thelbësorë në skemën e paraqitur. Detyra e saj kryesore është realizimi i makropaternës. . Nëse në botën e sipërmarrjeve me ndihmën e saj organizohet sinkronizimi i të dhënave ndërmjet shërbimeve, në rastin e arkitekturës aktorëve – të dhënat ndërmjet thread-eve. Kështu, na duhej një bazë të dhënash e tillë, puna me të cilën në një mjedis shumëthithmëror nuk shkakton as edhe minimumin e vështirësive. Në veçanti, kjo do të thotë se objektet e marra prej saj duhet të jenë të paktën të sigurta për thread-in, dhe idealisht edhe krejtësisht të patëmetme. Siç dihet, këto të fundit mund të përdoren njëkohësisht nga disa thread-e, pa u mbështetur në ndonjë bllokim, gjë që ndikon ndjeshëm në performancë.
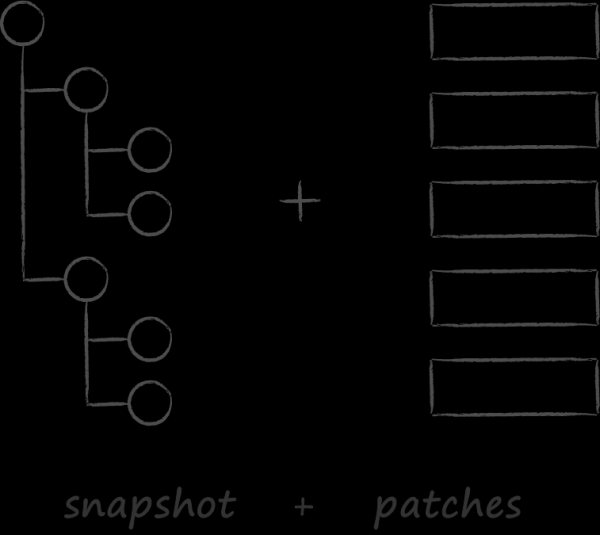 Faktori i dytë i rëndësishëm që ndikoi në zgjedhjen e bazës së të dhënave ishte API ynë cloud. Ai ishte i frymëzuar nga qasja ndaj sinkronizimit që u miratua në git. Siç është ai, ne synonim në , i cili për klientët cloud duket më se i përshtatshëm. Supozohej se ata do ta shkarkonin vetëm një herë gjendjen e plotë të cloud-it dhe më pas sinkronizimi në shumicën e rasteve do të ndodhte përmes aplikimit të ndryshimeve. Fatkeqësisht, kjo mundësi ende qendron vetëm në zonën teorike, dhe në praktikë klientët nuk mësuan asnjëherë të punojnë me patch-et. Kështu, ka disa arsye objektive që, për të mos e zgjatur hyrjen, do t'i lëmë jashtë diskutimit. Tani, një interes më i madh përfaqëson përfundimet e edukueshme të mësimit se çfarë ndodh kur API tha "A", dhe konsumatori i tij nuk tha "B".
Pra të themi, nëse e imagjinoni git, i cili kur ekzekuton komandën pull, në vend të aplikimit të patches në snapshot-in lokal, krahasohet me gjendjen e plotë të serverit, atëherë do të keni një përshkrim mjaft të saktë se si ndodh sinkronizimi në klientët e cloud. Nuk është e vështirë të kuptohet se për ta realizuar këtë është e nevojshme të alokoni në memorie dy pemë DOM me metainformacion rreth të gjitha skedareve të serverit dhe atyre lokale. Pra, nëse përdoruesi mban 500 mijë skedare në cloud, për sinkronizimin e tij do të duhet të rindërtohen dhe shkatërrohen dy pemë me 1 milion nodet. Dhe çdo nod është një agregat që përmban një grafik subjektesh. Në këtë kontekst, rezultatet e profilizimit ishin të pritshme. U zbulua se edhe pa marrë parasysh algoritmën e bashkimit, procedura për krijimin dhe shkatërrimin e një sasi të madhe objektesh të vogla në vetvete shpenzon para. Situata përkeqësohet nga fakti se operacioni bazë i sinkronizimit është i përfshirë në shumë skenarë përdoruesish. Si rezultat, regjistrojmë kriterin e dytë të rëndësishëm në zgjedhjen e një baze të dhënash — mundësinë e realizimit të operacioneve CRUD pa alokimin dinamik të objekteve.
Kërkesat e tjera janë më tradicionale dhe lista e tyre është si më poshtë.
- Siguria e rrjedhës.
- Multiprosesimi. Kjo është e diktuar nga dëshira për të përdorur të njëjtin instancë të bazës së të dhënave për sinkronizimin e gjendjes jo vetëm midis rrjedhave, por edhe midis aplikacionit kryesor dhe ekstensioneve të iOS.
- Mundësia për të paraqitur entitetet e ruajtura si objekte të pavaruara.
- Mungesa e alokimeve dinamike në kuadër të operacioneve CRUD.
- Përkrahja e transaksioneve për vetitë bazë : atomariteti, qëndrueshmëria, izolimi dhe besueshmëria.
- Shpejtësia në rastet më të njohura.
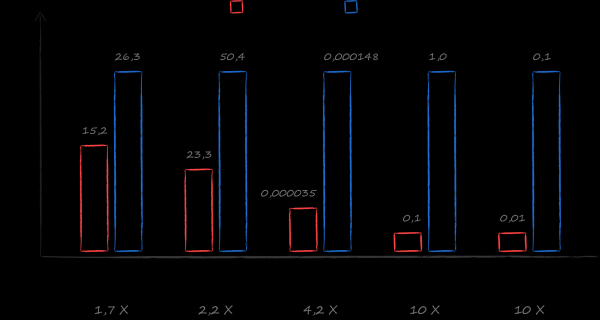
Një zgjedhje e mirë me një set kërkesash të tillë ishte dhe mbetet SQLite. Megjithatë, gjatë shqyrtimit të alternativave, më ra në dorë një libër . Nën drejtimin e saj u shkrua një benchmark që krahasonte shpejtësinë e punës me baza të ndryshme të të dhënave në skenarë realë në cloud. Rezultati tejkaloi pritshmëritë më ambicioze. Në rastet më të njohura — marrja e kursorit në një listë të renditur të të gjitha faqeve dhe lista e renditur e të gjitha faqeve për një direktor të caktuar — LMDB doli të ishte dhjetë herë më e shpejtë se SQLite. Zgjedhja bëhet e qartë.
2. Pozicionimi i LMDB
LMDB është një bibliotekë e vogël (vetëm 10K rreshta), që implementon nivelin më të ulët themelor të bazës së të dhënave — ruajtjen.
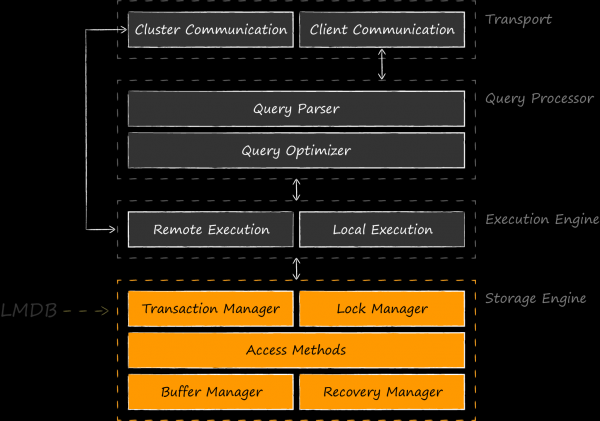
Schema e dhënë tregon se krahasimi i LMDB me SQLite, e cila implementon edhe nivele më të larta, nuk është më i saktë sesa krahasimi i SQLite me Core Data. Si konkurentë të barabartë do të ishte më e drejtë të përmendnim motorë të ngjashëm të ruajtjes — BerkeleyDB, LevelDB, Sophia, RocksDB dhe të tjerë. Ekzistojnë madje zhvillime ku LMDB shërben si komponent i motorit të ruajtjes për SQLite. Eksperimentin e parë të tillë e realizoi në vitin 2012 Howard Chu . LumoSQL prezentoi Aplikimi kryesor i LMDB është si motor për bazat e të dhënave aplikative. Biblioteka ekziston fal zhvilluesve
OpenLDAP btree «The Lightning Memory-mapped Database» yleo «Motori LMDB — kampioni i veçantë» MDBX rregullime .
zgjodhi e preferoi SQLite e tij për ruajtjen e indekseve.
Motori bëri hije edhe në botën e zhvillimit mobil. Gjetjet e tij mund të në klientin iOS për Telegram. LinkedIn shkoi edhe më tej dhe zgjodhi LMDB si depozita standarde për kornizën e tij të sjelljes të të dhënave Rocket Data, për të cilën në artikullin e tij në vitin 2016.
LMDB lufton me sukses për një vend në diell në niçen që la BerkeleyDB pas kalimit nën kontrollin e Oracle. Biblioteka pëlqehet për shpejtësinë dhe besueshmërinë, edhe krahasuar me homologët e saj. Siç dihet, ushqimet falas nuk ekzistojnë, dhe dua të theksoj trade-off-in me të cilin do të përballeni kur tregoni përzgjedhjen midis LMDB dhe SQLite. Schemi më sipër tregon qartë se si arrihet shpejtësia e rritur. Së pari, ne nuk paguajmë për shtresa të tjera abstraksioni mbi depozitën diskore. Natyrisht, në një arkitekturë të mirë, ato nuk mund të shmangen dhe ato do të shfaqen në kodin e aplikacionit, megjithatë ato do të jenë shumë më të holla. Ato nuk do të kenë veçori që nuk kërkohen nga aplikacioni përkatës, për shembull, mbështetje për pyetje në gjuhën SQL. Së dyti, krijohet mundësia për të realizuar në mënyrë optimale mapimin e operacioneve aplikative në pyetje ndaj depozitës diskore. Nëse SQLite bazohet në nevojat mesatare të një aplikacioni mesatar, ju si zhvillues aplikativ jeni plotësisht të vetëdijshëm për skenaret kryesore të ngarkesës. Për një zgjidhje më të fuqishme do të duhet të paguani një çmim më të lartë si për zhvillimin e zgjidhjes fillestare ashtu edhe për mbështetje të saj të mëvonshme.
3. Tre shtyllat e LMDB
Duke e parë LMDB nga lart, erdhi koha të zbresim më thellë. Tre seksionet e ardhshme do t'i kushtohen shqyrtimit të tre shtyllave kryesore mbi të cilat mbështetet arkitektura e depozitës:
- Skedarë të mapuar në memorie si mekanizëm për punën me diskun dhe për sinkronizimin e strukturave të brendshme të të dhënave.
- B+-pemë si organizim të strukturës së të dhënave të ruajtura.
- Copy-on-write si qasje për të siguruar pronat ACID të transaksioneve dhe shumë-versionalitetin.
3.1. Shtylla Nr. 1. Skedarë të mapuar në memorie
Aktet e shfaqura në kujtesë janë një element arkitektonik kaq i rëndësishëm, saqë ato madje figurojnë në emrin e depozitës. Çështjet e tregtimit dhe sinkronizimit të aksesit në informacionin e ruajtur janë plotësisht të deleguara operativit të sistemit. LMDB nuk përmban brenda vetes asnjë cache. Ky është një vendim i vetëdijshëm i autorit, pasi leximi i të dhënave direkt nga skedarët e shfaqur lejon nga të shkurtojë shumë kënde në realizimin e motorit. Më poshtë po paraqes një listë të pa plotë të disa prej tyre.
- Mbulimi i qëndrueshmërisë së të dhënave në depozitë gjatë punës nga disa procese bëhet detyrë e operativit të sistemit. Në seksionin e ardhshëm, kjo mekanikë është shqyrtuar në detaje dhe me figura.
- Mungesa e cache-ve e çliron plotësisht LMDB nga kostot që lidhen me alokimet dinamike. Leximi i të dhënave në praktikë paraqet një vendosje të një treguesi në adresën e duhur në kujtesën virtuale dhe asgjë më shumë. Tingëllon si fantastikë, por në burimet e depozitës të gjitha thirrjet e salloc janë përqendruar në funksionin e konfigurimit të depozitës.
- Mungesa e cache-ve do të thotë gjithashtu mungesën e bllokimeve që lidhen me sinkronizimin e aksesit të tyre. Lexuesit, të cilët mund të ekzistojnë në numër të pakufizuar në të njëjtën kohë, nuk hasin asnjë mutex në rrugën e tyre për në të dhëna. Për shkak të kësaj, shpejtësia e leximit ka një shkallë të përkryer lineare në numrin e CPU-ve. Në LMDB, sinkronizimi i nënshtrohet vetëm operacioneve modifikues. Një shkrues mund të jetë vetëm një në çdo moment.
- Minimumi i logjikës së cache-it dhe sinkronizimit e çliron kodin nga forma jashtëzakonisht komplekse e gabimeve të lidhura me punën në një mjedis shumëthënës. Në konferencën Usenix OSDI 2014 ishin dy kërkime interesante mbi bazat e të dhënave: dhe . Nga ato mund të nxirret informacion si mbi besueshmërinë pa precedent të LMDB, ashtu edhe mbi implementimin praktikisht të përsosur të pronave ACID të transaksioneve, që e kalon atë në të njëjtën SQLite.
- Minimalizmi i LMDB lejon që përfaqësimi i saj në makina të jetë plotësisht i vendosur në L1-cache të procesorit, me karakteristika të dalë nga kjo shpejtësi.
Fatke akoma, në iOS, ndërlidhja me skedarët e ngarkuar në kujtesë nuk është aq e thjeshtë sa dëshirohet. Për të diskutuar në mënyrë më të vetëdijshme në lidhje me mangësitë e lidhura, është e nevojshme të kujtojmë parimet e përgjithshme të implementimit të këtij mekanizmi në sistemet operative.
Informacione të përgjithshme mbi skedarët e ngarkuar në kujtesë
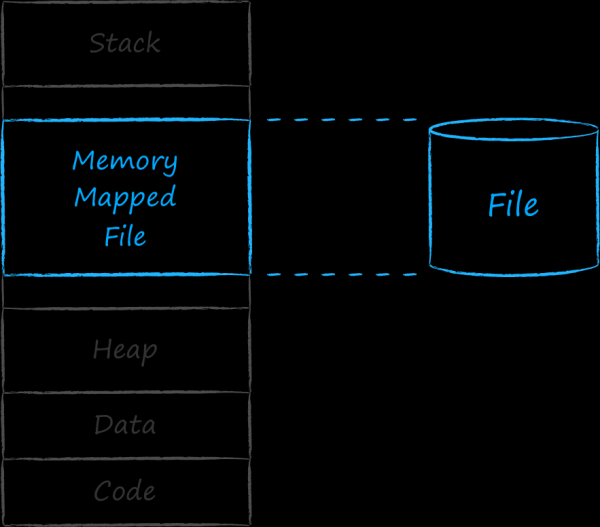 Çdo aplikacion ekzekutues asocion një entitet të quajtur proces me sistemin operativ. Çdo proces merr një interval vazhdimësie adresash, në të cilin vendos gjithçka që i nevojitet për funksionimin e tij. Në adresat më të ulëta ndodhen seksionet me kod dhe të dhëna e burime të ngulitura. Më pas vjen një bllok në rritje të hapësirës adresore dinamike, e njohur mirë si heap. Në të ndodhen adresat e entiteteve që shfaqen gjatë funksionimit të programit. Në krye ndodhet zona e memories që përdoret nga staku i aplikacionit. Ai rritet dhe zvogëlohet, pra, madhësia e tij gjithashtu ka natyrë dinamike. Për të siguruar që staku dhe heap-i të mos çojnë në ndërprerje mes tyre, ato janë ndarë në skajet e ndryshme të hapësirës adresore. Në mes të dy seksioneve dinamike, lart dhe poshtë, ka një hapësirë. Adresat në këtë pjesë të mesme i përdor sistemi operativ për të asociuar me procesin e ndryshme entitete. Në veçanti, ai mund të asociojë një grup vazhdimësie adresash me një skedar në disk. Ky skedar quhet skedar i ngarkuar në kujtesë.
Hapësira adresore e ndarë për procesin është kolosale. Teoretikisht, numri i adresave është i kufizuar vetëm nga madhësia e treguesit, i përcaktuar nga arkitektura e sistemit. Nëse do t'i ishte përshtatur një për një memoria fizike, procesi i parë do të kishte konsumuar të gjithë RAM-in, dhe nuk do të kishte asnjë fjalë për shumëprocesim.
Megjithatë, nga përvoja jonë e dimë se sistemet operative moderne mund të ekzekutojnë një numër të pacaktuar procesesh në të njëjtën kohë. Kjo është e mundur sepse ato vetëm në letër ndajnë shumë kujtesë për proceset, ndërsa në realitet ngarkojnë në memoryn fizike vetëm atë pjesë që kërkohet në këtë moment. Prandaj, memoria e asociuar me procesin quhet virtuale.
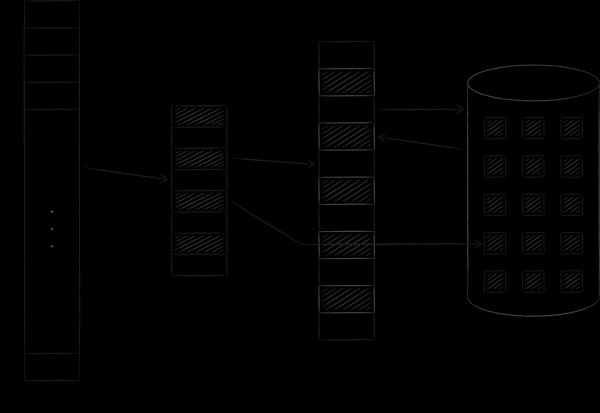
Sistemi i operimit organizon memorjen virtuale dhe fizike në forma të faqeve me një madhësi të caktuar. Sa herë që një faqe virtuale kërkohet, sistemi i operimit e ngarkon atë në memorjen fizike dhe vendos një lidhje midis tyre në një tabelë të veçantë. Nëse nuk ka vende të lira, një nga faqet e ngarkuara më parë kopjohet në disk, dhe faqja e kërkuar zë vendin e saj. Ky proces, i cili do të shqyrtojmë së shpejti, quhet swapping. Ilustrimi më poshtë tregon procesin e përshkruar. Në të, faqja A me adresën 0 është ngarkuar dhe vendosur në faqen e memorjes kryesore me adresën 4. Ky fakt është reflektuar në tabelën e lidhjeve në qelizën numër 0.
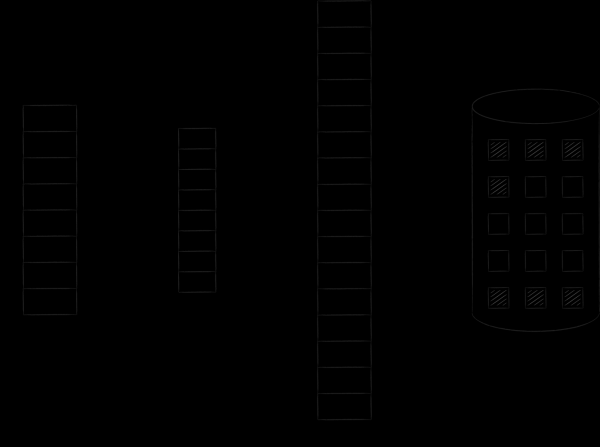
Historiku me skedarët e shfaqur në memorje është njësoj. Logjikisht ata janë të organizuar si një tërësi e vazhdueshme në hapësirën adresore virtuale. Megjithatë, ata kalojnë në memorjen fizike faqesh përfaqësisht dhe vetëm sipas kërkesës. Modifikimi i këtyre faqeve sinkronizohet me skedarin në disk. Kështu, mund të kryhen operacione për hyrje/dalje skedarësh, duke punuar thjesht me bajtët në memorje, - të gjitha ndryshimet do të transfertohen automatikisht nga bërthama e sistemit operativ në skedarin origjinal.
Imazhi më poshtë tregon se si LMDB sinkronizon gjendjen e saj gjatë punës me një bazë të dhënash nga procese të ndryshme. Duke mapuar memorjen virtuale të proceseve të ndryshme në të njëjtin skedar, de-fakto ne e obligojmë sistemin operativ të sinkronizojë në mënyrë transitore mes disa bllokesh të hapësirave të tyre adresore, ku LMDB bën monitorimin.
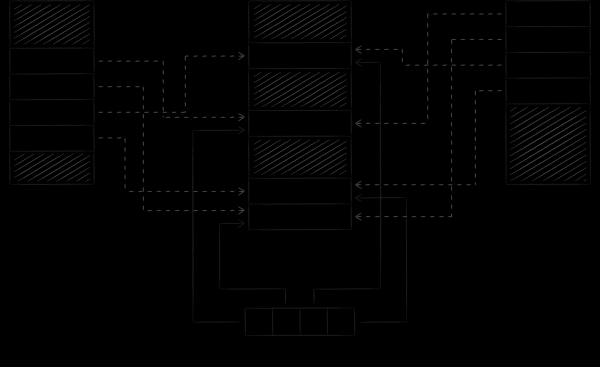
Një detaj i rëndësishëm është se LMDB për default modifikon skedarin me të dhëna përmes mekanizmit të thirrjes së sistemit write, ndërsa vetë skedari është i shfaqur në modin read-only. Ky qasje ka dy pasoja të rëndësishme.
Pasojë e parë — e përbashkët për të gjitha sistemet operative. Thelbi i saj është shtimi i mbrojtjes kundër dëmtimit të paqëllimshëm të bazës së të dhënave nga kodi jot korrekt. Siç dihet, instrukcionet ekzekutues të procesit janë të lira të qasen te të dhënat nga çdo vend në hapësirën e saj adresuese. Në të njëjtën kohë, siç sapo përmendëm, shfaqja e skedarit në modalitetin read-write do të thotë se çdo instrukcion mund ta modifikojë atë gjithashtu. Nëse e bën këtë gabimisht, duke tentuar, për shembull, të ricaktojë një element të vargut me një indeks joeksistues, atëherë në këtë mënyrë mund të ndryshojë për rastësi skedarin e mapuar në këtë adresë, çka do të çonte në dëmtimin e bazës së të dhënave. Nëse skedari është shfaqur në modalitetin read-only, tentativa për ta ndryshuar hapësirën përkatëse adresuese do të rezultojë në ndalimin e programit me sinjalin SIGSEGV, dhe skedari do të mbetet i paprekur.
Pasojën e dytë e ka kjo veçori specifike për iOS. As autori, as ndonjë burim tjetër nuk e përmend atë qartë, por pa të LMDB do të ishte e papërdorshme në këtë sistem operativ mobil. Rishikimit të saj i kushtohet seksioni vijues.
Specifika e skedarëve të mapuar në kujtesë në iOS
Në vitin 2018, në WWDC u mbajt një referat të shkëlqyer . Në të flitet se në iOS të gjitha faqet e vendosura në kujtesën fizike i përkasin një nga 3 tipeve: dirty, compressed dhe clean.
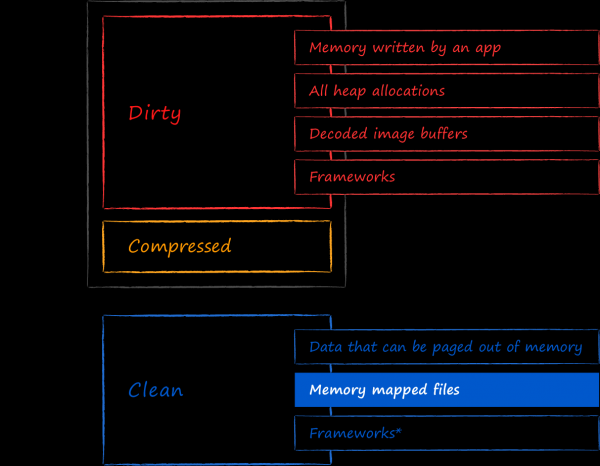
Kujtesa e pastër — është grumbull i faqeve që mund të shkarkohen pa probleme nga kujtesa fizike. Të dhënat në to mund të ngjiten përsëri sipas nevojës nga burimet e tyre fillestare. Skedarët e mapuar në kujtesë në mënyrë read-only bien saktësisht në këtë kategori. iOS nuk e frikson shkarkimin në çdo moment të faqeve të mapuara në skedar nga kujtesa, pasi ato janë garantuar se janë sinkronizuar me skedarin në disk.
Në kujtesën dirty bien të gjitha faqet e modifikuara, ku do që ato të ishin vendosur fillimisht. Në veçanti, kështu do të klasifikohen edhe skedarët e mapuar në kujtesë, të modifikuar përmes shkruarjes në kujtesën virtuale të asocuar me ta. Duke hapur LMDB me flagun MDB_WRITEMAP, pas kryerjes së ndryshimeve në të, mund ta verifikoni këtë vetë.
Kur çdo aplikacion fillon të zërë shumë memorie fizike, iOS e nënshtron atë në kompresionin e faqeve të papastra. Shuma e memories që zënë faqet e papastra dhe të kompresuara përbën atë që quhet footprint e memories së aplikacionit. Pasi të arrijë një prag të caktuar, një demon sistemik OOM killer vjen dhe e mbyll atë me forcë. Kjo është një veçori e iOS krahasuar me sistemet operative të desktopit. Ndryshe nga ato, zvogëlimi i footprint-it të memories përmes swap-it të faqeve nga memoria fizike në disk në iOS nuk parashikohet. Arsyet për këtë mund të supozohet. Mund të jetë që procedura e shpeshtimit të faqeve në disk dhe në tërësi është shumë e energjishme për pajisjet mobile, ose iOS kursen burimin e ripërtypjes së qelizave në SSD, ose ndoshta dizajnerët nuk ishin të kënaqur me performancën e përgjithshme të sistemit, ku gjithçka vazhdimisht swap-ohet. Megjithatë, fakti mbetet fakt.
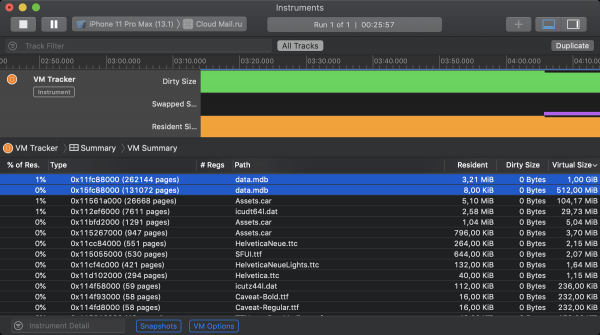
Lajmi i mirë, i përmendur më parë, është se LMDB me default nuk përdor mekanizmin mmap për përditësimin e skedareve. Kjo do të thotë se të dhënat e shfaqura klasifikohen nga iOS si memorie e pastër dhe nuk kontribuojnë në footprint-in e memories. Këtë mund ta verifikoni me ndihmën e mjetit Xcode të quajtur VM Tracker. Në shkëmbimin e mëposhtëm shikohet gjendja e memories virtuale të aplikacionit Clouds gjatë funksionimit. Në fillim ishin inicializuar 2 instanca të LMDB. E para u lejua të shfaqë skedarin e saj në 1GiB memorie virtuale, ndërsa e dyta në 512MiB. Megjithëse të dy depozitat zënë një volum të caktuar të memories rezidente, asnjëra nuk kontribuon në madhësinë e papastrës.
Tani është koha për lajmet e këqija. Falë mekanizmit të swap-it në sistemet operative 64-bit të desktopit, çdo proces mund të zërë aq hapësirë virtuale sa lejon vendi i lirë në disk për swap-in e tij potencial. Zëvendësimi i swap-it me kompresionin në iOS e ul radikalisht maksimumin teorik. Tani të gjithë proceset ekzistuese duhet të ngjiten në memorjen kryesore (lexo memorjen operative), dhe të gjithë ata që nuk arrijnë të bëjnë këtë do të mbyllen me forcë. Kjo është e përmendur si në , ashtu edhe në . Si pasojë, iOS e kufizon ndjeshëm madhësinë e memories që është e disponueshme për alokim përmes mmap. Këtu mund të shihni kufijtë empirikë të kapacitetit të memories, të cilat janë arritur të alokohen në pajisje të ndryshme përmes këtij thirrje të sistemit. Në modelet më moderne të smartphone-ve iOS, janë alokuar 2 gigabajt, ndërsa në versionet më të avancuara të iPad, deri në 4. Në praktikë, megjithatë, duhet të orientoheni nga modelet më të reja të mbështetura të pajisjeve, ku situata është shumë e trishtë. Më keq akoma, duke kontrolluar gjendjen e memories së aplikacionit në VM Tracker, mund të zbuloni se LMDB nuk është e vetmja që pretendon për memory-mapped memory. Pjesë të mira të memories konsumohen nga alokatorët sistemorë, skedarët me burime, framework-ët për punën me imazhe dhe grabitqarët e tjerë të vegjël.
Pas eksperimentesh në Cloud, arritëm në këto vlera kompromisi për alokimin e memories LMDB: 384 megabajt për pajisjet 32-bit dhe 768 për ato 64-bit. Pas konsumin e këtij kapaciteti, çdo operacion modifikues fillon të përfundojë me kodin MDB_MAP_FULL. Këto gabime i vërejmë në monitorimin tonë, por janë të mjaftueshme që në këtë fazë të mund të injorohen.
Një arsye jo e dukshme për konsumimin e tepërt të memories nga depoja mund të jenë transaksionet me jetëgjatësi të gjatë. Për të kuptuar se si lidhen këto dy fenomene, do të na ndihmojë shqyrtimi i dy ‘balenave’ të mbetura të LMDB.
3.2. Balenë Nr. 2. B+-Tree
Për të simuluar tabelat mbi një depo të tipit key-value, është e nevojshme që në API të saj të jenë të pranishme operacionet e mëposhtme:
- Shtimi i një elementi të ri.
- Kërkimi i një elementi me një çelës të caktuar.
- Fshirja e një elementi.
- Iterimi mbi intervalet e çelësave në rendin e tyre të rendit.
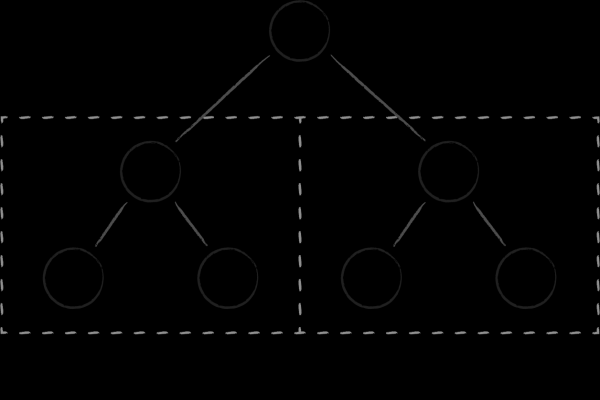 Struktura më e thjeshtë e të dhënave, me të cilën mund të realizoni lehtësisht të katërtat operacione, është një pemë kërkimi binar. Çdo nyje përfaqëson një çelës, duke ndarë gjithë nëngrupin e çelësave fëmijë në dy nënpemë. Në të majtë mbledhen ato që janë më të vogla se prindi, ndërsa në të djathtë ato që janë më të mëdha. Marrja e një grupi të renditur çelësh arrihet përmes një nga kalimeve klasike të pemës.
Pem trees binar kanë dy mangësi themelore që nuk i lejojnë ata të jenë efektivë si një strukturë të dhënash në disk. Së pari, shkalla e balancimit të tyre është e paparashikueshme. Ka një rrezik të konsiderueshëm për të marrë pemë, në të cilat lartësia e degëve të ndryshme mund të ndryshojë shumë, gjë që e përkeqëson ndjeshëm kompleksitetin algoritmik të kërkimit në krahasim me atë që pritet. Së dyti, abundenca e referencave midis nyjeve i heq pemëve binar lokalitetin në memorje. Nyjet e ngjashme (në aspektin e lidhjeve mes tyre) mund të jenë në faqe të ndryshme në memorien virtuale. Si pasojë, edhe për një kalim të thjeshtë nëpër disa nyje fqinjë në pemë, mund të jetë e nevojshme të vizitohet një numër i krahasueshëm faqesh. Kjo është një problem edhe kur diskutojmë për efikasitetin e pemëve binar si një strukturë të dhënash në memorje, pasi rrotullimi i vazhdueshëm i faqeve në memorie është një shpenzim i kushtueshëm. Kur është çështja për ngritjen e shpeshtë të faqeve të lidhura me nyjet nga disku, situata bëhet edhe më .
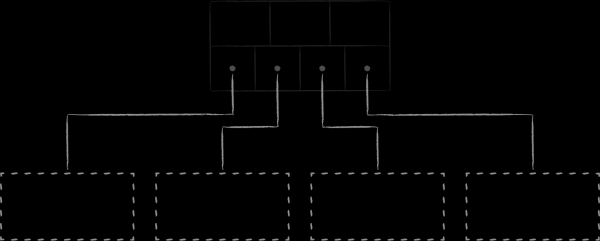 Pemët B, duke qenë evolucioni i pemëve binar, zgjidhin problemet e përmendura në paragrafin e mëparshëm. Së pari, ato janë vetëbalancuese. Së dyti, çdo nyje e tyre ndan shumë çelësa fëmijë jo në 2, por në M nëngrupe të renditura, dhe numri M mund të jetë mjaft i madh, rreth disa qindra ose madje mijëra.
Për shkak të kësaj:
- Në çdo nyje ka një numër të madh çelësh të renditur tashmë dhe pemët rezultojnë shumë të ulëta.
- Pema fiton pronën e lokalitetit të vendosjes në memorje, pasi çelësat e ngjashëm natyrshëm janë të vendosur afër njëri-tjetrit në një ose nyje fqinjë.
- Kjo e redukton numrin e nyjeve kalimtare gjatë zbritjes në pemë gjatë operacionit të kërkimit.
- Kjo e ul numrin e nyjeve të targetuara të lexuara gjatë kërkesave range, pasi në çdo një prej tyre tashmë ka një numër të madh çelësh të renditur.
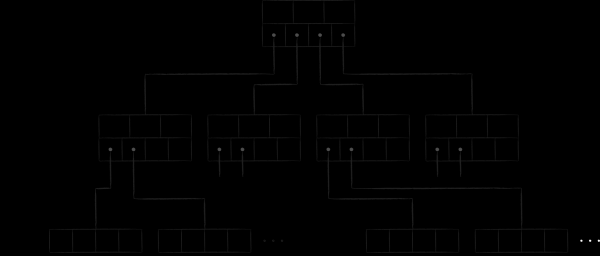
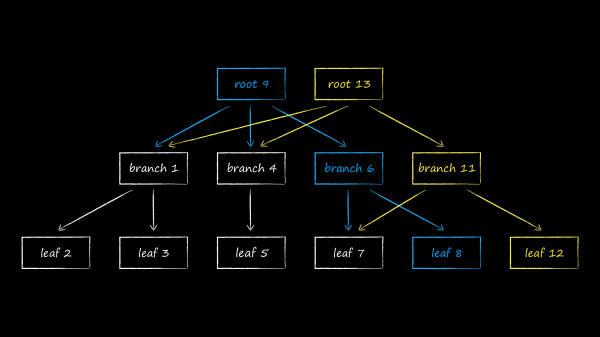
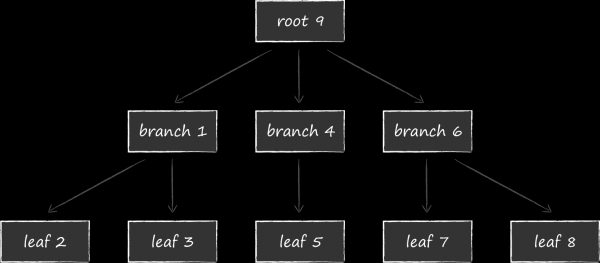
Në LMDB përdoret një nga variacionet e B-pemës të quajtur B+-pemë. Në skemën e mësipërme janë paraqitur tri lloje nyjesh që ndodhen në të:
- Në krye ndodhet rrënja (root). Ajo materializon asgjë tjetër veçse konceptin e bazës së të dhënave brenda magazinës. Brenda një instance të LMDB-së, është e mundur të krijoni disa baza të dhënash që ndajnë ndërmjet tyre hapësirën virtuale të adresave të mapuara. Çdo njëra prej tyre fillon me rrënjën e saj.
- Në nivelin më të ulët ndodhen gjethet (leaf). Ato përmbajnë vetëm çiftet çelës-vlerë që ruhen në bazën e të dhënave. Kjo është pikërisht veçoria e pemëve B+. Nëse një pemë standarde B ruan pjesët e vlerave në nyjet e të gjitha niveleve, varianti B+ e bën këtë vetëm në nivelin më të ulët. Pas shënimit të këtij fakti, do ta quajmë nën-dhunën e pemës së përdorur në LMDB një pemë B.
- Ndërmjet rrënjës dhe gjetheve ndodhen 0 dhe më shumë nivele teknike me nyje naviguese (branch). Detyra e tyre është të ndajnë grupin e renditur të çelësave midis gjetheve.
Fizikisht, nyjet janë blloqe të memories me një gjatësi të përcaktuar paraprakisht. Madhësia e tyre është shumëfish i madhësisë së faqeve të memories në sistemin operativ, për të cilin folëm më lart. Më poshtë është paraqitur struktura e nyjes. Në krye ndodhet meta-informacioni, nga i cili më e dukshme për shembull është shuma e kontrollit. Më pas është informata mbi offsetet, sipas të cilave ndodhen qelizat me të dhëna. Të dhënat mund të përfaqësojnë ose çelësat, nëse flasim për nyje naviguese, ose tërësisht çiftet çelës-vlerë në rastin e gjetheve. Më shumë informacion mbi strukturën e faqeve mund të lexoni në punimin .
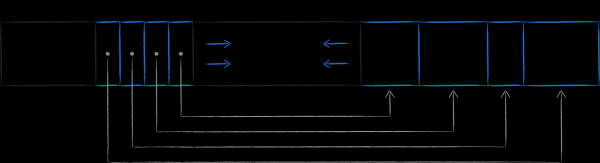
Pas shqyrtimit të përbërjes së brendshme të nyjeve-faqeve, do ta paraqesim më thjesht pemën B të LMDB-së në këtë formë.
Faqet me nyje rresht pas rreshti ndodhen në disk. Faqet me numra më të lartë ndodhen më afër fundit të skedarit. Faqja e njohur si meta-faqe (meta page) përmban informacion mbi offsetet, sipas të cilave mund të gjenden rrënjët e të gjitha pemëve. Kur hapet skedari LMDB, ai skanon faqet nga fundi në fillim në kërkim të një faqeje valide meta dhe përmes saj gjen bazat e dhënash ekzistuese.
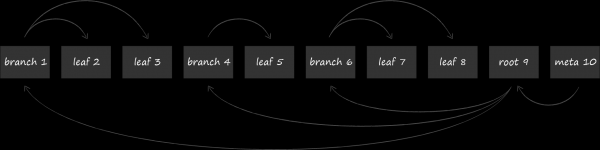
Tani, me një përfaqësi të strukturës logjike dhe fizike të organizatës së të dhënave, mund të kalojmë në shqyrtimin e filxhanit të tretë të LMDB. Pikërisht me ndihmën e tij, të gjitha modifikimet e depozitës ndodhin në mënyrë transaksionale dhe njëri nga tjetri, duke i dhënë bazës së të dhënave gjithashtu vetinë e shumëversionalitetit.
3.3. Filxhani nr. 3. Copy-on-write
Disa operacione me B-pohon supozojnë një seri të tërë ndryshimesh në nyjat e tij. Një nga shembujt është shtimi i një çelësi të ri në një nyje, e cila tashmë ka arritur kapacitetin maksimal. Në këtë rast, është e nevojshme së pari, të ndahen nyjat në dy, dhe së dyti, të shtohet një lidhje në nyjën e re të derdhur te prindi i saj. Kjo procedurë është potencialisht shumë e rrezikshme. Nëse për ndonjë arsye (krash, ndalesa e energjisë, etj.) ndodhin vetëm disa nga ndryshimet e serisë, mund të mbetet në gjendje jo konsistente.
Një nga zgjidhjet tradicionale për të siguruar që baza e të dhënave të jetë e qëndrueshme për dështime është shtimi pranë B-pohon një strukture të dhënash shtesë diskore - regjistri i transaksioneve, i njohur gjithashtu si write-ahead log (WAL). Ky është një skedar, në të cilin shënohet operacioni i supozuar para se të modifikohet vetë B-pohon. Kështu, nëse gjatë vetëdiagnozës zbulohet një dëmtim të të dhënave, baza e të dhënave konsultohet me regjistrin për t'u rregulluar.
LMDB si mekanizëm për të siguruar qëndrueshmërinë ndaj dështimeve ka zgjedhur një mënyrë tjetër, e cila quhet copy-on-write. Thelbi i saj është se, në vend që të përditësojë të dhënat në faqen ekzistuese, ajo fillimisht e kopjon atë plotësisht dhe të gjitha modifikimet i bën në kopje.
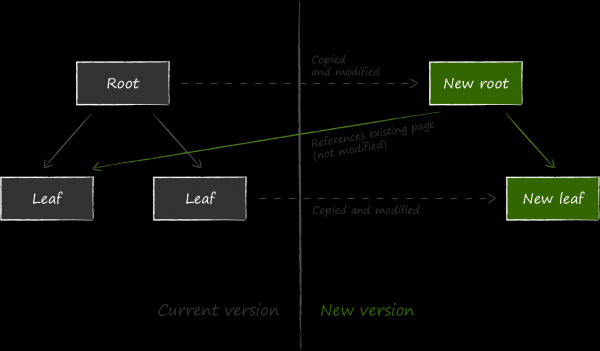
Më tej, në mënyrë që të dhënat e përditësuara të jenë të disponueshme, është e nevojshme të ndryshohet lidhja në nyjën e re të bërë të rëndësishme në nyjën prind ndaj saj. Pasi që për këtë duhet gjithashtu të modifikohet, ajo gjithashtu kopjohet paraprakisht. Procesi vazhdon në mënyrë rekurzive deri në rrënjën e vet. Të dhënat e fundit ndryshohen në faqen meta.
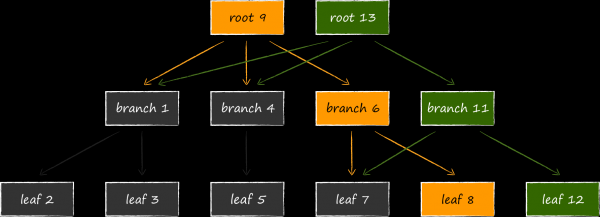
Nëse ndodh një ndërprerje aksidentale gjatë procedurës së përditësimit, as nuk do të krijohet një faqe e re meta, as ajo nuk do të shkruhet në disk deri në fund, dhe checksum i saj do të jetë i gabuar. Në cilindo nga këto dy raste, faqet e reja do të jenë të paarritshme, ndërsa të vjetrat nuk do të preken. Kjo e shpëton LMDB nga nevoja për të mbajtur një log përpara shkrimit për të ruajtur konsistencën e të dhënave. Struktura e ruajtjes së të dhënave në disk, e përshkruar më sipër, merr përsipër edhe funksionin e saj. Mungesa e logut të transaksioneve në mënyrë të qartë — është një nga karakteristikat e LMDB që siguron një shpejtësi të lartë në leximin e të dhënave.
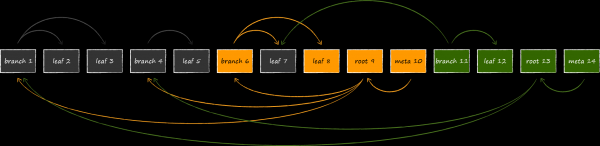
Konstruksioni i quajtur B-tree vetëm në anë natyrshëm siguron izolimin e transaksioneve dhe multiversionin. Në LMDB, me çdo transaksion të hapur lidhet një rrënjë aktuale e pemës. Deri sa transaksioni të përfundojë, faqet e pemës së lidhur me të nuk do të ndryshohen ose të ri-shfrytëzohen për versione të reja të të dhënave. Kështu, mund të punoni për aq kohë sa doni me saktësisht grupin e të dhënave që ishte aktual në momentin e hapjes së transaksionit, edhe nëse depoja vazhdon të përditësohet aktivisht. Kjo është thelbi i multiversionitetit, që e bën LMDB burimin ideal të të dhënave për të gjithë ne të dashuruarit UICollectionView. Duke hapur një transaksion, nuk është e nevojshme të rritet përdorimi i memories së aplikacionit, duke nxjerrë me ngut të dhënat aktuale në ndonjë strukturë in-memory, duke u frikësuar të mbetemi me një shkrirje. Kjo veçori e veçon LMDB nga vetë SQLite, i cili nuk mund të krenohet me një izolim të tillë të plotë. Duke hapur dy transaksione në të fundit dhe duke fshirë një regjistrim në kuadër të njërit prej tyre, atë regjistrim nuk do të mund të merrni edhe në kuadër të të dytit që ka mbetur.
Një anë tjetër e medaljes është shpenzimi potencialisht shumë më i madh i memorjes virtuale. Në slide është ilustruar se si do të dukej struktura e bazës së të dhënave nëse modifikohet njëkohësisht me 3 transaksione të hapura për lexim, duke parë versione të ndryshme të bazës së të dhënave. Duke qenë se LMDB nuk mund të ripërdorë nodet që arrijnë nga rrënjët e lidhura me transaksionet aktuale, depozitës nuk i mbetet asgjë tjetër veçse të vendosë një rrënjë të katërt në memorie dhe përsëri të klonojë nën të faqet e modifikuara.
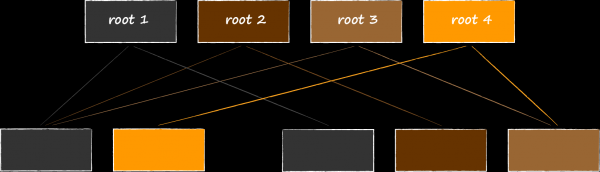
Këtu do të ishte e mençur të kujtojmë seksionin mbi skedarët e hartuar në memorie. Megjithëse shpenzimi shtesë i memorjes virtuale nuk duhet të na shqetësojë shumë, pasi ajo nuk kontribuon në peshën e memorjes së aplikacionit. Megjithatë, është vënë re që iOS është shumë e kursyer në ndarjen e saj, dhe ne nuk mund të ofrojmë një rajon LMDB prej 1 terabait siç bëjmë në servera ose desktopa pa menduar për këtë veçori. Sa më shumë që të jetë e mundur, duhet të përpiqemi të bëjmë kohën e jetës së transaksioneve sa më të shkurtra.
4. Projektimi i skemës së të dhënave mbi API-në e çelëzave-vlera
Analizën e API-së do ta fillojmë me shqyrtimin e abstraksioneve bazë që ofron LMDB: mjedisi dhe bazat e të dhënave, çelësat dhe vlerat, transaksionet dhe lehtësitë.
Vërejtje mbi listat e kodit
Të gjitha funksionet në API-në publike të LMDB kthejnë rezultatin e punës së tyre në formën e një kodi gabimi, por kontrolli i tij është hequr nga të gjitha listat më pas për shkak të shkurtësisë. Në praktikë, ne madje përdorim mbështetje tonë të C++ për të ndërvepruar me depozitën. Përmbështetje C++ , në të cilin gabimet materializohen në forma përjashtimesh C++.
Si mënyra më e shpejtë për të lidhur LMDB me projektin për iOS ose macOS, sugjeroj CocoaPod-in tim .
4.1. Abstraksionet bazë
Mjedisi (environment)
Struktura MDB_env është një depo e gjendjes së brendshme të LMDB. Familja e funksioneve me prefiksin mdb_env lejon të konfigurohen disa prej pronarëve të tij. Në rastin më të thjeshtë, inicializimi i motorit duket kështu.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);Në aplikacionin OblaMail.ru ne ndryshuam vetëm vlerat e dy parametrave default.
I pari është madhësia e hapësirës virtuale adresuese që i përkas një file të ruajtjes. Fatkeqësisht, edhe në të njëjtën pajisje, vlera e veçantë mund të ndryshojë ndjeshëm nga një ekzekutim në tjetrin. Për të marrë parasysh këtë veçori të iOS, madhësia maksimale e ruajtjes përcaktohet dinamikisht. Duke filluar nga një vlerë e caktuar, ajo reduktohet në mënyrë të rregullt derisa funksioni mdb_env_open nuk kthen një rezultat që është ndryshe nga ENOMEM. Në teori ekziston dhe një rrugë e kundërt — fillimisht të alokosh një minimum të Memories për motorin, dhe pastaj, në rast gabimesh, ta rritësh atë. Megjithatë, kjo është një rrugë shumë më e vështirë. Arsyeja është se procedura e ri-alokimit të Memories (remap) me funksionin MDB_MAP_FULLmdb_env_set_map_size dëshmon të gjitha entitetet (kursoret, transaksionet, çelësat dhe vlerat) që janë marrë më parë nga motori. Të merrni parasysh një kthesë të tillë ngjarjesh në kod do të çonte në një ndërlikim të rëndësishëm të tij. Nëse megjithatë, memoria virtuale është shumë e rëndësishme për ju, kjo mund të jetë një arsye për të shqyrtuar një fork që ka avancuar ndjeshëm përpara, ku mes veçorive të deklaruara është «përshtatja automatike e madhësisë së bazës së të dhënave gjatë funksionimit». Parametri i dytë, vlera e parazgjedhur e të cilit nuk na përmbushi, rregullon mekanikën e sigurimit të sigurisë përmes rrjedhave. Fatkeqësisht, të paktën në iOS 10 ka probleme me mbështetje për ruajtjen lokale të rrjedhave. Për këtë arsye, në shembullin e mësipërm, ruajtja hapet me flamurin
MDB_NOTLS . Përveç kësaj, ishte e nevojshme tëforkohej , për të larguar variablat me këtë atribut dhe atje. Baza e të dhënave është një instancë e veçantë e B-tree, për të cilin folëm më parë. Hapja e saj ndodh brenda një transaksioni, që fillimisht mund të duket pak e çuditshme.
Baza të dhënash
MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
Në të vërtetë, transaksioni në LMDB — është një entitet ruajtjeje, jo një bazë të dhënash specifike. Kjo koncepcioni lejon kryerjen e operacioneve atomike mbi entitetet që ndodhen në baza të ndryshme të të dhënave. Në teori, kjo hap mundësinë për modelimin e tabelave si baza të ndryshme, por unë në atë kohë zgjodha një rrugë tjetër, të cilën e kam përshkruar më hollësisht më poshtë.Çelësat dhe vlerat
MDB_val
Struktura Çelësat dhe vlerat modelon konceptin si çelës dhe vlerë. Depozita nuk ka asnjë ide për semantikën e tyre. Për të, çdo gjë është thjesht një varg bajtash të caktuar.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Me ndihmën e krahasuesit, depozita radhit çelësat në rritje. Nëse nuk e zëvendëson me një të tijin, do të përdoret e parazgjedhura, e cila i rendit ato bajt për bajt në rendin leksikografik.
Transaksionet
Mekanizmi i transaksioneve është përshkruar në , prandaj këtu do të përmbledh në mënyrë të shkurtër karakteristikat e tij kryesore:
- Përkrahja e të gjitha karakteristikave themelore : atomariteti, koherenca, izolimi dhe besueshmëria. Duhet të theksoj se lidhur me qëndrueshmërinë, në macOS dhe iOS ka një defekt, i cili është rregulluar në MDBX. Më shumë informacion mund të gjeni në .
- Qasja ndaj shumëprocësorës përshkruhet nga skema "shkruajës i vetëm / lexues shumë". Shkruajtësit bllokojnë njëri-tjetrin, por nuk bllokojnë lexuesit. Lexuesit nuk bllokojnë as shkruajtësit, as njëri-tjetrin.
- Përkrahja e transaksioneve të ndërlidhura.
- Përkrahja për shumëversionim.
Shumëversionimi në LMDB është kaq i mirë, saqë dua ta demonstroj atë në veprim. Nga kodi më poshtë, shihet se çdo transaksion punon me versionin e atij database, që ishte aktual në momentin e hapjes së tij, duke qenë plotësisht i izoluar nga të gjitha ndryshimet e mëvonshme. Inicializimi i depozitës dhe shtimi i një regjistri testues nuk paraqesin asgjë interesante, prandaj ato rituale janë lënë nën spoiler.
Shtimi i regjistrit testues
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Hapim 2 transaksione, secila prej të cilave shikon
// versionin e bazës së të dhënave me një rekord.
mdb_txn_begin(env, NULL, 0, &txn1); // lexim-shkrim
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // vetëm lexim
// Brenda transaksionit të parë, fshijmë nga baza e të dhënave rekordin ekzistues.
mdb_del(txn1, dbi, &key, NULL);
// Regjistrojmë fshirjen.
mdb_txn_commit(txn1);
// Hapim një transaksion të tretë, i cili shikon
// versionin aktual të bazës së të dhënave, ku rekordi tashmë nuk ekziston.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Sigurohemi që rekordi për çelësin kërkuar nuk ekziston më.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Përfundojmë transaksionin.
mdb_txn_abort(txn3);
// Sigurohemi që brenda transaksionit të dytë, i hapur në momentin
// e ekzistencës së rekordit në bazën e të dhënave, ende mund ta gjejmë atë sipas çelësit.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Kontrollojmë që për çelësin e marrë nuk kemi ndonjë mbetje, por të dhëna valide.
assert(*(int *)val.mv_data == 997);
// Përfundojmë transaksionin, i cili punon ndonëse me një bazë të dhënash të vjetruar, por konsistente.
mdb_txn_abort(txn2);Rekomandoj me përjashtim që të provoni të realizoni një hile të tillë me SQLite dhe të shikoni se çfarë do të ndodhë.
Multiversionimi sjell përfitime shumë të këndshme në jetën e zhvilluesit të iOS. Me këtë veçori, mund të rregulloni lehtësisht dhe pa ndjenja shpejtësinë e përditësimit të burimit të të dhënave për format ekranore, duke u bazuar në konsideratat e përvojës së përdoruesit. Si shembull, le të marrim një funksion të aplikacionit OblaMail si ngarkimin automatik të përmbajtjes nga galeria e medias së sistemit. Me një lidhje të mirë, klienti është në gjendje të ngarkojë disa fotografi në server në sekondë. Nëse pas çdo ngarkimi përditësojmë UICollectionView përmbajtjen mediatike në cloud-in e përdoruesit, atëherë mund të harrojmë për 60 fps dhe skrollin e lëmuar gjatë këtij procesi. Për të parandaluar përditësimet e shpeshta të ekranit, është e nevojshme të kufizojmë ndonjëherë shpejtësinë e ndryshimit të të dhënave në bazë. UICollectionViewDataSource.
Nëse baza e të dhënave nuk mbështet versionet e shumta dhe lejon të punohet vetëm me gjendjen aktuale, për krijimin e një snapshot-i të stabilizuar të të dhënave është e nevojshme të kryhet kopjimi ose në një strukturë të dhënash në memorie, ose në një tabelë përkohshme. Çdo qasje e tillë është shumë e kushtueshme. Në rastin e ruajtjes në memorie, kemi shpenzime si për memorie, të shkaktuara nga ruajtja e objekteve të ndërtuara, ashtu edhe për kohë, të lidhura me transformime të tepërta të ORM. Sa i përket tabelës përkohshme, kjo është një luks edhe më i shtrenjtë, ku ka kuptim vetëm në raste jo triviale.
Multi-versioning i LMDB zgjidh problemin e mbajtjes së një burimi të dhënash stabil shumë elegant. Mjafton të hapesh një transaksion dhe voilà — derisa ta përfundojmë, grupi i të dhënave është garantuar të ruhet. Logjika e shpejtësisë së përditësimit është tani krejtësisht nën kontrollin e shtresës prezantuese pa ndonjë shpenzim të rëndësishëm të burimeve.
Kursorët
Kursorët ofrojnë një mekanizëm për iterimin e renditur përmes çifteve çelës-vlerë përmes kalimit në B-tree. Pa ta, do të ishte e pamundur të modeloheshin tabelat në bazën e të dhënave, në të cilat po kalojmë.
4.2. Modelimi i tabelave
Sidoqoftë, pronësia e renditjes së çelësave lejon ndërtimin mbi abstraksionet bazë një model të nivelit të lartë si tabela. Le të shqyrtojmë këtë proces me shembullin e tabelës kryesore të klientit cloud, në të cilën është cache-uara informata për të gjitha skedarët dhe dosjet e përdoruesit.
Skema e tabelës
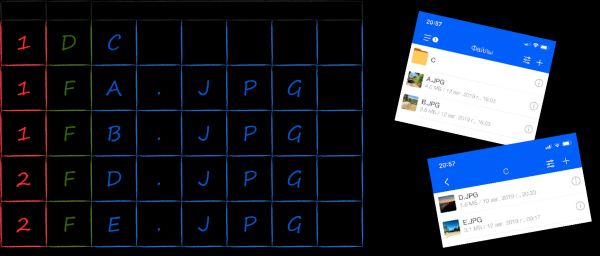
Një nga skenarët e zakonshëm për të cilin duhet të dizajnohet struktura e tabelës me pemë dosjesh — është marrja e të gjitha elementeve të vendosura brenda një direktorie të caktuar. Një model i mirë i organizimit të të dhënave për kërkesa të tilla është . Për ta realizuar këtë mbi një ruajtje të çelësit dhe vlerës, është e nevojshme të renditen çelësat e skedarëve dhe dosjeve në mënyrë që ato të grumbullohen bazuar në përkatësinë e tyre ndaj direktorisë prind. Për më tepër, për të paraqitur përmbajtjen e direktorisë në një format më të njohur për përdoruesin si Windows (fillimisht dosjet, pastaj skedarët, dhe të dyja të renditura alfabetikisht), është e nevojshme të përfshihen fushat shtesë përkatëse në çelës.
Në imazhin më poshtë shihet se si, në përputhje me detyrën e dhënë, mund të paraqiten çelësat si një array byte. Fillimisht vendosen byte me identifikuesin e drejtoriës prind (të kuqund), pastaj ato me tipin (të gjelbra) dhe në fund, emri (të blu). Duke u renditur me krahasuesin default të LMDB në rend lexikografik, ato renditen në mënyrën e kërkuar. Kalimi rreshtor i çelësave me të njëjtin prefiks të kuq na jep vlerat përkatëse në rendin në të cilin duhet të shfaqen në ndërfaqen e përdoruesit (drejt), pa kërkuar ndonjë përpunim të mëtejshëm.
Serializimi i çelësave dhe vlerave
Në botë janë krijuar shumë metoda për serializimin e objekteve. Duke pasur parasysh se nuk kishim asnjë kërkesë tjetër përveç shpejtësisë, për vete ne zgjodhëm metodën më të shpejtë të mundshme — dump-i i memories së zënë nga instanca e strukturës së gjuhës C. Kështu, çelësi i elementit të direktorisë mund të modelizohet me strukturën e mëposhtme NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Për të ruajtur NodeKey në ruajtje, duhet që objekti Çelësat dhe vlerat të pozicionojë treguesin për të dhënat në adresën e fillimit të strukturës, dhe madhësia e tyre të llogaritet me funksionin sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
Në kapitullin e parë mbi kriteret e zgjedhjes së bazës së të dhënave, si një faktor të rëndësishëm në zgjedhje, përmenda minimale dinamike të alokimeve në kuadër të operacioneve CRUD. Kodi i funksionit serialize tregon se si, në rastin e LMDB, ato mund të evitohen plotësisht gjatë futjes së regjistrimeve të reja në bazën e të dhënave. Ajo array byte që vjen nga serveri fillimisht transformohet në struktura stack, dhe pastaj ato dump-en në mënyrë triviale në ruajtje. Duke marrë parasysh se brenda LMDB gjithashtu nuk ka alokime dinamike, mund të kemi një situatë fantastike në përmasa të iOS - të përdorim vetëm memories në stack për punë me të dhënat në gjithë rrugën e tyre nga rrjeti në disk!
Renditja e çelësave me një krahasues binar
Marrëdhënia e rendit të çelësave përcaktohet nga një funksion të veçantë, i quajtur krahasues. Duke qenë se motori nuk di asgjë për semantikën e bajtëve që përmban, krahasuesi i paracaktuar nuk ka tjetër zgjedhje përveçse të renditë çelësat në rend lexikografik, duke u mbështetur në krahasimin e tyre bajt për bajt. Përdorimi i tij për të renditur struktura është si të rruash me një thikë prerëse. Sidoqoftë, në raste të thjeshta, unë e gjej këtë metodë të pranueshme. Alternativa përshkruhet pak më poshtë, dhe këtu do të përmend disa grupe të shpërndara në këtë rrugë.
E para që duhet të mbani mend është përfaqësimi në kujtesë i tipave të dhënash primitivë. Në të gjitha pajisjet Apple, variablat e numrave të plotë ruhet në formatin . Kjo do të thotë se bajti më pak i rëndësishëm do të jetë në majtë, dhe të renditësh numra të plotë, duke përdorur krahasimin e tyre bajt për bajt, nuk do të arrish. Për shembull, përpjekja për ta bërë këtë me një koleksion numrash nga 0 në 511 do të çojë në rezultatin e mëposhtëm.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Për të zgjidhur këtë problem, numrat e plotë duhet të ruhen në çelës në një format të përshtatshëm për krahasuesin bajt për bajt. Transformimi i nevojshëm do të ndihmojë funksionet nga familja hton* (veçanërisht htons për numrat dy-bajtë që përdoren në shembull).
Formati i përfaqësimit të vargjeve në programim është, siç dihet, një e tërë . Nëse semantika e vargjeve si dhe kodimi i përdorur për përfaqësimin e tyre në kujtesë nënkupton që për çdo karakter mund të ketë më shumë se një bajt, atëherë është më mirë të heqim dorë nga ideja e përdorimit të krahasuesit të paracaktuar.
E dyta që duhet të keni parasysh është nga kompajleri i fushave të strukturës. Për shkak të tyre, në kujtesë midis fushave mund të formohen bajta me vlera pleh, që sigurisht, prish renditjen bajt për bajt. Për të eliminuar plehun, duhet ose të shpallni fushat në një rend të caktuar, duke mbajtur mend rregullat e drejtimit, ose të përdorni në shpalljen e strukturës atributin packed.
Renditja e çelësave me një krahasues të jashtëm
Logjika e krahasimit të çelësave mund të refuzohet për të qenë shumë komplekse për një krahasues binar. Një nga shume arsye është pranija e fushave teknike brenda strukturave. Do ta ilustroj shfaqjen e tyre me shembullin e njohur tashmë të çelësit për elementin e direktorisë.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Megjithëse është shumë i thjeshtë, në shumicën e rasteve ai konsumon shumë memorie. Bufferi për emrin zë 256 byte, megjithatë emrat e skedarëve dhe dosjeve rrallë kalojnë 20-30 karaktere.
Një nga teknikat standarde për optimizimin e madhësisë së shënimeve është "prerja" e saj në madhësinë aktuale. Thelbi i saj është se përmbajtja e të gjitha fushave me gjatësi variabile ruhet në fund të strukturës, ndërsa gjatësitë e tyre janë në variabla të veçantë. Sipas këtij qasjes, çelësi NodeKey transformohet si më poshtë.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Më pas, gjatë serializimit, si madhësi të dhënash përcaktohet jo sizeof e gjithë strukturës, por madhësia e të gjitha fushave me gjatësi fikse plus madhësia e pjesës së vërtetë të përdorur të bufferit.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Si rezultat i refaktorizimit të kryer, ne arritëm një kursim të konsiderueshëm të hapësirës që zënin çelësat. Megjithatë, për shkak të fushës teknike nameLength, krahasuesi binar standard nuk është më i përshtatshëm për krahasimin e çelësave. Nëse nuk e zëvendësojmë me të tonin, do të jetë gjatësia e emrit faktor më prioritar në renditje sesa emri vetë.
LMDB lejon caktimin e një funksioni krahasimi çelësash për çdo bazë të dhënash. Kjo bëhet përmes funksionit mdb_set_compare në mënyrë strikte para hapjes. Për arsye të qarta, gjatë gjithë jetës së bazës së të dhënave ajo nuk mund të ndryshohet. Krahasuesi merr dy çelësa në format binar, dhe në dalje kthen rezultatin e krahasimit: më e vogël (-1), më e madhe (1) ose të barabarta (0). Pseudokodi për NodeKey duhet të duket kështu.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Derisa në bazën e të dhënave të gjithë çelësat të kenë të njëjtin tip, caktimi i pa kushtëzuar i përfaqësimit të tyre në byte në tipin e strukturës aplikative është legjitim. Ka një detaj këtu, por ai do të shqyrtohet më poshtë në nënseksionin "Leximi i shënimeve".
Serializimi i vlerave
Me çelësat e regjistrimeve të ruajtura LMDB funksionon jashtëzakonisht intensivisht. Krahasimi i tyre ndodh në çdo operacion aplikimi, dhe performanca e tërë zgjidhjes varet nga shpejtësia e krahasuesit. Në një botë ideale, për krahasimin e çelësave do të ishte mjaft një krahasues binar standard, por nëse është e nevojshme të përdoret një i vetëpërgatitur, procedura e deserializimit të çelësave në të duhet të jetë sa më e shpejtë të jetë e mundur.
Pjesa e vlerës së regjistrimit (vlera) nuk i intereson shumë bazës së të dhënave. Transformimi i saj nga përfaqësimi në bajta në një objekt ndodh vetëm kur është e nevojshme për kodin aplikativ, për shembull, për ta shfaqur në ekran. Duke qenë se kjo ndodh relativisht rrallë, kërkesat për shpejtësinë e kësaj procedure nuk janë aq kritike, dhe në implementimin e saj jemi në një masë më të madhe të lirë të orientohemi në komoditet. Për shembull, për seralizimin e metadata-ve për skedarët që ende nuk janë ngarkuar, ne përdorim NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Megjithatë, ka raste kur performanca ka rëndësi. Për shembull, për ruajtjen e metainformatave për strukturën e skedarëve në cloud-in e përdoruesit, ne përdorim sërish dump-in e memories së objekteve. Karakteristika e veçantë e detyrës për formimin e përfaqësimit të tyre të serializuar është fakti se elementët e direktorisë modelohen nga një hierarki klasash.
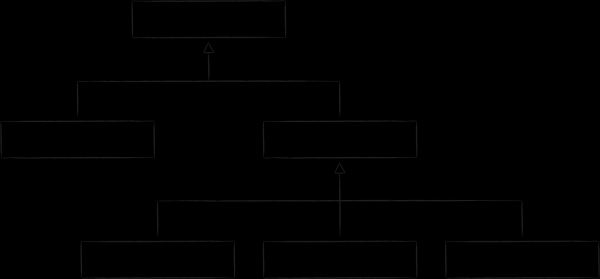
Për implementimin e saj në gjuhën C, fushat specifike të trashëgimtarëve nxirren në struktura të veçanta, dhe lidhja e tyre me të dhënat bazohet në një fushë të tipit union. Përmbajtja aktuale e union-it përcaktohet përmes atributit teknik type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Shtimi dhe përditësimi i regjistrimeve
Çelësi dhe vlera të serializuara mund të shtohen në ruajtje. Për këtë përdoret funksioni mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);Në fazën e konfigurimit, magazinës i lejohet ose ndalohet ruajtja e disa regjistrimeve me të njëjtin çelës. Nëse dyfishimi i çelësave është i ndaluar, atëherë gjatë inserimit të një regjistrimi mund të përcaktohet nëse lejohet azhurnimi i regjistrimit ekzistues apo jo. Nëse mbishkrimi ndodh vetëm për shkak të një gabimi në kod, atëherë mund të mbroheni nga ai duke caktuar një flamur NOOVERWRITE.
Leximi i regjistrimeve
Për leximin e regjistrimeve në LMDB është parashikuar funksioni mdb_get. Nëse çifti çelës-vlerë është paraqitur më parë me struktura të dumpuara, atëherë kjo procedurë duket si më poshtë.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Lista e paraqitur tregon se si serializimi përmes dump-it të strukturove lejon të hiqen alokimet dinamike jo vetëm gjatë shkruarjes, por edhe gjatë leximit të të dhënave. E shkruar nga funksioni mdb_get përfaqëson me saktësi adresën e memories virtuale, ku baza e të dhënave ruan përfaqësimin në byte të objektit. Në fakt, ne kemi një ORM të tillë, që në mënyrë praktike siguron një shpejtësi shumë të lartë të leximit të të dhënave. Pavarësisht bukurisë së qasjes, është e nevojshme të mbahet mend disa karakteristika të lidhura me të.
- Për transaksionet readonly, treguesi në strukturën-vlerë do të mbetet i vlefshëm vetëm deri në mbylljen e transaksionit. Siç u përmend më parë, faqet e pemës B, mbi të cilat qëndron objekti, për shkak të parimit copy-on-write mbeten të pandryshuara deri sa ato referohen nga të paktën një transaksion. Në të njëjtën kohë, sapo përfundon transaksioni i fundit i lidhur me to, faqet mund të ripërdoren për të dhëna të reja. Nëse është e nevojshme që objektet të jetojnë përtej transaksionit që i krijoi, ato duhet të kopjohen.
- Për transaksionet readwrite, treguesi në strukturën-vlerë të marrë do të jetë i vlefshëm vetëm deri në procedurën e parë modificuese (shkrim ose fshirje të të dhënave).
- Pavarësisht se struktura
NodeValuenuk është plotësisht e plotë, por e prishur (shih nënseksionin ‘Rendi i çelësave me krahasues të jashtëm’), mund të qaseni në fushat e saj përmes treguesit. E rëndësishme është të mos e çmontoni atë! - Aspak, strukturën nuk duhet të modifikoni kurrsesi përmes treguesit të marrë. Të gjitha ndryshimet duhet të realizohen vetëm përmes metodës
mdb_put. Megjithatë, pavarësisht dëshirës për ta bërë këtë, nuk do të mundesh, pasi zona e memories ku ndodhet kjo strukturë është e hartuar në modalitetin readonly. - Rimapping i skedës në hapësirën adresore të procesit me qëllim, për shembull, për të rritur madhësinë maksimale të ruajtjes përmes funksionit
dëshmon të gjitha entitetet (kursoret, transaksionet, çelësat dhe vlerat) që janë marrë më parë nga motori. Të merrni parasysh një kthesë të tillë ngjarjesh në kod do të çonte në një ndërlikim të rëndësishëm të tij. Nëse megjithatë, memoria virtuale është shumë e rëndësishme për ju, kjo mund të jetë një arsye për të shqyrtuar një fork që ka avancuar ndjeshëm përpara,çdo transaksion dhe entitete të lidhura me to dhe treguesit e objekteve të lexuara në veçanti invalidon plotësisht.
Së fundmi, një veçori tjetër është kaq e rrezikshme, saqë zbulimi i natyrës së saj nuk përshtatet lehtë në një tjetër pikë. Në kapitullin për B-dendësinë, kam paraqitur një diagram të dispozitivit të tij të faqeve në memorie. Nga kjo rezulton se adresa e fillimit të tamponit me të dhëna të serializuara mund të jetë krejtësisht e rastësishme. Për shkak të kësaj, treguesi për to, i marrë në strukturë Çelësat dhe vlerat dhe i konvertuar në një tregues për strukturën, në tërësi nuk është i përputhur. Megjithatë, arkitekturat e disa çipave (në rastin e iOS është armv7) kërkojnë që adresa e çdo të dhëne të jetë e barabartë me madhësinë e fjalës makinerike ose, me fjalë të tjera, bitësinë e sistemit (për armv7 — kjo është 32 bit). Me fjalë të tjera, një operacion i tillë si *(int *foo)0x800002 udohet të barazohet me ikjen dhe shkakton ndëshkimin me verdiktin EXC_ARM_DA_ALIGN. Të shmangni një fat të tillë të trishtueshëm mund të bëhet me dy mënyra.
E para konsiston në kopjimin paraprak të të dhënave në një strukturë tashmë të përputhur. Për shembull, në një krahasues të personalizuar do të reflektohet kështu.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \\ ...
}
Një rrugë alternative është të njoftoni paraprakisht kompilerin se strukturat me çelës dhe vlerë mund të mos jenë të përputhura me atributin aligned(1). Në ARM mund të arrihet një efekt të ngjashëm edhe me atributin packed. Duke marrë parasysh se ai gjithashtu ndihmon në optimizimin e hapësirës së zënë nga struktura, ky mënyrë më duket e preferuar, ndonëse shkakton rritjen e kostove të operacioneve të qasjes në të dhëna.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Kërkesa për diapazone
Për iterimin e një grupi rekordesh në LMDB, ekziston një abstraktë e kursit. Si ta përdorim atë, do ta shqyrtojmë me shembuj të njohur të tabelës me metadatat e cloud-it të përdoruesit.
Në kuadër të shfaqjes së listës së skedareve në direktor, është e nevojshme të gjenden të gjitha çelësat me të cilat janë të asocuar skedarët dhe folderët e saj. Në nënseksionet e mëparshme, i kemi renditur çelësat NodeKey në mënyrë që ata të jenë të renditur fillimisht sipas identifikuesit të direktorisë prind. Pra, në thelb, detyra për të marrë përmbajtjen e folderit reduktohet në vendosjen e kursit në kufirin e sipërm të grupit të çelësave me një prefiks të caktuar dhe pastaj të iteroni deri në kufirin e poshtëm.
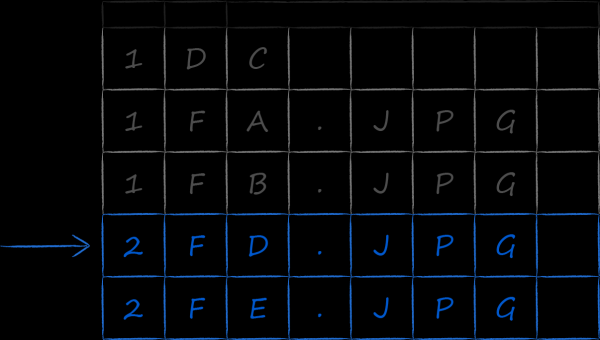
Kufirin e sipërm mund ta gjeni "në mënyrë të drejtpërdrejtë" përmes një kërkimi të vazhdueshëm. Për këtë, kursi vendoset në fillim të listës së gjithë çelësave në bazën e të dhënave dhe pastaj rritet deri sa të vendoset nën një çelës me identifikuesin e direktorive prind. Ky qasje ka dy disavantazhe të evidentuara:
- Kështuqë, kompleksiteti linear i kërkimit, megjithëse, siç dihet, në pemë dhe veçanërisht në pemët B, mund të realizohet në kohë logarimore.
- Kjo që është e pakuptimtë është se ngrihen nga dosja në memorjen kryesore të gjitha faqet që e parakalojnë kërkimin, e cila është shumë e shtrenjtë.
Për fat të mirë, në API-në e LMDB-së është paraparë një mënyrë efektive për pozicionimin fillestar të kursit. Për këtë, është e nevojshme të formohet një çelës i tillë, vlera e të cilit do të jetë sigurisht më e vogël ose e barabartë me çelësin që ndodhet në kufirin e sipërm të intervalit. Për shembull, në përputhje me listën në figurën e mësipërme, ne mund të krijojmë një çelës të tillë, ku fusha parentId do të jetë e barabartë me 2, dhe të gjitha pjesët e tjera të mbushura me zero. Ky çelës i plotësuar pjesërisht do t'i dorëzohet funksionit mdb_cursor_get me specifikimin e operacionit MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Nëse kufiri i sipërm i grupit të çelësave është gjetur, atëherë iteronim për të deri sa ose të hasim një çelës tjetër parentId, ose çelësat të përfundojnë krejtësisht.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// processing...
} while (MDB_NOTFOUND != rc && // kontrollo fundin e tabelës
IsTargetKey(key)); // kontrollo fundin e grupit të çelësaveE bukur është se, gjatë iterimit me mdb_cursor_get, ne marrim jo vetëm çelësin, por gjithashtu edhe vlerën. Nëse për të përmbushur kushtet e kërkimit duhen kontrolluar gjithashtu fushat nga pjesa e vlerës së regjistrimit, ato janë plotësisht të aksesueshme pa ndonjë lëvizje shtesë.
4.3. Modelimi i lidhjeve midis tabelave
Derisa kemi arritur të shqyrtojmë të gjitha aspektet e projektimit dhe funksionimit me një bazë të dhënash me një tabelë. Mund të themi se tabela është një grup regjistrimesh të renditura, të përbëra nga çifte të kufizuara çelës-vlerë. Nëse paraqesim çelësin në formën e një drejtkëndëshi dhe vlerën e lidhur me të në formën e një paralelopipedhi, rezulton një skemë vizuale e bazës së dhënash.

Megjithatë, në jetën reale, është e rrallë që të arrihet pa ndonjë përpjekje të madhe. Në shumë raste, një bazë e dhënash kërkon, së pari, që të ketë disa tabela, dhe së dyti, të realizojë kërkesa në një rend të ndryshëm nga çelësi fillestar. Këtë kapitull të fundit e përkushtohet pyetjeve të krijimit të tyre dhe lidhjes midis tyre.
Tabelat indekse
Në aplikacionin në cloud ka një seksion 'Galeria'. Aty shfaqet përmbajtja multimediale nga gjithë cloud-i, e renditur sipas datës. Për realizimin optimal të një kërkese të tillë, përveç tabelës kryesore, është e nevojshme të krijohet një tjetër me një tip të ri çelesh. Aty do të përmbahen një fushë me datën e krijimit të skedarit, e cila do të shërbejë si kriteri kryesor për renditjen. Duke qenë se çelësat e rinj lidhen me të njëjtat të dhëna si çelësat në tabelën kryesore, ata quhen indekse. Në imazhin më poshtë, ata janë theksuar me ngjyrë portokalli.
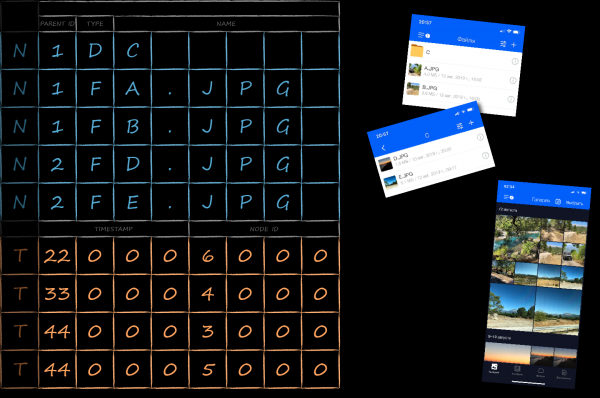
Për të ndarë çelësat e tabelave të ndryshme brenda një baze të dhënash, atyre iu është shtuar një fushë teknike të quajtur tableId. Duke e bërë atë prioritar për renditjen, ne do të arrijmë grupimin e çelësave së pari sipas tabelave dhe më pas brenda tabelave sipas rregullave tona.
Çelësi indeks i referohet të njëjtave të dhëna si çelësi fillestar. Implementimi i drejtpërdrejtë i kësaj prone përmes asocios me një kopje të pjesës së vlerës së çelësit fillestar është jooptimal nga disa këndvështrime:
- Nga këndvështrimi i hapësirës së zënë, pasi metadata mund të jetë shumë e pasur.
- Nga perspektiva e performancës, sepse gjatë përditësimit të metadata-ve, nyjat do të duhet të bëjnë një shkruhet për dy çelësa.
- Në aspektin e mbështetjes së kodit, nëse harrojmë të azhurnojmë të dhënat për një nga çelësat, do të hasim një defekt të vështirë për t'u kapur të moskoherencës së të dhënave në depo.
Më pas do të shqyrtojmë se si të eliminojmë këto mangësi.
Organizimi i lidhjeve mes tabelave
Për lidhjen e tabelës indekse me atë kryesore, patterni më i mirë është «çelësi si vlerë». Siç tregojnë emri dhe natyra e tij, si pjesë vlerë e regjistrimit të indeksit shërben një kopje e vlerës së çelësit primar. Ky qasje përmbush të gjitha mangësitë e mësipërme që lidhen me ruajtjen e një kopje të pjesës vlerë të regjistrimit primar. Çmimi i vetëm është se për të marrë vlerën sipas çelësit të indeksit, ne kemi nevojë të bëjmë 2 kërkesa në bazën e të dhënave në vend të një.
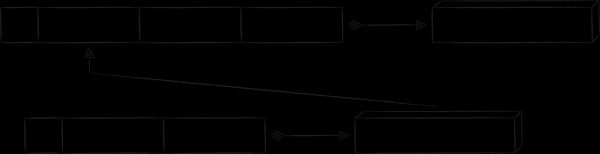
Një tjetër pattern organizimi i lidhjeve mes tabelave është «çelësi i tepërt». Thelbi i tij qëndron në shtimin e atributeve të tjera në çelës, të cilat nuk janë të nevojshme për renditjen, por për rikrijimin e çelësit të lidhur. Në aplikacionin Cloud të Mail.ru ka raste reale të përdorimit të tij, por për të shmangur një depërtim të thellë në kontekstin e çarqeve specifike të iOS, do të jap një shembull të sajuar, por më të kuptueshëm.
Në klientët mobil në cloud ka një faqe ku shfaqen të gjitha skedaret dhe dosjet të cilave përdoruesi u ka dhënë akses njerëzve të tjerë. Duke qenë se këto skedare janë relativisht pak, por ka shumë informacione specifike të lidhura me publikimin (kush ka akses, me çfarë të drejtash, etj.), do të ishte jo racionale të rëndohej pjesa vlerë e regjistrimit në tabelën kryesore. Megjithatë, nëse dëshirojmë t'i shfaqim këto skedare offline, atëherë duhet t'i ruajmë diku. Një zgjidhje e natyrshme është krijimi i një tabele të veçantë për to. Në diagramin më poshtë, çelësi i saj ka një prefiks «P», dhe placeholder'i «propname» mund të zëvendësohet me një vlerë më specifike «public info».
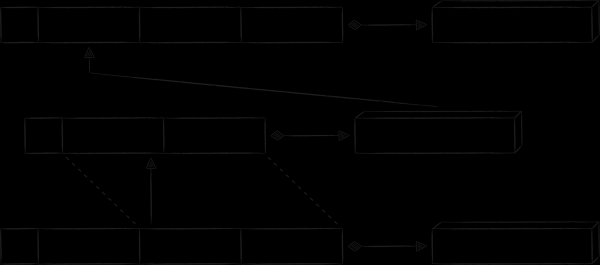
Të gjitha metadatabazat unike, për të cilat u krijua tabela e re, transferohen në pjesën me vlerë të regjistrimit. Në të njëjtën kohë, të dhënat për skedarët dhe dosjet që tashmë ruhet në tabelën kryesore, nuk dëshirohet të kopjohen. Në vend të kësaj, në çelësin "P" shtohen të dhëna të tepërta në formën e fushave "node ID" dhe "timestamp". Falë tyre mund të ndërtohet një çelës indeks, me të cilin mund të merret çelësi primar, me të cilin përfundimisht mund të merren metadatat e nodës.
Përfundimi
Ne e vlerësojmë pozitivisht zbatimin e LMDB. Pas tij, numri i ngritjeve të aplikacionit u ul me 30%.
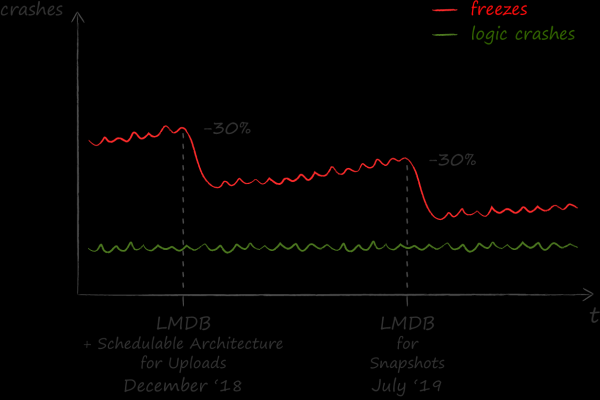
Rezultatet e punës së kryer kanë gjetur mbështetje edhe përtej ekipit të iOS. Në këtë moment, një nga seksionet kryesore "Skedarët" në aplikacionin për Android gjithashtu kaloi në përdorimin e LMDB, dhe pjesët e tjera janë në proces. Gjuha C, në të cilën është realizuar magazinimi key-value, ishte një ndihmë e mirë për të krijuar fillimisht një lidhesë aplikative rreth tij në mënyrë cross-platforme në gjuhën C++. Për lidhjen pa probleme të bibliotekës C++ me kodin platformik në Objective-C dhe Kotlin, u përdor një gjenerator kodi. nga Dropbox, por kjo është një histori krejt tjetër.
Burimi: habr.com
