

Shumë njerëz që hyjnë në fushën e Data Science kanë përfytyrime jo krejt realiste për atë çfarë i pret. Shumë mendojnë se tani do të shkruajnë ndërlidhëse të mëdha, do të krijojnë një ndihmës vokal si Iron Man apo do t'i kalojnë të gjithë në tregjet financiare.
Por puna Të dhëna Scientist është e lidhur ngushtësisht me të dhënat, dhe një nga momentet më të rëndësishme dhe më kohëkonsumues është përpunimi i të dhënave para se ato të dorëzohen në ndërlidhëse ose të analizohet në një mënyrë të caktuar.
Në këtë artikull, ekipi ynë do të përshkruajë se si mund të përpunoni të dhënat lehtësisht dhe shpejt me një udhëzues hap pas hapi dhe kodin përkatës. Ne u përpoqëm ta bënim kodin mjaft fleksibël, në mënyrë që ai të mund të aplicohet për dataset të ndryshme.
Shumë profesionistë ndoshta nuk do të gjejnë asgjë të jashtëzakonshme në këtë artikull, por ata që janë të rinj do të mund të marrin diçka të re, si dhe çdo person që ka ëndërruar për një notebook të veçantë për përpunimin e shpejtë dhe të strukturuar të të dhënave, mund të kopjojë kodin dhe ta formatojë sipas dëshirës së tij, ose
Mora dataset-in. Çfarë duhet të bëjmë tani?
Pra, standardi: duhet të kuptojmë se me çfarë kemi të bëjmë, pamja e përgjithshme. Për këtë, do të përdorim pandas për të përcaktuar llojet e ndryshme të të dhënave.
import pandas as pd #importojmë pandas
import numpy as np  #importojmë numpy
df = pd.read_csv("AB_NYC_2019.csv") #lexojmë dataset-in dhe e ruajmë në variablën df
df.head(3) #shikojmë 3 rreshtat e parë për të kuptuar se si duken vlerat 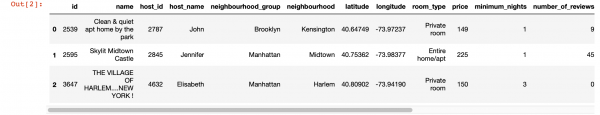
df.info() #Demonstrojmë informacionin mbi kolonat 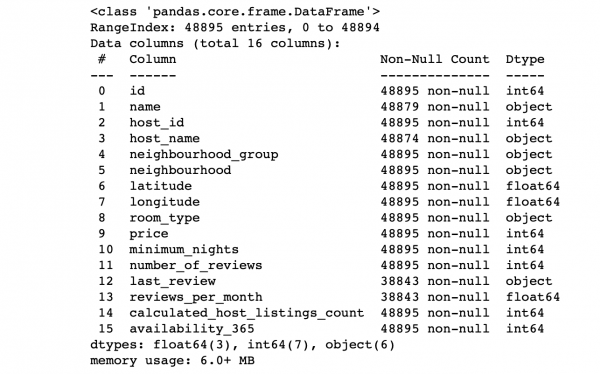
Shikojmë vlerat e kolonave:
- A përputhet numri i rreshtave të secilës kolone me numrin e përgjithshëm të rreshtave?
- Cila është thelbi i të dhënave në secilën kolone?
- Cilën kolone duam ta bëjmë objektiv, për të bërë parashikime për të?
Përgjigjet për këto pyetje do të lejojnë që të analizojmë dataset-in dhe të skicojmë një plan për veprimet e ardhshme.
Gjithashtu, për një vështrim më të thellë mbi vlerat në secilën kolone, mund të përdorim funksionin pandas describe(). Megjithatë, disavantazhi i këtij funksioni është se nuk jep informacion për kolonat me vlera string. Ne do t'i shqyrtojmë ato më vonë.
df.describe() 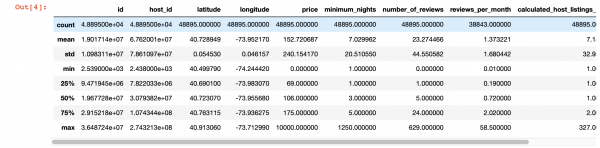
Vizualizimi magjik
Të shohim se ku na mungojnë vlerat krejtësisht:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 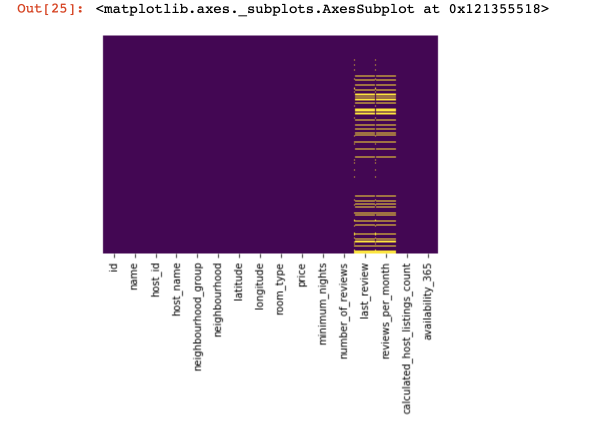
Ishte një vështrim i vogël nga lart, tani do të kalojmë në gjëra më interesante.
Do të përpiqemi të gjejmë dhe, nëse është e mundur, të heqim kolonat që kanë vetëm një vlerë në të gjitha rreshtat (ato nuk do të ndikojnë në rezultat):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Rikthejmë datasetin, duke mbajtur vetëm ato kolona ku ka më shumë se një vlerë unike
Tani, mbrojmë veten dhe suksesin e projektit tonë nga rreshtat e dyfishtë (rreshtat që përmbajnë të njëjtën informacion në të njëjtin rend, si një nga rreshtat ekzistues):
df.drop_duplicates(inplace=True) #E bëjmë këtë, nëse e konsiderojmë të nevojshme.
                                 #Në disa projekte nuk është e nevojshme të hiqen të dhënat e tilla që në fillim.
Pjesojmë datasetin në dy: një me vlera cilësore dhe një tjetër — me vlera sasiore
Këtu duhet sqaruar pak: nëse rreshtat me të dhëna të humbura në të dhënat cilësore dhe sasiore nuk përputhen fort me njëri-tjetrin, ne do të duhet të marrim një përcaktim se çfarë do të sakrifikojmë — të gjithë rreshtat me të dhëna të humbura, vetëm një pjesë të tyre ose disa kolona të caktuara. Nëse rreshtat përputhen, atëherë kemi plotësisht të drejtë të ndajmë datasetin në dy. Përndryshe, duhet së pari të merremi me rreshtat ku nuk përputhen të dhënat e humbura në cilësore dhe sasiore, dhe vetëm pastaj të ndajmë datasetin në dy.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
E bëjmë këtë për të na lehtësuar trajtimin e këtyre dy llojeve të ndryshme të të dhënave — më vonë do të kuptojmë se sa shumë e thjeshton jetën tonë.
Punojmë me të dhëna sasiore
E para që duhet të bëjmë është të përcaktojmë nëse ka "kolona spiun" në të dhënat sasiore. Ne i quajmë këto kolona kështu sepse ato maskohen si të dhëna sasiore, ndërsa në fakt funksionojnë si cilësore.
Si t'i përcaktojmë ato? Natyrisht, gjithçka varet nga natyra e të dhënave që po analizoni, por në shumicën e rasteve këto kolona mund të kenë pak të dhëna unike (rreth 3-10 vlera unike).
print(df_numerical.nunique())Pas vendosjes së kolonkave-spiun, do t'i transferojmë ato nga të dhënat sasiore në ato cilësore:
spy_columns = df_numerical[['kolonka1', 'kolonka2', 'kolonka3']]#ne heqim kolonkat spiun dhe i regjistrojmë në një dataframe të veçantë
df_numerical.drop(labels=['kolonka1', 'kolonka2', 'kolonka3'], axis=1, inplace = True)#heqim këto kolona nga të dhënat numerike
df_categorical.insert(1, 'kolonka1', spy_columns['kolonka1']) #shtojmë kolonën e parë spiun në të dhënat kategorike
df_categorical.insert(1, 'kolonka2', spy_columns['kolonka2']) #shtojmë kolonën e dytë spiun në të dhënat kategorike
df_categorical.insert(1, 'kolonka3', spy_columns['kolonka3']) #shtojmë kolonën e tretë spiun në të dhënat kategorike
Më në fund kemi ndarë plotësisht të dhënat numerike nga ato kategorike dhe tani mund të punojmë më mirë me to. E para — duhet të kuptojmë se ku kemi vlera të zbrazëta (NaN, dhe në disa raste edhe 0 do të pranohen si vlera të zbrazëta).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
Në këtë fazë është e rëndësishme të kuptojmë në cilat kolona 0-t mund të përfaqësojnë vlera të humbura: a lidhet kjo me mënyrën se si janë mbledhur të dhënat? Apo mund të jetë e lidhur me vlerat e të dhënave? Duhet të përgjigjemi për këto pyetje në çdo rast të veçantë.
Pra, nëse jemi të vendosur se të dhënat tona mund të mungojnë atje ku ka 0, duhet të zëvendësojmë 0-t me NaN, që të mund të punojmë më pas me këto të dhëna të humbura:
df_numerical[["kolonka 1", "kolonka 2"]] = df_numerical[["kolonka 1", "kolonka 2"]].replace(0, nan)Tani le të shohim ku na mungojnë të dhënat:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Mund të përdorim gjithashtu df_numerical.info() 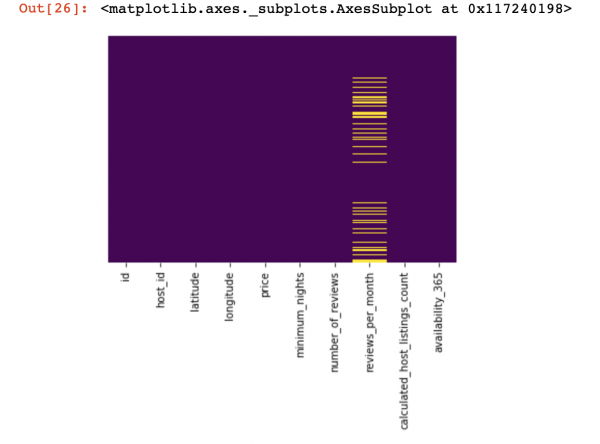
Këtu duhet të shfaqen me ngjyrë të verdhë ato vlera brenda kolonave që mungojnë. Dhe tani fillon e gjitha — si të veprojmë me këto vlera? Të fshijmë rreshtat me këto vlera apo kolonat? Ose t'i mbushim këto vlera të zbrazëta me ndonjë të dhënë tjetër?
Ja një skemë e përafërt që mund t'ju ndihmojë të vendosni se çfarë mund të bëni në parim me vlerat e zbrazëta:
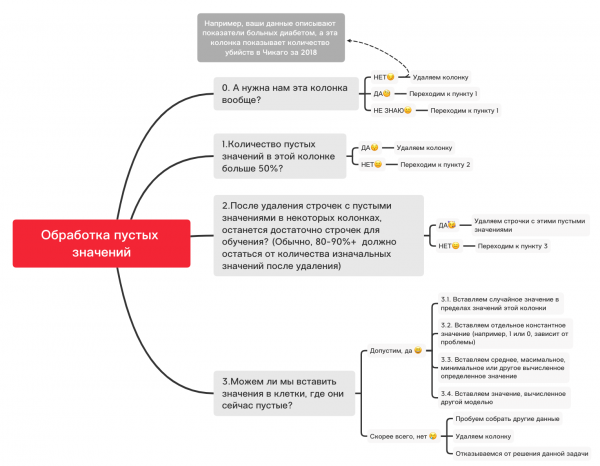
0. Heqim kolonat e panevojshme
df_numerical.drop(labels=["kolonka1","kolonka2"], axis=1, inplace=True)1. A janë vlerat e zbrazëta në këtë kolonë më shumë se 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["kolonka1","kolonka2"], axis=1, inplace=True)#Heqim nëse ndonjë kolonë ka më shumë se 50 vlera të zbrazëta2. Heqim rreshtat me vlera të zbrazëta
df_numerical.dropna(inplace=True) # Hiqim rreshtat me vlera bosh, nëse më pas mbeten mjaft të dhëna për trajnimin3.1. Futim një vlerë të rastësishme
import random # importojmë random
df_numerical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True) # futim vlera rastësore në qelizat bosh të tabelës
3.2. Futim një vlerë konstante
from sklearn.impute import SimpleImputer # importojmë SimpleImputer, i cili do na ndihmojë të futim vlera
imputer = SimpleImputer(strategy='constant', fill_value="") # futim një vlerë të caktuar përmes SimpleImputer
df_numerical[["kolona_e_re1", 'kolona_e_re2', 'kolona_e_re3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) # E zbatojmë këtë për tabelën tonë
df_numerical.drop(labels=["kolona1", "kolona2", "kolona3"], axis=1, inplace=True) # Heqim kolonat me vlerat e vjetra
3.3. Futim mesataren ose vlerën më të shpeshtë
from sklearn.impute import SimpleImputer # importojmë SimpleImputer, i cili do na ndihmojë të futim vlera
imputer = SimpleImputer(strategy='mean', missing_values=np.nan) # në vend të mean mund të përdorim edhe most_frequent
df_numerical[["kolona_e_re1", 'kolona_e_re2', 'kolona_e_re3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) # E zbatojmë këtë për tabelën tonë
df_numerical.drop(labels=["kolona1", "kolona2", "kolona3"], axis=1, inplace=True) # Heqim kolonat me vlerat e vjetra
3.4. Futim vlerën, e cila llogaritet nga një model tjetër
Ndonjëherë, vlerat mund të llogariten përmes modeleve regresionale, duke përdorur modelet nga biblioteka sklearn ose biblioteka të ngjashme. Ekipa jonë do t'i kushtojë një artikulli të veçantë se si të bëhet kjo në të ardhmen e afërt.
Pra, për momentin narrativa mbi të dhënat numerike do të ndalet, sepse ka shumë nuanca të tjera mbi atë se si të bëhet më mirë përgatitja e të dhënave dhe paraprocesimi për detyra të ndryshme, dhe gjërat bazike për të dhënat numerike janë marrë parasysh në këtë artikull, dhe tani është koha të kthehemi te të dhënat cilësore, të cilat i ndamë disa hapa më parë nga të dhënat numerike. Ju mund të modifikoni këtë notebook ashtu siç dëshironi, duke e përshtatur atë për detyra të ndryshme, që përgatitja e të dhënave të kalojë shumë shpejt!
Të dhënat cilësore
Në përgjithësi, për të dhëna cilësore përdoret metoda One-hot-encoding, për ta formatuar atë nga string (ose object) në numër. Para se të kalojmë në këtë pikë, le të përdorim skemën dhe kodin lart, për ta kuptuar vlerat e zbrazëta.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 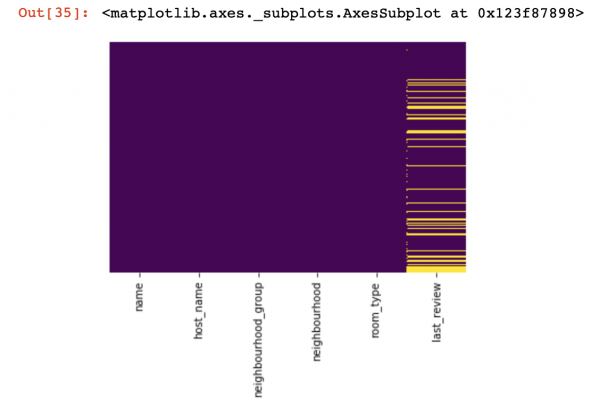
0. Heqim kolonat e panevojshme
df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True)1. A janë vlerat e zbrazëta në këtë kolonë më shumë se 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True) # Heqim nëse ndonjë kolonë
# ka më shumë se 50% vlera të zbrazëta2. Heqim rreshtat me vlera të zbrazëta
df_categorical.dropna(inplace=True) # Heqim rreshtat me vlera të zbrazëta,
                                   # nëse më pas do të mbeten mjaft të dhëna për trajnim
3.1. Futim një vlerë të rastësishme
import random
df_categorical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True)
3.2. Futim një vlerë konstante
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["kolona_e_re1", 'kolona_e_re2', 'kolona_e_re3']] = imputer.fit_transform(df_categorical[['kolona1', 'kolona2', 'kolona3']])
df_categorical.drop(labels=["kolona1", "kolona2", "kolona3"], axis=1, inplace=True)
Pra, përfundimisht ne i zgjidhëm vlerat e zbrazëta në të dhënat cilësore. Tani është koha të realizojmë one-hot-encoding për vlerat që ndodhen në bazën tuaj të të dhënave. Kjo metodë përdoret shumë shpesh për t'i mundësuar algoritmit tuaj të mësojë duke marrë parasysh të dhënat cilësore.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolona1", "kolona2", "kolona3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Pra, përfundimisht përfunduam me trajtimin e veçantë të të dhënave cilësore dhe atyre numerike — është koha t'i kombinojmë përsëri.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Pas që kemi bashkuar dataset-et në një, në fund mund të përdorim transformimin e të dhënave me anë të MinMaxScaler nga biblioteka sklearn. Kjo do të bëjë që vlerat tona të jenë në kufijtë e 0 deri në 1, gjë që do të ndihmojë në trajnim të modelit në të ardhmen.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Këto të dhëna tani janë gati për gjithçka — për rrjetet neuronale, algoritmët standard të ML dhe etj!
Në këtë artikull nuk kemi përfshirë punën me të dhënat që lidhen me seritë temporale, pasi për këto të dhëna duhet të përdoren teknikë të tjera për përpunimin e tyre, në varësi të detyrës suaj. Në të ardhmen, ekipi ynë do t’i kushtojë kësaj teme një artikull të veçantë, dhe ne shpresojmë se ai do të mund të sjellë diçka interesante, të re dhe të dobishme në jetën tuaj, ashtu si edhe ky artikull.
Burimi: habr.com
