

Përshëndetje të gjithëve! Quhem Dmitry Samsonov, punoj si administrator kryesor i sistemeve në 'Odnoklassniki'. Ne kemi mbi 7 mijë servera fizikë, 11 mijë kontejnerë në re dhe 200 aplikacione që në konfigurime të ndryshme formojnë 700 klasterë të ndryshëm. Shumica dërrmuese e serverëve punojnë nën administrimin e CentOS 7.
Më 14 gusht 2018 u publikua informacioni për një dobësi të FragmentSmack
() dhe SegmentSmack (). Këto janë dobësi me vektor sulmi rrjetor dhe një vlerësim mjaft të lartë (7.5), e cila rrezikon shërbimin (DoS) për shkak të shterimit të burimeve (CPU). Një rregullim në bërthamë për FragmentSmack në atë kohë nuk ishte propozuar, madje, ai doli shumë më vonë pas publikimit të informacionit për dobësinë. Për të adresuar SegmentSmack, ishte sugjeruar të bëhej përmirësimi i bërthamës. Paketa e përmirësimit u lëshua në të njëjtën ditë, mbetej vetëm ta instalonim.
Jo, ne nuk jemi aspak kundër përmirësimit të bërthamës! Megjithatë, ka nuanca…
Si e përmirësojmë bërthamën në prodhim
Në përgjithësi, nuk ka asgjë të komplikuar:
- Shkarkoni paketat;
- Instaloni ato në një sasi serverësh (përfshirë serverët që hostojnë re tonë);
- Sigurohuni që asgjë të mos ishte prishur;
- Kontrolloni që të gjitha cilësimet standarde të bërthamës të ishin aplikuar pa gabime;
- Prisni disa ditë;
- Kontrolloni parametrat e serverëve;
- Drejtoni vendosjen e serverëve të rinj në bërthamën e re;
- Përmirësoni të gjithë serverët sipas qendrave të të dhënave (një qendër të dhënash në një kohë, për të minimizuar efektin për përdoruesit në rast problemas);
- Rinisni të gjithë serverët.
Përsëritni këtë për të gjitha degët e bërthamave që kemi. Deri më tani, këto janë:
- Bërthama standarde CentOS 7 3.10 — për shumicën e serverëve të zakonshëm;
- Bërthama vanilla 4.19 — për re , sepse na nevojitet BFQ, BBR etj.;
- Elrepo kernel-ml 5.2 — për , sepse 4.19 më parë tregonte sjellje të paqëndrueshme, ndërsa karakteristikat janë të njëjta.
Si e keni marrë me mend, kjo procedurë merr më së shumti kohë për të rinisur mijëra serverë. Duke qenë se jo të gjitha dobësitë janë kritike për të gjithë serverët, ne rinisemi vetëm ato që janë të aksesueshme drejtpërdrejt nga interneti. Në re, për të mos kufizuar fleksibilitetin, ne nuk lidhen kontejnerët e aksesueshëm nga jashtë me serverë të veçantë me bërthamë të re, por rinisim të gjitha hostet pa përjashtim. Për fat të mirë, atje procedura është më e thjeshtë se me serverë të zakonshëm. Për shembull, kontejnerët stateless mund thjesht të kalojnë në një server tjetër gjatë rinisjes.
Megjithatë, ende ka shumë punë, dhe kjo mund të zgjasë disa javë, ose në rast se ndodhin ndonjë problem me versionin e ri — deri në disa muaj. Kriminelët e kuptojnë këtë mirë, prandaj na nevojitet një plan ‘B’.
FragmentSmack\/SegmentSmack. Zgjidhje alternative
Për fat të mirë, për disa dobësi ekziston një plan ‘B’, i cili quhet Zgjidhje alternative. Më së shpeshti, kjo do të thotë ndryshimi i cilësimeve të bërthamës\/aplikacioneve, që lejojnë minimalizimin e efektit të mundshëm ose përjashtimin e plotë të shfrytëzimeve të dobësive.
Në rastin e FragmentSmack\/SegmentSmack një zgjidhje alternative të tillë:
«Është e mundur të ndryshoni vlerat e parazgjedhura 4MB dhe 3MB në net.ipv4.ipfrag_high_thresh dhe net.ipv4.ipfrag_low_thresh (dhe ekuivalentet e tyre për ipv6 net.ipv6.ipfrag_high_thresh dhe net.ipv6.ipfrag_low_thresh) në 256 kB dhe 192 kB përkatësisht, ose më poshtë. Testet tregojnë se ka një rënie të vogël deri në të konsiderueshme të përdorimit të CPU gjatë sulmeve, në varësi të pajisjeve, cilësimeve dhe kushteve. megjithatë, mund të ketë një ndikim në performancë për shkak të ipfrag_high_thresh=262144 bytes, pasi vetëm dy 64K-fragmente mund të vendosen njëkohësisht në radhë për rinisje. Për shembull, ekziston rreziku që aplikacionet që funksionojnë me paketa të mëdha UDP të dështojnë.».
Parametrat e vetë përshkruhen si:
ipfrag_high_thresh - NUMËR TË GJATË
     Memoria maksimale e përdorur për të ribashkuar fragmentet IP.
ipfrag_low_thresh - NUMËR I GJATË
     Memoria maksimale e përdorur për të rindërtuar fragmente IP para se bërthama
     të fillojë të heqë radhët e paplota të fragmenteve për të çliruar burimet.
     Bërthama ende pranon fragmente të reja për defragmentim.
Në shërbimet e prodhimit nuk kemi UDP të mëdhenj. Në LAN, trafik i frakturësuar nuk ekziston, në WAN ka, por jo në përmasa të mëdha. Asgjë nuk parashikon — ne mund të implementojmë zgjidhjen alternative!
FragmentSmack\/SegmentSmack. Gjakimi i parë
Problemi i parë me të cilin u përballëm ishte se kontejnerët e mjeteve në cloud shpesh i aplikonin konfigurimet e reja vetëm pjesërisht (vetëm ipfrag_low_thresh), dhe ndonjëherë nuk i aplikonin fare — thjesht dështonin në nisje. Nuk arritëm ta riprodhojmë problemin me stabilitet (ndërsa manualisht të gjitha konfigurimet aplikohej pa asnjë vështirësi). Të kuptosh pse kontejneri dështon në nisje, gjithashtu, nuk është aq e lehtë: nuk u gjetën ndonjë gabim. Një gjë ishte e sigurt: rikthimi i konfigurimeve zgjidhte problemin me dështimin e kontejnerëve.
Pse nuk mjafton të aplikosh Sysctl në host? Kontejneri jeton në Namespace-in e tij të pavarur të rrjetit, prandaj të paktën në kontejner mund të jetë e ndryshme nga hosti.
Si aplikohet saktësisht konfigurimi i Sysctl në kontejner? Duke qenë se kontejnerët tanë janë të pa privilegjuar, nuk mund të ndryshosh ndonjë konfigurim Sysctl duke hyrë brenda kontejnerit — thjesht nuk ka mjaft të drejta. Për nisjen e kontejnerëve, cloud-i ynë në atë kohë përdorte Docker (tani tashmë ). Dokkerit i kaloheshin parametrat e kontejnerit të ri përmes API-së, duke përfshirë konfigurimet e nevojshme Sysctl.
Gjatë shqyrtimit të versioneve u zbulua se API Docker nuk jepte të gjitha gabimet (të paktën në versionin 1.10). Në përpjekjen për të nisur kontejnerin përmes 'docker run', përfundimisht pamë diçka:
write /proc/sys/net/ipv4/ipfrag_high_thresh: argument i pavlefshëm docker: Përgjigja e gabimit nga daemoni: Nuk mund të nisi kontejnerin <...>: [9] Gabim sistemi: nuk mund të sinkronizohej me procesin e kontejnerit.
Vlera e parametrave nuk është e vlefshme. Por pse? Dhe pse ajo nuk është e vlefshme vetëm ndonjëherë? U zbulua se Docker nuk garanton rendin e aplikimit të parametrave Sysctl (versioni më i fundit i verifikuar — 1.13.1), kështu që ndonjëherë ipfrag_high_thresh përpiqej të vendoseshin në 256K, kur ipfrag_low_thresh ishte ende 3M, qoftë edhe kufiri superior ishte më i ulët se ai inferior, gjë që çonte në gabimin.
Në atë kohë, ne tashmë kishim një mekanizëm të vetin për konfiguruar sërish kontejnerin pas nisjes (ndalimi i kontejnerit përmes dhe ekzekutimi i komandave në namespace-in e kontejnerit përmes ), dhe ne e shtuam këtë pjesë me shkrimin e parametrave Sysctl. Problemi u zgjidh.
FragmentSmack/SegmentSmack. Gjakderdhja e Parë 2
Nuk e arritëm të kuptojmë përdorimin e Workaround në re, sapo filluan të vijnë ankesat e para të rralla nga përdoruesit. Në atë kohë kishin kaluar disa javë nga fillimi i përdorimit të Workaround në serverët e parë. Hetimi fillestar tregoi se ankesat vinin për shkak të shërbimeve të veçanta, dhe jo për të gjithë serverët e këtyre shërbimeve. Problemi e mori përsëri një karakter të paqartë.
Në radhë të parë, natyrisht, ne provuam të kthejmë cilësimet e Sysctl, por kjo nuk pati asnjë efekt. Manovra të ndryshme me cilësimet e serverit dhe aplikacionit gjithashtu nuk ndihmuan. Ndihmoi reboot. Reboot për Linux është po aq i kundërt siç ishte një kusht normal për të punuar me Windows në ditët e kaluara. Megjithatë, ai ndihmoi dhe ne e trajtuam gjithçka si një 'defekt në bërthamë' gjatë përdorimit të cilësimeve të reja në Sysctl. Sa e lehtë ishte kjo...
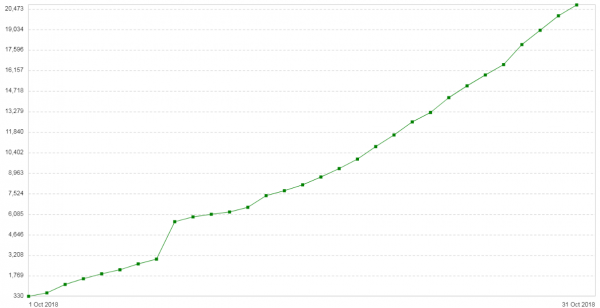
Pas tre javësh, problemi u përsërit. Konfigurimi i këtyre serverëve ishte mjaft i thjeshtë: Nginx në mënyrën proxy/balancues. Nuk kishte shumë trafik. Një informacion i ri: numri i gabimeve 504-ësh po rritet çdo ditë te klientët (). Grafikoni tregon numrin e gabimeve 504 në ditë për këtë shërbim:
Të gjitha gabimet bëhen për të njëjtin backend — për atë që ndodhet në re. Grafikoni i konsumit të memorjes për fraksionet e paketeve në këtë backend dukej si më poshtë:
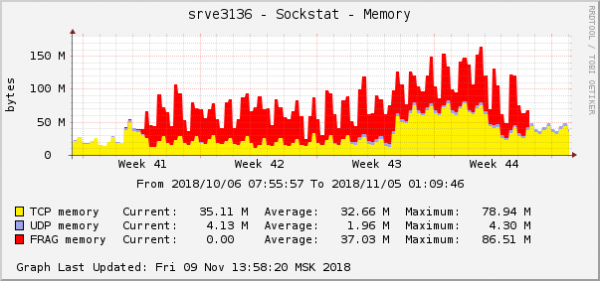
Ky është një nga manifestimet më të dukshme të problemit në grafikët e sistemit operativ. Në re, pikërisht në atë kohë, u rregullua një problem tjetër rrjetëor me cilësimet QoS (Kontrolli i Trafikut). Grafikoni i konsumit të memorjes për fraksionet e paketeve dukej pikërisht ashtu si më parë:
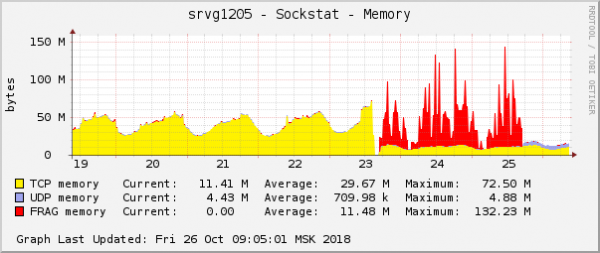
Supozimi ishte i thjeshtë: nëse në grafikët ato duken të njëjta, atëherë edhe arsyeja është e njëjtë. Më shumë, pasi që ndodhin shumë rrallë probleme me këtë lloj memorjeje.
Thelbi i problemit të rregulluar ishte se ne përdornim në QoS programin e planifikimit të paketave fq me cilësimet e paracaktuara. Në mënyrë të paracaktuar, për një lidhje ai lejon të shtohen në radhë 100 paketa dhe disa lidhje në situatën e mungesës së kanalit filluan të mbushnin radhën deri në kufi. Në këtë rast, paketat hidhen. Në statistikën tc (tc -s qdisc) kjo duket ashtu:
qdisc fq 2c6c: prind 1:2c6c kufizim 10000p fluksi_kufizim 100p kanistra 1024 orphan_mask 1023 quantum 3028 quantum_fillest 15140 refill_delay 40.0ms
  Dërguar 454701676345 byte 491683359 pkt (të hequra 464545, mbi kufijtë 0, rikthime 0)
  backlog 0b 0p rikthime 0
   1024 flukset (1021 inaktive, 0 të kufizuara)
   0 gc, 0 prioritet të lartë, 0 të kufizuara, 464545 flukset_plimit
"464545 flows_plimit" është paketa e hedhur për shkak të tejkalimit të limitit të radhës së një lidhjeje, ndërsa "dropped 464545" është shuma e të gjitha paketave të hedhura nga ky planifikues. Pas rritjes së gjatësi së radhës deri në 1 mijë dhe rinisjes së kontejnerëve, problemi nuk u shfaq më. Mund të kthehesh në karrige dhe të pijë një smoothie.
FragmentSmack/SegmentSmack. Gjakët e fundit.
Së pari, pas disa muajsh nga njoftimi i dobësive në bërthamë, më në fund u shfaq një rregullim për FragmentSmack (të kujtojmë se bashkë me njoftimin në gusht doli vetëm një rregullim për SegmentSmack), e cila na dha një mundësi për t'u hequr nga Workaround, që na ka dhënë shumë shqetësime. Disa nga serverët e tanishëm i kemi kaluar në bërthamën e re dhe tani duhet të fillojmë nga e para. Pse e përmirësuam bërthamën pa pritur rregullimin për FragmentSmack? Arsyeja është se procesi i mbrojtjes nga këto dobësi përputhej (dhe u bashkua) me procesin e përditësimit të CentOS-it (cili zë shumë më shumë kohë se përditësimi vetëm i bërthamës). Për më tepër, SegmentSmack është më i rrezikshëm, dhe rregullimi për të u shfaq menjëherë, kështu që kishte arsye për veprim në çdo rast. Megjithatë, nuk mundëm thjesht të përmirësojmë bërthamën në CentOS sepse dobësia FragmentSmack, e cila u shfaq gjatë CentOS 7.5, u rregullua vetëm në versionin 7.6, prandaj na duhej të ndalonim përditësimin në 7.5 dhe të fillonim gjithçka nga e para me përditësimin në 7.6. Edhe kjo ndodh.
Së dyti, na janë kthyer disa ankesa të rralla nga përdoruesit për probleme. Tani e dimë me siguri se të gjitha janë të lidhura me ngarkimin e skedarëve nga klientët në disa nga serverët tanë. Ndërkohë, përmes këtyre serverëve kalonte një numër shumë të vogël ngarkimesh nga masa totale.
Siç e mbajmë mend nga përshkrimi më sipër, rikthimi i Sysctl-it nuk ndihmoi. Ndihmoi Rinisi, por përkohësisht.
Dyshimet mbi Sysctl-in nuk u hoqën, por kësaj here ishte e nevojshme të mblidheshin sa më shumë informata. Gjithashtu, na mungonte jashtëzakonisht mundësia për të riprodhuar problemin me ngarkimin te klienti, për të studiuar më saktë se çfarë po ndodhte.
Analiza e gjithë statistikave dhe logjeve të disponibile nuk na afroi me një kuptim të situatës. Mungonte ndjeshëm mundësia për të riprodhuar problemin, për të "prekur" një lidhje specifike. Së fundi, zhvilluesit në versionin special të aplikacionit arritën të sigurojnë një riprodhim të qëndrueshëm të problemeve në pajisjen e testimit kur ishin të lidhur përmes Wi-Fi. Kjo ishte një përparësi në hetim. Klienti u lidh me Nginx, i cili e riprosesoronte në backend, që ishte aplikacioni ynë në Java.
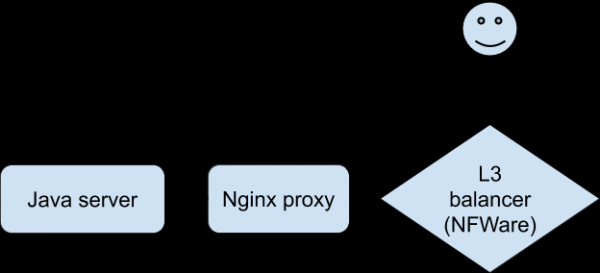
Dialogu në rast probleme ishte njëlloj (i regjistruar nga Nginx-proksi):
- Klienti: kërkesë për informacion mbi vazhdimin e skedarit.
- Java-server: përgjigje.
- Klienti: POST me skedarin.
- Java-server: gabim.
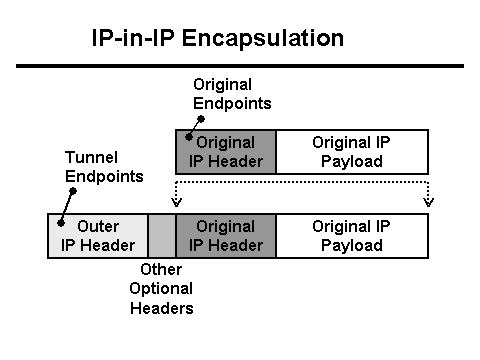
Java-server, nga ana tjetër, shkruan në log që ka marrë 0 byte të dhënash nga klienti, ndërsa Nginx-proksi thotë se kërkesa zgjati më shumë se 30 sekonda (30 sekonda është koha e skadimit në aplikacionin e klientit). Pse ndodhi skadimi dhe pse 0 byte? Nga pikëpamja e HTTP-së, gjithçka funksionon siç duhet, por POST me skedarin duket se humbet në rrjet. Dhe humbet ndërmjet klientit dhe Nginx. Është koha të armatosemi me Tcpdump! Por përpara se gjithçka, duhet të kuptojmë konfigurimin e rrjetit. Nginx-proksi ndodhet pas një balancuesi L3 . Përdoret tunelizimi për dërgimin e paketave nga balancuesi L3 në server, e cila shton headerat e saj në paketa:
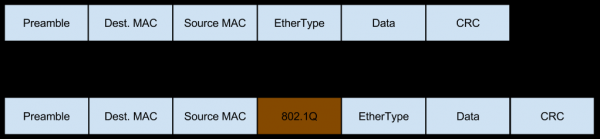
Njëkohësisht, rrjeti në këtë server vjen në formën e trafikut të tag-uar Vlan, e cila gjithashtu shton fushat e saj në paketa:
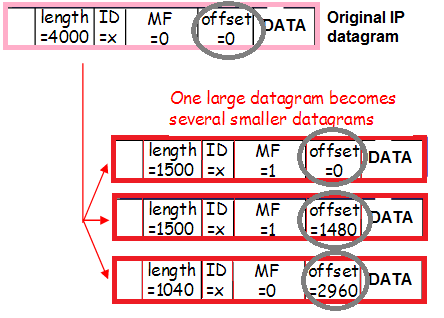
Dhe po ashtu, ky trafik mund të fragmentizohet (ai përqindje e vogël e trafikut të fragmentizuar që kemi përmendur në vlerësimin e rreziqeve nga Workaround), që gjithashtu e ndryshon përmbajtjen e headerave:
Këtu, paketat janë të inkapsuluara me tag-un e Vlan, janë të inkapsuluara me tunelin, janë të fragmentizuara. Për të kuptuar më saktë se si ndodh këtë, do të ndjekim rrugën e paketës nga klienti deri te Nginx-proksi.
- Paketa arrin te balancuesi L3. Për të siguruar një rrugëzim të saktë brenda qendrës të të dhënave, paketa inkapsulohet në një tunel dhe dërgohet në kartën rrjetësore.
- Pasi që paketa + headerat e tunelit nuk i përshtaten MTU-së, paketa ndahen në fragmente dhe dërgohen në rrjet.
- Switch-i pas balancuesit L3, kur merr paketën, i shton tag-un e Vlan dhe e dërgon më tej.
- Switchi para Nginx-proksi sheh (sipas konfigurimeve të portit) se serveri pret një paketë të inkapsuluar Vlan, prandaj e dërgon atë ashtu siç është, pa e hequr etiketën Vlan.
- Linux merr fragmente të paketave të veçanta dhe i bashkon ato në një paketë të madhe.
- Pastaj paketa arrin në ndërfaqen Vlan, ku hiqet shtresa e parë — inkapsulimi Vlan.
- Më pas, Linux e dërgon atë në ndërfaqen Tunnel, ku hiqet edhe një shtresë — inkapsulimi Tunnel.
Sfidimi është ta kalosh të gjitha këto si parametra në tcpdump.
Le të fillojmë nga fundi: a ka paketat e pastra (pa tituj të panevojshëm) IP nga klientët, me inkapsulim të hequr vlan dhe tunnel?
tcpdump host
Jo, nuk kishte paketa të tilla në server. Pra, problemi duhet të jetë më herët. A ka paketa me inkapsulim të hequr vetëm Vlan?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx — kjo është adresa IP e klientit në formatin hex.
32:4 — adresa dhe gjatësia e fushës ku është regjistruar IP SCR në paketën Tunnel.
Adresa e fushës duhej të merren përmes provave, pasi në internet shkruhen për 40, 44, 50, 54, por atje nuk kishte adresa IP. Gjithashtu, mund të shihni një nga paketat në hex (parametri -xx ose -XX në tcpdump) dhe të llogaritni se në cilën adresë është IP e njohur.
A ka fragmente paketash pa hequr inkapsulimin Vlan dhe Tunnel?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Kjo magji do të na tregojë të gjitha fragmentet, duke përfshirë të fundit. Sigurisht, gjithashtu mund të filtrohet sipas IP, por unë nuk kam provuar, pasi nuk ka shumë paketa të tilla, dhe në fluksin e përgjithshëm u gjetën lehtësisht ato që më duheshin. Ja ato:
14:02:58.471063 Në 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), gjatësi 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), gjatësi 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 byte të munguar! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), gjatësi 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], gjatësi 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 nëse..MM.*........
14:02:58.471103 Në 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), gjatësi 62: (tos 0x0, ttl 63, id 53652, offset 1480, flamuj [asnjë], proto IPIP (4), gjatësi 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Këto janë dy fragmente të një pakete (ID i njëjtë 53652) me fotografi (duket fjala Exif në paketën e parë). Për shkak se në këtë nivel paketat janë, dhe në formën e bashkuar në dump nuk ka, problemi është qartë me montimin. Në fund, ka një dokumentim për këtë!
Dekoderi i paketave nuk zbuloi asnjë problem që pengon montimin. Kam provuar këtu: . Në fillim, kur u përpoqëm të dërgojmë diçka atje, dekoduesi nuk e pëlqente formatin e paketës. Doli se kishte dy oktete shtesë mes Srcmac dhe Ethertype (të papërfshira në informacionin mbi fraksionet). Pas heqjes së tyre, dekoduesi filloi të funksiononte. Megjithatë, nuk tregoi asnjë problem.
Sikur të mos ishte kështu, nuk gjeta asgjë përveç atyre Sysctl. Duhej të gjeja një mënyrë për të identifikuar serverët e problematik, për të kuptuar shkallën dhe për të marrë një vendim për veprimet e dukshme. Mjaft shpejt u gjet numri i duhur:
netstat -s | grep "packet reassembles failed”
Ai është gjithashtu në snmpd nën OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
„Numri i dështimeve të konstatuara nga algoritmi i rishikimit të IP (për çfarëdo arsye: skadimi, gabime, etj.)”.
Në mes të grupit të serverëve, ku problemi u studiuar, në dy ky numër u rrit më shpejt, në dy të tjerë u rrit ngadalë, ndërsa në dy të tjerë nuk u rrit fare. Krahasimi i dinamikës së këtij numri me dinamikën e gabimeve HTTP në serverin Java zbuloi një korelacion. Pra, numri mund të ishte vendosur për monitorim.
Prania e një treguesi të besueshëm të problemeve është shumë e rëndësishme, për të qenë në gjendje të përcaktojmë saktësisht nëse rikthimi i Sysctl ndihmon, pasi nga tregimi i mëparshëm e dimë që nuk mund ta kuptojmë menjëherë nga aplikacioni. Ky tregues do të lejonte identifikimin e të gjitha pikave problematike në prodhim përpara se ta zbulojnë përdoruesit.
Pas rikthimit të Sysctl, gabimet nga monitorimi u ndalën, kështu që arsyeja e problemeve u provua, ashtu si dhe se rikthimi ndihmon.
Ne rikthyem cilësimet e fraksionimit në serverët e tjerë, ku u ndez një monitorim i ri, dhe diku për fragmente u ndan edhe më shumë memorie se sa ishte më parë si standard (kjo ishte statistika e udp, humbja e pjesore e të cilës nuk ishte e dukshme në kontekstin e përgjithshëm).
Pyetjet më të rëndësishme
Pse paketat fraksionohen në balancuesin tonë L3? Shumica e paketave që vijnë nga përdoruesit në balancuesit janë SYN dhe ACK. Madhësitë e këtyre paketave janë të vogla. Por, pasi pjesa e tillë e paketave është shumë e madhe, ne nuk e vërejmë praninë e paketave më të mëdha që filluan të fraksionohen.
Arsyeja ishte një skenar konfigurimi që u prish në serverat me ndërfaqe Vlan (atëherë në prodhim kishte shumë pak servera me trafik etiketuar). Advmss lejon që të përcjellim informacion te klienti se paketat që vijnë nga ana jonë duhet të jenë më të vogla, në mënyrë që pas ngjitjes së titujve të tunelit, ato të mos duhet të fragmentohen.
Pse rikthimi i Sysctl nuk ndihmoi, ndërsa rinisja ndihmoi? Rikthimi i Sysctl ndryshonte sasinë e memories në dispozicion për bashkimin e paketimeve. Në të njëjtën kohë, duket se vetë fakti i mbushjes së memories për fragmentet shkaktonte ngadalësim të lidhjeve, që çonte në një vonesë të gjatë të fragmenteve në radhë. Kështu që, procesi ishte i bllokuar.
Rinisja e fshinte memorien dhe gjithçka kthehej në rregull.
A mund të kishte qenë pa Workaround? Po, por rreziku ishte i madh për të lënë përdoruesit pa shërbim në rast sulmi. Sigurisht, aplikimi i Workaround përfundimisht shkaktoi probleme të ndryshme, duke përfshirë ngadalësimin e një nga shërbimet për përdoruesit, por gjithsesi ne besojmë se veprimet ishin të justifikuara.
Faleminderit shumë Andrey Timofeyev () për ndihmën në zhvillimin e hetimit, si dhe Alexey Krenyev () — për punën titanike mbi përditësimin e Centos dhe kernelit në servera. Procesi, i cili në këtë rast u desh të fillohej disa herë nga e para, për shkak të cilit zgjati për shumë muaj.
Burimi: habr.com
