

Berkeley Packet Filters (BPF) është një teknologji e bërthamës Linux, që është në qendër të vëmendjes në botimet teknike anglishtfolëse tashmë disa vite. Konferencat janë të mbushura me prezantime mbi përdorimin dhe zhvillimin e BPF. David Miller, mirëmbajtësi i nënsystemit rrjetë të Linux, e quan prezantimin e tij në Linux Plumbers 2018 (XDP – është një nga variantet e përdorimit të BPF). Brendan Gregg mban prezantime me titullin . Toke Høiland-Jørgensen , që bërthama tani është microkernel. Thomas Graf promovon idenë se .
Në Habrë ende nuk ka një përshkrim sistematik të BPF, dhe prandaj në këtë seri artikujsh do të përpiqem të tregoj historinë e teknologjisë, të përshkruaj arkitekturën dhe mjetet e zhvillimit, të përshkruaj fushat e aplikimit dhe praktikat e përdorimit të BPF. Në këtë, artikullin e parë të ciklit, tregohet historia dhe arkitektura e BPF klasik, si dhe zbërthehen sekreti i principeve të funksionimit tcpdump, seccomp, strace, dhe shumë të tjera.
Zhvillimi i BPF kontrollohet nga komuniteti rrjetë të Linux, aplikimet kryesore ekzistuese të BPF lidhen me rrjetet dhe prandaj, me lejen e , e quajta serinë "BPF për të vegjlit", në nder të serisë së madhe .
Një kurs i shkurtër mbi historinë e BPF (c)
Teknologjia moderne BPF është një version i përmirësuar dhe i zgjeruar i teknologjisë së vjetër me të njëjtin emër, tani e quajtur, për të evituar konfuzionin, BPF klasike. Në bazë të BPF klasike është krijuar utiliteti i njohur tcpdump, mekanizmi seccomp, si dhe moduli më pak i njohur xt_bpf për iptables dhe klasifikuesi cls_bpf. Në Linuxin modern, programet klasike BPF automatikisht përkthehen në një formë të re, megjithatë, nga këndvështrimi i përdoruesit, API ka mbetur në vend, dhe aplikimet e reja të BPF klasike, si do të shohim në këtë artikull, ende ekzistojnë. Për këtë arsye, si dhe për shkak se duke ndjekur historinë e zhvillimit të BPF klasike në Linux, do të bëhet e qartë si dhe pse ajo ka evoluar në formën moderne, vendosa të filloj me artikullin mbi BPF klasike.
Në fund të viteve '80 të shekullit të kaluar, inxhinierët nga laboratorët e njohur Lawrence Berkeley u interesuan për problemin se si të filtronin në mënyrë korrekte paketat e rrjetit në harduerin modern të asaj kohe. Ideja themelore e filtrimit, e implementuar fillimisht në teknologjinë CSPF (Filtri i Paketimeve CMU/Stanford), ishte që të filtronin paketat e tepërta sa më herët, domethënë në hapësirën e bërthamës, pasi kjo lejonte që të mos kopjohej informacion i tepërt në hapësirën e përdoruesit. Për të siguruar sigurinë e kohës së ekzekutimit për ekzekutimin e kodit të përdoruesit në hapësirën e bërthamës, u përdor një makinë virtuale – një sandbox.
Megjithatë, makinat virtuale për filtrat ekzistues ishin projektuar për t'u ekzekutuar në makina me arkitekturë stack dhe nuk punonin aq efikasisht në makinat e reja RISC. Si rezultat i përpjekjeve të inxhinierëve nga Berkeley Labs, u zhvillua një teknologji e re BPF (Filtrat e Paketimeve Berkeley), arkitektura e makinës virtuale të së cilës ishte projektuar mbi bazën e procesorit Motorola 6502 – një punëtor i njohur për produkte të tilla si ose . Makinë e re virtuale rriti performancën e filtrave disa herë në krahasim me zgjidhjet ekzistuese.
Arkitektura e makinës BPF
Ne do të njihemi me arkitekturën në punë, duke shqyrtuar shembuj. Megjithatë, përpara se të fillojmë, le të themi se makina kishte dy regjistra 32-bitë të disponueshëm për përdoruesin, një akumulator A dhe një regji indeksimi X, 64 byte memorje (16 fjalë), të disponueshme për shkrim dhe lexim të mëvonshëm, dhe një sistem të vogël komandash për të punuar me këto objekte. Në programet ishin të disponueshme gjithashtu instrukcionet e kalimit për implementimin e shprehjeve kushtetuese, megjithatë për të garantuar përfundimin e përshtatshëm të punës së programit, mund të kalonim vetëm përpara, dmth., në veçanti, ndalohej krijimi i cikleve.
Skema e përgjithshme e ekzekutimit të makinës është si vijon. Përdoruesi krijon një program për arkitekturën BPF dhe, me anë të ndonjë mekanizmi të bërthamës (p.sh., thirrje sistemesh), ngarkon dhe lidh programin me ndonjë gjenerator ngjarjesh në bërthamë (p.sh., një ngjarje – është ardhja e një pakete në kartën e rrjetit). Kur ndodh një ngjarje, bërthama ekzekuton programin (p.sh., në një interpretues), në këtë rast, memorja e makinës përputhet. ndonjë regjioni i memories së bërthamës (p.sh., të dhënat e paketës së ardhur).
E thënë më sipër, kjo do të mjaftojë për të filluar me analizimin e shembujve: do të njihemi me sistemin dhe formatin e komandave sipas nevojës. Nëse dëshironi të studioni menjëherë sistemin e komandave të makinës virtuale dhe të mësoni për të gjitha mundësitë e saj, mund të lexoni artikullin origjinal. dhe/o pjesën e parë të skedarit nga dokumentacioni i bërthamës. Për më tepër, mund të shqyrtoni prezentimin , në të cilin McCanne, një nga autorët e BPF, diskuton për historinë e krijimit të tij. libpcap.
Ne kalojmë në shqyrtimin e të gjitha shembujve të rëndësishëm të përdorimit të BPF klasik në Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Zhvillimi i BPF është realizuar paralelisht me zhvillimin e front-end-it për filtrimin e paketave — mjeti i njohur tcpdump. Dhe, pasi kjo është shembulli më i vjetër dhe më i njohur i përdorimit të BPF klasik, që është i disponueshëm në shumë sisteme operative, do ta fillojmë studimin e teknologjisë prej tij.
(Të gjithë shembujt në këtë artikull i kam ekzekutuar në Linux 5.6.0-rc6. Daljet e disa komandave janë redaktuar për lehtësinë e lexueshmërisë.)
Shembull: vëzhgojmë paketat IPv6
Supozoni se dëshirojmë të shohim të gjitha paketat IPv6 në ndërfaqen eth0. Për këtë, mund të ekzekutojmë programin tcpdump me një filtër të thjeshtë ip6:
$ sudo tcpdump -i eth0 ip6Dhe tcpdump kompiloi filtrin ip6 në kodin e arkitekturës BPF dhe do ta dërgojë në bërthamë (shihni detajet në seksionin ). Filtri i ngarkuar do të ekzekutohet për çdo paketë që kalon përmes ndërfaqes eth0. Nëse filtri kthen një vlerë të jo zero n, atëherë deri n bytet e paketës do të kopjohen në hapësirën e përdoruesit dhe ne do ta shohim atë në dalje tcpdump.
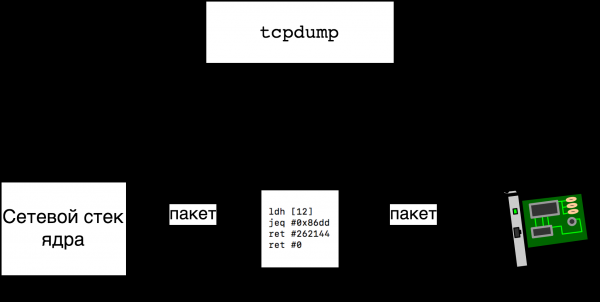
Duket se mund të zbulojmë lehtësisht se cila është saktësisht kodi i bytit që dërguam në bërthamë tcpdump me anë të vetë tcpdump, nëse e ekzekutojmë atë me opsionin -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Në rreshtin zero, ne ekzekutojmë komandën ldh [12], që dekodohet si "ngarko në regjistrin A pjesën e fjalës (16 bit), që ndodhet në adresën 12" dhe pyetja e vetme është — çfarë lloj memorjeje po adresojmë? Përgjigjja është se në adresën x fillon (x+1)-i byt i paketës së rrjetit në analizë. Ne lexojmë paketat nga ndërfaqja Ethernet eth0, dhe kjo është , kështu që paketa duket si më poshtë (për thjeshtësi ne supozojmë se paketa nuk ka etiketat VLAN):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
Pas njenes së ekzekutimit të komandës ldh [12] në regjistër A do të shfaqet fusha Ether Type — tipi i paketës që dërgohet në këtë Ethernet frame. Në rreshtin 1, ne krahasojmë përmbajtjen e regjistrit A (tipi i paketës) me 0x86dd, dhe kjo është tipi që na intereson, IPv6. Në rreshtin 1 përveç komandës së krahasimit ka edhe dy kolona — jt 2 dhe jf 3 — etiketat të cilat duhet të kalojmë në rastin e krahasimit të suksesshëm (A == 0x86dd) dhe të pasuksesshëm. Pra, në rastin e suksesshëm (IPv6), kalojmë në rreshtin 2, ndërsa në atë të pasuksesshëm — në rreshtin 3. Në rreshtin 3 programi përfundohet me kodin 0 (mos kopjo paketën), ndërsa në rreshtin 2 programi përfundohet me kodin 262144 (kopjo më së shumti 256 kilobajt të paketës).
Një shembull më të komplikuar: shikojmë paketat TCP mbi portin e destinacionit
Le të shohim si duket filtrimi që kopjon të gjitha paketat TCP me portin e destinacionit 666. Ne do të shqyrtojmë rastin IPv4, sepse rasti IPv6 është më i thjeshtë. Pas studimit të këtij shembulli, mund të shqyrtoni si ushtrim filtrin për IPv6 (ip6 and tcp dst port 666) dhe filtrin për rastin e përgjithshëm (tcp dst port 666). Pra, filtri që na intereson duket kështu:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Çfarë bëjnë rreshtat 0 dhe 1, ne tashmë e dimë. Në rreshtin 2, ne tashmë kemi kontrolluar se është një paketë IPv4 (Ether Type = 0x800) dhe ngarkohet në regjistër A byte-i 24 i paketës. Paketa jonë duket si
       14            8      1     1
|ethernet header|ip fields|ttl|protocol|...
dhe kështu ngarkohet në regjistër A fusha Protocol e titullit IP, që është e logjikshme, pasi duam të kopjojmë vetëm paketat TCP. Ne krahasojmë Protocol me 0x6 () në rreshtin 3.
Në rreshtat 4 dhe 5, ne ngarkojmë një fjalë të plotë që ndodhet në adresën 20, dhe me ndihmën e komandës jset kontrollojmë nëse ndonjëri nga tre — në maskën e dhënë jset janë pastruar tre bitët më të lartë. Dy bitë nga tre na tregojnë nëse paketa është pjesë e një pakete IP të fragmentuar, dhe nëse po, nëse është fragmenti përfundimtar. Bitin e tretë e kemi rezervuar dhe duhet të jetë zero. Ne nuk duam të kontrollojmë as paketat jo të plota as të dëmtuara, prandaj kontrollojmë të tre bitët.
Rreshti 6 — është më interesant në këtë listim. Shprehja ldxb 4*([14]&0xf) do të thotë se ngarkohemi në regjistër X katër bitët më të vogla të bajtit të pestëmbëdhjetë të paketës, të shumzuara me 4. Katër bitët më të vogla të bajtit të pestëmbëdhjetë janë një fushë e başit IPv4, ku ruhet gjatësia e krye në fjalë, prandaj duhet shumëzuar me 4. Është interesante se shprehja 4*([14]&0xf) është një shenjë e skemës speciale të adresimit, e cila mund të përdoret vetëm në këtë formë dhe vetëm për regjistrin X, dmth. ne nuk mund të themi as ldb 4*([14]&0xf) as ldxb 5*([14]&0xf) (ne mund të citojmë vetëm një offset tjetër, p.sh. ldxb 4*([16]&0xf)). Është evidente se kjo skemë adresimi u shtua në BPF pikërisht për të marrë në X (regjistri indeks) gjatësinë e krye të IPv4.
Në këtë mënyrë, në rreshtin 7 ne përpiqemi të ngarkojmë gjysmën e një fjale, në adresën (X+16). Duke u kujtuar se 14 bajtë zënë krye Ethernet, dhe X përmban gjatësinë e krye të IPv4, ne e kuptojmë se në A ngarkohet porta e destinacionit TCP:
       14           X           2             2
|krye ethernet|krye ip|porta e burimit|porta e destinacionit|
Më në fund, në rreshtin 8, ne krahasojmë portën e destinacionit me vlerën e kërkuar dhe në rreshtat 9 ose 10 kthejmë rezultatin - të kopjojmë paketën ose jo.
Tcpdump: ngarkimi
Në shembujt e mëparshëm, ne qëllimisht nuk u ndalëm në mënyrën se si ngarkojmë BPF bajtkodin në bërthamë për filtrimin e paketimeve. Në përgjithësi, tcpdump është portuar në shumë sisteme dhe për punën me filtrat përdor bibliotekën . Në përmbledhje, për të vendosur filtrin në interfisin përmes libpcap, duhet të bësh si në vijim:
- të krijosh një deskriptues të tipit
pcap_tnga emri i interfisit: , - të aktivizosh interfisin: ,
- të kompilosh filtrin: ,
- të lidhësh filtrin: .
Për të parë se si është zbatuar funksioni pcap_setfilter në Linux, ne përdorim strace (disa rreshta u hoqën):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Në dy rreshtat e parë të daljes ne krijojmë për të lexuar të gjithë framet Ethernet dhe e lidhnim atë me interfisin eth0. Nga ne e dimë se filtri ip do të përbëhet nga katër instruktime BPF, dhe në rreshtin e tretë shohim se si me opcionin thirrjes së sistemit setsockopt ne ngarkohet dhe lidhen filtrin e gjatë 4. Ky është filtri ynë.
Është e rëndësishme të theksohet se në BPF-in klasik, ngarkimi dhe lidhja e filtrit ndodhin gjithmonë si një operacion atomik, ndërsa në versionin e ri të BPF, ngarkimi i programit dhe lidhja e tij me gjeneratorin e ngjarjeve janë të ndara në kohë.
E vërteta e fshehur
Një versioni disi më i plotë i daljes duket kështu:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Burimi përkohësisht i paavailable)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Siç u tha më parë, ne ngarkojmë dhe lidhim filtrin tonë me soketin në rreshtin 5, por çfarë ndodh në rreshtat 3 dhe 4? Duket se kjo libpcap e menaxhon për ne — për të siguruar që paketa që nuk i përmbush kriteret, të mos kalojnë në daljen tonë, biblioteka një filtrin fals ret #0 (të heqë të gjitha paketat), e çon soketin në modalitetin jo-bllokues dhe përpiqet të lexojë të gjitha paketat që mund të mbeteshin nga filtrat e kaluar.
Pra, për të filtruar paketat në Linux duke përdorur BPF-in klasik, është e nevojshme të keni një filtrin në formën e një strukture të tipit struct sock_fprog dhe një soket të hapur, pas së cilës filtri mund të lidhet me soketin përmes thirrjes sistemike setsockopt.
Është interesante se filtri mund të lidhet me çdo soket, jo vetëm me atë raw. Ja programet, që të gjitha, përveç dy bajtëve të parë të të gjitha datagrameve UDP të ardhshme. (Komentet i kam shtuar në kod, për të mos e mbingarkuar artikullin).
Detaje më shumë rreth përdorimit setsockopt për lidhjen e filtrave shiko në , dhe për të shkruar filtrat tuaj të tipit struct sock_fprog pa ndihmën tcpdump do të bisedojmë në seksionin .
BPF-i klasik dhe shekulli XXI
BPF u përfshi në Linux në vitin 1997 dhe për një kohë të gjatë mbeti një kalë punë libpcap pa ndryshime të mëdha (ndryshime specifike për Linux, sigurisht, , por ato nuk ndryshuan pamjen globale). Shenjat e para serioze se BPF do të evoluonte u shfaqën në vitin 2011, kur Eric Dumazet sugjeroi , duke shtuar një Kompilator Just In Time në bërthamë — një përkthyes për të përkthyer bytecode BPF në x86_64 kode të natyrshëm.
Kompilatori JIT ishte i pari në zinxhirin e ndryshimeve: në vitin 2012 mundësia për të shkruar filtrat për , duke përdorur BPF, në janar 2013 ishte moduli xt_bpf, i lejon të shkruhen rregullat për iptables nëpërmjet BPF, dhe në tetor 2013 ishte edhe një moduli cls_bpf, që lejon shkrimin e klasifikuesve të trafikut me ndihmën e BPF.
Shpejt do t'i shqyrtojmë të gjitha këto shembuj më në detaje, por së pari do të jetë e dobishme të mësojmë si të shkruajmë dhe kompelojmë programe të rastësishme për BPF, pasi mundësitë që ofron biblioteka libpcap janë të kufizuara (një shembull i thjeshtë: një filtrues i gjeneruar libpcap mund të kthejë vetëm dy vlera — 0 ose 0x40000) ose në të vërtetë, si në rastin e seccomp, është e papërshtatshme.
Programimi i BPF me duar tona
Të njohim formatin binar tëInstruksioneve BPF, ai është shumë i thjeshtë:
   16    8    8     32
| kod | jt | jf |  k  |
Çdo instruksion zë 64 bita, ku 16 bita të parë janë kod komande, pasuar nga dy zhvendosje me tetë bita, jt dhe jf, dhe 32 bita për argumentin K, destinacioni i të cilit ndryshon nga komanda në komandë. Për shembull, komanda kthehu, që përfundon ekzekutimin e programit ka kod 6, dhe vlera e kthyer merret nga konstantja K. Në gjuhën C një instruksion BPF paraqitet si një strukturë
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
dhe një program i tërë — si një strukturë
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Kështu, ne tashmë mund të shkruajmë programe (kodet e instruksioneve ne, supozojmë, i dimë nga ). Kështu do të duket filtruesi ip6 nga :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
Programi prog ne mund të përdorim ligjërisht në thirrjen
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Të shkruash programe në formën e kodit të makinës nuk është shumë e rehatshme, por ndonjëherë duhet (për shembull, për debuggimin, për krijimin e testeve njësi, për shkruarjen e artikujve në Habr dhe të tjera). Për lehtësim në skedarin <linux/filter.h> definohen makroshtëpënjese — të njëjtin shembull, si më sipër, mund ta shkruajmë si
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Megjithatë, edhe ky variant nuk është shumë i lehtë. Kështu arsyetuan edhe programuesit e bërthamës Linux dhe prandaj në direktorinë të bërthamës mund të gjeni assembler dhe debugger për punë me BPF klasik.
Gjuha assembler është shumë e ngjashme me rezultatin e debuggimit tcpdump, por përveç kësaj mund të tregojmë etiketat simbolike. Për shembull, këtu është një program që hedh të gjithë paketat, përveç TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Sipas parazgjedhjes, assembleri gjeneron kod në formatin , ,..., për shembullin tonë me TCP do të rezultojë
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Për lehtësinë e programuesve C, mund të përdoret një format tjetër i daljes:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Ky tekst mund të kopjohet në përkufizimin e strukturës së tipit struct sock_filter, ashtu siç e bëmë në fillim të këtij kapitulli.
Zgjerimet Linux dhe netsniff-ng
Përveç instruksioneve standarde BPF, Linux dhe tools/bpf/bpf_asm mbështesin gjithashtu . Kryesisht, instruksionet shërbejnë për qasje në fushat e strukturës struct sk_buff, e cila përshkruan një paketë rrjeti në bërthamë. Megjithatë, ka gjithashtu instruksione ndihmëse të një lloji tjetër, për shembull ldw cpu do të ngarkojë në regjistrin A rezultatin e thirrjes së funksionit të bërthamës raw_smp_processor_id().(Në versionin e ri të BPF, këto zgjerime jo standarde u zgjeruan në formën e ofrimit të grupeve të ndihmësve të kernelit për qasje në memorie, struktura dhe për gjenerimin e ngjarjeve.) Ja një shembull interesant i filtrit, në të cilin kopjojmë në hapësirën e përdoruesit vetëm headerat e pakove, duke përdorur zgjerimin poff, offset-i i ngarkesës:
ld poff
ret a
Zgjerimet BPF nuk do të mund të përdoren në tcpdump, por ky është një arsyetim i mirë për t'u njohur me paketën e mjeteve , i cili, përveç të gjithave, përmban një program të avancuar netsniff-ng, i cili, përveç filtrimit duke përdorur BPF, përmban gjithashtu një gjenerator të trafikut efikas dhe një asamble BPF më të avancuar të quajtur tools/bpf/bpf_asmbpfc. Paketa përmban një dokumentacion bastante të detajuar, shih gjithashtu lidhjet në fund të artikullit.Pra, tashmë dimë të shkruajmë programe BPF të kompleksiteteve të ndryshme dhe jemi gati të shohim shembuj të rinj, i pari prej të cilëve është teknologjia seccomp, e cila lejon me anë të filtrave BPF të menaxhojmë shumë dhe grupin e argumenteve të thirrjeve të sistemit, të disponueshme për këtë proces dhe pasardhësit e tij.
seccomp
Versioni i parë i seccomp u shtua në bërthamë në vitin 2005 dhe nuk gëzoi shumë popullaritet, pasi ofronte vetëm mundësinë e vetme — kufizimin e grupit të thirrjeve të sistemit të disponueshme për procesin, në vijim:
sigreturn read, write, exit dhe , dhe procesi, që shkelte rregullat, do të vritej me anë të, dhe procesi, që shkelte rregullat u shkatërrua me SIGKILL. Megjithatë, në vitin 2012, seccomp mori mundësinë për të përdorur filtre BPF, që lejojnë përcaktimin e shumë thirrjeve të lejuara të sistemit dhe madje kryerjen e kontrolleve mbi argumentet e tyre. (Është interesante se një nga përdoruesit e parë të kësaj funksionaliteti ishte Chrome, dhe aktualisht, njerëzit nga Chrome po zhvillojnë mekanizmin KRSI, i bazuar në një version të ri të BPF që lejon personalizimin e Moduleve të Sigurisë së Linuxit.) Lidhje për dokumentacionin shtesë mund të gjenden në fund të artikullit.
Vlen të theksohet se në Habrë tashmë ka pasur artikuj mbi përdorimin e seccomp, ndoshta dikush do të dëshirojë t'i lexojë ato para (ose në vend të) leximit të nënseksioneve të ardhshme. Në artikullin janë dhënë shembuj të përdorimit të seccomp, si versioni i vitit 2007, ashtu si dhe versioni që përdor BPF (filtrat gjenerohen me ndihmën e libseccomp), diskutohet lidhja e seccomp me Docker, si dhe janë dhënë shumë lidhje të dobishme. Në artikullin diskutohet, përveç kësaj, se si të shtoni lista të zeza ose të bardha të thirrjeve të sistemit për demonët nën menaxhimin e systemd.
Më pas do të shohim si të shkruajmë dhe ngarkojmë filtrat për seccomp në C të pastruar dhe me ndihmën e bibliotekës libseccomp dhe cilat janë avantazhet dhe disavantazhet e çdo varianti, dhe përfundimisht do të shikojmë si përdoret seccomp nga programi strace.
Shkruajmë dhe ngarkojmë filtrat për seccomp
Ne tashmë dimë si të shkruajmë programe BPF dhe kështu që do të shohim fillimisht ndërfaqen programore të seccomp. Filtri mund të vendoset në nivelin e procesit, ku të gjitha proceset fëmijë do të trashëgojnë kufizimet. Kjo bëhet përmes thirrjes së sistemit :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)ku &filter — është një tregues në strukturën që tashmë e njohim struct sock_fprog, dmth. programi BPF.
Çfarë ndryshon midis programeve për seccomp dhe atyre për soketet? Konteksti i transmetuar. Në rastin e soketeve, na u dha një zonë memorjeje që përmbante një paketë, ndërsa në rastin e seccomp, na jepet një strukturë e tipit
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Këtu nr — është numri i thirrjes së sistemit që po ekzekutohet, arch — arkitektura aktuale (për këtë më poshtë), args — deri në gjashtë argumente të thirrjes së sistemit, dhe instruction_pointer — është një tregues i një udhëzimi në hapësirën e përdoruesit që bëri këtë thirrje të sistemit. Pra, për shembull, për të ngarkuar numrin e thirrjes së sistemit në regjistër A duhet të themi
ldw [0]Për programet seccomp ekzistojnë dhe veçori të tjera, për shembull, akses në kontekstin është e mundur vetëm për mbushjen 32-bit dhe nuk lejohet ngarkimi i gjysmë fjali apo bajt - në përpjekje për të ngarkuar filtrin ldh [0] thirrje sistemike seccomp will return EINVAL. Kontrollin e filtrave të ngarkuara e kryen funksioni i bërjes. (Nga të qeshurat, në commit-in origjinal që shtoi funksionalitetin seccomp, u harrua të shtohej miratimi për përdorimin e udhëzimit mod (mbetja nga ndarja) dhe tani ajo nuk është e disponueshme për programet seccomp BPF, pasi shtimi i saj ABI.)
Në parim, ne tashmë e dimë gjithçka për të shkruar dhe lexuar programet seccomp. Zakonisht logjika e programit është e organizuar si një listë të bardhë ose të zezë të thirrjeve të sistemit, për shembull programi
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
kontrollon listën e zezë të katër thirrjeve të sistemit me numra 304, 176, 239, 279. Cila është kjo thirrje e sistemit? Ne nuk mund të themi saktësisht, pasi nuk dimë për cilën arkitekturë është shkruar programi. Prandaj autorët e seccomp duhet të fillojnë të gjitha programet me kontrollin e arkitekturës (arkitektura aktuale është e specifikuar në kontekst si një fushë arch struktura struct seccomp_data). Me kontrollin e arkitekturës, fillimi i shembullit do të dukej si:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
dhe atëherë numrat tanë të thirrjeve të sistemit do të merrnin vlera të caktuara.
Shkruajmë dhe ngarkojmë filtrat për seccomp duke përdorur libseccomp
Shkrimi i filtrave në kodin e makinës ose për assembler BPF lejon që të kemi kontroll të plotë mbi rezultatin, por njëkohësisht ndonjëherë është e preferuar të kemi kod të transportueshëm dhe/ose të lexueshëm. Në këtë na ndihmon biblioteka , e cila ofron një ndërfaqe standarde për të shkruar filtrat e zeza ose të bardha.
Le të shkruajmë, për shembull, një program që ekzekuton një skedë binar sipas zgjedhjes së përdoruesit, duke vendosur, paraprakisht, një listë të zezë të thirrjeve të sistemit nga (programi është i thjeshtuar për lexueshmëri më të madhe, versioni i plotë mund të gjendet ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Fillimisht ne përcaktojmë një array sys_numbers me më shumë se 40 numra thirrjesh të sistemit për të bllokuar. Pastaj, inicializojmë kontekstin ctx dhe i themi bibliotekës që duam të lejojmë (SCMP_ACT_ALLOW) të gjitha thirrjet sistemore ndaj parazgjedhjes (ndërtimi i listave të bardha është më i thjeshtë). Pastaj, një nga një, ne shtojmë të gjitha thirrjet sistemore në listën e zezë. Si reagim ndaj thirrjes sistemore nga lista, ne kërkojmë SCMP_ACT_TRAP, në këtë rast seccomp do të dërgojë një sinjal në procesin SIGSYS me përshkrimin se cila thirrje sistemore ka shkelur rregullat. Në fund, ne ngarkojmë programin në bërthamë përmes seccomp_load, e cila do të kompilohet programin dhe do ta lidhë atë me procesin përmes thirrjes sistemore seccomp(2).
Për të kompaktuar me sukses programin, duhet ta lidhim me bibliotekën libseccomp, për shembull:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Shembulli i një ekzekutimi të suksesshëm:
$ ./seccomp_lib echo ok
ok
Shembulli i një thirrjeje sistemore të bllokuar:
$ sudo ./seccomp_lib mount -t bpf bpf /tmp
Thirrje sistemore e keqe
Përdorni strace, për të mësuar më shumë:
$ sudo strace -e seccomp ./seccomp_lib mount -t bpf bpf /tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ u ndal nga SIGSYS (bërë dump të bërthamës) +++
Thirrje sistemore e keqe
ku mund të mësojmë se programi u mbyll për shkak të përdorimit të thirrjes sistemore të ndaluar mount(2).
Pra, kemi shkruar një filtrues përmes bibliotekës libseccomp, duke përfshirë kodin jo trivial në katër rreshta. Në shembullin më sipër, me një numër të madh thirrjesh sistemore, koha e ekzekutimit mund të zvogëlohet ndjeshëm, pasi verifikimi është thjesht një listë krahasimesh. Për optimizim, kohët e fundit në libseccomp është , që shton mbështetje për atributin e filtrit SCMP_FLTATR_CTL_OPTIMIZE. Nëse e vendosni këtë atribut në 2, atëherë filtri do të kthehet në një program për kërkimin binar.
Nëse dëshironi të shihni si janë filtrat me kërkim binar, atëherë shikoni , që gjeneron këto programe në assembler BPF me një grup numrash thirrjesh sistemore, për shembull:
$ echo 1 3 6 8 13 | ./generate_bin_search_bpf.py
ld [0]
jeq #6, keq
jgt #6, kontrollo8
jeq #1, keq
jeq #3, keq
ret #0x7fff0000
kontrollo8:
jeq #8, keq
jeq #13, keq
ret #0x7fff0000
keq: ret #0
Nuk ka asgjë thelbësisht më të shpejtë për të shkruar, pasi programet BPF nuk mund të bëjnë kalime në atë mënyrë (nuk mund të bëjmë, për shembull, jmp A ose jmp [label+X]) dhe prandaj të gjitha kalimet janë statike.
seccomp dhe strace
Të gjithë e dinë utilitarin strace — një instrument i padiskutueshëm në hetimin e sjelljes së proceseve në Linux. Megjithatë, shumë gjithashtu kanë dëgjuar për në përputhje me këtë vegël. E vërteta është se strace implementuar përmes ptrace(2), dhe në këtë mekanizëm nuk mund të specifikojmë se në cilën sërë thirrjesh sistemore duam të ndalim procesin, pra, për shembull, komandat
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
dhe
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
arrihen në një kohë të ngjashme, edhe pse në rastin e dytë ne duam të ndjekim vetëm një thirrje sistemore.
Opsioni i ri --seccomp-bpf, e cila është shtuar në strace versionin 5.3, lejon të përshpejtohet procesi shumëfish dhe koha e nisjes nën ndjekje të një thirrjeje sistemore tashmë është e krahasueshme me kohën e një nisjeje normale:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Këtu, sigurisht, ka një mashtrim të vogël në faktin se ne po ndjekim jo thirrjen sistemore kryesore të kësaj komande. Sikur të ndjekim, për shembull, newfsstat, nuk është e nevojshme, madje, ajo jep një gabim sintaksor strace do të ngadalësonte po aq shumë sa edhe pa --seccomp-bpf.)
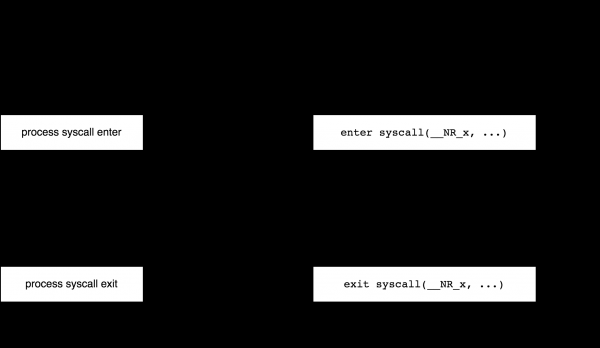
Si funksionon kjo mundësi? Pa të strace lidhet me procesin dhe e nis atë përmes PTRACE_SYSCALL. Kur procesi i menaxhuar nis një (çdo) thirrje sistemore, kontrolli kalon strace, i cili shikon argumentet e thirrjes sistemore dhe e nis atë përmes PTRACE_SYSCALL. Pas një kohe, procesi përfundon thirrjen sistemore dhe kur del nga ajo, kontrolli përsëri kalon strace, i cili shikon vlerat e kthimit dhe nis procesin përmes PTRACE_SYSCALL, etj.
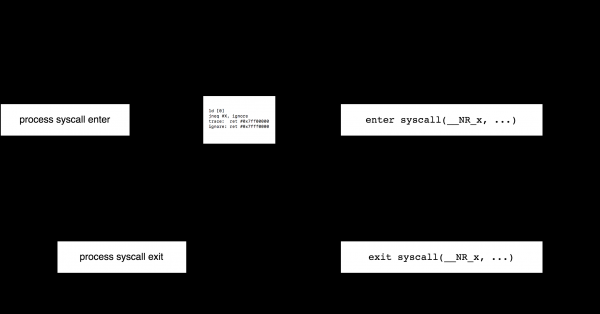
Përmes seccomp, megjithatë, ky proces mund të optimizohet pikërisht siç do të dëshironim. Konkretisht, nëse duam të shohim vetëm thirrjen sistemore X, mund të shkruajmë një filtrin BPF, i cili për X kthen vlerën SECCOMP_RET_TRACE, ndërsa për thirrjet që nuk na interesojnë — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
Në këtë rast strace fillimisht nis procesin si PTRACE_CONT, për çdo thirrje sistemore ekzekutohet filtrin ynë, nëse thirrja sistemore nuk është X, atëherë procesi vazhdon punën, por nëse është X, atëherë seccomp do të kalojë kontrollin strace, i cili do të shikojë argumentet dhe do të nisë procesin si PTRACE_SYSCALL (pasi në seccomp nuk ka mundësi për të nisur një program kur del nga thirrja sistemore). Kur thirrja sistemore të kthehet, strace do ta rinisë procesin përmes PTRACE_CONT dhe do të presë mesazhe të reja nga seccomp.
Nën përdorimin e mundësisë --seccomp-bpf ka ka dy kufizime. Së pari, nuk është e mundur të bashkohesh me një proces ekzistues (opsioni -p për punë me lloje të ndryshme grafikë. Për iOS ka mjaft shumë prej tyre. strace), pasi kjo nuk mbështetet nga seccomp. Së dyti, nuk ka mundësi jo të shikosh proceset fëmijë, pasi filtrat seccomp trashëgohen nga të gjithë proceset fëmijë pa mundësi për t'i çaktivizuar ato.
Pak më shumë hollësi mbi se si saktësisht strace punon me seccomp mund të merret nga . Për ne, fakti më interesant është se klasa e BPF me emrin seccomp vazhdon të ketë përdorim edhe sot.
xt_bpf
Tani le të kthehemi në botën e rrjeteve.
Historiku: shumë kohë më parë, në vitin 2007, në bërthamë u moduli xt_u32 për netfilter. Ai ishte shkruar sipas analogjisë me klasifikuesin e trafikut më të lashtë cls_u32 dhe lejonte të shkruheshin rregulla binare të rastësishme për iptables duke përdorur operacione të thjeshta: ngarko 32 bit nga paketa dhe kryej me ta një grup operacionesh aritmetike. Për shembull,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Ngarko 32 bitë e headerit IP, duke filluar nga offset 6, dhe aplikon maskën 0xFF (merr bajtin më të vogël). Ky është një fushë protocol e headerit IP dhe ne e krahasojmë atë me 1 (ICMP). Në një rregull mund të kombinohen shumë verifikime, dhe gjithashtu mund të kryhet operatori @ — kaloni X byte në të djathtën. Për shembull, rregulli
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"kontrollon nëse Numri i Sekuencës TCP 0x29. Nuk do të thellohesha më tej, pasi tashmë është e qartë që të shkruash këto rregulla manualisht nuk është shumë e përshtatshme. Në artikullin , ka disa lidhje me shembuj të përdorimit dhe gjenerimit të rregullave për xt_u32. Shih gjithashtu lidhjet në fund të këtij artikulli.
Që nga viti 2013, moduli në vend të modulit xt_u32 mund të përdoret një modul i bazuar në BPF. xt_bpfTë gjithë ata që e lexuan deri këtu duhet të kenë kuptuar principin e funksionit të tij: ekzekutimi i kodit të BPF si rregulla iptables. Një rregull të ri mund të krijohet, për shembull, kështu:
iptables -A INPUT -m bpf --bytecode -j LOGkëtu <байткод> — ky është kodi në formatin e daljes së assembler bpf_asm në mënyrë default, për shembull,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
Në këtë shembull ne filtrojmë të gjitha paketat UDP. Konteksti për programin BPF në modulin xt_bpf, sigurisht, tregon të dhënat e paketës, në rastin e iptables — në fillimin e headerit IPv4. Vlera e kthyer nga programi BPF index false tregon se paketa nuk përputhet.
E qartë se moduli xt_bpf mbështet filtre më komplekse se në shembullin e mësipërm. Le të shikojmë shembujt e vërtetë nga kompania Cloudfare. Deri kohët e fundit ata përdornin modulin xt_bpf për mbrojtjen nga sulmet DDoS. Në artikullin ata tregojnë si (dhe pse) gjenerojnë filtre BPF dhe publikojnë lidhje në një set mjetesh për krijimin e atyre filtrave. Për shembull, me ndihmën e mjeteve bpfgen mund të krijoni një program BPF që përputhet me kërkesën DNS për emrin habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
Në program ne fillimisht ngarkojmë në regjistër X adresën e fillimit të vargut x04habrx03comx00 brenda UDP-datagramit dhe pastaj kontrollojmë kërkesën: 0x04686162 "x04hab" etj.
Pak më vonë Cloudfare publikoi kodin e kompilatorit p0f -> BPF. Në artikullin ata flasin për atë se çfarë është p0f dhe si të konvertojnë nënshkrimet p0f në BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
Në aktualitet Cloudfare nuk e përdor më xt_bpf, pasi ata kaluan në XDP — një nga opsionet për të përdorur versionin e ri të BPF, shih. .
cls_bpf
Shembulli i fundit i përdorimit të BPF klasik në bërthamë është klasifikuesi cls_bpf për nënsystemin e kontrollit të trafikut në Linux, i shtuar në Linux në fund të vitit 2013 dhe konceptualisht zëvendësoi të vjetrin cls_u32.
Megjithatë, ne nuk do ta përshkruajmë tani funksionimin e cls_bpf, sepse nga këndvështrimi i njohurive mbi BPF klasik kjo nuk do të na sjellë asgjë — ne tashmë kemi njohur të gjithë funksionalitetin. Për më tepër, në artikujt e ardhshëm që flasin për BPF të Zgjeruar, ne do të hasim sërish këtë klasifikues.
Një tjetër arsye për të mos folur për përdorimin e BPF klasik me cls_bpf është se krahasuar me BPF të Zgjeruar, në këtë rast fusha e aplikueshmërisë radikalisht ngushtohet: programet klasike nuk mund të ndryshojnë përmbajtjen e paketimeve dhe nuk mund të ruajnë gjendjen mes thirrjeve.
Kështu që ka ardhur koha të përshëndetemi me BPF klasike dhe të shohim të ardhmen.
Lamtumirë BPF klasik
Ne kemi shikuar se si teknologjia BPF, e zhvilluar në fillim të viteve ‘90, ka mbijetuar për një çerek shekulli dhe vazhdimisht ka gjetur aplikime të reja. Megjithatë, ashtu si kalimi nga makinat me stekë në RISC, që shërbeu si një nxitje për zhvillimin e BPF klasic, në vitet 2000 ndodhi kalimi nga makinat 32-bit në ato 64-bit dhe BPF klasic filloi të mbetet pas. Përveç kësaj, mundësitë e BPF klasic janë të kufizuara dhe përveç arkitekturës së tejkaluar - nuk kemi mundësi për të ruajtur gjendjen midis thirrjeve të programeve BPF, nuk ka mënyrë për ndërveprim të drejtpërdrejtë me përdoruesin, nuk ka mundësi për ndërveprim me bërthamën, përveç leximit të një numri të kufizuar të fushave të strukturës. sk_buff dhe për të drejtuar funksione ndihmës të thjeshta, nuk është e mundur ndryshimi i përmbajtjes së pakove dhe ridrejtoni ato.
Në të vërtetë, në këtë moment nga BPF klasic në Linux ka mbetur vetëm ndërfaqja API, ndërsa brenda bërthamës të gjitha programet klasike, qofshin ato filtra soketesh apo filtra seccomp, automatikisht përkthehen në formatin e ri, BPF i Zgjatur. (Do të flasim rreth se si ndodh kjo në artikullin e ardhshëm.)
Kalimi në arkitekturën e re filloi në vitin 2013, kur Aleksei Starovoitov propozoi një skemë për përmirësimin e BPF. Në vitin 2014, patches përkatëse në bërthamë. Sa e kuptoj unë, fillimisht ishte planifikuar vetëm optimizimi i arkitekturës dhe kompiluesit JIT për një punë më efektive në makinat 64-bit, por përkundrazi, këto optimizime çuan në një kapitull të ri në zhvillimin e Linux.
Artikujt e ardhshëm në këtë seri do të flasin për arkitekturën dhe aplikimet e teknologjisë së re, e cila fillimisht ishte e njohur si BPF i brendshëm, pastaj BPF i zgjatur, dhe tani thjesht si BPF.
Linket
- Steven McCanne dhe Van Jacobson, "Filtri i Paketave BSD: Një Arkitekturë e Re për Kapjen e Paketave në Nivelin Përdorues",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: Një Arkitekturë dhe Metodologji Optimizimi për Kapjen e Paketave",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — bytecode i harruar:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Prezantimi i Mjetit BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Një pasqyrë mbi seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: një shikim nën kapak",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Burimi: habr.com
