

Në fillim ishte teknologjia dhe ajo u quajt BPF. Ne e shqyrtuam atë në , artikulli i vjetër i këtij cikli. Në vitin 2013, falë përpjekjeve të Alexei Starovoitov dhe Daniel Borkman, u zhvillua një version i përmirësuar dhe u përfshi në bërthamën Linux, e optimizuar për makinat moderne 64-bit. Kjo teknologji e re për një kohë të shkurtër u quajt Internal BPF, pastaj u ribërtërit në Extended BPF, dhe tani, pas disa vitesh, të gjithë e quajnë thjesht BPF.
Në terma të thjeshtë, BPF lejon ekzekutimin e kodit të rastësishëm, të ofruar nga përdoruesi, në hapësirën e bërthamës Linux dhe arkitektura e re rezultoi të jetë aq e suksesshme, sa që do të na duhen edhe dhjetra artikuj për të përshkruar të gjitha aplikimet e saj. (E vetmja gjë me të cilën zhvilluesit nuk u përballuan, siç mund ta shihni në bpm e mëposhtme, është krijimi i një logo të denjë.)
Në këtë artikull përshkruhet struktura e makinerisë virtuale BPF, ndërfaqet e bërthamës për të punuar me BPF, mjetet e zhvillimit, si dhe një përmbledhje e shkurtër, shumë e shkurtër, e mundësive ekzistuese, pra gjithçka që na nevojitet më vonë për një studim më të thellë të aplikimeve praktike të BPF.
Përmbledhje e shkurtër e artikullit
Fillimisht, ne do të shohim arkitekturën BPF nga një lartësi fluturimi dhe do të shënjojmë komponentët kryesorë.
Duke pasur tashmë një ide për arkitekturën në përgjithësi, ne do të përshkruajmë strukturën e makinerisë virtuale BPF.
Në këtë seksion, ne do të shohim më afër ciklin e jetës së objekteve BPF — programeve dhe hartave.
Duke pasur tashmë një ide për sistemin, ne përfundimisht do të shohim se si të krijojmë dhe menaxhojmë objekte nga hapësira e përdoruesit përmes një thirrjeje të veçantë të sistemit — bpf(2).
Sigurisht, është e mundur të shkruhen programe përmes thirrjes së sistemit. Por është e komplikuar. Për një skenar më realistik, programuesit e bërthamës zhvilluan një bibliotekë libbpf. Ne do të krijojmë skeleti më të thjeshtë të aplikacionit BPF, të cilin do ta përdorim në shembujt e ardhshëm.
Këtu do të mësojmë se si programet BPF mund të drejtojnë funksionet ndihmëse të bërthamës — një mjet që, së bashku me harta, zgjeron në mënyrë parësore kapacitetet e BPF-së së re krahasuar me atë klasike.
Në këtë pikë, ne do të dimë mjaftueshëm për të kuptuar se si pikërisht mund të krijojmë programe që përdorin harta. Dhe madje do të hedhim një sy në verifikuesin e madh dhe të fuqishëm.
Një seksion ndihmës mbi atë se si të ndërtojmë utilitetet e nevojshme dhe bërthamën për eksperimente.
Në fund të artikullit, ata që arrijnë deri aty do të gjejnë fjalë motivuese dhe një përshkrim të shkurtër të asaj që do të jetë në artikujt e ardhshëm. Ne gjithashtu do të përmendim disa lidhje për studim të pavarur për ata që nuk kanë dëshirë apo mundësi të presin vazhdimin.
Hyjnizimi në arkitekturën BPF.
Para se të fillojmë të shqyrtojmë arkitekturën BPF, një herë të fundit do të referohemi në , e cila u krijua si përgjigje ndaj shfaqjes së makinave RISC dhe zgjidhte problemin e filtrimit efikas të paketave. Arkitektura rezultoi kaq e suksesshme, saqë, duke lindur në vitet e errëta të nëntëdhjetës në Berkeley UNIX, ajo u portua në shumicën e sistemeve operativë ekzistuese, duke mbijetuar deri në vitet e çmendura njëzet dhe ende gjen përdorime të reja.
BPF-i ri u zhvillua si një përgjigje ndaj përhapjes së gjërë të makinave 64-bit, shërbimeve cloud dhe nevojave të rritura për mjete për ndërtimin e SDN (Ssoftuer-ddefinuar nrrjetin). E krijuar nga inxhinierët e rrjeteve si një zëvendësim të përmirësuar të BPF-së klasike, BPF-i ri përfundimisht gjeti aplikime brenda gjashtë muajve për hetimin e sistemeve Linux, dhe tani, pas gjashtë vjetësh nga shfaqja e saj, do të kërkojmë një artikull të plotë vetëm për të renditur llojet e ndryshme të programeve.
VëSëLë KëRtInKë
Në thelb, BPF është një makinë virtuale që vepron si një sandë, e lejon ekzekutimin e kodit "të rastësishëm" në hapësirën e kernelit pa rrezikuar sigurinë. Programet BPF krijohen në hapësirën e përdoruesit, ngarkohen në kernel dhe lidhen me një burim ngjarjesh. Një ngjarje mund të jetë, për shembull, dorëzimi i një pakete në ndërfaqen rrjetë, ekzekutimi i një funksioni të kernelit, etj. Në rastin e paketës, programit BPF do t'i jenë të disponueshme të dhënat dhe metadata e paketës (për lexim dhe, ndoshta, për shkrim, në varësi të tipit të programit), ndërsa në rastin e ekzekutimit të funksionit të kernelit — argumentet e funksionit, duke përfshirë treguesit e memories së kernelit, etj.
Le të hedhim një vështrim më të detajuar në këtë proces. Fillimisht, le të flasim për dallimin e parë nga BPF tradicional, për të cilin programet shkruheshin në assembler. Në versionin e ri, arkitektura u përmirësua në mënyrë që programet të mund të shkruheshin në gjuhë të nivelit të lartë, kryesisht, natyrisht, në C. Për këtë, u zhvillua një backend për llvm, që mundëson gjenerimin e kodit të byte për arkitekturën BPF.
Arkitektura BPF u zhvillua, veçanërisht, për të funksionuar në mënyrë efikase në makinat moderne. Për të siguruar që kjo të funksiononte në praktikë, kodi i byte BPF, pas ngarkimit në kernel, përkthehet në kod natyror me ndihmën e një komponenti të quajtur JIT compiler (Just In Time). Më tej, nëse e mbani mend, në BPF-në tradicionale, programi ngarkohej në kernel dhe lidhej me burimin e ngjarjeve në mënyrë atomike — në kuadër të një thirrjeje sistemike. Në arkitekturën e re, kjo ndodh në dy etapa — së pari, kodi ngarkohet në kernel përmes një thirrjeje sistemike bpf(2), dhe pastaj, më vonë, përmes mekanizmave të tjerë, të ndryshëm në varësi të tipit të programit, programi lidhet (attaches) me burimin e ngjarjeve.
Këtu mund të lindë një pyetje për lexuesin: a ka qenë kështu? Si i garanton siguria ekzekutimin e tillë të kodit? Siguria e ekzekutimit garanton nga faza e ngarkimit të programeve BPF të quajtur verifikues (në anglisht këtë fazë e quajnë verifier dhe unë do ta përdor më tej fjalën në anglisht):
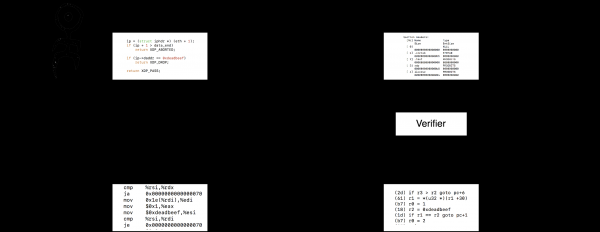
Verifier është një analizator statik që garanton se programi nuk do të ndërhyjë në funksionimin normal të bërthamës. Kjo, megjithatë, nuk do të thotë që programi nuk mund të ndërhyjë në funksionimin e sistemit — programet BPF, varësisht nga lloji, mund të lexojnë dhe shkruajnë pjesë të memories së bërthamës, të kthejnë vlera funksionesh, të prishin, plotësojnë, rishkruajnë dhe madje të dërgojnë paketa rrjeti. Verifier garanton që bërthama nuk do të dështojë nga ekzekutimi i programit BPF dhe që një program, i cili sipas rregullave ka leje shkruese, si për shembull të dhënat e paketës së dalsim, nuk do të jetë në gjendje të rishkruajë memorjen e bërthamës jashtë paketës. Pak më në detaje, ne do të shikojmë verifier në seksionin përkatës, pasi të njihemi me të gjithë komponentët e tjerë të BPF.
Pra, çfarë kemi mësuar deri në këtë moment? Përdoruesi shkruan një program në gjuhën C, e ngarkon atë në bërthamë përmes një thirjeje sistemike bpf(2), ku ai kalon verifikimin në verifier dhe përkthimin në kodin nativ të bajtëve. Më pas, të njëjtin ose një përdorues tjetër lidh programin me burimin e ngjarjeve dhe ai fillon të ekzekutohet. Ndara e ngarkimit dhe lidhjes është e nevojshme për disa arsye. Së pari, ekzekutimi i verifier është relativisht i kushtueshëm dhe, duke ngarkuar të njëjtin program disa herë, ne humbasim kohë kompjuterike pa kuptim. Së dyti, mënyra se si lidhet programi varet nga lloji i tij dhe një "ndërfaqe universale" e dizajnuar një vit më parë mund të mos jetë e përshtatshme për lloje të reja programesh. (Megjithatë, tani, kur arkitektura po bëhet më e pjekur, ka një ide për të unifikuar këtë ndërfaqe në nivelin libbpf.)
Një lexues i vëmendshëm mund të vërejë se ne nuk kemi përfunduar akoma me imazhet. Në të vërtetë, gjithçka e thënë më sipër nuk shpjegon se si BPF ndryshon në mënyrë thelbësore pamjen përballë BPF klasike. Dy novacione, të cilat zgjasin ndjeshëm kufijtë e aplikueshmërisë — janë mundësia për të përdorur kujtesë të ndarë dhe funksione ndihmëse të bërthamës (kernel helpers). Në BPF, kujtesa e ndarë realizohet me anë të ashtuquajturave maps — struktura të dhënash të ndara me një API të caktuar. Ky emër e merr ndoshta sepse tipi i parë i map që u shfaq ishte një tabelë hashi. Më pas u shfaqën array, tabela hashi lokale (per-CPU) dhe array lokale, pemë kërkimi, mapa që përmbajnë tregues për programet BPF dhe shumë të tjera. Çfarë na intereson tani është fakti që programet BPF morën mundësinë të ruajnë gjendjen midis thirrjeve dhe ta ndajnë atë me programe të tjera dhe me hapësirën e përdoruesit.
Qasja në maps bëhet nga proceset e përdoruesve me anë të një thirrjeje sistemike bpf(2), ndërsa nga programet BPF që punojnë në bërthamë — me anë të funksioneve ndihmëse. Më shumë se kaq, ndihmësit ekzistojnë jo vetëm për punën me mapa, por gjithashtu për qasjen në mundësi të tjera të bërthamës. Për shembull, programet BPF mund të përdorin funksione ndihmëse për të ridirekruar paketat në interface të tjera, për të gjeneruar ngjarje në nën-sistemin perf, për të aksesuar struktura të bërthamës dhe e të tjera.
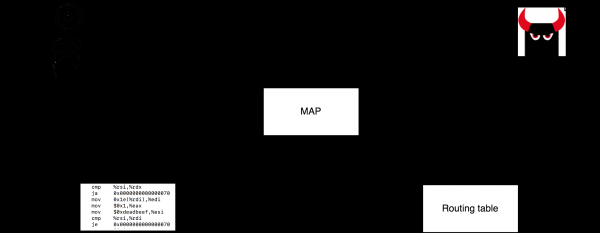
Përfundimisht, BPF ofron mundësinë të ngarkojë kod të rastësishëm, dmth, kodin që ka kaluar kontrollin në verifier, në hapësirën e bërthamës. Ky kod mund të ruajë gjendjen midis thirrjeve dhe të ndajë të dhëna me hapësirën e përdoruesit, si dhe ka qasje në nën-sistemat e bërthamës të lejuara për këtë tip programesh.
Kjo tashmë ngjan si mundësi që ofrohen nga modulat e bërthamës, përballë të cilave BPF ka disa avantazhe (sigurisht, mund të krahasohet vetëm aplikacione të ngjashme, për shembull, gjurmimi i sistemit - në BPF nuk mund të shkruhet ndonjë drejtues të rastësishëm). Mund të vërejmë një prag më të ulët hyrjeje (disa utilitare që përdorin BPF nuk kërkojnë që përdoruesi të ketë aftësi programimi të bërthamës, dhe madje, as aftësi programimi në përgjithësi), sigurinë e kohës ekzekutimi (ngrihuni dorën në komente ata që nuk e kanë thyer sistemin kur kanë shkruar ose testuar module), atomaritetin - gjatë rinisjes së moduleve ka kohë ndërprerjeje, ndërsa nën-sistemi BPF garanton që asnjë ngjarje nuk do të kalojë (për t'i bërë të drejta, kjo nuk është e vërtetë për të gjitha llojet e programeve BPF).
Prania e të tilla mundësive e bën BPF një mjet universale për zgjerimin e bërthamës, gjë që vërtetohet në praktikë: çdo ditë po shtohen lloje të reja programesh në BPF, gjithnjë e më shumë kompanitë e mëdha e përdorin BPF në serverët e tyre në mënyrë 24×7, gjithnjë e më shumë startup-e po ndërtojnë biznesin e tyre mbi zgjidhje të bazuara në BPF. BPF përdoret kudo: në mbrojtjen nga sulmet DDoS, në krijimin e SDN (për shembull, implementimin e rrjeteve për kubernetes), si mjeti kryesor për gjurmimin e sistemeve dhe mbledhjen e statistikave, në sistemet e zbulimit të depërtimit dhe në sistemet e rëra etj.
Le të përfundojmë këtë pjesë përmbledhëse të artikullit dhe të shikojmë më në detaje mbi makinat virtuale dhe ekosistemin BPF.
Shkëputje: utilitarët
Për të pasur mundësinë të ekzekutoni shembujt nga kapitujt e ardhshëm, mund t'ju nevojitet një sërë utilitarësh, minimalisht llvm/clang me mbështetje për bpf dhe bpftool. Në seksionin mund të lexoni udhëzime për ndërtimin e utilitarëve, si dhe të bërthamës tuaj. Ky seksion është vendosur poshtë, për të mos prishur rregullsinë e përshkrimit tonë.
Regjistrat dhe sistemi i komandave të makinës virtuale BPF
Arkitektura dhe sistemi i komandave BPF u zhvilluan duke pasur parasysh që programet do të ishin shkruar në gjuhën C dhe, pas ngarkimit në bërthatë, do të përktheheshin në kod nativ. Prandaj, numri i regjistrave dhe shumica e komandave u zgjodh duke marrë parasysh përputhjen, në kuptimin matematikor, me mundësitë e makinave moderne. Përveç kësaj, programet kishin disa kufizime, për shembull, deri para pak kohësh nuk kishte mundësi për të shkruar cikle dhe nënprograme, dhe numri i instruksioneve ishte i kufizuar në 4096 (tani programet me privilegje mund të ngarkojnë deri në një milion instruksione).
Në BPF ka njëmbëdhjetë regjistra 64-bitë që janë të disponueshëm për përdoruesit. r0—r10 dhe një numërues komandash (program counter). Regjistri r10 mban një tregues për shpejtësinë (frame pointer) dhe është i disponueshëm vetëm për lexim. Programet gjatë ekzekutimit i qasen një steku prej 512 byte dhe një numri të pakufizuar të memories së ndarë në formë maps.
Programet BPF lejohet të ekzekutojnë një grup funksionesh ndihmëse (kernel helpers) në varësi të llojit të programit dhe, së fundmi, edhe funksione të zakonshme. Çdo funksion i thirrur mund të marrë deri në pesë argumente, të cilat kalohen në regjistrat r1—r5, ndërsa vlera e kthyer kalon në r0. Garantohet se pas kthimit nga funksioni përmbajtja e regjistrave r6—r9 nuk do të ndryshohet.
Për përkthimin efikas të programeve, regjistrat r0—r11 për të gjitha arkitekturën e mbështetur hartohen në mënyrë të qartë në regjistra të vërtetë duke marrë parasysh veçoritë e ABI të arkitekturës aktuale. Për shembull, për x86_64 regjistrat r1—r5, të cilët përdoren për kalimin e parametrave të funksioneve, hartohen në rdi, rsi, rdx, rcx, r8, të cilat përdoren për kalimin e parametrave në funksionet në x86_64. Për shembull, kodi në majë përkthehet në kodin në të djathtë kështu:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Regjistri r0 përdoret gjithashtu për kthimin e rezultatit të ekzekutimit të programit, ndërsa në regjistrin r1 programi kalon një tregues për kontekstin — në varësi të llojit të programit, kjo mund të jetë, për shembull, struktura (për XDP) ose struktura (për programe të ndryshme rrjetëshe) ose struktura (për lloje të ndryshme programesh tracing) etj.
Pra të gjithë, kishim një grup regjistrash, ndihmës të kernelit, një stack, një tregues konteksti dhe memorie të ndarë në formën e maps. Nuk ishte se e gjitha kjo ishte absolutisht e nevojshme gjatë udhëtimit, por...
Le të vazhdojmë me përshkrimin dhe të flasim për sistemin e komandeve për të punuar me këto objekte. Të gjithë () instruksionet BPF kanë një madhësi fikse prej 64 bit. Nëse e shikoni njëinstruksion në një makinë 64-bit Big Endian, do të shihni

Këtu Code — kjo është kodifikimi i instruksionit, Dst/Src — këto janë kodifikimet e marrësit dhe burimit, përkatësisht, Off — një zhvendosje e shenjuar 16-bit, dhe Imm — kjo është një numër i tërë 32-bit i shenuar, e përdorur në disa komanda (analog me konstantën K nga cBPF). Kodifikimi Code ka një nga dy lloje:
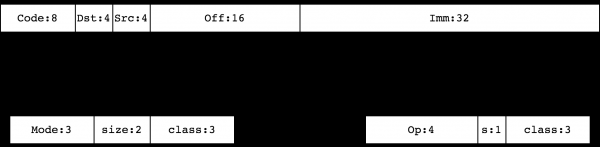
Klasat e instruksioneve 0, 1, 2, 3 përcaktojnë komanda për të punuar me memorien. Ato , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, përkatësisht. Klasat 4, 7 (BPF_ALU, BPF_ALU64) përbëjnë një grup instruksionesh ALU. Klasat 5, 6 (BPF_JMP, BPF_JMP32) përmbajnë instruksione kalimi.
Plani tjetër për të studiuar sistemin e komandeve BPF është ky: në vend që të përmendim me hollësi të gjitha instrukcionet dhe parametrat e tyre, ne do të shqyrtojmë disa shembuj në këtë seksion dhe do të bëhet e qartë se si janë organizuar instruksionet në të vërtetë dhe si të disasemblonim një skedar binar për BPF. Për të forcuar materialin, më tej në artikull, do të takojmë instruksione të veçanta në seksionet për Verifier, kompiluesin JIT, transkriptimin e BPF klasik, si dhe gjatë studimit të maps, thirrjes së funksioneve etj.
Kur të flasim për instruksione të veçanta, ne do t'i referohemi skedarëve të kernelit dhe , në të cilat përcaktohen kodet numerike të instruksioneve BPF. Gjatë studimeve të pavarura të arkitekturës dhe/ose analizës së binarëve, semantikën e mund të gjeni në burimet e mëposhtme, të renditura sipas vështirësisë: , , dhe, natyrisht, në kodin burimor të Linux — verifier, JIT, interpreter BPF.
Shembulli: disasemblojmë BPF në mendje
Le të shqyrtojmë një shembull, ku do të kompilirojmë programin readelf-example.c dhe të shohim binarin e fituar. Do të zbulojmë përmbajtjen origjinale readelf-example.c më poshtë, pasi të rikthejmë logjikën e tij nga kodet binare:
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Kolona e parë në dalje readelf — është hapsira dhe programi ynë, kështu që përbëhet nga katër komanda:
Code Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Kodet e komandave janë të barabarta b7, 15, b7 dhe 95. Kujtojmë se tri bitët më të ulët janë klasa e instrukcionit. Në rastin tonë, bita e katërt është bosh për të gjitha instrukcionet, kështu që klasat e instrukcioneve janë të barabarta, përkatësisht, 7, 5, 7, 5. Klasa 7 është BPF_ALU64, ndërsa 5 është BPF_JMP. Për të dyja klasat formati i instrukcionit është i njëjtë (shih më lart) dhe ne mund ta shkruajmë programin tonë kështu (po ashtu, do të shkruajmë edhe kolonat e tjera në një format më të qartë):
Op S  Class   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operación b klasës ALU64 — është . Ajo i cakton një vlerë regjistrimit-rresht të pranuesit. Nëse është vendosur bita s (source), vlera merret nga regjistri-burim, dhe nëse, si në rastin tonë, ai nuk është vendosur, atëherë vlera merret nga fusha Imm. Kështu, në instrukcionet e para dhe të treta ne kryejmë operacionin r0 = Imm. Më pas, operacioni 1 i klasës JMP është (kalim nëse janë të barabarta). Në rastin tonë, pasi bita S është zero, ajo krahason vlerën e regjistrit-burim me fushën Imm. Nëse vlerat përputhen, atëherë kalimi ndodh në PC + Offindex PC, si zakonisht, përmban adresën e instrukcionit tjetër. Së fundmi, operacioni 9 i klasës JMP është . Ky instrukcion përfundon ekzekutimin e programit, duke kthyer në bërthamë r0. Do të shtojmë një kolonë të re në tabelën tonë:
Op    S  Class   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      nëse (r1 == 0) kaloni në pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      dil
Ne mund ta shkruajmë këtë në një format më të përshtatshëm:
     r0 = 1
     nëse (r1 == 0) kaloni në FUND
     r0 = 2
FUND:
     dil
Nëse ne kujtojmë se në regjistrin r1 programi kalon një tregues në kontekst nga bërthama, dhe në regjistrin r0 kthehet një vlerë në bërthamë, atëherë ne mund të shohim se nëse treguesi në kontekst është zero, ne kthejmë 1, ndryshe 2. Le të kontrollojmë nëse jemi të saktë duke parë burimin:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Po, ky është një program pa kuptim, por megjithatë, ai përkthehet vetëm në katër instrukcione të thjeshta.
Shembulli përjashtim: instrukcioni 16-bajtësh
Më parë përmendëm se disa instrukcione zënë më shumë se 64 bita. Kjo vlen për shembuj për instrukcionin lddw (Code = 0x18 = | | ) — ngarko në regjistër një fjalë të dyfishtë nga fushat Imm. E vërteta është se Imm ka ka një madhësi prej 32, ndërsa fjala e dyfishtë — 64 bita, kështu që ngarkimi i një vlerë të drejtpërdrejtë 64-bit në një regjistër me një udhëzim 64-bitsh nuk është i mundur. Për këtë, dy udhëzime ngjitur përdoren për të ruajtur pjesën e dytë të vlerës 64-bit në fushë Imm. Shembull:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
Në programin binar ka vetëm dy udhëzime:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Ne do të takojmë përsëri me udhëzimin lddw, kur të flasim për rilokimet dhe punën me maps.
Shembull: disasemblojmë BPF me mjete standarde
Pra, ne kemi mësuar të lexojmë kodet binare BPF dhe jemi gati të analizojmë çdo udhëzim nëse është e nevojshme. Megjithatë, duhet thënë se në praktikë është më e lehtë dhe më e shpejtë të disasemblojmë programet duke përdorur mjete standarde, për shembull:
$ llvm-objdump -d x64.o

Disassembly of section .text:

0000000000000000 :
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Cikli i jetës së objekteve BPF, sistemi i skedarëve bpffs
(Disa detaje që përshkruhen në këtë nënkapitull, unë i mësova për herë të parë nga Alexei Starovoitov në .)
Objektet BPF — programet dhe mapat — krijohen nga hapësira e përdoruesit përmes komandave BPF_PROG_LOAD dhe BPF_MAP_CREATE thirrjes së sistemit bpf(2), ne do të flasim se si ndodh kjo në kapitullin e ardhshëm. Këtu krijohen struktura të dhënash të bërthamës dhe për secilën prej tyre refcount (numri iReferencave) vendoset të jetë një, dhe përdoruesit i kthehet një deshifrues skedari që tregon në objekt. Pasi të mbyllet deshifruesi refcount numri iReferencave të
kësaj mape rritet me një pas ngarkimit të programit, dmth. deshifruesit e skedarëve mund të mbyllen nga procesi i përdoruesit dhe për këtë arsye refcount nuk bëhet zero: refcount Pasi të ngarkohet me sukses programi ne zakonisht e lidhim atë me ndonjë gjenerator ngjarjesh. Për shembull, ne mund ta vendosim atë në ndërfaqen rrjetë për përpunimin e paketimeve që vijnë ose ta lidhim atë me ndonjë
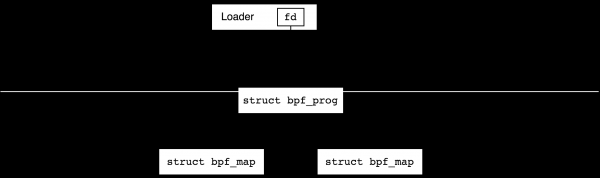
tracepoint në bërthamë. Në këtë moment, numri iReferencave gjithashtu do të rritet me një dhe ne do të mund të mbyllim deshifruesin e skedarit në programin ngarkues. në thellësi. Në këtë moment, numri i lidhjeve gjithashtu do të rritet me një dhe mund të mbyllim descriptorin e skedarit në programin ngarkues.
Çfarë do të ndodhë nëse ne tani përfundojmë punën e ngarkuesit? Kjo varet nga lloji i gjeneratorit të ngjarjeve (hook). Të gjitha hook-et rrjetë do të ekzistojnë pas përfundimit të ngarkuesit, këto quhen hook-et globale. Ndërsa, për shembull, programet e gjurmimeve do të çlirohen pas përfundimit të procesit që i krijoi ato (dhe për këtë arsye quhen lokale, nga „local to the process”). Teknikisht, hook-et lokale gjithmonë kanë një deshifrim të dosjes përkatëse në hapësirën e përdoruesit dhe për këtë arsye mbyllen me mbylljen e procesit, ndërsa ato globale jo. Në figurën e ardhshme, përmes crosses të kuq, do të përpiqem të tregoj si përfundimi i programit ngarkues ndikon në kohëzgjatjen e objekteve në rastin e hook-eve lokale dhe globale.
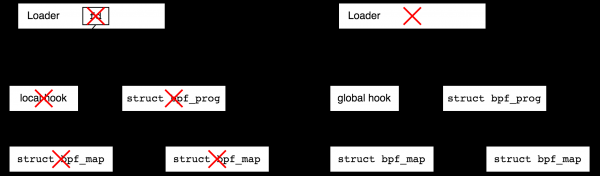
Pse egziston ndarja në hook-e lokale dhe globale? Shkarkimi i disa llojeve të programit rrjetë ka kuptim dhe pa hapësirë për përdoruesit, për shembull, imagjinoni mbrojtjen nga DDoS — ngarkuesi shkruan rregullat dhe lidh një program BPF me ndërfaqen rrjetë, pas së cilës ngarkuesi mund të shkojë dhe të vetëvritet. Nga ana tjetër, mendoni për një program gjurmimi që keni shkruar shpejt për dhjetë minuta — pas përfundimit të tij, do të dëshironit që në sistem të mos kishte mbetje dhe hook-et lokale e garantohen këtë.
Nga ana tjetër, imagjinoni që dëshironi të lidheni me një pikë gjurmimi në bërthamë dhe të mbledhni statistikat për shumë vite. Në këtë rast, do të dëshironit të përfundoni pjesën e përdoruesit dhe të ktheheni herë pas here te statistikat. Këtë mundësi ofron sistemi i dosjeve bpf. Ky është një sistem dosjesh psevdosh, që ekziston vetëm në memorie, i cili lejon krijimin e dosjeve që referojnë objekte BPF dhe, kështu, rritin refcount objektet. Pasi që ngarkuesi mund të përfundojë punën, objektet që krijoi do të mbeten të gjalla.
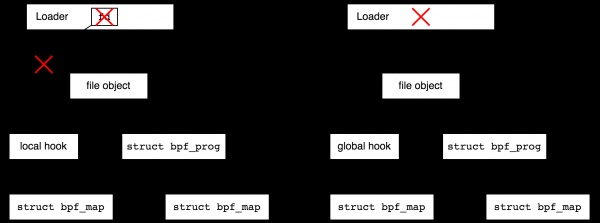
Krijimi i dosjeve në bpffs, që referojnë objekte BPF quhet „ngjitje” („pin”, si në frazën tjetër: „process can pin a BPF program or map”). Krijimi i objekteve dosje për objektet BPF ka kuptim jo vetëm për të zgjatur jetën e objekteve lokale, por edhe për lehtësimin e përdorimit të objekteve globale — duke u kthyer te shembulli me programin global për mbrojtjen nga DDoS, ne duam të kemi mundësi herë pas here të vijmë dhe të shikojmë statistikat.
Sistemi datotekave BPF zakonisht montohet në /sys/fs/bpf, por gjithashtu mund të montohet lokalisht, për shembull, kështu:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Emrat në sistemin e skedave krijohen duke përdorur komandën BPF_OBJ_PIN të thirrjes së sistemit BPF. Si ilustim, le të marrim një program, ta kompilojmë, ta ngarkojmë dhe ta lidhim në bpffs. Programi ynë nuk bën asgjë të dobishme, ne vetëm po sjellim kodin e tij për t'ju lejuar të riprodhoni shembullin:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Tani do ta kompilojmë këtë program dhe të krijojmë një kopje lokale të sistemit të skedave bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Tani le të ngarkojmë programin tonë duke përdorur utilitarin bpftool dhe të shohim thirrjet e sistemeve përkatëse bpf(2) (nga dalja e strace janë hequr disa rreshta të panhulumtuar):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Këtu e ngarkuam programin duke përdorur BPF_PROG_LOAD, morëm një descriptor të skedave nga bërthama 3 dhe duke përdorur komandën BPF_OBJ_PIN e lidhi këtë descriptor skedash si një skedë "bpf-mountpoint\/test". Pas kësaj, programi ngarkues bpftool përfundoi punën, por programi ynë mbeti në bërthamë, ndonëse nuk e lidhëm atë me asnjë ndërfaqe rrjeti:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Ne mund ta fshijmë objektin e skedave me anë të unlink(2) dhe pas kësaj, programi përkatës do të fshihet:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Fshirja e objekteve
Duke folur për fshirjen e objekteve, është e nevojshme të saktësohet se pasi që e kemi shkëputur programin nga hook (generaatorin e ngjarjeve), asnjë ngjarje e re nuk do të nxisë fillimin e saj, megjithatë, të gjitha ekzistencat aktuale të programit do të përfundojnë në mënyrë të rregullt.
Disa lloje programesh BPF lejojnë ndërrimin e programit në flakë, dmth. ofrojnë atomikën e sekuencës replace = detach old program, attach new program. Në këtë mënyrë, të gjitha ekzistencat aktive të versions së vjetër të programit do të përfundojnë punën e tyre, ndërsa përpunuesit e rinj të ngjarjeve do të krijohen nga programi i ri, dhe "atomikën" në këtë kontekst do të thotë se asnjë ngjarje nuk do të humbasë.
Kjo programesh për lidhjen me burimet e ngjarjeve
Në këtë artikull nuk do të përshkruajmë veçmas lidhjen e programeve me burimet e ngjarjeve, pasi ka kuptim ta studiojmë në kontekstin e një lloji specifik programi. Shihni më poshtë, ku tregojmë si lidhen programet e tipit XDP.
Menaxhimi i objekteve përmes thirrjes sistemore bpf
Programet BPF
Të gjitha objektet BPF krijohen dhe menaxhohen nga hapësira e përdoruesit përmes thirrjes sistemore bpf, që ka prototipin e mëposhtëm:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Këtu, komanda cmd – është një nga vlerat e tipit , attr – tregues ndaj parametrave për programin specifik dhe size – madhësia e objektit përmes treguesit, dmth zakonisht është sizeof(*attr). Në kernelin 5.8, thirrja sistemore bpf mbështet 34 komanda të ndryshme, dhe union bpf_attr merr 200 rreshta. Por kjo nuk duhet të na friksojë, pasi do të njihemi me komandat dhe parametrat gjatë disa artikujve.
Të fillojmë me komandën BPF_PROG_LOAD, e cila krijon programet BPF — merr një grup instruksionesh BPF dhe e ngarkon ato në kernel. Në momentin e ngarkimit, aktivizohet verifikuesi, pastaj kompjileri JIT dhe, pas një përfundimi të suksesshëm, përdoruesit i kthehet descriptori i skedarit të programit. E pamë se çfarë ndodhi më tej në seksionin e mëparshëm .
Tani do të shkruajmë një program përdoruesi që do të ngarkohet një program të thjeshtë BPF, por së pari na nevojitet të vendosim se çfarë programi dëshirojmë të ngarkojmë — do të duhet të zgjedhim dhe brenda këtij tipi të shkruajmë një program që do të kalojë verifikimin. Sidoqoftë, për të mos e komplikuar procesin, këtu është një zgjidhje e gatshme: do të marrim programin e tipit BPF_PROG_TYPE_XDP, i cili do të kthejë vlerën XDP_PASS (kaloni të gjitha paketat). Në assemblerin BPF kjo duket shumë e thjeshtë:
r0 = 2
exit
Pas përcaktimit të asaj që nuk shkon, dhe gjithashtu ka një ide për atë që ndodh në shërbimet përreth, për të kuptuar, ne do të ngarkojmë, mund të tregojmë se si do ta bëjmë:
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Ngjarjet interesante në program fillojnë me përcaktimin e një vargu insns – programi ynë BPF në kodin makinerik. Në këtë rast, çdo instruksion i programit BPF paketizohet në një strukturë Elementi i parë insns përkon me instruksionin r0 = 2, tjetri — exit.
Përjashtim. Në bërthama janë përcaktuar më shumë makro të përshtatshme për të shkruar kode makine, dhe, duke përdorur dosjen kryesore të bërthamës tools/include/linux/filter.h ne do të mund të shkruajmë
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Por shkakun se shkruajtja e programeve BPF në kodet makinë nevojitet vetëm për të shkruar teste në bërthamë dhe artikuj për BPF, mungesa e këtyre makros nuk e komplikon jetën e zhvilluesit në të vërtetë.
Pas përcaktimit të programit BPF, ne kalojmë në ngarkimin e tij në bërthamë. Grupi ynë minimalistik i parametrave attr përfshin llojin e programit, grupin dhe numrin e instruksioneve, licencën e detyrueshme, si dhe emrin "woo", i cili përdoret për të gjetur programin tonë në sistem pas ngarkimit. Programi, siç është premtuar, ngarkohet në sistem përmes thirrjes së sistemit bpf.
Në fund të programit, ne kalojmë në një cikël të pafund, i cili imiton ngarkesën e dobishme. Pa të, programi do të zhduket nga bërthama kur mbyllet deshifruesi i skedarit që na ktheu thirrja e sistemit bpf, dhe ne nuk do ta shohim atë në sistem.
Mirë, jemi gati për testim. Do ta ndërrymë dhe ekzekutojmë programin në strace, për të kontrolluar nëse gjithçka funksionon siç duhet:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace ./simple-prog
execve("./simple-prog", ["./simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Gjithçka është në rregull, bpf(2) na ktheu deshifruesin 3 dhe ne kaluam në një cikël të pafund me pause(). Le të përpiqemi të gjejmë programin tonë në sistem. Për këtë do të shkojmë në një terminal tjetër dhe do të përdorim utilitarin bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Ne shohim se në sistem ekziston një program i ngarkuar woo i cili ka një ID global prej 390, dhe që në procesin simple-prog ka një deshifrues të hapur të skedarit që tregon për programin (dhe nëse simple-prog përfundon, atëherë woo do të zhduket). Siç pritej, programi woo zë 16 byte - dy instruksione - kodet binare në arkitekturën BPF, por në formatin natyror (x86_64) - është tashmë 40 byte. Le të shohim programin tonë në formatin origjinal:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
pa surpriza. Tani le të shohim kodin e krijuar nga JIT kompaktori:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
nuk është shumë efikas për exit(2), por për të drejtën, programi ynë është shumë i thjeshtë, dhe për programet jo triviale, prologu dhe epilogu të shtuar nga JIT kompaktori, sigurisht, janë të nevojshme.
Maps
Programet BPF mund të përdorin zona strukturore të memories, të aksesueshme si nga programet e tjera BPF, ashtu edhe nga programet në hapësirën e përdoruesit. Këto objekte quhen maps dhe në këtë pjesë ne do të tregojmë si t'i menaxhojmë ato me anë të thirrjeve sistemike. bpf.
Të themi qartë se mundësitë e maps nuk kufizohen vetëm në aksesin në memorjen e përbashkët. Ekzistojnë mapa me destinacion të veçantë, që përmbajnë, për shembull, tregues për programet BPF ose tregues për ndërfaqet rrjet, mape për të punuar me ngjarje perf dhe kështu me radhë. Këtu ne nuk do të flasim për to, për të mos ngatërruar lexuesin. Përveç kësaj, ne e injorojmë problemin e sinkronizimit, pasi kjo nuk është e rëndësishme për shembujt tanë. Një listë e plotë e tipeve të mapeve që janë në dispozicion mund të gjendet në , dhe në këtë pjesë do të marrim si shembull tipin historikisht të parë, tabelën me hash. BPF_MAP_TYPE_HASH.
Nëse po krijoni një tabelë me hash, le të themi në C++, do të thoni unordered_map woo, që në shqip do të thotë "më nevojitet një tabelë woo të pakufizuar, ku çelësat kanë tipin int, ndërsa vlerat - tipin long". Për të krijuar një tabelë BPF me hash duhet të bëjmë më shumë ose pak të njëjtën gjë, me ndryshimin se na nevojitet të tregojmë madhësinë maksimale të tabelës dhe në vend të tipeve të çelësave dhe vlerave, na duhen madhësitë e tyre në byte. Për krijimin e mapeve përdoret komanda BPF_MAP_CREATE thirrjes së sistemit bpf. Le të shohim një program mëse minimal, i cili krijon një mapë. Pas programit të mëparshëm, që ngarkon programet BPF, ky duhet t'ju duket i thjeshtë:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Këtu ne përcaktojmë një set parametrash attr, ku thërrasim "më nevojitet një tabelë me hash me çelësa dhe vlera të madhësisë sizeof(int), në të cilën mund të vendos maksimum katër elemente”. Kur krijoni mape BPF mund të përcaktoni edhe parametra të tjerë, për shembull, ashtu siç në shembullin me programin, kemi përcaktuar emrin e objektit si "woo".
Le të kompilojmë dhe ekzekutojmë programin:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Këtu është thirrja sistematike bpf(2) na ktheu një deskriptori të hartës numër 3 dhe më pas programi, siç pritej, pret udhëzime të mëtejshme në thirrjen sistematike pause(2).
Tani do të dërgojmë programin tonë në background ose do të hapim një terminal tjetër dhe do të shohim objektin tonë me ndihmën e utilitarit bpftool (mund të dallojmë hartën tonë nga të tjera sipas emrit të saj):
$ sudo bpftool map
...
114: hash  emri woo  flamuj 0x0
        çelësi 4B  vlera 4B  max_entries 4  memlock 4096B
...
Numri 114 është ID globale e objektit tonë. Çdo program në sistem mund të përdorë këtë ID për të hapur një hartë ekzistuese me komandën BPF_MAP_GET_FD_BY_ID thirrjes së sistemit bpf.
Tani mund të luajmë me tabelën tonë të hash. Le të shohim përmbajtjen e saj:
$ sudo bpftool map dump id 114
Gjetur 0 elementë
E pustë. Le të vendosim një vlerë në të hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Le të shohim tabelën edhe një herë:
$ sudo bpftool map dump id 114
çelësi: 01 00 00 00  vlera: 01 00 00 00
Gjetur 1 element
Hurrah! Mundëm të shtonim një element. Vini re se për këtë na duhej të punonim në nivelin e byte-ve, pasi bptftool nuk e di se çfarë lloj kanë vlerat në tabelën e hash. (Kjo njohuri mund t'i jepet, duke përdorur BTF, por jo tani.)
Si i lexon dhe shton elementet bpftool? Le të hedhim një sy poshtë kapakut:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
çelësi: 01 00 00 00  vlera: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Fillimisht hapëm hartën sipas ID-së së saj globale me komandën BPF_MAP_GET_FD_BY_ID dhe bpf(2) na ktheu një deskriptor 3. Më pas, me komandën BPF_MAP_GET_NEXT_KEY gjetëm çelësin e parë në tabelë, duke kaluar NULL si një tregues ndaj çelësit "të mëparshëm". Nëse kemi një çelës mund të bëjmë BPF_MAP_LOOKUP_ELEM, i cili kthen vlerën në treguesin vlera. Hapi tjetër është që përpiqemi të gjejmë elementin tjetër, duke kaluar treguesin ndaj çelësit aktual, por tabela jonë përmban vetëm një element dhe komanda BPF_MAP_GET_NEXT_KEY false, nëse elementi që do të zëvendësohet është ENOENT.
Mirë, le të ndryshojmë vlerën për çelësin 1, le të themi se logjika jonë e biznesit kërkon të shkruajmë hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Siç pritej, është shumë e lehtë: komandë BPF_MAP_GET_FD_BY_ID hap hartën tonë sipas ID-së, dhe komandë BPF_MAP_UPDATE_ELEM shkruan përsëri elementin.
Në përfundim, pas krijimit të një hesh-tabele nga një program, ne mund të lexojmë dhe shkruajmë përmbajtjen e saj nga një program tjetër. Vini re se nëse arritëm ta bënim këtë nga rreshti i komandave, atëherë çdo program tjetër në sistem mund ta bëjë po ashtu. Përveç komandave të përmendura më sipër, për të punuar me harta nga hapësira e përdoruesit janë të disponueshme :
BPF_MAP_LOOKUP_ELEM: të gjejmë vlerën sipas çelësitBPF_MAP_UPDATE_ELEM: të përditësojmë/krijojmë vlerënBPF_MAP_DELETE_ELEM: të fshijmë çelësinBPF_MAP_GET_NEXT_KEY: të gjejmë çelësin e ardhshëm (ose të parin)BPF_MAP_GET_NEXT_ID: lejon kalimin nëpër të gjitha harta ekzistuese, kështu funksiononbpftool mapBPF_MAP_GET_FD_BY_ID: të hapim një hartë ekzistuese sipas ID-së së saj globaleBPF_MAP_LOOKUP_AND_DELETE_ELEM: të përditësojmë atomikisht vlerën e objektit dhe të kthejmë të vjetrënBPF_MAP_FREEZE: të bëjmë hartën të pandryshueshme nga hapësira e përdoruesit (kjo operacion nuk mund të anulohet)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: operacione masive. Për shembull,BPF_MAP_LOOKUP_AND_DELETE_BATCH— ky është mënyra e vetme e besueshme për të lexuar dhe resetuar të gjitha vlerat nga harta
Jo të gjitha këto komanda funksionojnë për të gjitha tipet e hartave, por në përgjithësi puna me lloje të tjera të hartave nga hapësira e përdoruesit duket kështu si puna me hesh-tabelat.
Për renditje, le të përfundojmë eksperimentet tona me hesh-tabelën. Mos harroni se krijuam një tabelë, në të cilën mund të ketë deri në katër çelësa? Le të shtojmë disa elemente të tjera:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Derisa çdo gjë po shkon mirë:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Gjetur 4 elemente
Le të përpiqemi të dytojmë edhe një tjetër:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Gabim: përditësimi dështoi: Lista e argumenteve është shumë e gjatë
Siç pritej, ne nuk arritëm. Le të shohim më afër gabimin:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Lista e argumenteve është shumë e gjatë)
Gabim: përditësimi dështoi: Lista e argumenteve është shumë e gjatë
+++ doli me 255 +++
Gjithçka është në rregull: siç pritej, komanda BPF_MAP_UPDATE_ELEM përpiquni të krijoni një çelës të ri, të pestë, por dështon me E2BIG.
Pra ndaj, ne dimë si të krijojmë dhe ngarkojmë programe BPF, si dhe si të krijojmë dhe menaxhojmë hartat nga hapësira e përdoruesit. Tani është logjikisht koha të shohim si mund të përdorim hartat nga vetë programet BPF. Mund të flasim për këtë në një gjuhë të vështirë për t'u lexuar, në makro-kodet e makinave, por në të vërtetë erdhi koha të tregojmë se si shkruhen dhe mbahen programet BPF në të vërtetë — duke përdorur libbpf.
(Për lexuesit që janë të pakënaqur me mungesën e një shembulli të nivelit të ulët: ne do të shqyrtojmë detajisht programet që përdorin hartat dhe funksionet ndihmëse të krijuara duke përdorur libbpf dhe do të tregojmë se çfarë ndodh në nivelin e instrukcioneve. Për lexuesit që janë të pakënaqur me shumë fort, ne kemi shtuar në vendin e duhur të artikullit.)
Shkruajmë programe BPF me libbpf.
Të shkruash programe BPF me kod makina mund të jetë interesante vetëm për një kohë të shkurtër, dhe pastaj vjen një pikë e ngopjes. Në këtë moment duhet të drejtojmë vëmendjen tonë në llvm, e cila ka një backend për gjenerimin e kodit për arkitekturën BPF, si dhe në bibliotekën libbpf, e cila lejon të shkruani pjesën e përdoruesit të aplikacioneve BPF dhe ngarkoni kodin e programeve BPF të gjeneruara duke përdorur llvm/clang.
Në të vërtetë, si do të shohim në këtë dhe artikujt e ardhshëm, libbpf bën një punë të madhe dhe pa të (ose mjete të ngjashme — iproute2, libbcc, libbpf-go, etj.) nuk është e mundur të jetosh. Një nga funksionet killer të projektit libbpf është BPF CO-RE (Compile Once, Run Everywhere) — një projekt që lejon të shkruhen programe BPF që janë të transferueshme nga një bërthamë në tjetrën, me mundësinë e ekzekutimit në API të ndryshme (p.sh. kur struktura e bërthamës ndryshon nga versioni në version). Për të qenë në gjendje të punoni me CO-RE, bërthama juaj duhet të jetë kompiliuar me mbështetje për BTF (si ta bëni këtë e shpjegojmë në seksionin . Të kontrolloni nëse bërthama juaj është kompiliuar me BTF ose jo, është shumë e lehtë — është shumica e pranishme e skedarit të mëposhtëm:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Ky skedar ruan informacionin mbi të gjitha llojet e të dhënave që përdoren në bërthamë dhe përdoret në të gjithë shembujt tanë që përdorin libbpf. Ne do të flasim në detaje për CO-RE në artikullin e ardhshëm, ndërsa në këtë — thjesht ndihmoni veten të ndërtoni një bërthamë me CONFIG_DEBUG_INFO_BTF.
Biblioteka libbpf jeton direkt në drejtorinë tools/lib/bpf të bërthamës dhe zhvillimi i saj bëhet përmes listës së postimeve bpf@vger.kernel.org. Megjithatë, për nevojat e aplikacioneve që jetojnë jashtë bërthamës, mbështetet një depo e veçantë ku biblioteka e bërthamës pasqyrohet për qasje leximi më shumë-më pak ashtu siç është.
Në këtë pjesë, do të shikojmë se si mund të krijojmë një projekt që përdor libbpf, do të shkruajmë disa (më shumë-më pak pa kuptim) programe testimi dhe do të shqyrtojmë në mënyrë të detajuar sesi funksionon gjithçka. Kjo do të na lejojë në pjesët e ardhshme të shpjegojmë më lehtë se si programet BPF ndërveprojnë me maps, ndihmësit e bërthamës, BTF, etj.
Zakoni projekti që përdorin libbpf shtojnë një depo nga GitHub si një git submodule, le të bëjmë edhe ne këtë:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Inicializuar depo të zbrazët Git në /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Duke klonuar në '/tmp/libbpf-example/libbpf'...
remote: Enumerating objects: 200, done.
remote: Counting objects: 100% (200/200), done.
remote: Compressing objects: 100% (103/103), done.
remote: Total 3354 (delta 101), reused 118 (delta 79), pack-reused 3154
Duke marrë objekte: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, done.
Zgjidhja e deltas: 100% (2176/2176), done.
Kompilohet libbpf shumë lehtë:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Plani ynë i mëtejshëm në këtë pjesë është si vjen: ne do të shkruajmë një program BPF të tipit BPF_PROG_TYPE_XDP, të njëjtin që kishim në shembullin e mëparshëm, por në C, do ta kompilojmë me clang, dhe do të shkruajmë një program ndihmës që do ta ngarkojë në bërthamë. Në pjesët e ardhshme ne do të zgjedhim mundësitë e si programit BPF, ashtu edhe programit ndihmës.
Shembulli: të krijojmë një aplikacion të plotë me libbpf
Fillimisht ne do të përdorim skedarin /sys/kernel/btf/vmlinux, për të cilin u përmend më parë, dhe do të krijojmë ekuivalentin e tij si një skedar titulli:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hKy skedar do të ruajë të gjitha strukturat e të dhënave që janë në bërthamën tonë, për shembull, kështu përcaktohet në bërthamë titulli IPv4:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Tani do të shkruajmë programin tonë BPF në gjuhën C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Edhe pse programi ynë është shumë i thjeshtë, gjithsesi duhet të kushtojmë vëmendje shumë detajeve. Së pari, skedari i parë i titullit që përfshijmë është vmlinux.h, i cili sapo e kemi gjeneruar me anë të bpftool btf dump — tani nuk kemi nevojë të instalojmë paketën kernel-headers për të ditur si duken strukturat e kernelit. Skedari tjetër i titullit vjen nga biblioteka libbpf. Aktualisht na nevojitet vetëm për t'u definuar makrosi SEC, i cili dërgon simbolin në seksionin përkatës të skedarit objekt ELF. Programi ynë ndodhet në seksionin xdp/simple, ku para shkronjës ndiqet lloji i programit BPF—kjo është një marrëveshje që përdoret në libbpf, sipas emrit të seksionit do të shënohet lloji i duhur gjatë ekzekutimit bpf(2). Programi BPF në C është shumë i thjeshtë dhe përbëhet nga një rresht return XDP_PASS. Në fund, një seksion i veçantë "license" përmban emrin e licencës.
Mund të kompilijmë programin tonë me anë të llvm/clang, versioni >= 10.0.0, më mirë akoma—më të lartë (shiko kapitullin ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Nga veçoritë interesante: ne specifikojmë arkitekturën e synuar -target bpf dhe rrugën drejt titujve libbpf, të cilat sapo i kemi instaluar. Gjithashtu, mos harroni për -O2, pa këtë opsion ju mund të përballeni me surpriza më vonë. Le të shikojmë kodin tonë, a e kemi shkruar programin që doja?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Po, ia arritëm! Tani, kemi një skedar binar me programin, dhe duam të krijojmë një aplikacion që do ta ngarkojë në kernel. Për këtë, biblioteka libbpf na ofron dy mundësi—të përdorim një API më të ulët ose një API më të lartë. Ne do të zgjedhim rrugën e dytë, pasi dëshirojmë të mësojmë si të shkruajmë, ngarkojmë dhe lidhemi me programet BPF me përpjekje minimale për studim të mëtejshëm.
Së pari, na nevojitet të gjenerojmë "skeletin" e programit tonë nga binari i tij me anë të po atij mjeti bpftool — mjera më e mirë e shumëllojshmërisë BPF (gjë që mund të kuptohet edhe në kuptimin literal, pasi Daniel Borkman është një nga krijuesit dhe mbajtësit e BPF — shqiptar):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hNë skedar xdp-simple.skel.h përmban kodin binar të programit tonë dhe funksionet për menaxhimin — ngarkimin, lidhjen, heqjen e objektit tonë. Në rastin tonë të thjeshtë, kjo duket si mbi-mundim, por funksionon dhe kur skedari objekt përmban shumë programe BPF dhe mapa, dhe për ngarkimin e këtij ELF gjigand, na mjafton të gjenerojmë një skelet dhe të thërrasim një ose dy funksione nga aplikacioni përdorues, për të cilin do të kalojmë tani.
Në të vërtetë, programi ynë ngarkues është i thjeshtë:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Këtu struct xdp_simple_bpf definohet në skedarin xdp-simple.skel.h dhe përshkruan skedarin tonë objekt:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Këtu mund të vëmë re shenjat e API-së së ulët: struktura struct bpf_program *simple dhe struct bpf_link *simple. Struktura e parë përshkruan saktësisht programin tonë, i shkruar në seksionin xdp/simple, ndërsa e dyta përshkruan se si programi lidhet me burimin e ngjarjeve.
Funksioni xdp_simple_bpf__open_and_load, hap skedarin ELF, e parse, krijon të gjitha strukturat dhe nën-strukturat (përveç programit, në ELF ndodhen edhe seksione të tjera — data, data e lexueshme, informacion për paraqitje, licencë etj.), dhe më pas ngarkohet në bërthamë përmes thirrjes së sistemit bpf, të cilin mund ta verifikojmë duke e kompaktuar dhe ekzekutuar programin:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Tani le të shikojmë programin tonë përmes bpftool. Të gjejmë ID-në e tij:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
dhe ta dumpojmë (ne përdorim formën e shkurtuar të komandës bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Diçka e re! Programi printoi copa të skedarit tonë burimor në gjuhën C. Kjo u realizua nga biblioteka libbpf, e cila gjeti seksionin e ndihmës në binar, e kompiloi atë në objekt BTF, e ngarkoi në bërthamë përmes BPF_BTF_LOAD, dhe pastaj tregoi deshifruesin e skedarit të fituar gjatë ngarkimit të programit me komandën BPG_PROG_LOAD.
Ndihmësit e Bërthamës
Programet BPF mund të ekzekutojnë funksione 'të jashtme' — ndihmës të kernelit. Këto funksione ndihmës lejojnë programet BPF të aksesojnë struktura të kernelit, menaxhojnë maps, si dhe të komunikojnë me 'botën reale' — të krijojnë ngjarje perf, të menaxhojnë pajisjet (p.sh., të shpërndajnë paketa) etj.
Shembuj: bpf_get_smp_processor_id
Në kuadër të paradigms 'mësojmë nga shembujt', le të shqyrtojmë një nga funksionet ndihmëse, bpf_get_smp_processor_id(), në skedarin kernel/bpf/helpers.c. Ajo kthen numrin e procesorit në të cilin ekzekutohet programi BPF që e thirri atë. Por ajo që na intereson më shumë është se implementimi i saj zë një rresht:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Kufizimet e funksioneve ndihmëse BPF janë të ngjashme me ata të thirrjeve sistemike në Linux. Këtu, për shembull, përcaktohet një funksion që nuk ka argumente. (Një funksion që merr, le të themi, tre argumente, përcaktohet duke përdorur makron BPF_CALL_3. Numri maksimal i argumenteve është pesë.) Megjithatë, kjo është vetëm pjesa e parë e përcaktimit. Pjesa e dytë përfshin përcaktimin e strukturës tipit struct bpf_func_proto, e cila përmban përshkrimin e funksionit ndihmës, të kuptueshëm për verifierin:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Regjistrimi i funksioneve ndihmëse
Për që programet BPF të një lloji të caktuar të mund të përdorin këtë funksion, ato duhet ta regjistrojnë atë, për shembull, për llojin BPF_PROG_TYPE_XDP në kernel përcaktohet funksioni xdp_func_proto, i cili përmes ID-së së funksionit ndihmës përcakton nëse XDP mbështet këtë funksion apo jo. Funksioni ynë :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Lloje të reja programesh BPF 'përcaktohen' në skedarin nëpërmjet makros BPF_PROG_TYPE. Përcaktimi është marrë në cita, pasi kjo është një përcaktim logjik, dhe në terma të gjuhës C, përcaktimi i një grupi të tërë strukturash specifike ndodh në vende të tjera. Konkretisht, në skedarin kernel/bpf/verifier.c të gjitha përcaktimet nga skedari bpf_types.h përdoren për të krijuar një array strukturash bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Pra të thoni, për çdo lloj programa BPF përcaktohet një tregues për një strukturë të dhënash të tipit struct bpf_verifier_ops, i cili inicializohet me vlerën _name ## _verifier_ops, dmth, xdp_verifier_ops për xdp. Struktura xdp_verifier_ops në skedarin net/core/filter.c në mënyrë të tillë:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Këtu e shohim funksionin tonë të njohur xdp_func_proto, i cili do të aktivizohet nga verifier çdo herë që ai takohet me një thirrje ndonjë funksioni brenda programit BPF, shihni. .
Le të shohim se si një program hipotetik BPF përdor funksionin bpf_get_smp_processor_id. Për këtë do të rishkruajmë programin nga seksioni ynë i mëparshëm si më poshtë:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Simboli bpf_get_smp_processor_id në <bpf/bpf_helper_defs.h> bibliotekës libbpf si
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;dmth, bpf_get_smp_processor_id — ky është një tregues për funksionin, vlera e të cilit është 8, ku 8 është vlera BPF_FUNC_get_smp_processor_id të tipit enum bpf_fun_id, e cila përcaktohet për ne në skedarin vmlinux.h (skedari bpf_helper_defs.h në bërthamë gjenerohet me një skript, kështu që numrat "magjikë" janë në rregull). Ky funksion nuk pranon argumente dhe kthen një vlerë të tipit __u32. Kur e ekzekutojmë në programin tonë, clang gjeneron një instruktion BPF_CALL "të saktë." Le të kompilohemi programin dhe të shohim seksionin xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       formati i skedarit elf64-bpf

Dekompilimi i seksionit xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 thirr 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 nëse r1 == 0 shko +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 dil
Në rreshtin e parë ne shohim instruktionin thirr, parametri IMM i cili është 8, dhe SRC_REG — zero. Sipas marrëveshjes ABI, që përdoret nga verifier, ky është thirrja për funksionin ndihmës me numrin tetë. Pas ekzekutimit të saj logjika është e thjeshtë. Vlera e kthyer nga regjistri r0 kopjohet në r1 dhe në rreshtat 2,3 konvertohet në tipin u32 — bitet e sipërme 32 janë zero. Në rreshtat 4,5,6,7 ne kthejmë 2 (XDP_PASS) ose 1 (XDP_DROP) në varësi të asaj që ktheu funksioni ndihmës nga rreshti 0, gjithsesi zero ose jo zero.
Le të kontrollojmë veten: ngarko programin dhe shiko rezultatin bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Mirë, verifier gjeti ndihmësin e duhur të kernelit.
Shembull: kalojmë argumentet dhe, më në fund, e fillojmë programin!
Të gjitha funksionet ndihmëse gjatë ekzekutimit kanë prototip
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Parametrat kalohen funksioneve ndihmëse në regjistra r1—r5, dhe vlera kthehet në regjistrin r0. Nuk ka funksione që pranojnë më shumë se pesë argumente - dhe mbështetje për to në të ardhmen nuk pritet.
Le të shohim ndihmësin e ri të kernelit dhe se si BPF kalon parametrat. Le të ri-shkruajmë xdp-simple.bpf.c në këtë mënyrë (rreshtat e tjerë nuk janë ndryshuar):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Programi ynë printon numrin e CPU-së, në të cilin është ekzekutuar. Le të kompilohet dhe të shohim kodin:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
Në rreshtat 0-7 ne shkruajmë në stack stringun running on CPU%un, dhe më pas në rreshtin 8 ekzekutojmë atë që e dimë bpf_get_smp_processor_id. Në rreshtat 9-12 ne përgatisim argumentet për ndihmësin bpf_printk — regjistrat r1, r2, r3. Pse janë tre, e jo dy? Sepse bpf_printk — rreth ndihmësit të vërtetë bpf_trace_printk, që kërkon që të kalojmë madhësinë e stringut formatues.
Le të shtojmë tani disa rreshta në xdp-simple.c, në mënyrë që programi ynë të lidhet me ndërfaqen lo dhe të ekzekutohet në të vërtetë!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Këtu ne përdorim funksionin bpf_set_link_xdp_fd, i cili lidhi programet BPF të tipit XDP me ndërfaqet rrjetësore. Ne e kemi koduar me dorë numrin e ndërfaqes lo, i cili gjithmonë është i barabartë me 1. Ne e aktivizojmë funksionin dy herë, për të shkëputur fillimisht programin e vjetër, nëse kishte qenë i lidhur. Vini re, tani nuk na nevojitet thirrja pause ose cikli infinit: programi ynë ngarkues do të mbyllet, por programi BPF nuk do të shkatërrohet, pasi është i lidhur me burimin e ngjarjeve. Pas ngarkimit të suksesshëm dhe lidhjes, programi do të ekzekutohet për çdo paketë rrjeti që vjen në lo.
Do të ngarkojmë programin dhe do të shikojmë në ndërfaqe lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  emri simple  etiketa 4fca62e77ccb43d6  gpl
$ ip l shiko dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue gjendja UNKNOWN mode DEFAULT grup default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Programi që ngarkuam ka ID 669 dhe të njëjtin ID e shohim në ndërfaqe lo. Do të dërgojmë disa paketa në 127.0.0.1 (kërkesë + përgjigje):
$ ping -c1 localhostdhe tani do të shikojmë përmbajtjen e skedarit virtual të debugging-ut /sys/kernel/debug/tracing/trace_pipe, në të cilin bpf_printk shkruan mesazhet e tij:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Dy paketa u vunë re në lo dhe u përpunuan në CPU0 — programi ynë i parë i plotë BPF punoi!
Vlen të theksohet se bpf_printk nuk e bën këtë kot në skedarin e debugging-ut: ky nuk është ndihmësi më i mirë për përdorim në production, por qëllimi ynë ishte të tregojmë diçka të thjeshtë.
Qasja në maps nga programet BPF
Shembuj: përdorim map nga programi BPF
Në seksionet e mëparshme, ne mësojmë të krijojmë dhe përdorim mapa nga hapësira e përdoruesit, tani do të shikojmë pjesën në bërthamë. Do të fillojmë, si zakonisht, me një shembull. Do ta rishkruajmë programin tonë xdp-simple.bpf.c në mënyrë të tillë:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Në fillim të programit kemi shtuar përkufizimin e mapës woo: ky është një array me 8 elemente, ku ruhen vlerat e tipit u64 (në C do ta përkufizonim këtë array si u64 woo[8]). Në programin "xdp/simple" ne marrim numrin e procesorit aktual në variablën key dhe pastaj me ndihmën e funksionit ndihmës bpf_map_lookup_element marrim një pointer në regjistrin përkatës në array, të cilin e rrisim me një. Në përkthimin e shqip: ne po numërojmë statistikën e cilit CPU iu përpunuan paketat e hyrjes. Le të përpiqemi të ekzekutojmë programin:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Le të kontrollojmë që ajo është lidhur me lo dhe dërgojmë disa paketa:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Tani po shikojmë përmbajtjen e masivit:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Gati të gjitha proceset u përpunuan në CPU7. Kjo nuk na përket, e rëndësishme është që programi punon dhe ne kuptuam si të qasel në hartat nga programet BPF — përmes .
Të dyshimtë tregues
Pra, ne mund të qasemi nga programi BPF në hartën përmes thirrjeve të tilla si
val = bpf_map_lookup_elem(&woo, &key);ku funksioni ndihmës duket si
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)por ne po kalojmë një tregues &woo në strukturën pa emër struct { ... }…
Nëse shikojmë në assembler-in e programit, do të shohim se vlera &woo në të vërtetë nuk është e përcaktuar (rreshti 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       formati i skedarit elf64-bpf

Zhvillimi i seksionit xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
dhe përmban në relokimet:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Seksioni i relokimit '.relxdp/simple' në offset 0xe18 përmban 1 hyrje:
    Offset             Info             Type               Vlera e Simbolit  Emri i Simbolit
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Por nëse shikojmë në programin që është ngarkuar, do të shohim një tregues në hartën e duhur (rreshti 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Kështu, ne mund të arrijmë në përfundimin se në momentin e ekzekutimit të programit tonë ngarkues, referenca në &woo u zëvendësua nga biblioteka libbpf. Fillimisht do të shikojmë në daljen strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Ne shohim se libbpf krijoi një hartë woo dhe pastaj ngarkoi programin tonë simple. Le të shikojmë më me kujdes se si e ngarkojmë programin:
- thërrasim
xdp_simple_bpf__open_and_loadnga skedarixdp-simple.skel.h - i cili thërret
xdp_simple_bpf__loadnga skedarixdp-simple.skel.h - i cili thërret
bpf_object__load_skeletonnga skedarilibbpf/src/libbpf.c - i cili thërret
bpf_object__load_xattrngalibbpf/src/libbpf.c
Funksioni i fundit, përveç të gjitha, do të thërrasë bpf_object__create_maps, e cila krijon ose hap ekzistuese maps, duke i kthyer ato në dëshmitë e skedarëve. (Këtu është vendi ku ne shohim BPF_MAP_CREATE në daljen strace.) Më pas thirret funksioni bpf_object__relocate dhe ky është interesanti për ne, sepse kujtojmë se kemi parë woo në tabelën e relokimeve. Duke e shqyrtuar, ne përfundojmë tek funksioni bpf_program__relocate, i cili :
rasi RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Prandaj, ne marrim instruksionin tonë
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 lldhe e zëvendësojmë regjistrin burimor me BPF_PSEUDO_MAP_FD, dhe IMM-në e parë me dëshmitë e skedarëve të mapit tonë, dhe, sikur të ishte p.sh., 0xdeadbeef, atëherë rezultati do të ishte instruksioni
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llKështu informata për mapat kalon në programin konkret të ngarkuar BPF. Ndërkohë, mapa mund të jetë krijuar me BPF_MAP_CREATE, ose të hapet me ID përmes BPF_MAP_GET_FD_BY_ID.
Përfundimisht, me përdorimin e libbpf algoritmi është si më poshtë:
- gjatë kompilimit për referencat në mapa krijohen regjistrime në tabelën e relokimit
libbpfhap objekti ELF, gjen të gjitha mapat e përdorura dhe krijon për to dëshmitë e skedarëve- dëshmitë e skedarëve ngarkohen në bërthamë si pjesë e instruksionit
LD64
Ashtu siç e kuptoni, kjo nuk është e gjitha, dhe do të duhet të hedhim një sy në bërthamë. Fatmirësisht, kemi një gjurmë — kemi shkruar vlerën BPF_PSEUDO_MAP_FD në regjistrin burimor dhe mund ta shqyrtojmë, gjë që do të na çojë në vendin më të shenjtë të të gjithëve — kernel/bpf/verifier.c, ku funksioni me emrin karakteristik zëvendëson dëshminë e skedarit me adresën e strukturës së tipit struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(Kodi i plotë mund të gjendet ). Pra, mund të plotësojmë algoritmin tonë:
- gjatë ngarkimit të programit, verifikuesi kontrollon saktësinë e përdorimit të mapës dhe shkruan adresën e strukturës përkatëse
struct bpf_map
Kur ngarkohet binari ELF përmes libbpf ndodhin shumë ngjarje të tjera, por ne do t'i diskutojmë ato në kuadër të artikujve të tjerë.
Ngarko programet dhe mapat pa libbpf
Ashtu siç ishte e premtuar, ja një shembull për lexuesit që dëshirojnë të dinë si të krijojnë dhe ngarkojnë një program që përdor mapa, pa ndihmën libbpf. Kjo mund të jetë e dobishme kur punoni në një ambient ku nuk mund të grumbulloni varësi, ose kurseni çdo bit, ose shkruani një program si , i cili gjeneron kodin binar BPF në fluturim.
Për t'u ndjekur më lehtë logjika, ne për këto qëllime do ta riparojmë shembullin tonë xdp-simple. Kodi i plotë dhe pak më i zgjeruar i programit, i shqyrtuar në këtë shembull, mund të gjendet në këtë .
Logjika e aplikacionit tonë është si vijon:
- të krijojmë një hartë të tipit
BPF_MAP_TYPE_ARRAYme komandënBPF_MAP_CREATE, - të krijojmë një program që përdor këtë hartë,
- të lidhim programin me ndërfaqen
lo,
çka përkthehet në gjuhën njerëzore si
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Këtu map_create krijon një hartë po ashtu siç e kemi bërë në shembullin e parë mbi thirrjen e sistemit bpf — "në bërthamë, të lutem, më krijo një hartë si një array me 8 elemente të tipit __u64 dhe më kthe një deshkrim të dosjes":
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Programi gjithashtu ngarkohet lehtësisht:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Pjesa e komplikuarë prog_load është definimi i programit tonë BPF si një array strukturash struct bpf_insn insns[]. Por pasi përdorim programin që kemi në C, mund të jemi pak të zgjuar:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Pra, na nevojitet të shkruajmë 14 instruksione si struktura të tipit struct bpf_insn (këshillë: merrni dump-in lart, rishikoni seksionin për udhëzime, hapni dhe dhe provoni të përcaktoni struct bpf_insn insns[] vetë):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 thirr 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* vendi i lirë */

    /* 85 00 00 00 01 00 00 00 thirr 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 nëse r0 == 0 shko +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 dilni */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Një ushtrim për ata që nuk e shkruan vetë këtë – gjeni map_fd.
Në programin tonë ka mbetur një pjesë tjetër e papërfunduar – xdp_attach. Fatkeqësisht, programet e tipit XDP nuk mund të lidhen përmes thirrjeve të sistemit bpf. Njerëzit që krijuan BPF dhe XDP ishin nga komuniteti rrjetor i Linux, prandaj ata përdorën ndërfaqen më të njohur për ta (por jo për njerezit e zakonshëm ) për të ndërvepruar me kernelin: , shih gjithashtu . Mënyra më e lehtë për ta zbatuar xdp_attach është kopjimi i kodit nga libbpf, konkretisht, nga skedari , të cilin ne e kemi ndjekur, paksa duke e shkurtruar atë:
Mirë se vini në botën e netlink sockets
Hapni netlink socket tipin NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink error reporting not supported");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Lexojmë nga ky soket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "wrong pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); too many code to copy...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Së fundi, ja funksioni ynë që hap soketin dhe dërgon në të një mesazh të veçantë, që përmban një deshifrues skedari:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Kështu, gjithçka është gati për testim:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Le të shohim nëse programi ynë është lidhur me lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Do t'i dërgojmë ping dhe do të shohim në hartë:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Gjetur 8 elemente
Ura, gjithçka funksionon. Vini re, gjithashtu, se harta jonë sërish paraqitet në formë bajtësh. Kjo ndodh sepse, ndryshe nga libbpf ne nuk kemi ngarkuar informacionin mbi llojet (BTF). Por për këtë do të flasim më në detaje herën tjetër.
Mjetet e zhvillimit
Në këtë seksion, do të shohim setin minimal të veglave për zhvilluesit BPF.
Në të vërtetë, për të zhvilluar programe BPF nuk nevojitet asgjë e veçantë — BPF funksionon në çdo kernel të njohur të distirbutit, dhe programet kompilohet përmes clang, i cili mund të vendoset nga paketa. Megjithatë, për shkak se BPF është në proces zhvillimi, blloku dhe mjetet ndryshojnë vazhdimisht; nëse nuk dëshiron të shkruash programe BPF në mënyrat e vjetra nga vitet 2019, do të duhet ta ndërtosh
llvm/clangpahole- në bllokun tënd
bpftool
(Për referencë: kjo seksion dhe të gjithë shembujt në artikull u ekzekutuan në Debian 10.)
llvm/clang
BPF punon mirë me LLVM dhe, megjithëse kohët e fundit programet për BPF mund të kompilohen edhe me gcc, e gjithë zhvillimi i tanishëm po bëhet për LLVM. Prandaj, fillimisht ne do të ndërtoshim versionin aktual clang nga git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... shumë kohë më vonë
$
Tani mund të kontrollojmë nëse gjithçka është ndërtuar si duhet:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  LLVM version 11.0.0git
  Ndërtimi i optimizuar.
  Objektivi i paracaktuar: x86_64-unknown-linux-gnu
  CPU host: znver1

  Objektivat e regjistruar:
    bpf    - BPF (endi i hostit)
    bpfeb  - BPF (endi i madh)
    bpfel  - BPF (endi i vogël)
    x86    - X86 32-bit: Pentium-Pro dhe më lart
    x86-64 - X86 64-bit: EM64T dhe AMD64
(Udhëzimi për ndërtimin clang i marrë nga .)
Ne nuk do të instalojmë programet e sapo ndërtuara, por përkundrazi thjesht do t'i shtojmë ato në për, për shembull:
export PATH="`pwd`/bin:$PATH"(Kjo mund të shtohet në .bashrc ose në një skedë të veçantë. Personalish, unë shtoj këto gjëra në ~/bin/activate-llvm.sh dhe kur është e nevojshme bëj . activate-llvm.sh.)
Pahole dhe BTF
Mjeti pahole përdoret gjatë ndërtimit të bllokut për të krijuar informacionin e ndihmës në formatin BTF. Ne nuk do të shkojmë në detaje të teknologjisë BTF në këtë artikull, përveç faktit që është e përshtatshme dhe ne duam ta përdorim atë. Prandaj, nëse po planifikoni të ndërtosh bllokun tënd, ndihmoni që të ndërtosh së pari pahole (pa pahole nuk do të jesh në gjendje të ndërtosh bllokun me opsionin CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Blloqe për eksperimente me BPF
Në shqyrtimin e mundësive të BPF, dëshiron të ndërtohësh bërthamën tënde. Kjo nuk është e domosdoshme, sepse mund të ndërtohesh dhe ngarkosh programe BPF edhe me bërthamën e shpërndarjes, megjithatë, të pasosh bërthamën tënde të lejon të përdorësh mundësitë më të reja të BPF, të cilat do të bëhen të disponueshme në shpërndarjen tënde, në më të mirën e rastit, pas disa muajsh ose, si në rastin e disa mjeteve për debuggim, nuk do të paketohen fare në një të ardhme të dukshme. Gjithashtu, bërthama e jotja të lejon të ndihesh e rëndësishme duke eksperimetuar me kodin.
Për të ndërtuar bërthamën, nevojitet, së pari, vetë bërthama dhe, së dyti, skedari i konfigurimit të bërthamës. Për eksperimente me BPF, mund të përdorim ose një nga bërthamat zhvillimore. Historikisht, zhvillimi i BPF ndodh brenda komunitetit rrjetor të Linux dhe kështu që të gjitha ndryshimet kalojnë, herët ose vonë, përmes David Miller — mbajtësit të pjesës rrjetore të Linux. Në varësi të natyrës së saj — rregullimi ose karakteristika të reja — ndryshimet rrjetore përfshihen në njërën nga dy bërthamat — ose . Ndryshimet për BPF po ashtu shpërndahen mes dhe , të cilat më pas transferohen në net dhe net-next, përkatësisht. Shihni më shumë në dhe . Prandaj, zgjidhni bërthamën në përputhje me preferencat dhe nevojat tuaja për stabilitetin e sistemit ku po testoni (*-next bërthamat janë më të paqëndrueshmet nga ato që janë përmendur).
Ky artikull nuk përfshin histori mbi si të menaxhoni skedarët e konfigurimit të bërthamës — supozohet që ju tashmë e dini këtë ose vetë. Megjithatë, udhëzimet e mëposhtme duhet të jenë, më shumë ose më pak, të mjaftueshme që ju të keni një sistem funksional me mbështetje për BPF.
Shkarkoni një nga bërthamat e përmendura më sipër:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Ndërto një konfigurim minimal të punueshmërisë së bërthamës:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Aktivizoni opsionet BPF në skedarin .config sipër zgjedhjes suaj (shumë mund të jetë se vetë CONFIG_BPF do të jetë tashmë aktivizuar, pasi përdoresh nga systemd). Këtu është lista e opsioneve nga bërthama që është përdorur për këtë artikull:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Pastaj mund të mbledhim dhe instalojmë lehtësisht modul dhe kernel (me rastin, mund ta mbledhim kernel-in duke përdorur atë që sapo u mbledh) clang, duke shtuar CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
dhe rinisni me kernel-in e ri (unë e përdor për këtë kexec nga paketa kexec-tools):
v=5.8.0-rc6+ # nëse po rimbledhni kernel-in aktual, mund të bëni v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
Utliliti më i përdorur në këtë artikull do të jetë utiliti bpftool, i ofruar si pjesë e kernel-it Linux. Ai është shkruar dhe mbështetur nga zhvilluesit e BPF për zhvilluesit e BPF dhe me të mund të menaxhoni të gjitha llojet e objekteve BPF — ngarkoni programe, krijoni dhe ndryshoni mapa, shqyrtoni aktivitetin e ekosistemit BPF, etj. Dokumentacionin në formën e burimeve për man pages mund ta gjeni ose, tashmë të kompiluar, .
Në momentin që po shkruhet ky artikull bpftool ofrohet në formë të gatshme vetëm për RHEL, Fedora dhe Ubuntu (shihni, për shembull, , në të cilin flitet për historinë e papërfunduar të paketimit bpftool në Debian). Por nëse tashmë keni mbledhur kernel-in tuaj, atëherë ta mbledhni bpftool është shumë e lehtë:
$ cd ${linux}/tools/bpf/bpftool
# ... shkruani rrugët e clang të fundit, siç është treguar më sipër
$ make -s

Auto-detecting system features:
...                        libbfd: [ on  ]
...        disassembler-four-args: [ on  ]
...                          zlib: [ on  ]
...                        libcap: [ on  ]
...               clang-bpf-co-re: [ on  ]

Auto-detecting system features:
...                        libelf: [ on  ]
...                          zlib: [ on  ]
...                           bpf: [ on  ]

$
(këtu ${linux} — është direktoria juaj me kernel-in). Pas ekzekutimit të këtyre komandave bpftool do të mbledhet në direktorinë ${linux}/tools/bpf/bpftool dhe mund ta shtoni në rrugë (përpara se gjithash user root) ose thjesht ta kopjoni në /usr/local/sbin.
Më mirë është ta mbledhni me versionin më të fundit bpftool , e mbledhur, siç është treguar më sipër, dhe ta kontrolloni nëse është mbledhur saktë — duke përdorur, për shembull, komandën clang$ sudo bpftool feature probe kernel Scanning system configuration... bpf() syscall for unprivileged users is enabled JIT compiler is enabled JIT compiler hardening is disabled JIT compiler kallsyms exports are enabled for root ...
e cila do të tregojë cilat karakteristika BPF janë të aktivizuara në kernel-in tuaj.Për më tepër, komandën paraprake mund ta ekzekutoni si
Kjo është bërë në mënyrë analogjike me utilitetet nga paketa
# bpftool f p kKjo është bërë në bazë të analogjisë me utilitat nga paketa iproute2, ku mund të themi, për shembull, ip a s eth0 në vend të ip addr show dev eth0.
Përfundim
BPF lejon që një bletë të masë efektivisht dhe të ndryshojë funksionalitetin e kernelit në fluturim. Sistema rezultoi shumë e suksesshme, në traditat më të mira të UNIX: një mekanizëm i thjeshtë, që lejon (rindërtimin) e kernelit, u dha mundësinë një numri të madh njerëzish dhe organizatash të eksperimentojnë. Dhe, ndonëse eksperimentet, ashtu si zhvillimi i infrastrukturës BPF, ende nuk kanë përfunduar, sistemi tashmë ka një ABI të qëndrueshme që lejon ndërtimin e një logjike biznesi të besueshme e, më e rëndësishmja, efektive.
Dua të theksoj se, sipas mendimit tim, teknologjia u bë kaq e njohur sepse, nga njëra anë, mund të luajë (arkitektura e makinës mund të kuptohet më shumë ose më pak brenda një mbrëmjeje), dhe nga ana tjetër — të zgjidhë probleme, që nuk mund të zgjidhen (bukur) para shfaqjes së saj. Këto dy komponente së bashku e nxisin njerëzit të eksperimentojnë dhe të ëndërrojnë, gjë që çon në shfaqjen e zgjidhjeve inovative të reja e më të reja.
Ky artikull, edhe pse nuk është shumë i shkurtër, është vetëm një hyrje në botën e BPF dhe nuk përshkruan "mundësitë e avancuara" dhe pjesët e rëndësishme të arkitekturës. Plani i mëtejshëm është, përafërsisht, kështu: artikulli i ardhshëm do të jetë një përmbledhje e llojeve të programeve BPF (në kernelin 5.8 përkrah 30 lloje programesh), atëherë përfundimisht do të shohim se si të shkruajmë aplikacione reale në BPF përmes programeve për gjurmimin e kernelit, pastaj do të vijë koha për një kurs më të thelluar mbi arkitekturën BPF, e pastaj — për shembuj të aplikacioneve BPF në rrjet dhe siguri.
Artikujt e mëparshëm të këtij cikli
Linket
— dokumentacioni për BPF nga cilium, më saktësisht nga Daniel Borkman, njëri nga krijuesit dhe mirëmbajtësit e BPF. Kjo është një nga përshkrimet e para serioze, që dallohet nga të tjerat për faktin se Daniel e di saktësisht për çfarë po shkruan dhe nuk ka gabime aty. Në veçanti, në këtë dokument shpjegohet si të punoni me programet BPF të llojeve XDP dhe TC duke përdorur utilitarin e njohur
ipnga paketaiproute2.— dokumenti origjinal me dokumentacionin për BPF klasik, dhe pastaj për BPF të zgjeruar. E dobishme për t'u lexuar, nëse dëshironi të hidhni një vështrim në asamblin dhe detajet teknike të arkitekturës.
. Rreth aktualizohet rrallë, por me precizitet, pasi aty shkruajnë Alexei Starovoitov (autori i eBPF) dhe Andrii Nakryiko — (mirëmbajtës
libbpf).. Një thread i interesant në Twitter nga Quentin Monnet me shembuj dhe sekrete për përdorimin e bpftool.
. Një listë gjigante (dhe akoma e mbështetur) e lidhjeve në dokumentacionin mbi BPF nga Quentin Monnet.
Burimi: habr.com
