

Kapaciteti Tier (ose siç e quajmë brenda vetes - kaptir) u shfaq që në kohën e Veeam Backup dhe Replication 9.5 Update 4 me emrin Archive Tier. Ideja pas këtij është të mundësojë zhvendosjen e kopjeve rezervë që kanë dalë jashtë dritares operacionale të rikuperimit në magazinat objektive. Kjo ndihmonte në lirimin e hapësirës diskore për ata përdorues që kishin hapësirë të kufizuar. Kjo opsion quhet Move Mode.
Për të realizuar këtë veprim të thjeshtë (siç duket) mjaftonte të përmbusheshin dy kushte: të gjitha pikat nga kopja rezervë e zhvendosur duhet të ishin jashtë dritares së rikuperimit operacional, e cila është e specifikuar qartë në UI. E dyta: zinxhiri duhet të jetë në një "formë të vulosur" (sealed backup chain ose Inactive Backup Chain). Kjo do të thotë se me kalimin e kohës në këtë zinxhir nuk ndodhin ndryshime.
Por në VBR v10 koncepti u pasurua me funksione të reja - u shfaqën Copy Mode, Sealed Mode dhe një gjë me një emër të vështirë për tu thënë Immutability.
Këto gjëra interesante ne do të diskutojmë sot. Fillimisht për atë se si funksiononte në VBR9.5u4, dhe pastaj për ndryshimet në versionin e dhjetë.
Dhe le të më falin ata që mbrojnë gjuhën e pastër, por shumë terma nuk mund të përkthehen.
Pra, këtu do të ketë shumë anglicizma.
Dhe shumë gif-e.
Dhe imazhe.
- Pa asnjë keqardhje. Autori i artikullit.
Si ishte
Pra, le të fillojmë me analizën e dritares operative të rikuperimit dhe backup-it të vulosur (ose siqu quhen në dokumentacion Inactive Backup Chain). Pa kuptuar ato, nuk mund të shpjegohet më tej.
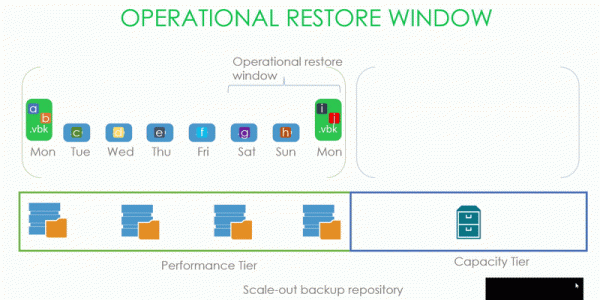
Siç e shohim në figurë, kemi një zinxhir rezervë me blloqe të dhënash, i cili ndodhet në Performance tier të repositorit SOBR, ku është lidhur Kapaciteti Tier. Dritarja jonë operacionale e rezervimit është e barabartë me tre ditë.
Kështu, një .vbk e krijuar të hënën vulos zinxhirin e mëparshëm, dritarja e të cilit është vendosur në tre ditë. Dhe, pra, mund të fillojmë paq pastrimin në kapacitetin tier të gjitha ato që janë më të vjetra se këto tri ditë.
Por çfarë do të thoshte pikërisht një zinxhir i vulosur dhe çfarë mund të dërgohej në kapacitetin tier në update 4?
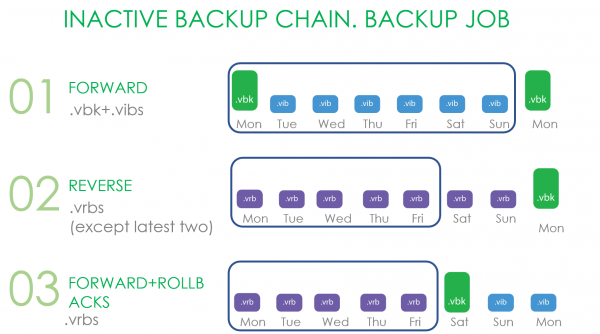
Për Forward Incremental, treguesi i vulosjes së zinxhirit është krijimi i një backup-i të plotë të ri. Dhe nuk ka rëndësi se si merret ky backup i plotë: konsiderohet si backup i plotë sintetik dhe backup i plotë aktiv.
Në rastin e Reverse, këto janë të gjitha skedarët që nuk bien në dritaren operacionale.
Në rastin e Forward increment me rrotullime, të gjitha rrotullimet dhe .vbk, nëse në kapacitetin e performancës ka edhe një tjetër .vbk.
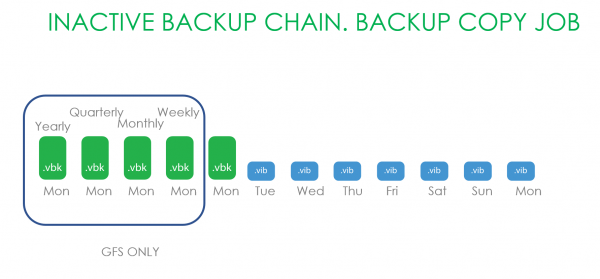
Tani le të shqyrtojmë opsionin e punës me zinxhirët e Backup Copy. Këtu është ruajtur vetëm ajo që përfshin ruajtjen GFS. Sepse gjithçka që ndodhet në zinxhirët më të rinj të backup copy mund të jetë ndonjëherë e ndryshuar në një mënyrë ose në një tjetër.
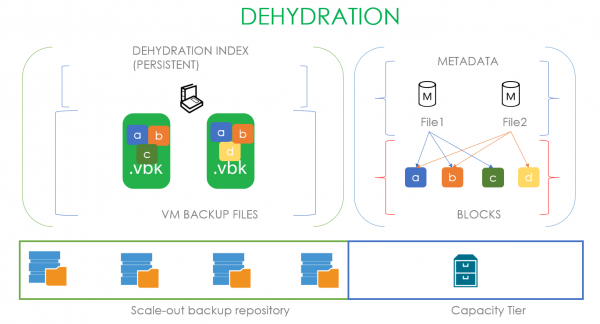
Tani le të shohim nën kapak. Atje ndodh një proces i quajtur dehidrim - lënia e qëndrushmeve të skedarëve të backup në kapacitet dhe zhvendosja e blloqeve nga këta skedarë në rezervat e kapacitetit. Për të optimizuar këtë proces, përdoret një indeks i ashtuquajtur dehidrimi, i cili lejon që të mos kopjohen blloqet që janë kopjuar tashmë në rezervat e kapacitetit.
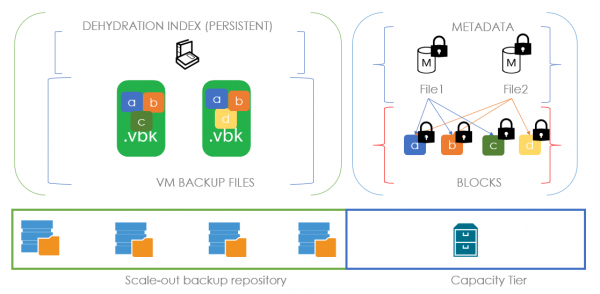
Le të shohim si duket kjo në një shembull: supozoni se kemi një .vbk, që ka dalë nga fushëpamja operacionale dhe i përket një zinxhiri të vulosur. Kështu, ne kemi të drejtë ta transferojmë atë në rezervat e kapacitetit. Në momentin e zhvendosjes krijohet një skedar metadata në rezervën e kapacitetit dhe blloqet e skedarit të transferuar. Në skedarin e metadatas në nivelin e lidhjeve përshkruhet nga cilat blloqe përbëhet skedari ynë. Në rastin në figurë, skedari ynë i parë përbëhet nga blloqet a, b, c dhe në metadat e vendosura janë lidhjet për këto blloqe. Kur kemi një skedar të dytë .vbk, gati për t'u zhvendosur dhe i përbërë nga blloqet a, b dhe d, ne, duke analizuar indeksin e dehidrimit, kuptojmë se duhet të transferojmë vetëm bllokun d. Skedari i tij i metadatas do të përmbajë lidhjet për dy blloqet e mëparshme dhe një të re.
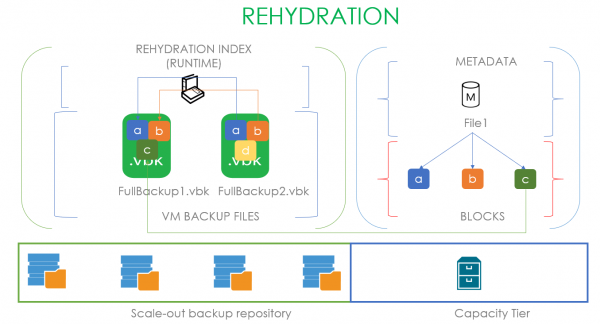
Për këtë arsye, procesi i mbushjes së këtyre qëndrushmeve me të dhëna quhet rehidrimi. Këtu përdoret një indeks i vetë rehidrimit, i mbështetur në skedarin më të vjetër .vbk në kapacitetin e performancës lokale. Kështu, nëse një përdorues dëshiron të rikthejë një skedar nga rezervat e kapacitetit, ne fillimisht krijojmë një indeks blloqesh të backup-it më të plotë të vjetër dhe zhvendosim nga rezervat e kapacitetit vetëm blloqet e munguar. Në rastin e paraqitur në figurë, për të rehidratuar FullBackup1.vbk sipas indeksit të rehidrimit na mungon vetëm blloku C, të cilin e marrim nga rezervat e kapacitetit. Nëse si rezervë kapaciteti shërben një objekt blerjeje në re, kjo lejon kursimin e një shume të madhe parash.
Këtu mund të duket se kjo teknologji është identike me atë që përdoret në WAN Accelerators, por kjo është vetëm një iluzion. Në akseleratorë, deduplikimi është global, ndërsa këtu përdoret lokal në kuadër të çdo faili në një offset të caktuar. Kjo ndodh për shkak të ndryshimit të detyrave që zgjidhim: këtu na nevojitet të kopjojmë skedarë të mëdhenj të backup-eve të plota, dhe sipas kërkimeve tona, madje edhe nëse kalon një periudhë e madhe kohe mes tyre, një algoritëm i tillë i deduplikimit ofron rezultatet më të mira.
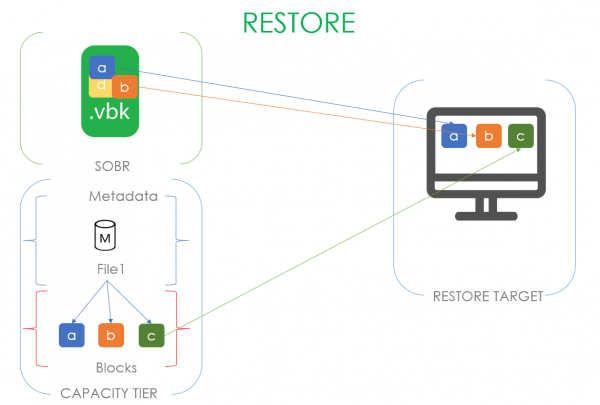
Por më shumë indekse Zotit indekseve! Ka edhe një indeks për rikuperimin e të dhënave! Kur ne fillojmë rikuperimin e një makine të vendosur në kapacitetin e rezervuarit, atëherë do të lexojmë vetëm blloqet unike të të dhënave, të cilat nuk gjenden në rezervuarin e performancës.
Siç u bë
Këtu përfundon pjesa hyrëse. Ajo është mjaft e detajuar, por, siç u tha më parë, pa këto detaje nuk mund të shpjegojmë se si funksionojnë tiparet e reja. Prandaj, pa asnjë parathënie, kalojmë në të parën.
Mënyra kopjimi
Në shumë aspekte bazohet në teknologjitë ekzistuese, megjithatë sjell një logjikë krejtësisht tjetër përdorimi.
Qëllimi i këtij mode është të sigurojë që të gjitha të dhënat e vendosura në ekstentin lokal të kenë një kopje në kapacitetin e rezervuarit.
Nëse e krahasojmë në mënyrë të drejtpërdrejtë mënyrat Move dhe Copy, do të rezultonte kështu:
- Mund të lëvizni vetëm zinxhirin e vulosur. Në rastin e mënyrës së kopjimit, transportohet krejtësisht gjithçka, pavarësisht nga ajo që ndodh në punën e backup-it.
- Lëvizja aktivizohet kur skedarët dalin jashtë dritares operacionale të backup-it, ndërsa kopjimi aktivizohet menjëherë sapo shfaqet skedari i backup-it.
- Ndjekja e të dhënave të reja për kopjim ndodh vazhdimisht, ndërsa për lëvizje aktivizohej një herë në 4 orë.
Duke shqyrtuar mënyrën e re, propozoj të shkojmë nga shembujt e thjeshtë te ata më të komplikuar.
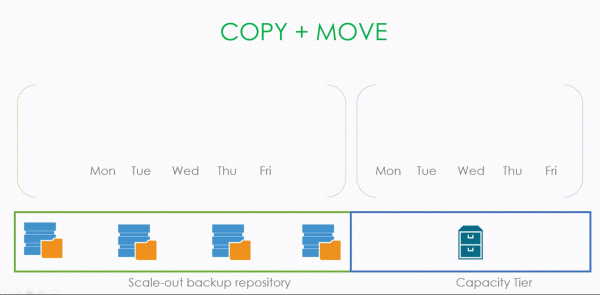
Në rastin më të zakonshëm, thjesht shfaqen skedarë të rinj me inkrementet dhe ne thjesht i kopjojmë ato në kapacitetin e rezervuarit. Pa marrë parasysh se cila mënyrë përdoret në punën e backup-it, pa marrë parasysh nëse i përket pjesës së vulosur të zinxhirit apo jo, pa marrë parasysh nëse ka skaduar dritarja jonë operative. Thjesht morëm dhe kopjuam.
Procesi që qëndron pas kësaj është ende dehidrimi ashtu siç është përshkruar më sipër. Në modalitetin e kopjimit, ai gjithashtu ndjek që të mos kopjojmë blloqet që tashmë janë në storage-in tonë. Diferenca e vetme është që në modalitetin e lëvizjes ne zëvendësonim skedarët realë me skedarë zbrazët, ndërsa këtu ne nuk i prekim fare dhe e lëmë gjithçka siç është. Përndryshe, ky është një indeks i tillë dehidrimi, i cili përpiqet me kujdes të kursejë paratë dhe kohën tuaj.
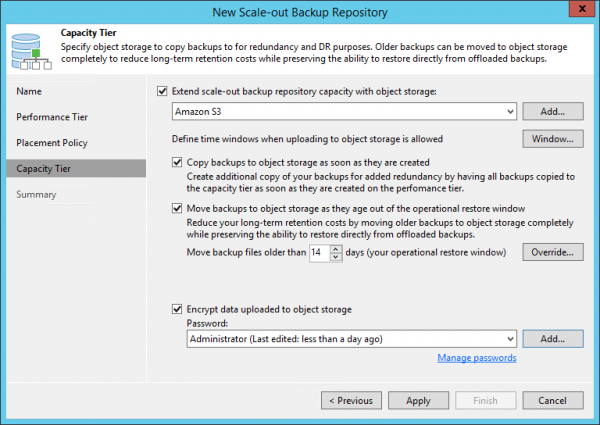
Shqetësimi që lind është — nëse shohim në UI, aty ka mundësinë për të zgjedhur të dy opsionet njëkohësisht. Si do të funksionojë një modalitet i tillë i kombinuar?
Le të merremi me këtë.
Fillimi është standard: krijohet një skedar backup dhe menjëherë kopjohet. Shkruhet një inkrement dhe gjithashtu kopjohet. Kjo ndodh deri në momentin kur kuptojmë se skedarët kanë dalë nga dritarja jonë operacionale dhe ka një zinxhir të vulosur. Në këtë moment, ne kryejmë operacionin e dehidrimit dhe zëvendësojmë këta skedarë me zbrazët. Natyrisht, nuk kopjojmë përsëri asgjë në kapacitetin e tir.
Për gjithë këtë logjikë emocionuese përgjigjen vetëm një shenjë në ndërfaqe: Copy backups to object storage as soon as they are created.
Por pse na nevojitet ky modalitet Kopjimi?
Madje është më mirë ta riformulojmë pyetjen kështu — nga cilat rreziqe po na mbrojnë me ndihmën e tij? Çfarë problemi na ndihmon të zgjidhim?
Përgjigjja është e qartë: sigurisht, është rikuperimi i të dhënave. Nëse në object storage kemi një kopje të plotë të të dhënave lokale, nuk ka rëndësi se çfarë ndodh me prodhimin tonë, ne gjithmonë mund të rikuperojmë të dhënat nga skedarët që ndodhen në një Amazon të kushtuar.
Prandaj, le të shqyrtojmë skenarët e mundshëm, nga më të thjeshtët deri te më të ndërlikuarit.
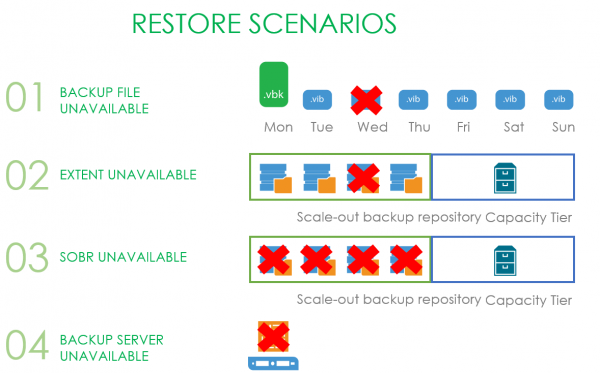
Shtypja më e thjeshtë që mund të na bjerë është pamundësia e njërit nga skedarët në zinxhirin e backupeve.
Një histori më e trishtueshme — na është thyer një nga ekstentët e repository-t tonë SOBR.
Akoma më keq bëhet kur i gjithë repository SOBR bëhet i pamundur, por kapaciteti i tir vazhdon të funksionojë.
Dhe gjithçka është shumë keq — është kur serveri backup vdes dhe dëshira juaj e parë është të provoni të arrini kufirin e Kanadasë brenda dhjetë minutash.
Dhe tani le të shqyrtojmë çdo situatë veçmas.
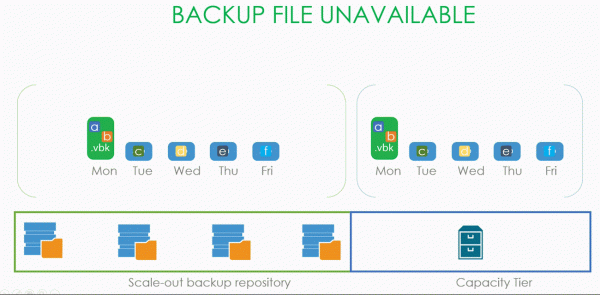
Kur ne humbëm një (po le të jetë, madje disa) skedarë backup, na mjafton të fillojmë procesin e skanimit të magazinës, dhe skedari i humbur do të zëvendësohet me një skedar të zbrazët. Dhe me ndihmën e procesit të rigjenerimit (për të cilin u fol në fillim të artikullit), përdoruesi do të jetë në gjendje të shkarkojë të dhënat nga kapaciteti i pirgusit në magazinën lokale.
Tani situata është më e komplikuar. Supozojmë se SOBR-i ynë përbëhet nga dy ekstensione që punojnë në modin Performance, dhe kështu, .vbk dhe .vib janë shpërndarë mbi to në një shtresë mjaft të paekuilibruar. Dhe në një moment, një nga ekstensat bëhet i paaksesueshëm, dhe përdoruesit i nevojitet urgjentisht të rikthejë makinën, një pjesë të të dhënave të së cilës qëndron pikërisht në këtë ekstens.
Përdoruesi fillon wizard-in e rikthimit, zgjedh pikën në të cilën dëshiron të rikthejë, ndërsa wizard-i gjatë procesit arrin në përfundimin se nuk ka të dhëna të nevojshme për rikthim lokal, dhe prandaj ato duhet shkarkuar nga kapaciteti i pirgusit. Në këtë rast, blloqet që mbeten në magazinën lokale nuk do të shkarkohen nga re. Falë indeksit të rikthimit (po, për të u fol gjithashtu në fillim të artikullit).
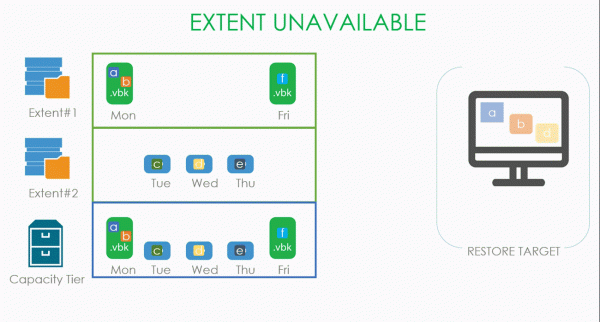
Një nënvariant i këtij rasti është që e gjithë magazina SOBR bëhet e paaksesueshme. Në këtë rast, nuk kemi çfarë të kopjojmë nga magazinat lokale, dhe të gjithë blloqet shkarkohen nga re.
Dhe situata më interesante është kur serveri i backup-it vdes. Këtu ka dy mundësi: admini është i shkëlqyer dhe ka bërë backup dhe admini është një Pinokio i keq që nuk ka bërë një backup të konfigurimit.
Në rastin e parë, mjafton që ai të shpërndajë diku një instalim të pastër të VBR dhe të rikthejë bazën e tij nga backup-i me mjetet standarde. Në përfundim të këtij procesi, gjithçka do të kthehet në normalitet. Ose do të rikthehet sipas një nga skenarët e mësipërm.
Por çfarëdo admini, ose nëse ai vetë është armiku i tij, ose nëse backup-i i konfiguracionit përjetoi një dështim legjendar, ne nuk do ta lëmë atë në mëshirën e fatit. Për këtë rast, ne kemi futur një procedurë të re, e cila quhet Import Object Storage. Kjo lejon të anashkalojmë procesin e rikrijimit manual të repozitorit SOBR dhe lidhjen e kapacitetit me një skaner të mëvonshëm; thjesht duhet të shtojmë objektin e ruajtjes në ndërfaqen e vima dhe të nisemi me procedurën Import Storage Repository. E vetmja gjë që mund të qëndrojë mes jush dhe backup-it tuaj është kërkesa për të futur një fjalëkalim, nëse backup-et tuaja ishin të kriptuara.
Këtu për Copy Mode, mendoj se kemi përfunduar, dhe ne kalojmë në
Sealed Mode
Koncepci kryesore është që në ekstensin e zgjedhur të repozitorit SOBR nuk mund të shfaqen backup-e të reja. Para versionit v10, ne kishim vetëm Modalitetin e Mirëmbajtjes, ku ndalohej plotësisht çdo punë me repozitorin. Një lloj rrethi ekstrem të punës jashtë përdorimit, ku vetëm butoni Evacuate ishte i disponueshëm, duke tërhequr backup-et në një ekstens tjetër një herë.
Modaliteti i Pezulluar është një version 'më të butë': ndalojmë krijimin e backup-eve të reja dhe gradualisht fshijmë ato të vjetra sipas ruajtjes së zgjedhur, por në proces nuk humbasim mundësinë për t'u rikuperuar nga piketat e ruajtura. Një gjë shumë e dobishme kur na duhen ose po i skadon afati i pajisjes dhe duhet ta zëvendësojmë, ose thjesht duhet ta lirojmë për diçka më të rëndësishme, dhe nuk kemi vend për ta transferuar gjithçka njëherësh. Ose nuk është e mundur ta fshijmë.
Prandaj, parimi i funksionimit është mjaft i thjeshtë: duhet të ndaloni të gjitha operacionet shkruese (shfaqjen e të dhënave të reja), duke lënë ato lexuese (rikuperimet) dhe fshirëse (ruajtjen).
Të dy modet mund të përdoren njëkohësisht, por duhet të kemi parasysh se Modaliteti i Mirëmbajtjes ka përparësi më të lartë.
Si një shembull, le të marrim një SOBR, i përbërë nga dy ekstens. Supozoni se për katër ditët e para kemi krijuar backup-e në modalitetin Forward Forever Incremental, dhe pastaj ne pezullojmë ekstensin. Kjo çon në faktin se ne iniciativisht krijojmë një aktiv të plotë në ekstensin e dytë të disponueshëm. Nëse ruajtja jonë është katër, atëherë kur e gjithë zinxhiri, që ndodhet në ekstensin e pezulluar, kalon përtej kufijve të tij, ai fshihet pa ndonjë ndjenjë faji.
Ka janë situata kur fshirja ndodh më herët. Për shembull, kjo ndodh në Forward incremental me fulle periodike. Nëse dy ditët e para kemi krijuar backup-e të plota, dhe të enjten vendosim të mbyllim repositorin, atëherë të premten, kur të krijohet një backup i ri, file për të hënën do të fshihet sepse në këtë pikë nuk ka varësi. Dhe vetë pika nuk varet nga askush. Pas kësaj, presim që të krijohen katër pika në ekstensinë e disponueshme dhe fshijmë tre të tjera të mbetura, të cilat nuk mund të fshihen ndaras nga njëra-tjetra.
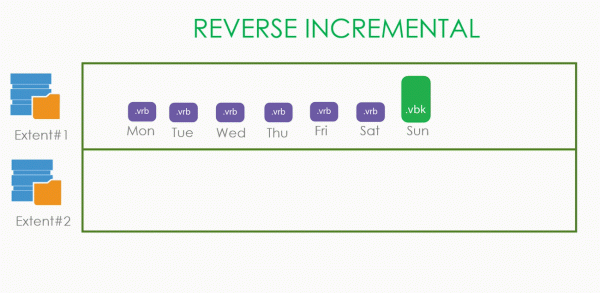
Është më e thjeshtë me Reverse Incremental. Në të, pikat më të vjetra nuk varen nga asgjë dhe mund të fshihen pa ndonjë problem. Prandaj, sa herë që krijohet një .vbk e re në një ekstension të ri, të vjetrat .vrb do të fshihen një nga një.
Sidoqoftë, pse ne çdo herë krijojmë një .vbk të ri: nëse nuk do ta krijonim atë dhe do të vazhdonim me zinxhirin e vjetër të inkrementëve, atëherë e vjetra .vbk do të ngej në mënyrë të pafund në çdo mod, duke penguar fshirjen e saj. Prandaj, u mor vendimi që sa herë që mbyllet ekstensioni, krijojmë një backup të plotë në ekstensionin e lirë.
Është më e komplikuar me kapacitetin e tier-it.
Fillimisht, le të shqyrtojmë modin copy. Supozoni se gjatë katër ditëve kemi krijuar backup-e aktive, dhe pastaj kapaciteti i tier-it është mbyllur. Ne nuk fshijmë asgjë, por durim qëndrojmë me ruajtjen, dhe pas kësaj fshijmë të dhënat nga kapaciteti i tier-it.
Përgjithësisht, e njëjta gjë ndodh edhe me modin move — presim ruajtjen, fshijmë të vjetrat në ruajtjen lokale, dhe fshijmë ato që ruhen në object storage.
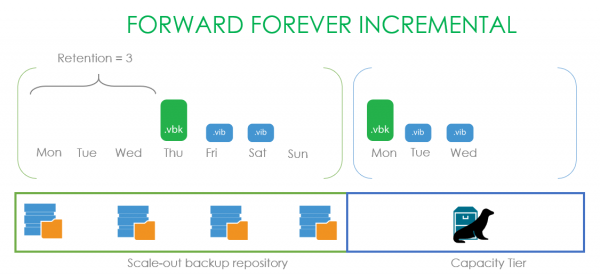
Një shembull interesant është me Forever forward incremental. Vendosim ruajtjen në tre pika dhe fillojmë të hënën duke bërë backup-e, të cilat kopjohen saktësisht në cloud. Pas mbylljes së ruajtjes, backup-et vazhdojnë të krijohen, duke mbajtur tre pika, por të dhënat që ruhen në kapacitetin e tier-it mbeten të vare nga njëra-tjetra dhe nuk mund të fshihen. Prandaj, presim të enjten, kur .vbk jonë kalon jashtë kufijve të ruajtjes dhe vetëm atëherë fshijmë të gjithë zinxhirin e ruajtur.
Dhe një shënim i vogël: të gjitha shembujt këtu janë të ilustruar me një makinë. Nëse keni më shumë makineri në backup, ruajtja e tyre do të ndryshojë në varësi të faktit nëse është bërë Active Full apo jo.
Kështu që, në principe, kjo është e gjitha. Prandaj, kalojmë te karakteristika më e fortë —
Immutability
Si me parazgjuar me pikat e mëparshme, fillimisht flasim për problemin që zgjidh kjo funksionalitet. Sapo transferojmë backupet tona për ruajtje diku, ndjehet një dëshirë e madhe për të garantuar ruajtjen e tyre, domethënë për të ndaluar fizikisht fshirjen e tyre dhe çdo modifikim gjatë periudhës së caktuar të ruajtjes. Edhe nga administratorët, madje edhe nga llogaritë e tyre të adminit. Kjo ndihmon në mbrojtjen e tyre nga dëmshmëria e rastësishme apo e qëllimshme. Ata që punojnë me AWS, mund të kenë hasur një funksionalitet të tillë nën emrin Object Lock.
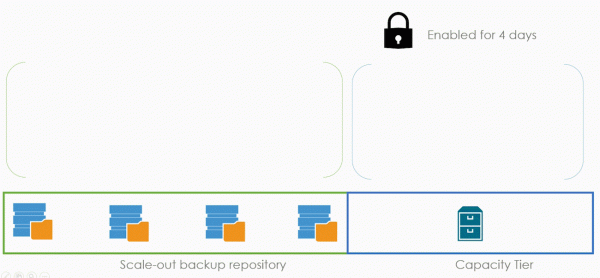
Tani le të shohim modin në mënyrë të përgjithshme, pastaj do të thellohemi në detaje. Në shembullin tonë, Immutability do të aktivizohet për kapacitetin tonë me një periudhë ruajtjeje prej katër ditësh. Ndërsa backupi përfshin modin Copy.
Immutability nuk ndërvepron asnjëherë me ruajtjen e përgjithshme. Për shembull, nuk shton pika të tjera apo diçka të tillë. Thjesht gjatë katër ditëve, personi nuk mund të fshijë skedarët e backupit. Nëse bëhet një backup të hënën, atëherë skedari i tij mund të fshihet vetëm të premten.
Të gjitha konceptet e mëparshme të dehidratimit, indekseve dhe metadënave vazhdojnë të funksionojnë njësoj. Por me një kushtrim — blloku vendoset jo vetëm për të dhënat, por edhe për metadënat. Kjo është bërë në rast se një keqbërës dinak vendos të fshijë bazën tonë të metadënave dhe që blloqet me të dhëna të mos shndërrohen në një grumbull binar të padobishëm.
Dhe tani ka ardhur një moment i shkëlqyer për të shpjeguar teknologjinë tonë të gjenerimit të bllokëve. Ose gjenerimi i bllokëve. Për këtë, le të shqyrtojmë situatën që çoi në shfaqjen e saj.
Marrim një lini kohore prej gjashtë ditësh dhe nga poshtë do të shënojmë kohën e pritur për skadimin e immutability. Marrim dhe krijojmë në ditën e parë një skedar, i përbërë nga blloku a dhe metadatate e tij. Nëse immutability është vendosur për tre ditë, është logjike të supozojmë se në ditën e katërt të dhënat do të çbllokohen dhe do të fshihen. Në ditën e dytë do të shtojmë një skedar të ri file2, i përbërë nga blloku b me të njëjtat konfigurime. Blloku a ende duhet të fshihet në ditën e katërt. Por në ditën e tretë ndodh diçka e frikshme — krijohet skedari File3, i përbërë nga blloku i ri d dhe një referencë në bllokun e vjetër a. Kjo do të thotë se për bllokun a flamuri i immutability duhet të rikonfirmohet për një afat të ri, i cili shtyhet për në ditën e gjashtë. Dhe këtu shfaqet problemi — në backup-et reale të këtyre bllokëve krijohet një numër i madh. Dhe për të zgjatur periudhën e immutability, duhet të kryhen një sasi e madhe kërkesash çdo herë. Dhe në fakt, kjo do të jetë një proces praktikisht i pafundëm çdo ditë, sepse me probabilitet të lartë, ne do të gjejmë grumbuj të mëdhenj të bllokëve të deduplication në çdo kopjim. Dhe çfarë do të thotë një numër i madh kërkesh ndaj ofruesve të objekteve të ruajtjes? Sakrifikim! Një faturë e madhe në fund të muajit.
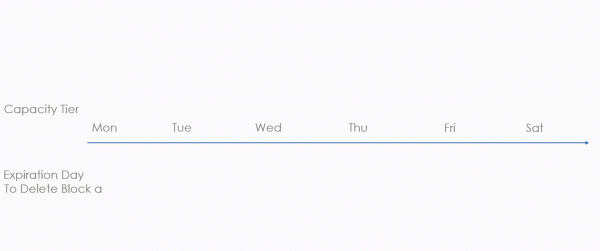
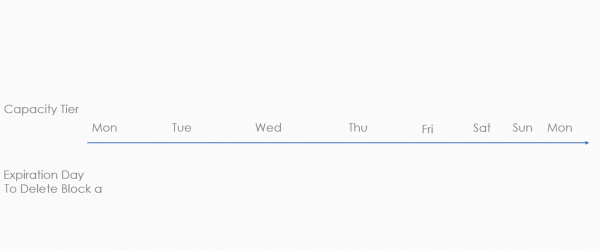
Dhe për të mos i rënduar klientët tanë të dashur me shifra të larta për diçka që ndodh pa arsye, u shpik mekanizmi i gjenerimit të bllokëve. Ky është një periudhë shtesë që ne e shtojmë në periudhën e vendosur të immutability. Në shembullin më poshtë, kjo periudhë është dy ditë. Por kjo është vetëm për shembull. Në realitet, aty përdoret një formulë e vetme, e cila ofron përafërsisht dhjetë ditë shtesë për një bllokim mujor.
Do vazhdojmë të shqyrtojmë të njëjtën situatë, por tani me gjenerimin e bllokut. Krijojmë në ditën e parë file1 nga blloku a dhe të dhënat metadatatike. Kemi grumbulluar periudhën e gjenerimit dhe immutability - do të thotë, mundësia për të fshirë skedarin do të jetë në ditën e gjashtë. Nëse në ditën e dytë krijojmë File2, i cili përbëhet nga blloku b dhe lidhja me bllokun a, asgjë nuk ndodh me datën e parashikuar të fshirjes. Ajo mbetet e pandryshuar në ditën e gjashtë. Kështu, ne po përpiqemi të kursejmë para në numrin e kërkesave. Situata e vetme kur afati mund të shtyhet është nëse periudha e gjenerimit ka skaduar. Pra, nëse në ditën e tretë File3 i ri do të përmbajë një lidhje me bllokun a, do të shtohet gjenerimi 2 pasi Gen1 ka skaduar. Dhe data e pritur e fshirjes së bllokut a do të zhvendoset në ditën e tetë. Kjo na lejon të reduktojmë dramatikisht numrin e kërkesave për të zgjasur jetën e blloqeve të deduplikuara, që kursen shumë para për klientët.
Përgjithësisht, teknologjia është e disponueshme për përdoruesit e S3 dhe pajisjeve të ndërlidhura me S3, prodhuesit e të cilave garantojnë që implementimi i tyre nuk ndryshon nga ai i Amazon. Këtu vjen përgjigjja për pyetjen legjitime, pse Azure nuk mbështetet - ata kanë një veçori të ngjashme, por ajo funksionon në nivelin e kontejnerëve dhe jo të objekteve individuale. Për më tepër, në Amazon ka dy mënyra për obiekt lok: compliance dhe governance. Në rastin e dytë, ka mundësi që admini më i fuqishëm mbi adminët dhe super admini, pavarësisht nga obiekt lok, të fshijë të dhënat. Në rastin e compliance, gjithçka është ngjitur fort dhe askush nuk mund të fshijë backup-et. Madje edhe adminët e Amazon (sipas deklaratave të tyre zyrtare). Ne mbështesim pikërisht këtë mënyrë.
Dhe, tradicionalisht, disa lidhje të dobishme:
- Për në të gjitha detajet.
- Të gjitha informacionet rreth në formën më të mirë
- Q në detaje
Burimi: habr.com
