

Sot është 100500 kurse për Data Science dhe është e njohur se më shumë para në Data Science mund të fitohen pikërisht nga kurset e Data Science (pse të gërmosh, kur mund të shesësh lopata?). Minus i madh i këtyre kurseve është se ato nuk kanë asnjë lidhje me punën reale: askush nuk do t'ju japë të dhëna të pastra, të përpunuara në formatin e dëshiruar. Dhe kur dilni nga kurset dhe filloni të zgjidhni një problem të vërtetë — dalin në pah shumë nuanca.
Prandaj fillojmë një seri shënimesh "Çfarë mund të shkojë keq me Data Science", të bazuara në ngjarje reale që më kanë ndodhur mua, shokëve dhe kolegëve të mi. Do shqyrtojmë me raste reale detyrat tipike të Data Science: si ndodh në të vërtetë. Të fillojmë sot me problemin e mbledhjes së të dhënave.
Dhe e para në të cilën presidentët hasin, filluan të punojnë me të dhëna reale — është pikërisht mbledhja e këtyre të dhënave që na interesojnë. Mesazhi kryesor i këtij artikulli:
Ne sistematikisht nënvlerësojmë kohën, burimet dhe përpjekjet për mbledhjen, pastrimin dhe përgatitjen e të dhënave.
Dhe më kryesorja, do diskutojmë se çfarë të bëjmë që të mos e lejojmë këtë.
Sipas vlerësimeve të ndryshme, pastrimi, transformimi, përpunimi i të dhënave, inxhinieria e veçorive etj. zënë 80-90% të kohës, dhe analiza 10-20%, ndërsa praktiksht i gjithë materiali mësimor përqendrohet ekskluzivisht në analizë.
Le të shqyrtojmë si një shembull tipik një detyrë analitike të thjeshtë në tri variante dhe të shohim se çfarë janë "rrethanat njollosëse".
Dhe për shembull po ashtu, ne do të shqyrtojmë variacione të tilla të detyrës së mbledhjes së të dhënave dhe krahasimit të komuniteteve për:
- Dy subreddite në Reddit
- Dy seksione në Habr
- Dy grupe në Odnoklassniki
Qasja kondicionale në teori
Hapni faqen dhe lexoni shembuj, nëse është e qartë, planifikoni disa orë për leximin, disa orë për kodin sipas shembujve dhe debug. Shtoni disa orë për mbledhjen. Shtoni disa orë për rezervë (shumoni me dy dhe shtoni N orë).
Pika kryesore: vlerësimi temporal bazohet në supozime dhe hamendje se sa do të zgjasë.
Të filloni analizën e kohës është e nevojshme që të bëni vlerësimin e parametrave të mëposhtëm për detyrën e kushtezuar, të përshkruar më lart:
- Cila është madhësia e të dhënave dhe sa prej saj nevojitet fizikisht për t'u mbledhur (*shih më poshtë*).
- Cili është koha e mbledhjes së një regjistrimi dhe sa duhet të prisni para se të mund të mbledhni të dytën.
- Të krijoni një kod që ruan gjendjen dhe fillon rinisjen, kur (e jo nëse) gjithçka dështon.
- Të kuptojmë nëse na nevojitet autentifikimi dhe të parashikojmë kohën për të marrë qasje përmes API.
- Të parashikojmë numrin e gabimeve si funksion të kompleksitetit të të dhënave – të vlerësojmë për një detyrë të caktuar: struktura, sa transformime, çfarë dhe si e nxjerrim.
- Të parashikojmë gabimet e rrjetit dhe problemet me sjellje jostandarde të projektit.
- Të vlerësojmë nëse funksionet e nevojshme janë në dokumentacion dhe nëse jo, atëherë si dhe sa është e nevojshme për një zgjidhje alternative.
Më e rëndësishmja, për të vlerësuar kohën – ju faktikisht duhet të shpenzoni kohë dhe përpjekje për "zhbllokimin e situatës" – vetëm atëherë planifikimi juaj do të jetë adekuat. Pra, pavarësisht se si ju përpiqen të thonë "sa kohë nevojitet për mbledhjen e të dhënave" – merrni kohë për një analizë paraprake dhe argumentoni se sa kohë do të variëren në varësi të parametrave realë të detyrës.
Dhe tani do të ilustrojmë shembuj konkretë, ku këta parametra do të ndryshojnë.
Pika kyçe: vlerësimi bazohet në analizën e faktorëve kyç që ndikojnë në sasinë dhe kompleksitetin e punës.
Vlerësimi, i bazuar në supozime – është një qasje e mirë kur elementët funksionalë janë mjaft të vegjël dhe nuk ka shumë faktorë që mund të ndikojnë dukshëm në strukturën e detyrës. Por në rastin e një sërë detyrash në Shkencën e të Dhënave, këta faktorë bëhen jashtëzakonisht të shumtë dhe kjo qasje bëhet e papërshtatshme.
Krahasimi i komuniteteve në Reddit
Të fillojmë me rastin më të thjeshtë (siç do të rezultojë më vonë). Në të vërtetë, nëse jemi të sinqertë, kemi përpara një rast praktikisht ideal, le të kontrollojmë listën tonë të kontrollit për kompleksitetin:
- Ka një API të qartë, të kuptueshme dhe të dokumentuar.
- Shumë e thjeshtë dhe më e rëndësishmja fitohet automatikisht një token.
- Ka – me një mori shembujsh.
- Komuniteti që merret me analizën dhe mbledhjen e të dhënave në Reddit (përfshirë deri në video në YouTube që shpjegojnë se si të përdorni python wrapper) .
- Metodat që na duhen ndoshta ekzistojnë në API. Për më tepër, kodi duket kompakt dhe i pastër, më poshtë është një shembull i funksionit që mbledh komentet për postimin.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Marrë nga përmbledhja e mjeteve të përshtatshme për paketimin.
Megjithëse kemi rastin më të mirë përpara nesh, megjithatë është e nevojshme të merret parasysh një sërë faktorësh të rëndësishëm nga jeta reale:
- Kufijtë e API-së — jemi të detyruar të marrim të dhënat në grupe (të presim midis kërkesave, etj.).
- Koha e mbledhjes — për një analizë të plotë dhe krahasim, do të duhen rëndësisht kohë vetëm për kërkuesi për të kaluar nëpër subredit.
- Robotët duhet të funksionojnë në server — nuk mund ta filloni thjesht në laptop, ta vendosni në çantë dhe të shkoni për biznes. Prandaj, unë kam filluar gjithçka në VPS. Me kodin e zbritjes habrahabr10 mund të kurseni edhe 10% të çmimit.
- Pamundësia fizike për të aksesuar disa të dhëna (ato janë të dukshme për administratoret ose janë shumë të vështira për t'u mbledhur) — duhet ta marrim parasysh, jo të gjitha të dhënat mund të mblidhen brenda një kohe të arsyeshme.
- Gabimet e punës në rrjet: punimi me rrjetin është e dhimbshme.
- Këto janë të dhëna reale — ato nuk janë kurrë të pastra.
Sigurisht, është e nevojshme të merret parasysh këto nuanca në zhvillim. Orët/ditat e sakta varen nga përvoja e zhvillimit ose përvoja e punës me detyra të ngjashme, megjithatë ne shohim se këtu detyra është ekskluzivisht inxhinierike dhe nuk kërkon lëvizje të tjera shtesë për zgjidhje — gjithçka mund të vlerësohet, të përshkruhet dhe të bëhet shumë mirë.
Krahasimi i seksioneve të Habrës
Kaloim në një rast më interesant dhe jo trivial, duke krahasuar rrjedhat dhe/ose seksionet e Habrës.
Le të kontrollojmë listën tonë të komplikiave — këtu, për të kuptuar çdo pikë, do të duhet të eksperimentoni pak me detyrën dhe të provoni.
- Fillimisht mendoni se ka një API, por nuk ka. Po, Habra ka API, por ai nuk është në dispozicion për përdoruesit (ndoshta as nuk funksionon).
- Pastaj thjesht filloni të parse html — «import requests», çfarë mund të shkojë keq?
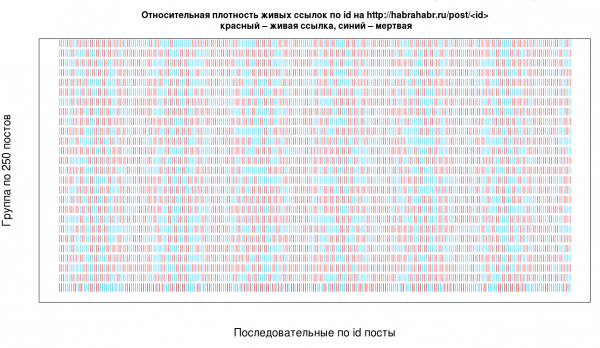
- Dhe si mund të parse? Qasja më e thjeshtë dhe e përdorur shpesh është të iteroni mbi ID, do të theksojmë se nuk është metoda më efektive dhe do të duhen të përpunohen raste të ndryshme — për shembull, densiteti i ID-ve reale në mesin e të gjithë atyre që ekzistojnë.

Marrë nga artikuj. - Të dhënat e papërpunuara, të mbështjella në HTML sipër rrjetit — janë një dhimbje. Për shembull, dëshironi të mbledhni dhe ruani vlerësimin e artikullit: e nxorrët score nga html dhe vendosët ta ruani si numër për përpunim të mëtejshëm:
1) int(score) shkakton një gabim: pasi në Habra minus, si në rreshtin "–5" — është një lidhëse e shkurtër, jo një shenjë minusi (papritur, apo jo?), prandaj në një moment duhej ta ngrihnim parser-in në jetë me një fikso të tillë të tmerrshëm.
provoni:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      nëse kontrolloni datën (date):
        post_score += score
Datat, pluset dhe minuset mund të mos ekzistojnë fare (siç e shohim më lart në funksionin check_date, dhe kështu ka ndodhur).
2) Simbolet speciale të paekranuara — ato do të vijnë, duhet të jeni gati.
3) Strukturat ndryshojnë varësisht nga lloji i postit.
4) Postet e vjetra mund të kenë **strukturë të çuditshme**.
- Në thelb, procesi i përpunimit të gabimeve dhe çfarë mund ose s'mund të ndodhë do të duhet të përballeni dhe nuk mund të parashikohet me siguri se çfarë do të shkojë keq dhe si mund të jetë ndryshe struktura dhe se çfarë do të bjerë — ndoshta do t'ju duhet të provoni dhe të merrni parasysh gabimet që jep parser-i.
- Më pas kuptoni se duhet të parse në disa rrjedha në të kundërt, procesi në një të vetme do të zgjasë 30+ orë (ky është thjesht koha e ekzekutimit të parser-it të vetëm që fle dhe nuk bie nën asnjë ndalese). Në artikull, kjo solli një moment të ngjashëm në skemën e tillë:
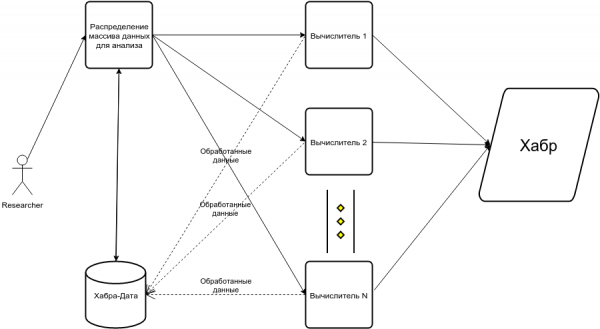
Kështu, lista e kontrollit për vështirësinë:
- Puna me rrjetin dhe parse HTML me iterim dhe kalim sipas ID.
- Dokumentet kanë strukturë të heterogjene.
- Ka shumë vende ku kodi mund të dështojë lehtësisht.
- Nevojitet të shkruhet || kodi.
- Mungojnë dokumentacioni i nevojshëm, shembujt e kodit dhe\/ose komuniteti.
Vlerësimi kushtetues i kohës për këtë detyrë do të jetë 3-5 herë më i lartë, sesa për mbledhjen e të dhënave nga Reddit.
Krahasimi i grupeve në Odnoklassniki
Të kalojmë në rastin më teknologjikisht të interesant përveç atyre që janë përmendur. Për mua, ai ishte interesant pikërisht për faktin se në dukje duket mjaft trivial, por nuk është krejtësisht i tillë — sapo të bëni një prekje në të.
Do të fillojmë me listën tonë të kontrollit për vështirësinë dhe do të theksojmë se shumë nga ato do të rezultojnë më të komplikuara se si duken në fillim:
- API ekziston, por i mungojnë pothuajse të gjitha funksionet e nevojshme.
- Për disa funksione duhet të kërkoni akses me email, domethënë dhënia e aksesit nuk është e menjëhershme.
- Dokumentimi është jashtëzakonisht i dobët (të fillojmë me faktin se terma rusë dhe anglishte përzihen kudo, në një mënyrë krejtësisht të paparashikueshme — ndonjëherë duhet thjesht të gjesh se çfarë po kërkohet prej teje diku) .
- Kërkon seancë në dokumentacion, ndërsa në praktikë nuk e përdor atë — dhe nuk ka asnjë mënyrë për të kuptuar të gjitha nuancat e modës së API, përveç të provohet dhe shpresohet që diçka do të funksionojë.
- Mungojnë shembuj dhe komuniteti, pika e vetme e mbështetjes për mbledhjen e informacionit është një në Python (pa shumë shembuj përdorimi).
- Mënyra më funksionale duket të jetë Selenium, pasi shumë të dhëna të nevojshme janë nën mbrojtje.
1) Pra, ndodh autorizimi përmes një përdoruesi të rremë (dhe regjistrimi manual).2) Megjithatë, me Selenium nuk ka garantira për funksionimin e saktë dhe të përsëritshëm (sigurisht në rastin me ok.ru).
3) Site Ok.ru përmban gabime JavaScript dhe ndonjëherë sillet çuditshëm dhe pa një qëndrim të qartë.
4) Duhet të merremi me paginimin, ngarkimin e elementeve, etj...
5) Gabimet e API që jep wrapper-it do të duhet të përpunohen në mënyrë të përpiktë, për shembull, kështu (një copë kod eksperimental):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#ka kuptim të mbani gjurmët e diskutimeve të përpunuara tashmë
        për diskutim në tqdm(discussions):
            përpiqem:
                comments = get_comments_from_discussion_via_api(context, discussion)
            përjashto odnoklassniki.api.OdnoklassnikiError si e:
                nëse "NOT_FOUND" në str(e):
                    comments = set()
                tjetër:
                    print(e)
                    bp()
                    kaloni
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Gabimi im i preferuar ishte:
OdnoklassnikiError("Gabim(kodi: 'None', përshkrimi: 'gabim HTTP', metoda: 'discussions.getComments', parametra: …)")6) Në fund, mundësia Selenium + API duket të jetë mundësia më e arsyeshme.
- Nevoja për ruajtjen e gjendjes dhe rikthimin e sistemit, përpunimi i shumë gabimeve, përfshirë sjelljen e paqëndrueshme të site-it — për më tepër, këto gabime janë mjaft të vështira për t'u imagjinuar (nëse nuk jeni profesionist në shkruarjen e parserëve, natyrisht).
Vlerësimi i kushtëzuar i kohës për këtë detyrë do të jetë nga 3-5 herë më i lartë se sa për mbledhjen e të dhënave nga Habra. Pavarësisht se në rastin e Habra ne përdorim një qasje ballore me parsing të HTML-së, në rastin e OK ne mund të punojmë me API në vendet kritike.
Përfundimet
Pavarësisht se si mund të kërkohet vlerësimi i afateve "në vend" (ne kemi planifikim sot!), volumi i modulit të harduerit të procesit të të dhënave është praktikisht e pamundur të vlerësohet cilësisht pa analizuar parametrat e projektit.
Nëse flasim pak më filozofikisht, strategjitë e vlerësimit në agile i përshtaten mirë detyrave inxhinierike, por me detyra më eksperimentale dhe, në një farë mënyre, "kreative" dhe kërkuese, pra, më pak të parashikueshme, lindin vështirësi, si në shembujt që analizuam këtu.
Sigurisht, mbledhja e të dhënave është një shembull ilustrativ — zakonisht kjo detyrë duket jashtëzakonisht e lehtë dhe teknikisht jo e komplikuar, dhe pikërisht në detaje këtu shpesh fshihet djalli. Dhe pikërisht në këtë detyrë është e mundur të tregohet e gjithë spektri i mundësive se çfarë mund të shkojë keq dhe sa shumë mund të zgjatet puna.
Nëse shikoni një herë për të parë karakteristikat e detyrës pa eksperimente të tjera, Reddit dhe OK duken të ngjashme: janë me API, py wrapper, por në thelb, ndryshimi është gjigand. Nëse gjykohet sipas këtyre parametrave, parser-i i Habrës duket më i komplikuar se OK — ndërsa në praktikë është krejtësisht e kundërta dhe pikërisht këtë mund ta zbulojmë duke kryer eksperimente të thjeshta për analizën e parametrave të detyrës.
Nga përvoja ime, qasja më efektive është një vlerësim i përafërt i kohës që do t'ju nevojitet për analizën preliminare dhe eksperimentet e para të thjeshta, leximi i dokumentacionit — ato do t'ju lejojnë të jepni një vlerësim të saktë për të gjithë punën. Me terma të metodologjisë popullore agile — kërkoj të krijohet një biletë për "vlerësimin e parametrave të detyrës", mbi bazën e së cilës mund të jap një vlerësim për atë që është e mundur të realizohet brenda "sprintit" dhe të jap një vlerësim më të saktë për secilën detyrë.
Prandaj duket se argumenti më efektiv është ai që do të tregonte "specialistit jo teknik" sa shumë do të variojë koha dhe burimet në varësi të parametrave që ende duhet të vlerësohen.
Burimi: habr.com
