

Tregu i llogarive të shpërndara dhe të dhënave të mëdha, nëse besohet, , rritet me 18-19% në vit. Kjo do të thotë se pyetja e zgjedhjes së softuerit për këto qëllime mbetet aktuale. Në këtë postim, do të fillojmë me arsyen pse janë të nevojshme llogaritë e shpërndara, do të ndalemi më në detaje në zgjedhjen e softuerit, do të flasim për përdorimin e Hadoop me Cloudera dhe në fund do të diskutojmë për zgjedhjen e harduerit dhe për mënyrat se si ndikon në performancë.
Pse janë të nevojshme llogaritë e shpërndara në biznesin e zakonshëm? Këtu është e thjeshtë dhe e komplikuar njëkohësisht. E thjeshtë — sepse në shumicën e rasteve, ne bëjmë llogaritje relativisht të thjeshta për çdo njësi informacioni. E komplikuar — sepse ka shumë të tillë. Shumë shumë. Si pasojë, na duhet . Kështu, skenarët e përdorimit janë mjaft universale: llogaritë mund të aplikohen kudo ku kërkohet të merren parasysh një numër i madh metrikash mbi një masiv edhe më të madh të dhënash.
Një nga shembujt e fundit: rrjeti i picerive Dodo Pizza në bazë të analizës së bazës së të dhënave të porosive të klientëve, se kur zgjedhin një picë me përbërje të rastësishme, përdoruesit zakonisht operojnë vetëm me gjashtë grupe themelore përbërësish plus disa të rastësishëm. Në përputhje me këtë, piceria rregulloi blerjet. Për më tepër, ajo arriti të rekomandojë më mirë përdoruesve produkte shtesë të ofruara në fazën e porosisë, çka rriti fitimin.
Një tjetër shembull: reduktimi i numrit të artikujve ndihmoi dyqanin H&M të zvogëlojë asortimentin në disa dyqane me 40%, duke ruajtur kështu nivelin e shitjeve. Kjo u arrit duke përjashtuar pozitat që shiteshin keq, për më tepër, në llogaritje u mor parasysh sezonaliteti.
Zgjedhja e mjetit
Standarti i industrisë për llogaritë e këtij lloji është Hadoop. Pse? Sepse Hadoop është një framework i shkëlqyer, i dokumentuar mirë (po ashtu, Habr publikojnë shumë artikuj të detajuar mbi këtë temë), që shoqërohet me një set të tërë utilitaresh dhe librarish. Ju mund të jepni si input grupe të mëdha të të dhënave si të strukturuara ashtu edhe të pa-struktuara, dhe sistemi do t’i shpërndajë ato vetë mes kapaciteteve llogaritative. Më tej, këto kapacitete mund të rriten ose çaktivizohen në çdo moment — ajo është horizontale e shkallëzueshmërisë në veprim.
Në vitin 2017, kompania e njohur e konsulencës Gartner , që Hadoop do të shkojë drejt zhdukjes. Arsyeja është mjaft e thjeshtë: analistët besojnë se kompanitë do të fillojnë të migrojnë masivisht në cloud, sepse atje ata do të mund të paguajnë për përdorimin real të kapaciteteve kompjuterike. Faktori i dytë i rëndësishëm, i cili përflitet se mund të dhembë Hadoop — është shpejtësia e funksionimit. Sepse alternativa si Apache Spark ose Google Cloud DataFlow punojnë më shpejt se MapReduce, që është baza e Hadoop.
Hadoop mbështetet në disa kërkesa, ndër të cilat më të dukshme janë teknologjitë MapReduce (sistemi i shpërndarjes së të dhënave për kalkulimet ndërmjet serverëve) dhe sistemi i skedarëve HDFS. Ky i fundit është krijuar posaçërisht për ruajtjen e informacionit të shpërndarë ndërmjet nyjave të klasterit: çdo bllok me madhësi të caktuar mund të vendoset në disa nyje, dhe përmes replikimit sigurohet qëndrueshmëria e sistemit ndaj dështimeve të nyjave të caktuara. Në vend të tabelës së skedarëve përdoret një server i veçantë, i quajtur NameNode.
Në ilustrimin më poshtë është paraqitur skema e punës së MapReduce. Në fazën e parë, të dhënat ndahen sipas një kritere të caktuar, në të dytën — shpërndahen sipas kapaciteteve kompjuterike, në të tretën — ndodhin llogaritjet.
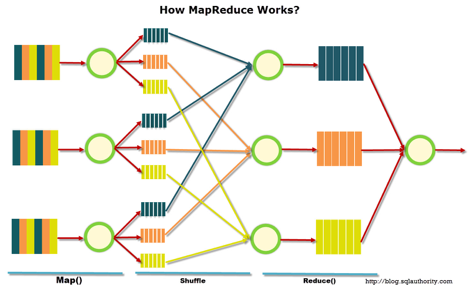
Fillimisht, MapReduce u krijua nga Google për nevojat e kërkimit të saj. Më pas, MapReduce kaloi në kodin e lirë dhe projekti u mor nga Apache. Ndërsa Google gradualisht kaloi në zgjidhje të tjera. Një detaj interesant: në momentin aktual, Google ka një projekt të quajtur Google Cloud Dataflow, e cila pozicionohet si hapi tjetër pas Hadoop, si një zëvendësim të shpejtë për të.
Për një shqyrtim më të afërt, vërehet se Google Cloud Dataflow bazohet në një variant të Apache Beam, dhe në të, Apache Beam përfshin një framework të dokumentuar mirë Apache Spark, duke lejuar të flitet për një shpejtësi ekzekutimi praktikisht të njëjtë. Ndërsa Apache Spark punon shumë mirë në sistemin e skedarëve HDFS, çka lejon që të zhvillohet në serverë Hadoop.
Shtojmë këtu volumet e dokumentacionit dhe zgjidhjeve të gatshme për Hadoop dhe Spark në krahasim me Google Cloud Dataflow, dhe zgjedhja e mjetit bëhet e qartë. Për më tepër, inxhinierët mund të vendosin vetë se cilin kod — për Hadoop ose Spark — ta ekzekutojnë, duke u bazuar në detyrën, përvojën dhe kualifikimin.
Cloud ose server lokal
Tendenca për kalimin në cloud ka sjellë edhe një termin interesant si Hadoop-as-a-service. Në këtë skenar, administrimi i serverëve të lidhur është bërë shumë i rëndësishëm. Sepse, fatkeqësisht, përkundër popullaritetit të tij, Hadoop-i i pastër është një mjet mjaft i komplikuar për t'u konfiguruar, pasi shumë gjëra duhen bërë manualisht. Për shembull, konfiguroi serverët veças, monitoroi treguesit e tyre, konfiguroi me kujdes shumë parametrat. Në përgjithësi, është një punë për entuziastë dhe ka një mundësi të madhe për të bërë gabime apo për të lënë diçka pas dore.
Prandaj, kanë fituar popullaritet të madh distribucione të ndryshme, të cilat përfshijnë mjetet e përshtatshme për zbatimin dhe administrimin. Një nga distribucionet më të njohura, të cilat përkrahin Spark dhe thjeshtojnë gjithçka, është Cloudera. Ai ka versione të paguara dhe të lira — dhe në versionin e fundit është në dispozicion e gjithë funksionaliteti kryesor, pa kufizim në numrin e nod-ëve.
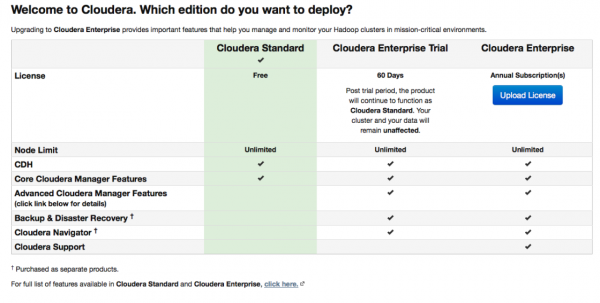
Gjatë konfigurimit, Cloudera Manager do të lidhë për SSH me serverët tuaj. Një moment interesant: gjatë instalimit është më mirë të caktuash që të realizohet me paketë speciale: paketat speciale, në secilën nga të cilat përfshihen të gjitha komponentët e nevojshëm, të konfiguruara për të punuar së bashku. Në thelb, kjo është një version i përmirësuar i menaxherit të paketave.
Pas instalimit, ne marrim një panel menaxhimi të klastrit, ku mund të shihni telemetrinë lidhur me klastrat, shërbimet e instaluara, plus do të jeni në gjendje të shtoni/hiqni burime dhe të redaktoni konfigurimin e klastrit.
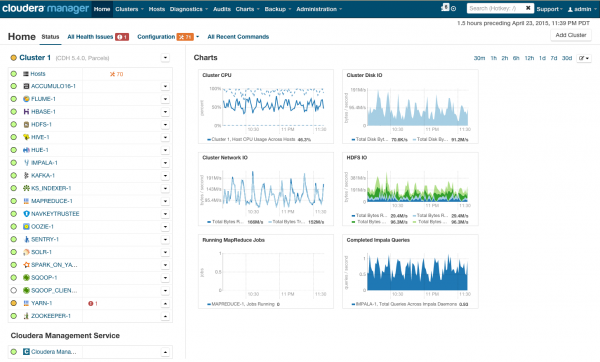
Si rezultat, para jush shfaqet pjesa e raketës që do t'ju çojë në të ardhmen e ndritur të BigData. Por përpara se të themi "në rrugë", le të hedhim një sy nën kapak.
Kërkesat për harduer
Në faqen e saj, Cloudera përmend konfigurime të ndryshme të mundshme. Parimet e përgjithshme mbi të cilat ato bazohen janë paraqitur në ilustrovimin:
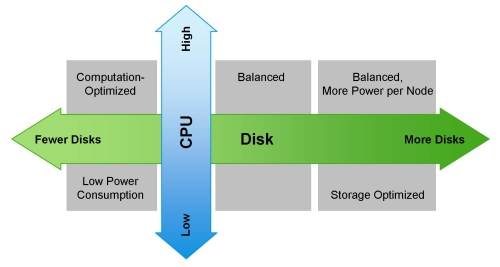
Një imazh optimist mund të prishë MapReduce. Nëse e shikojmë përsëri diagramin nga seksioni i mëparshëm, bëhet e qartë se në pothuajse të gjitha rastet, një detyrë MapReduce mund të përballen me "ngushticat" kur lexon të dhëna nga disku ose nga rrjeti. Kjo gjithashtu është e theksuar në blogun e Cloudera. Si rezultat, për çdo lloj llogaritjesh të shpejta, përfshirë përmes Spark, i cili shpesh përdoret për llogaritje në kohë reale, është shumë e rëndësishme shpejtësia e hyrjes/daljes. Prandaj, kur përdoret Hadoop, është shumë e rëndësishme që në kluster të përfshihen makina të balancuara dhe të shpejta, çka, butësisht thënë, nuk sigurohet gjithmonë në infrastrukturën cloud.
Balancimi në shpërndarjen e ngarkesave arrihet përmes përdorimit të virtualizimit Openstack në serverët me CPU të fuqishme me shumë bërthamë. Nodalet e të dhënave janë ndarë me burime të specificuara të procesorëve dhe disqeve. Në zgjidhjen tonë Atos Codex Data Lake Engine arrihet një virtualizim i gjerë, prej së cilës përfitojmë si në performancë (minimizimi i ndikimit të infrastrukturës rrjetit), ashtu edhe në TCO (eliminohem serverët fizikë të panevojshëm).
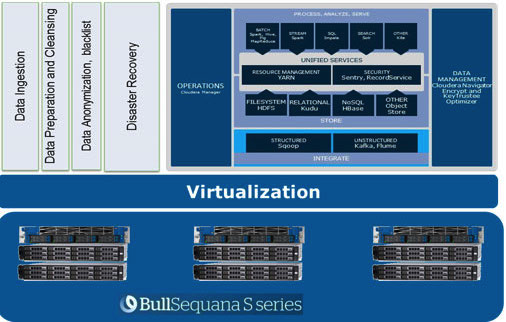
Në rastin e përdorimit të serverëve BullSequana S200, ne marrim një ngarkesë shumë të barabartë, të liruar nga disa ngushtica. Konfigurimi minimal përmban 3 serverë BullSequana S200, secili me dy JBOD, plus mundësisht lidhen serverë të tjerë S200, që përmbajnë katër nodale të dhënash. Ja një shembull ngarkese në testin TeraGen:
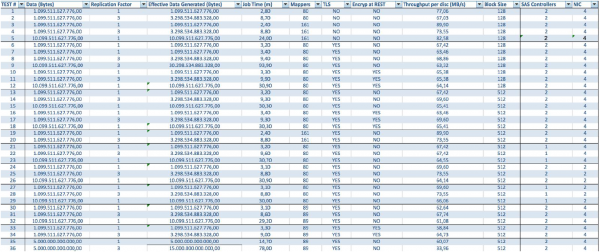
Testet me volumin e ndryshëm të të dhënave dhe vlerat e replikimit tregojnë rezultate të njëjta në përmes shpërndarjes së ngarkesës ndërmjet nyjave të klustrit. Më poshtë është një grafik i shpërndarjes së aksesit në disk nga testet e performancës.
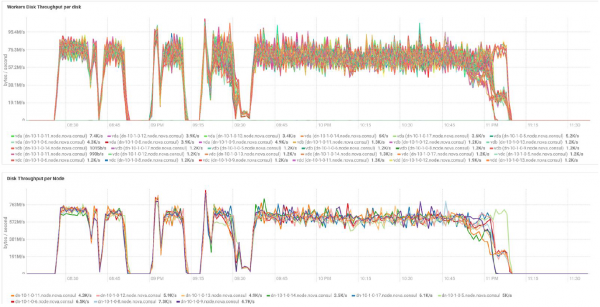
Llogaritjet janë kryer mbi bazën e konfigurimit minimal të 3 serverëve BullSequana S200. Ajo përfshin 9 nyje të dhënash dhe 3 nyje kryesore, si dhe makinat virtuale të rezervuara për rastin e mobilizimit të mbrojtjes mbi bazën e Virtualizimit OpenStack. Rezultati i testit TeraSort: madhësia e bllokut 512 MB me faktor replikimi tre me enkriptim është 23.1 minuta.
Si mund të zgjerohet sistemi? Për Data Lake Engine janë të disponueshme lloje të ndryshme të zgjerimeve:
- Nodalet e transmetimit të të dhënave: për çdo 40 TB hapësirë të dobishme
- Nodalet analitike me mundësinë e instalimit të procesorëve grafikë
- Mënyra të tjera në përputhje me nevojat e biznesit (p.sh., nëse nevojitet Kafka dhe të ngjashme)
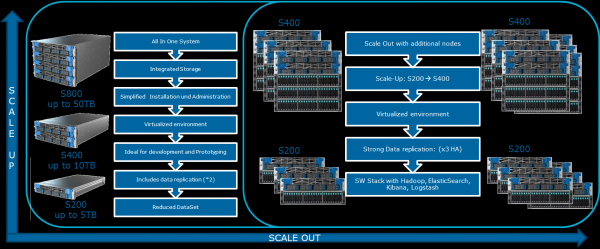
Kompleksi Atos Codex Data Lake Engine përfshin si serverat vetë ashtu dhe software-n e instaluar më parë, duke përfshirë paketën Cloudera me licencë; vetë Hadoop, OpenStack me makinat virtuale të bazuara në bërthamën RedHat Enterprise Linux, sistemet e replikimit të të dhënave dhe backup-it (përfshirë me ndihmën e nodit të rezervimit dhe Cloudera BDR — Backup dhe Rimëkëmbje nga Fatkeqësitë). Atos Codex Data Lake Engine u bë zgjidhja e parë që përdor virtualizimin dhe që u certifikua. .
Nëse jeni të interesuar për detaje, do të jemi të lumtur të përgjigjemi në pyetjet tuaja në komentet.
Burimi: habr.com
