

🥇Si të arrish në qiell dhe të bëhesh pilot | ProHoster
Më quajnë Mikhail, jam zëvendësdrejtor për IT në kompaninë «Sportmaster». Dua të ndaj një histori se si u përballëm me sfidat që u shfaqën gjatë pandemisë.
Në ditët e para të realiteteve të reja, formati tradicional i tregtisë offline të «Sportmaster» u ndal, dhe ngarkesa në kanalin tonë online, kryesisht në lidhje me dorëzimin tek klientët, u rrit dhjetëfish. Brenda disa javësh, ne transformuam një biznes të madh offline në online, duke e adaptuar shërbimin sipas nevojave të klientëve tanë.
Në thelb, ajo që ishte një operacion dytësor për ne, u bë biznesi kryesor. Rëndësia e çdo porosie online u rrit ekstremisht. Duhej të ruanim çdo lek që klientët sjellin në kompani.
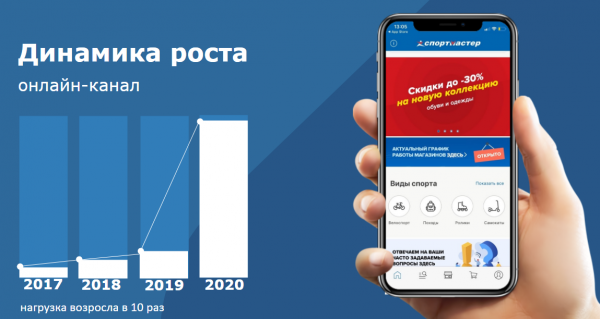
Për t'u përgjigjur shpejt kërkesave të klientëve, hapëm një qendër kontakti shtesë në zyrën qendrore të kompanisë, dhe tani mund të pranojmë rreth 285,000 telefonata në javë. Në të njëjtën kohë, ne kaluam 270 dyqane në një format të ri pa kontakt dhe të sigurt, çka lejoj klientët të merrnin porositë, ndërsa punonjësit ruanin vendet e tyre të punës.
Gjatë procesit të transformimit, kishim dy probleme kryesore. Së pari, ngarkesa në burimet tona online u rrit ndjeshëm (se si u përballëm me këtë, do ta tregojë Sergey). Së dyti, fluksi i operacioneve të rralla (para COVID) u rrit shumëfish, çka kërkonte një volum të madh automatizimi të shpejtë. Për të zgjidhur këtë problem, na duhej të rishpërndanim burimet nga drejtimet që ishin më parë kryesore. Si u përballëm me këtë — do ta tregojë Elena.
Shfrytëzimi i shërbimeve online
Kolesnikov Sergey, përgjigjet për shfrytëzimin e dyqanit online dhe mikroshërbimeve
Që nga momenti kur dyqanet tona me pakicë filluan të mbyllen për vizitorët, ne filluam të regjistronim rritje të treguesve si numri i përdoruesve, numri i porosive që bëhen në aplikacionin tonë, numri i kërkesave për aplikacionet.
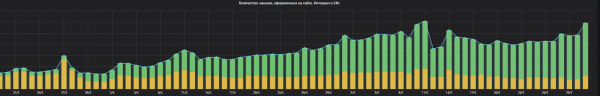 Numri i porosive nga 18 deri më 31 mars
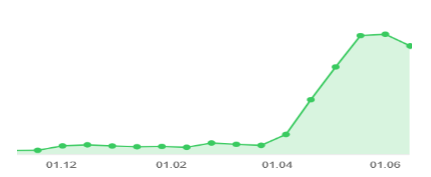 Numri i kërkesave për mikroshërbimet e pagesave online
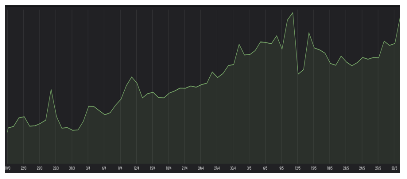 Numri i porosive të realizuara në faqen e internetit
Në grafikun e parë shohim se rritja ishte përafërsisht 14 herë, ndërsa në të dytin — 4 herë. Të dhënat më treguese për ne konsiderojmë koha e përgjigjes së aplikacioneve tona.
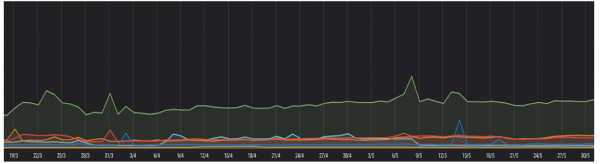
Në këtë grafik shohim përgjigjen e fronteve dhe aplikacioneve, dhe për ne e kemi përcaktuar se nuk kemi vërejtur ndonjë rritje të tillë.
Së pari, kjo lidhet me faktin se ne filluam punët përgatitore në fund të vitit 2019. Tani shërbimet tona janë të rezervuara, është siguruar qëndrueshmëria në nivelin e serverëve fizikë, sistemeve të virtualizimit, konteinerëve dhe shërbimeve në to. Megjithatë, kapacitetet e burimeve tona serverike na lejojnë të përballojmë ngarkesa të shumëfishta.
Instrumenti kryesor që na ndihmoi në të gjithë këtë histori ishte sistemi ynë i monitorimit. Megjithatë, edhe para pak kohësh ne nuk kishim një sistem të vetëm që të na ndihmonte të mbledhim metrika në të gjitha nivelet, nga niveli i pajisjeve fizike dhe harduerit deri te metrikat e biznesit.
Formalisht, monitorimi ekzistonte në kompani, por zakonisht ishte i shpërndarë dhe në përgjegjësinë e njësive të veçanta. Faktikisht, kur ndodhte ndonjë incident, ne pothuajse kurrë nuk kishim një kuptim të përbashkët se çfarë kishte ndodhur, nuk kishte njoftim, dhe shpesh kjo çonte në një kërkim pa fund për lokalizimin dhe zgjidhjen e problemit.
Në një moment, ne menduam dhe vendosëm se ishte e mjaftueshme — na nevojitej një sistem i vetëm që të shihnim të gjithë pamjen plotësisht. Teknologjitë kryesore në stogun tonë përfshijnë Zabbix si qendër për paralajmërim dhe ruajtjen e metrikave, Prometheus për mbledhjen dhe ruajtjen e metrikave të aplikacioneve, Stack ELK për regjistrimin dhe ruajtjen e të dhënave të gjithë sistemit të monitorimit, si dhe Grafana për vizualizimin, Swagger, Docker dhe gjëra të tjera të dobishme dhe të njohura për ju.
Gjithashtu, ne përdorim jo vetëm teknologjitë që janë të disponueshme në treg, por zhvillojmë edhe disa gjëra vetë. Për shembull, ne krijojmë shërbime për integrimin e sistemeve me njëra-tjetrën, domethënë një API për mbledhjen e metrikave. Gjithashtu punojmë mbi sistemet tona të monitorimit — në nivelin e metrikave të biznesit përdorim teste UI. Po ashtu, kemi një bot në Telegram për njoftimin e ekipeve.
Dhe ne gjithashtu përpiqemi ta bëjmë sistemin e monitorimit të aksesueshëm për ekipet, në mënyrë që ato të mund të ruajnë metrikat e tyre dhe të punojnë me to, përfshirë konfigurimin e paralajmërimeve në disa metrika të ngushta që nuk kanë një përdorim shumë të gjerë.
Në kuadër të gjithë sistemit, ne synojmë proaktivitetin dhe lokalizimin e shpejtë të incidenteve. Për më tepër, numri i mikrosistemeve dhe sistemeve tona ka pësuar një rritje të ndjeshme kohët e fundit, duke shkaktuar edhe rritjen e numrit të integrimeve. Si pjesë e optimizimit të procesit të diagnostikimit të incidenteve në nivelin e integrimit, ne jemi duke zhvilluar një sistem që lejon kontrollin ndër-sistemor dhe nxjerrjen e rezultateve, duke ndihmuar në identifikimin e problemeve kryesore lidhur me importet dhe ndërveprimin midis sistemeve.
Natyrisht, kemi ende shumë për të rritur dhe zhvilluar në fushën e operimit të sistemeve, dhe jemi duke punuar intensivisht mbi këtë. Më shumë rreth sistemit tonë të monitorimit mund të lexoni .
Testet teknike
Sergei Orlov, drejton qendrën e kompetencës për zhvillimin e uebit dhe mobilit
Që nga fillimi i mbylljes së dyqaneve fizike, na është dashur të përballim prova të ndryshme nga pikëpamja e zhvillimit. Në radhë të parë, një rritje e ngarkesës si e tillë. Është e qartë se nëse nuk merren masa përkatëse, me një ngarkesë të madhe, sistemi mund të shndërrohet në një përvojë të pakëndshme, ose të degradon në performancë, ose madje të humbas kompleksi i funksionimit të tij.
Aspakti i dytë, pak më pak i dukshëm, është se sistemi nën ngarkesë të lartë duhej të ndryshohej shumë shpejt, duke u adaptuar për ndërrimet e proceseve të biznesit. Herë pas here disa herë në ditë. Në shumë kompani ka një rregull që gjatë aktiviteteve të mëdha marketingu nuk duhet të bëhen asnjë ndryshim në sistem. Asnjë, le të funksionojë siç është.
Por ne kishim, në thelb, një të premte të pakufizuar të zezë, gjatë së cilës duhej të ndryshonim sistemin. Dhe çdo gabim, problem, ose dështim në sistem do të ishte shumë i kushtueshëm për biznesin.
Duke kaluar përpara, mund të them se arritëm të përballojmë këto prova, të gjitha sistemet përballuan ngarkesën, u shkallëzuan lehtësisht, dhe nuk patëm ndonjë dështim teknik të rëndësishëm.
Ekzistojnë katër shtylla mbi të cilat mbështetet aftësia e sistemit për të përballuar ngarkesa të larta rampë. Shtylla e parë është monitorimi, për të cilin keni lexuar më lart. Pa një sistem të ndërtuar monitorimi, është praktikisht e pamundur të gjejmë ngushticat e sistemit. Një sistem i mirë monitorimi është si veshja e shtëpisë, ai duhet të jetë i rehatshëm dhe i adaptuar për ju.
Aspekti i dytë është testimi. Ne e marrim këtë moment shumë seriozisht: shkruajmë teste klasike unitare, integruese, teste ngarkese dhe shumë të tjera për çdo sistem. Gjithashtu, ne shkruajmë një strategji testimi dhe përpiqemi ta çojmë nivelin e testimit deri sa kontrolli manual të mos na nevojitet më.
Shtylla e tretë është CI/CD Pipeline. Proceset e ndërtimit, testimit dhe shpërndarjes së aplikacionit duhet të jenë sa më të automatizuara, nuk duhet të ketë ndërhyrje manuale. Tematika CI/CD Pipeline është mjaft e thellë dhe unë do ta prek vetëm pak. Duhet përmendur vetëm se ne kemi një listë kontrolli CI/CD Pipeline, me të cilën çdo ekip produkti kalon përmes qendrave të kompetencës.
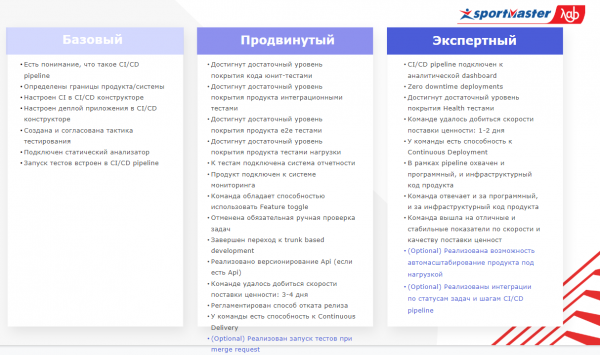 Ja lista e kontrollit
Kështu arrihen shumë qëllime. Kjo përfshin versionimin e API-së, dhe feature toggle, për të shmangur trenin e lëshimeve, si dhe arritjen e mbulimit të testeve të ndryshme në një nivel të tillë sa të automatizohet plotësisht testimi, dhe shpërndarjet të jenë pa ndërprerje etj.
Shtylla e katërt janë parimet arkitektonike dhe zgjidhjet teknike. Mund të flasim shumë dhe gjatë për arkitekturën, por dëshiroj të theksoj disa parime mbi të cilat dëshiroj të përqendrohem.
Së pari, duhet të zgjidhni mjete të specializuara për detyra të caktuara. Po, duket e qartë, dhe është e qartë se për të goditur gozhdë duhen përdorur çekiç, ndërsa për të çmontuar orët duhen përdorur dhëmbëz të veçantë. Por në epokën tonë, shumë mjete synojnë të jenë universale, për të përfshirë një segment maksimal përdoruesish: bazat e të dhënave, cachët, framework-et dhe të tjera. Për shembull, nëse marrim bazën e të dhënave MongoDB, ajo punon me transaksione multidokumentar, ndërsa baza e të dhënave Oracle punon me json. Dhe duket se gjithçka mund të përdoret për çdo gjë. Por nëse ne jemi për performancën, duhet të kuptojmë qartë pikët e forta dhe të dobëta të çdo mjeti dhe të përdorim ato që na nevojiten për klasën tonë të detyrave.
Së dyti, gjatë projektimit të sistemeve, çdo rritje e kompleksitetit duhet të jetë e arsyetuar. Duhet të mbajmë vazhdimisht këtë në mendje; parimi i low coupling është i njohur për të gjithë. Unë besoj se ai duhet të zbatohet si në nivelin e shërbimit konkret, ashtu edhe në atë të gjithë sistemit, dhe në nivelin e peizazhit arkitektural. Gjithashtu, është e rëndësishme të kemi aftësinë e shkallëzimit horizontal të çdo komponente të sistemit në rast ngarkese. Nëse kemi këtë aftësi, shkallëzimi nuk do të jetë asnjëherë një problem.
Nëse flasim për zgjidhje teknike, kemi kërkuar nga ekipet produktore të përgatisin një set të ri rekomandimesh, idesh dhe zgjidhjesh që ata kanë realizuar gjatë përgatitjes për valën e ardhshme të ngarkesës.
Cachët
Është e nevojshme të qasemi me vetëdije ndaj zgjedhjes së cachëve lokale dhe të shpërndarë. Ndonjëherë ka kuptim të përdoren të dyja brenda një sistemi. Për shembull, ne kemi sisteme, ku një pjesë e të dhënave në thelb është një cache vitrine, domethënë burimi i përditësimeve ndodhet jashtë vetë sistemit, dhe sistemi nuk e ndërron atë të dhënë. Për këtë qasje ne përdorim Caffeine Cache lokale.
Dhe ka të dhëna që sistemi i ndryshon aktivisht gjatë punës, dhe këtu aplikojmë cache-n e shpërndarë me Hazelcast. Kjo qasje na mundëson të shfrytëzojmë avantazhet e cache-së së shpërndarë atje ku ato vërtet janë të nevojshme dhe të minimizojmë shpenzimet shërbyese për qarkullimin e të dhënave në klasterin Hazelcast atje ku mund të ja dalim pa to. Kemi shkruar shumë për cache-t. dhe .
Për më tepër, kalimi në serializuesin Kryo në Hazelcast na ka dhënë një rritje të mirë. Dhe kalimi nga ReplicatedMap në IMap + Near Cache në Hazelcast na ka lejuar të minimizojmë lëvizjen e të dhënave nëpër klaster.
Një këshillë e vogël: kur bëni invalidimin masiv të caches, nganjëherë aplikohet taktika e ngrohjes së caches të dytë me kalimin e mëpasshëm në të. Mund të duket se, me këtë qasje, duhet të kemi një konsum të dyfishtë të memories, por në praktikë, në ato sisteme ku kjo është praktikuar, konsumimi i memories është zvogëluar.
Staku reaktiv
Ne përdorim stakun reaktiv në një numër të konsiderueshëm sistemesh. Në rastin tonë, kjo është Webflux ose Kotlin me korutina. Staku reaktiv është veçanërisht efektiv aty ku presim operacione të ngadalta të input-output. Për shembull, thirrje të shërbimeve të ngadalta, punë me sistemin e skedarëve ose me sistemet e ruajtjes.
Principi më i rëndësishëm është të shmangni thirrjet bllokuese. Nën kapakun e framework-eve reaktive, ka një numër të vogël shërbimesh aktive. Nëse me kujdes lejojmë veten të bëjmë një thirrje të drejtpërdrejtë bllokuese, si thirrjen e driver-it JDBC, sistemi thjesht do të ndalojë.
Dëshironi të ktheni gabimet në përjashtime runtime të vetat. Procesi real i ekzekutimit të programit kalon në framework-et reaktive, ekzekutimi i kodit bëhet jo-lineare. Si pasojë, është shumë e vështirë të diagnostikosh problemet përmes stack-trace-ve. Zgjidhja këtu do të ishte krijimi i përjashtimeve runtime objektive dhe të qarta për çdo gabim.
Elasticsearch
Kur përdorni Elasticsearch, mos zgjidhni të dhëna që nuk përdoren. Ky është një këshillë shumë e thjeshtë, por shpesh harrohet. Nëse duhet të zgjidhni më shumë se 10,000 regjistrime njëherësh, duhet të përdorni Scroll. Nëse bëjmë një analogji, është paksa si një kursori në një bazë të dhënash relationale.
Mos përdorni postfilter pa nevojë. Me të dhëna të mëdha në përzgjedhjen kryesore, kjo operacion ngarkon shumë bazën e të dhënave.
Përdorni operacione bulk aty ku është e aplikueshme.
API
Kur projektoni API, vendosni kërkesa për minimizimin e të dhënave të transferuara. Kjo është veçanërisht e rëndësishme në ndërlidhjen me frontin: pikërisht në këtë pikë ne dalim përtej kanaleve të Qendrave tona të të Dhënave dhe tashmë punojmë në kanalin që na lidh me klientin. Nëse ka probleme të vogla atje, trafik i tepërt e sjell një përvojë negative për përdoruesin.
Dhe, më në fund, mos e derdhni të gjithë masën e të dhënave, qartë qasuni kontratës mes konsumatorëve dhe furnizuesve.
Transformimi organizativ
Eroshkina Elena, zëvendës drejtoreshë për IT
Në momentin kur ndodhi karantina dhe u shfaq nevoja për të rritur ndjeshëm ritmin e zhvillimit online dhe për të zbatuar shërbime omnichannel, ne ishim tashmë në procesin e transformimit organizativ.
Një pjesë e strukturës tonë u kalua në punën sipas parimeve dhe praktikave të qasjes produktive. U formuan ekipe, të cilat tani janë përgjegjëse për funksionimin dhe zhvillimin e secilit produkt. Punonjësit në këto ekipe janë angazhuar në 100% dhe e organizojnë punën e tyre sipas Scrum ose Kanban, në varësi të asaj që është më e preferueshme për ta, rregullojnë linjën e shtrirjes, zbatojnë praktikat teknike, praktikat e sigurimit të cilësisë dhe shumë të tjera.
Me fat, pjesa më e madhe e atyre ekipeve produktive ndodhej pikërisht në fushën e shërbimeve online dhe omnichannel. Kjo na lehtësoi të kalonim në mënyrë të shpejtë (seriozisht, për dy ditë) në një mod nga distanca pa humbur efikasitetin. Procesi i vendosur na lejoi të adaptoheshim shpejt në kushtet e reja të punës dhe të mbanim një ritëm të mjaftueshëm të dorëzimit të funksionaliteteve të reja.
Për më tepër, na u shfaq nevoja të forcojmë ato ekipe që ndodhen në frontierin e biznesit online. Në atë moment, u bë e qartë se mund ta bënim këtë vetëm përmes burimeve të brendshme. Dhe rreth 50 njerëz brenda dy javësh ndryshuan fushën, ku kishin punuar më parë dhe u integruan në punën mbi një produkt të ri për ta.
Për këtë, nuk nevojiteshin ndonjë përpjekje të veçanta menaxheriale, sepse përveç organizimit të procesit tonë, me përmirësimin teknik të produktit, me praktikat e sigurimit të cilësisë, ne i mësojmë ekipet tona për autodashuri — të menaxhojnë procesin e tyre të prodhimit pa angazhuar burime administrative.
Ne menaxhuar burimin, arritëm ta fokusohemi pikërisht aty ku ishte e nevojshme në atë moment, - në koordinimin me biznesin: Çfarë është aktualisht e rëndësishme për klientin tonë, cila funksionalitet duhet të implementohet si prioritet, çfarë duhet të bëjmë për të rritur kapacitetin tonë për dërgesë dhe përpunim të porosive. Të gjitha këto dhe një model i qartë role na lejuan që në këtë periudhë të mundohemi të ngarkojmë proceset tona prodhuese me atë që është vërtet e rëndësishme dhe e nevojshme.
E qartë, në punën e largët dhe me ritmin e lartë të ndryshimeve, kur pjesëmarrja e secilit ndikon në treguesit e biznesit, nuk mund të mbështetemi vetëm në ndjenjat e brendshme si "A po na shkon mirë? Po, mendoj se po". Kërkohen matjet objektive të procesit prodhues. Këto i kemi, janë të-accessueshme për secilin këtu që interesohet për matjet e ekipeve produktive. Para gjithçkaje, për ekipin e vet, biznesin, kolegët dhe menaxhmentin.
Çdo dy javë me secilën ekip organizohet një status, ku për 10 minuta analizohen metrikat, identifikohen ngushticat e procesit prodhues dhe zhvillohet një zgjidhje e përbashkët: çfarë mund të bëhet që këto ngushtica të eliminohen. Po ashtu, mund të kërkohet menjëherë ndihma nga menaxhmenti nëse ndonjë problem i identifikuar ndodhet jashtë zonës së influencës së ekipeve, ose ekspertizës së kolegëve të cilët, ndoshta, kanë hasur në probleme të ngjashme.
Megjithatë, ne e kuptojmë se për të shpejtuar shumë herë (sikur e kemi vendosur këtë si qëllim), na nevojitet të mësojmë shumë gjëra dhe t'i implementojmë në punën tonë të përditshme. Tani jemi duke vazhduar me shkallëzimin e qasjes produktive në ekipe të tjera dhe në produkte të reja. Për këtë na ndihmoi të përvetësojmë një format të ri për ne, shkollën online për metodologët.
Metodologët, njerëzit që ndihmojnë ekipet të ndërtkojnë procesin, të përmirësojnë komunikimin, të rrisin efikasitetin e punës, në thelb janë agjentë të ndryshimit. Tani, absolvimet tona të grupit të parë po punojnë me ekipet dhe u ndihmojnë atyre të bëhen të suksesshëm.
Mendoj se situata që kemi krijuar ofron mundësi dhe perspektiva të tilla, të cilat ndoshta as ne nuk i kuptojmë plotësisht ende. Por përvoja dhe praktika që po fitojmë tani konfirmojnë se kemi zgjedhur rrugën e duhur të zhvillimit, nuk do të humbasim këto mundësi të reja në të ardhmen dhe do të jemi gjithashtu në gjendje të përgjigjemi në mënyrë efektive ndaj sfidave që do të paraqiten për "Sportmaster".
Përfundimet
Gjatë këtij kohe të vështirë, ne formuluam parimet kryesore mbi të cilat mbështetet zhvillimi i softuerit, të cilat mendoj se do të vlejnë për çdo kompani që merret me këtë.
NjerëzitKjo është ajo mbi të cilën bazohet gjithçka. Punonjësit duhet të gëzojnë nga puna, të kuptojnë qëllimet e kompanisë dhe qëllimet e produkteve me të cilat merret. Dhe, natyrisht, të kenë mundësi për zhvillim profesional.
ShkencaËshtë e nevojshme që kompania të afrojë një qasje të zhvilluar ndaj punës me stivën e saj teknologjike dhe të rrisë kompetencat atje ku është realisht e nevojshme. Tingëllon shumë e thjeshtë dhe e dukshme. Dhe shpesh neglizhohet.
ProcesetËshtë e rëndësishme të organizohet siç duhet puna e ekipeve të produkteve dhe qendrave të kompetencës, për të ndërtuar bashkëpunimin me biznesin, në mënyrë që të punosh me të si një partner.
Në përgjithësi, kështu e kaluam. Teza kryesore e kohërave moderne u konfirmua edhe një herë, duke bërë një goditje të fortë në ballë.
Edhe nëse je një biznes i madh offline me shumë dyqane dhe shumë qytete, zhvillo online tëndin. Nuk është thjesht një kanal shtesë shitjeje apo një aplikacion i bukur, përmes të cilit gjithashtu mund të blihen gjëra (edhe sepse konkurentët kanë gjithashtu një aplikacion të bukur). Nuk është një rezervë për çdo rast, që do të ndihmojë për të kaluar stuhinë.
Është një nevojë e vërtetë. Për të cilën duhet të jenë të gatshëm jo vetëm kapacitetet teknike dhe infrastruktura, por edhe njerëzit dhe proceset. Sepse, blerja e shpejtë e memories, hapësirës, shpërndarja e instancave të reja dhe të tjera mund të bëhet për disa orë. Por njerëzit dhe proceset duhet të përgatiten paraprakisht për një gjë të tillë.
Burimi: habr.com
