

Më 9 janar u publikua Pandas 1.0.0rc. Versioni i mëparshëm i bibliotekës ishte 0.25.
Publikimi i parë kryesor përmban shumë risitë të shkëlqyera, përfshirë përmirësimin e përllogaritjes automatike të DataFrame-ve, më shumë formate të daljes, lloje të reja të të dhënave dhe madje një faqe të re dokumentacioni.
Të gjitha ndryshimet mund të shihen , në këtë artikull do të ndalemi në një përmbledhje më të vogël, më pak teknike të asaj që është më e rëndësishme.
Të instaloni bibliotekën mund të bëni si zakonisht me pip, por pasi në momentin e shkrimit të artikullit Pandas 1.0 ende është candidat për publikim, do të duhet të përcaktoni qartë versionin:
pip install --upgrade pandas==1.0.0rc0Keni kujdes: pasi ky është një publikim kryesor, përditësimi mund të dëmtojë kodin e vjetër!
Për më tepër, me këtë version është ndaluar plotësisht mbështetje për Python 2 (gjë që mund të jetë një arsyetim i mirë — shën. i përkth.). Pandas 1.0 kërkon të paktën Python 3.6+, kështu që nëse nuk jeni të sigurt, kontrolloni se cilin keni instaluar:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Kontrolli i versionit të Pandas është më së lehti kështu:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Përllogaritje më e mirë automatike me DataFrame.info
Risia ime e preferuar është përditësimi i metodës DataFrame.info. Funksioni tani është bërë shumë më i lexueshëm, duke e bërë procesin e shqyrtimit të të dhënave edhe më të lehtë:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Shfaqja e tabelave në formatin Markdown
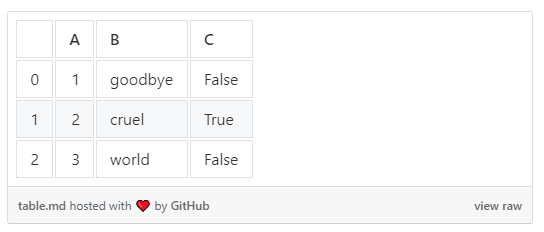
Një tjetër risitë e këndshme ishte mundësia për të eksportuar DataFrame-t në tabela Markdown me ndihmën e DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Kjo e bën ndjeshëm më të lehtë publikimin e tabelave në faqe si Medium duke përdorur github gists.
Lloje të reja për vargjet dhe vlerat logjike
Në publikimin e Pandas 1.0 janë shtuar gjithashtu të reja eksperimentale llojra. API i tyre edhe mund të ndryshojë, prandaj përdoreni me kujdes. Por në përgjithësi, Pandas rekomandon përdorimin e llojeve të reja kudo që kjo ka kuptim.
Derisa tani duhet ta bëni konvertimin në mënyrë të qartë:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Kujdesi për si kolona Dtype shfaq tipet e reja — string dhe bool.
Tipi më i dobishëm i ri të vargjeve është mundësia për të zgjedhur vetëm kolonat e vargjeve nga dataframe-të. Kjo mund të thjeshtojë ndjeshëm analizimin e të dhënave tekstuale:
df.select_dtypes("string")Më parë, kolonat e vargjeve nuk mund të zgjidheshin pa specifikuar emrat e tyre.
Më shumë për tipet e reja mund të lexoni .
Faleminderit që e lexuat! Lista e plotë e ndryshimeve, siç është përmendur tashmë, mund të shikohet .
Burimi: habr.com
