

Më 10 gusht në Slërm nisi , në të cilin analizojmë atë plotësisht — nga abstraksionet bazë deri te parametrat e rrjetës.
Në këtë artikull do të flasim për historinë e shfaqjes së Docker dhe abstraksionet e tij kryesore: Image, Cli, Dockerfile. Lekura është e përgatitur për fillestarët, prandaj është e vështirë që të jetë interesante për përdoruesit e avancuar. Nuk do të ketë gjak, apendiks dhe zhytje të thellë. Bazat e thjeshta.
Çfarë është Docker
Le të shohim definicionin e Docker nga Wikipedia.
Docker është një software për automatizimin e shpërndarjes dhe menaxhimin e aplikacioneve në mjedise që mbështesin kontenierizimin.
Nga ky përkufizim nuk kuptohet asgjë. Sidomos nuk kuptohet çfarë do të thotë "në mjedise që mbështesin kontenierizimin". Për të kuptuar, le të kthehemi në të kaluarën. Të fillojmë nga epoka, të cilën e quaj "Era Monolitike".
Era Monolitike
Era Monolitike — është fillimi i viteve 2000 kur të gjitha aplikacionet ishin monolitike, me shumë varësi. Zhvillimi zgjaste gjatë. Në këtë kohë serverët nuk ishin aq shumë, i njihnim të gjithë me emra dhe i monitoronim. Ka një krahasim të këndshëm:
Kafshët shtëpiake — Në epokën monolitike, ne u sillnim serverëve tanë si ndaj kafshëve shtëpiake, i kujdeseshim dhe i përkëdhelim, duke e hequr pluhurin me kujdes. Për menaxhim më të mirë të burimeve përdornim virtualizimin: merrnim një server dhe e ndajmë në disa makina virtuale, duke siguruar kështu izolimin e mjedisit.
Sistemet e virtualizimit bazuar në hipervizorë
Sigurisht, të gjithë kanë dëgjuar për sistemet e virtualizimit: VMware, VirtualBox, Hyper-V, Qemu KVM etj. Ato sigurojnë izolimin e aplikacioneve dhe menaxhimin e burimeve, por kanë edhe disavantazhe. Për të bërë virtualizimin, nevojitet një hipervizor. Dhe hipervizori është një ngarkesë burimesh. Gjithashtu, makina virtuale vetë është zakonisht një makinë e madhe — një imazh i rëndë, në të cilin ndodhet sistemi operativ, Nginx, Apache, ndoshta dhe MySQL. Imazhi është i madh, dhe operimi me makinat virtuale mund të jetë i ngadaltë. Për të zgjidhur këtë problem, u krijuan sistemet e virtualizimit në nivelin e bërthamës.
Sistemet e virtualizimit në nivelin e bërthamës
Virtualizimi në nivelin e bërthamës mbështetet nga sistemet OpenVZ, Systemd-nspawn, LXC. Një shembull i spikatur i kësaj virtualizimi është LXC (Linux Containers).
LXC — një sistem virtualizimi në nivelin e sistemit operativ për të drejtuar disa ekzemplarë të izoluar të sistemit operativ Linux në një nod. LXC nuk përdor makina virtuale, por krijon një ambient virtual me hapësirë procesesh dhe një stack rrjeti të vetin.
Në thelb, LXC krijon kontejnerë. Cila është diferenca midis makinave virtuale dhe kontejnerëve?
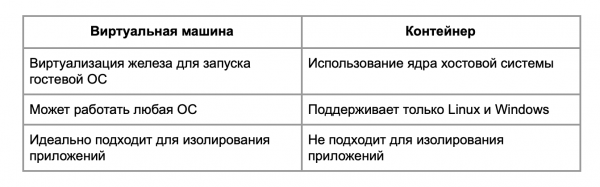
Kontejneri nuk është i përshtatshëm për izolimin e proceseve: në sistemet e virtualizimit në nivelin e bërthamës gjen dritare të sigurisë që lejojnë të dalin nga kontejneri në host. Prandaj, nëse ju nevojitet të izoloni diçka, është më mirë të përdorni një makinë virtuale.
Diferencat midis virtualizimit dhe kontejnerizimit mund të shihen në një skemë.
Ka hipervizorë të harduerit, hipervizorë mbi OS dhe kontejnerë.
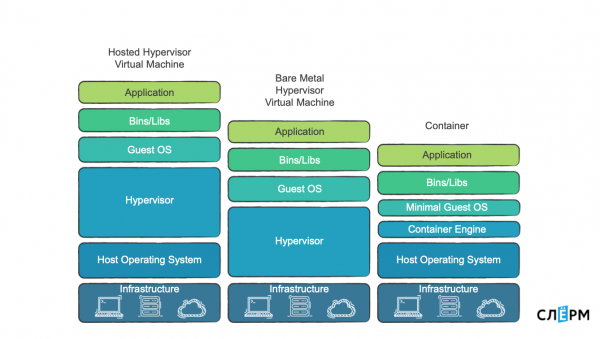
Hipervizorët 'e harduerit' janë një gjë e bukur, nëse vërtet dëshironi të izoloni diçka. Sepse aty ka mundësi për izolim në nivelin e faqeve të memories, procesorëve.
Ka hipervizorë si programe, dhe ka kontejnerë, për të cilët do të flasim më tej. Në sistemet e kontejnerizimit nuk ka hipervizor, por ka një Container Engine që krijon dhe menaxhon kontejnerët. Kjo është më e lehtë, prandaj për shkak të punës me bërthamën overhead është më e vogël, ose nuk ka fare.
Çfarë përdoret për kontejnerizim në nivelin e bërthamës
Teknologjitë kryesore që lejojnë krijimin e një kontejneri të izoluar nga proceset e tjera janë Namespaces dhe Control Groups.
Namespaces: PID, Networking, Mount dhe User. Ka edhe të tjera, por për thjeshtësinë e kuptimit do të ndalemi tek këto.
PID Namespace kufizon proceset. Kur ne, për shembull, krijojmë një PID Namespace, dhe vendosim aty një proces, ai bëhet me PID 1. Zakonisht në sistemet, PID 1 është systemd ose init. Prandaj, kur ne vendosim një proces në një namespace të ri, ai gjithashtu merr PID 1.
Networking Namespace lejon kufizimin/izolimin e rrjetit dhe brenda tij mund të vendosen ndërfaqet e veta. Mount është kufizimi mbi sistemin e skedarëve. User është kufizim mbi përdoruesit.
Control Groups: Memory, CPU, IOPS, Network — rreth 12 konfigurime gjithsej. Ndryshe quhen edhe Cgroups ('C-grupet').
Control Groups menaxhojnë burimet për kontejnerin. Nëpërmjet Control Groups mund të themi se kontejneri nuk duhet të konsumojë më shumë se një sasi të caktuar burimesh.
Për të funksionuar plotësisht, kontenierizimi përdor teknologji shtesë: Capabilities, Copy-on-write dhe të tjera.
Capabilities është kur i themi procesit se çfarë mund të bëjë dhe çfarë jo. Në nivelin e bërthamës, janë thjesht harta bit për shumë parametra. Për shembull, përdoruesi root ka privilegje të plota, mund të bëjë gjithçka. Një server i kohës mund të ndryshojë kohën sistemike: ai ka capabilities për Time Capsule, dhe gjithçka. Me ndihmën e privilegjeve mund të rregullojmë në mënyrë fleksibile kufizimet për proceset, duke siguruar vetën.
Sistemi Copy-on-write na lejon të punojmë me imazhe Docker, duke i përdorur ato më efikas.
Aktualisht Docker ka probleme me përputhshmërinë e Cgroups v2, prandaj ky artikull shqyrton pikërisht Cgroups v1.
Por le të kthehemi në histori.
Kur u shfaqën sistemet e virtualizimit në nivelin e bërthamës, ato filluan të aplikohen intensivisht. Overhedi në hipervizor humbi, por disa probleme mbetën:
- imazhe të mëdha: në të njëjtën OpenVZ shtyjnë sistemin operativ, bibliotekat, një mori software-t, dhe në fund imazhi ende rezulton të jetë i madh;
- nuk ka një standard të mirë për paketimin dhe dërgimin, prandaj mbetet problemi i varësive. Ka raste kur dy copa kodi përdorin një bibliotekë, por me versione të ndryshme. Ndërmjet tyre mund të ketë një konflikt.
Për të zgjidhur të gjitha këto probleme, erdhi epoka e ardhshme.
Epoka e kontenierëve
Kur erdhi Epoka e kontenierëve, ndryshoi filozofia e punës me to:
- Një proces — një kontenier.
- Të gjitha varësitë e nevojshme për procesin i dërgojmë në kontenierin e tij. Kjo kërkon që të prishim monolitët në mikroshërbime.
- Sa më e vogël të jetë imazhi, aq më mirë — më pak vulnerabilitete të mundshme, shkarkim më të shpejtë dhe kështu me radhë.
- Instancat bëhen efemere.
Mos harroni, thashë për kafshët shtëpiake vs bagëtitë? Disa kohë më parë instancat ishin si kafshë shtëpiake, ndërsa tani janë si bagëtia. Disa kohë më parë ishte një monolit — një aplikacion. Tani janë 100 mikroshërbime, 100 kontenierë. Disa kontenierë mund të kenë 2-3 replikat. Nuk është kaq e rëndësishme të kontrollojmë çdo kontenier. Ajo që na intereson më shumë është disponueshmëria e shërbimit të vetë: asaj që bën ky grup kontenierësh. Kjo ndryshon qasjet në monitorim.
Në vitet 2014-2015 ndodhi lulëzimi i Docker — asaj teknologjie që do të flasim tani.
Docker ka ndryshoi filozofinë dhe standardizoi paketimin e aplikacionit. Me Docker, ne mund të paketojmë një aplikacion, ta dërgojmë në një depo, ta shkarkojmë nga aty dhe ta deploy-më.
Në kontejnerin Docker ne përfshijmë gjithçka që na nevojitet, kështu që zgjidhet problemi i varësive. Docker garanton riprodhueshmërinë. Mendoj se shumë njerëz janë përballur me problemin e mosriprodhueshmërisë: gjithçka funksionon, e dërgon në prodhim dhe atje ndalon së funksionuari. Me Docker ky problem zhduket. Nëse kontejneri yt Docker nis dhe bën atë që duhet të bëjë, ka një mundësi të madhe që ai të nisë në prodhim dhe atje të bëjë të njëjtën gjë.
Shkurtim mbi overhead
Për overhead ka debate të vazhdueshme. Disa mendojnë se Docker nuk sjell ngarkesë shtesë, sepse përdor bërthamën Linux dhe të gjithë proceset e nevojshme për containerizimin. Thonë, 'nëse thoni se Docker është overhead, atëherë edhe bërthama Linux është overhead'.
Nga ana tjetër, nëse zhytemi pak më thellë, vërtet në Docker ka disa gjëra për të cilat mund të thuhet ndryshe se janë overhead.
E para është namespace i PID. Kur vendosim një proces në namespace, atij i jepet PID 1. Në të njëjtën kohë, ky proces ka një PID tjetër, i cili ndodhet në namespace-n e host-it, jashtë kontejnerit. Për shembull, nëse nisëm Nginx në kontejner, ai bëhet PID 1 (procesi master). Dhe në host, ai ka PID 12623. Është e vështirë të thuhet se sa është kjo overhead.
Së dyti është Cgroups. Të merremi me Cgroups për kujtesën, pra mundësia për të kufizuar kujtesën e një konteneri. Kur ajo aktivizohet, aktivizohen ndjesa, memory accounting: bërthama duhet të kuptojë sa faqe janë ndarë dhe sa ende janë të lira për këtë kontenere. Kjo mund të jetë overhead, por nuk kam parë studime të sakta se si ndikon në performancë. As nuk kam vërejtur që një aplikacion i nisur në Docker papritmas të humbiste në performancë.
Dhe një vërejtje tjetër mbi performancën. Disa parametra të bërthamës përcillen nga host-i në kontejner. Në veçanti, disa parametra rrjeti. Prandaj, nëse dëshiron të nisësh diçka me performancë të lartë në Docker, për shembull, diçka që do të përdorë intensivisht rrjetin, duhet të ndryshosh këta parameter. Një shembull është nf_conntrack.
Për konceptin e Docker
Docker përbëhet nga disa komponentë:
- Docker Daemon — ai është motori i konteinerëve; запуска контейнеры.
- Docker CII — utiliteti për menaxhimin e Docker.
- Dockerfile — udhëzimi se si të ndërtohet imazhi.
- Image — imazhi, nga i cili krijohet kontenieri.
- Container.
- Docker registry — depo imazhesh.
Përskaj kësaj duket kështu:
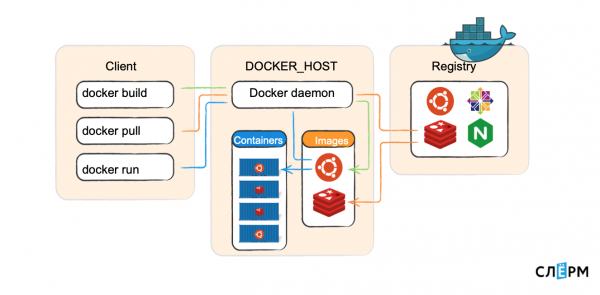
Në Docker_host punon Docker daemon, që nis kontenierët. Ka një Client, i cili dërgon komanda: ndërto imazhin, shkarko imazhin, nise kontenierin. Docker daemon shkon në registry dhe i realizon ato. Docker-client mund të lidhet si lokal (në socket-in e unix-it), ashtu edhe përmes TCP nga një host të largët.
Le të kalojmë përmes secilit komponent.
Docker daemon (demon) — është pjesa server, ajo punon në makinën host: shkarkon imazhe dhe nis nga ato kontenierë, krijon rrjet midis kontenierëve, mbledh loge. Kur themi "krijo imazh", këtë e bën gjithashtu demon.
Docker CLI — është pjesa klient e Docker, utiliteti në konsolë për të punuar me demonin. E përsëris, ajo mund të punojë jo vetëm lokal, por edhe në rrjet.
Komandat bazë:
docker ps — tregon kontenierët që tani po funksionojnë në Docker-host.
docker images — tregon imazhet e shkarkuara lokal.
docker search — kërkimi i imazhit në registry.
docker pull — shkarkoni imazhin nga registry në makinë.
docker build <> — ndërto imazhin.
docker run — nise kontenierin.
docker rm — fshij kontenierin.
docker logs — loget e kontenierit.
docker start/stop/restart — puna me kontenierin.
Nëse ju e mbani mend me këto komanda dhe do t'i përdorni ato me besim, atëherë mund të thoni se e keni zotëruar Docker-in në nivelin e përdoruesit në 70%.
Dockerfile 187х70
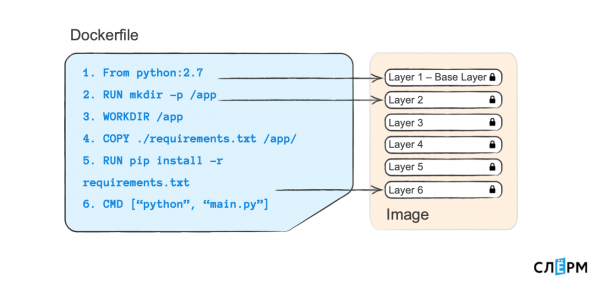
Kështu duket Dockerfile: në të majtë komandat, në të djathtë — argumentet. Çdo komandë që ndodhet këtu (dhe në përgjithësi shkruhet në Dockerfile), krijon një shtresë të re në Image.
Hostings.info saytında müştəri rəyləri
ProHoster rəyləri ditcoin1
Bitcoin-Cash
Ethereum GPay
Litecoin Ripple
USD-Tether
Zcash».
master2
Burimi: habr.com
