

Tani është një temë e njohur sot në DevOps. Kanali i integrimit dhe dorëzimit të përhershëm po implementohet nga të gjithë ata që kanë dëshirë. Por shumica nuk i kushtojnë gjithmonë vëmendjen e duhur sigurimit të besueshmërisë së operacioneve të sistemeve informacionit në faza të ndryshme të CI/CD Pipeline. Në këtë artikull, dëshiroj të flas për përvojën time në automatizimin e kontrollit të cilësisë së softuerit dhe realizimin e skenarëve të mundshëm për 'riparimin' e tij.
Unë punoj si inxhinier në departamentin e menaxhimit të shërbimeve IT në kompaninë . Direksioni im kryesor është implementimi i sistemeve të ndryshme për monitorimin e performancës dhe aksesit të aplikacioneve. Unë shpesh komunikoj me klientët IT nga segmente të ndryshme të tregut për çështje aktuale rreth monitorimit të cilësisë së shërbimeve të tyre IT. Detyra kryesore është të minimizojmë kohën e ciklit të lëshimit dhe të rrisim frekuencën e lëshimeve. Sigurisht, e gjithë kjo është e mirë: më shumë lëshime – më shumë funksionalitete të reja – më shumë përdorues të kënaqur – më shumë fitime. Por në fakt, gjithmonë nuk shkon ashtu siç duhet. Me ritmet shumë të larta të implementimit, menjëherë del në pah çështja e cilësisë së lëshimeve tona. Edhe nëse procesi është plotësisht i automatizuar, një nga problemet më të mëdha është kalimi i shërbimeve nga testimi në prodhim, pa ndikuar në kohën e funksionimit pa ndërprerje dhe ndërveprimi i përdoruesve me aplikacionin.
Pas bisedave të shumta me klientët, mund të them se kontrolli i cilësisë së lëshimeve, problemi i besueshmërisë së aplikacionit dhe mundësia e 'riparimit' të tij (p.sh., kthimi në një version të qëndrueshëm) në faza të ndryshme të kanaleve CI/CD janë disa nga temat më shqetësuese dhe aktuale.
Së fundmi, unë vetë punova nga ana e klientit - në shërbimin e mbështetjes për aplikacionet e bankave online. Në arkitekturën e aplikacionit tonë, ishte përdorur një numër i madh mikroshërbimesh të shkruara nga ne. Më e keqja është se jo të gjithë zhvilluesit ia dolën me ritmet e larta të vaksinimit, cilësia e disa mikroshërbimeve u përkeqësua, gjë që çoi në emra qesharakë për to dhe krijuesit e tyre. Përdoreshin legjenda mbi materialet me të cilat krijoheshin këto produkte.
«Vendosja e detyrës»
Frekuenca e lartë e lëshimeve dhe numri i madh i mikroshërbimeve sjellin vështirësi në kuptimin e punës së aplikacionit në tërësi, si në fazën e testimit, ashtu edhe në fazën e operimit. Ndryshimet ndodhin vazhdimisht dhe të kontrollosh ato pa mjete të mira monitorimi është shumë e vështirë. Shpesh, pas një lëshimi mbrëmje, mëngjesin zhvilluesit ndihen si në një bombë afatshkurtër dhe presin që asgjë të mos prishet, megjithëse në fazën e testimit të gjitha kontrollimet ishin të suksesshme.
Ka edhe një çështje tjetër. Në fazën e testimit kontrollohet funksionaliteti i softuerit: realizimi i funksioneve kryesore të aplikacionit dhe mungesa e gabimeve. Vlerësimet cilësore të performancës janë ose të mungueshme, ose nuk mbulojnë të gjitha aspektet e punës së aplikacionit dhe shtresës integruese. Disa metrika madje mund të mos verifikohen fare. Si rezultat, kur ndodh një defekt në mjedisin prodhues, departamenti i mbështetjes teknike merr vesh vetëm kur përdoruesit realë fillojnë të ankohem. Është e dëshirueshme të minimizohet ndikimi i softuerit të paqartë tek përdoruesit përfundimtarë.
Një nga mënyrat për të zgjidhur këtë është të implementohet procesi i kontrollit të cilësisë së softuerit në faza të ndryshme të CI/CD Pipeline, të shtohen skenarë të ndryshëm për rikuperimin e sistemit në rast të aksidenteve. Po ashtu, kujtojmë se kemi DevOps. Biznesi pret marrjen e re të produktit sa më shpejt të jetë e mundur. Prandaj, të gjitha kontrollimet dhe skenarët tanë duhet të jenë të automatizuar.
Detyra ndahen në dy komponente:
- kontrolli i cilësisë së ndërtimeve në fazën e testimit (automatizimi i procesit të identifikimit të ndërtimeve të paligjshme);
- kontrolli i cilësisë së softuerit në mjedisin prodhues (mekanizmat e zbulimit automatik të problemeve dhe skenarët e mundshëm për vetë-rikuperimin e tyre).
Instrument për monitorimin dhe grumbullimin e metricave
Për të realizuar detyrat e caktuara, nevojitet një sistem monitorimi që është i aftë të zbulojë probleme dhe t'i transmetojë ato në sistemet e automatizimit në etapa të ndryshme të konvejerit CI/CD. Gjithashtu, do të ishte një përfitim i madh nëse ky sistem ofron metrika të dobishme për ekipe të ndryshme: zhvillimi, testimi, operimi. Dhe do të ishte shumë e shkëlqyer nëse do të ishte e dobishme edhe për biznesin.
Për mbledhjen e metrikeve mund të përdoren një mori sistemesh të ndryshme (Prometheus, ELK Stack, Zabbix etj.), por, sipas mendimit tim, zgjidhjet e klasës APM janë më të përshtatshme për këto detyra (), të cilat mund të thjeshtojnë shumë jetën tuaj.
Në kuadër të punës sime në shërbimin e mbështetjes kam filluar të realizoj një projekt të ngjashëm, duke përdorur zgjidhjen e klasës APM nga kompania Dynatrace. Tani, duke punuar si integrues, e njoh shumë mirë tregun e sistemeve të monitorimit. Mendimi im subjektiv: Dynatrace është më e përshtatshme për zgjidhjen e këtyre detyrave.
Zgjidhja Dynatrace ofron një pamje horizontale të secilës operacion përdoruesi me një shkallë të thellë detajizimi deri në nivelin e ekzekutimit të kodit. Mund të ndjekësh të gjithë zinxhirin e ndërveprimit mes shërbimeve të ndryshme informative: nga nivelet e aplikacioneve web dhe mobile frontend, serverëve aplikacionësh back-end, autobusit të integrimit deri në thirrjen specifike në Baza të Dhënash.
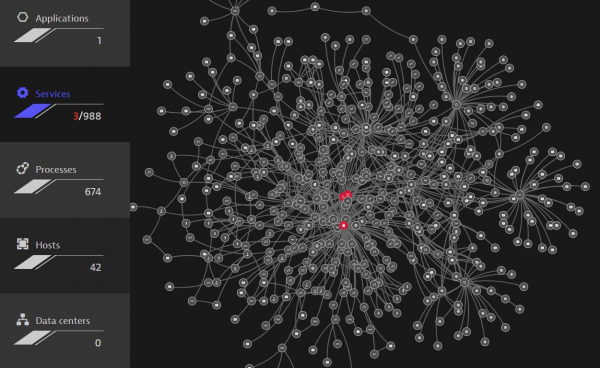 . Ndërtohen automatikisht të gjitha varësitë ndërmjet komponenteve të sistemit.
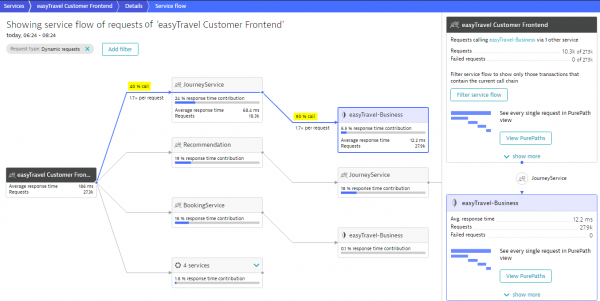 . Përcaktimi dhe ndërtimi automatik i rrugës së operacionit të shërbimit.
Gjithashtu, kujtojmë se na nevojitet të integrohemi me mjetet e ndryshme të automatizimit. Zgjidhja ka një API të përshtatshëm, që lejon dërgimin dhe marrjen e metrikeve dhe ngjarjeve të ndryshme.
Më pas, kalojmë në një shqyrtim më të detajuar se si të zgjidhim detyrat e vendosura duke përdorur sistemin Dynatrace.
Detyra 1. Automatizimi i kontrollit të cilësisë së ndërtimeve në fazën e testimit.
Detyra e parë është të gjejmë problemet sa më shpejt që të jetë e mundur në fazat e tavanit të shpërndarjes së aplikacioneve. Vetëm "ndërtimet e mira" të kodit duhet të arrijnë në ambientin prodhuese. Për këtë, në pipeline-in tuaj në fazën e testimit duhet të përfshihen monitorë të shtesë për të kontrolluar cilësinë e shërbimeve tuaja.
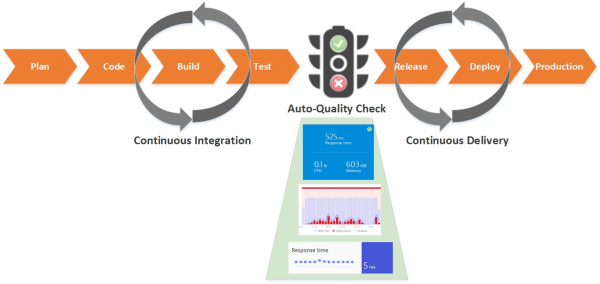
Le të shqyrtojmë hapat se si të realizojmë dhe automatizojmë këtë proces:
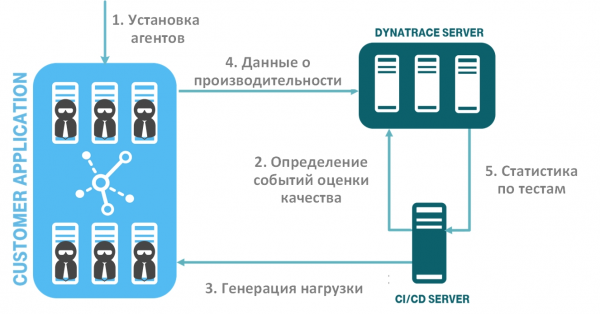
Në figurë tregohet fluksi i hapat të automatizuar për verifikimin e cilësisë së softuerit:
- ndërtimi i sistemit të monitorimit (instalimi i agenëve);
- përcaktimi i ngjarjeve për vlerësimin e cilësisë së softuerit tuaj (metrike dhe pragje) dhe dërgimi i tyre në sistemin e monitorimit;
- gjenerimi i ngarkesës dhe testeve të performancës;
- mbledhja e të dhënave për performancën dhe disponueshmërinë në sistemin e monitorimit;
- transferimi i të dhënave për testet e bazuara në ngjarje të vlerësimit të cilësisë së softuerit nga sistemi i monitorimit në sistemin CI/CD. Analiza automatike e ndërtimeve.
Hapi 1. Zbatimi i sistemit të monitorimit
Së pari, duhet të instaloni agjentët në mjedisin tuaj të testit. Zgjidhja Dynatrace ka një karakteristikë të këndshme – ajo përdor agjentin universal OneAgent, i cili instalohet në instancën e OS (Windows, Linux, AIX), zbulohet automatikisht shërbimet tuaja dhe fillon të mbledhë të dhënat e monitorimit për to. Nuk keni nevojë të konfiguroni veçmas agjent për çdo proces. Një situatë e ngjashme do të jetë për platformat në cloud dhe kontejnerët. Po ashtu, procesi i instalimit të agjentëve mund të automatizohet. Dynatrace përshtatet shkëlqyeshëm me konceptin e "infrastrukturës si kod" (): ka skripte dhe udhëzime për të gjitha platformat më popullore. E integroni agjentin në konfigurimin e shërbimit tuaj, dhe me zbatimin e tij merrni menjëherë një shërbim të ri me agjentin që funksionon tashmë.
Hapi 2. Caktimi i ngjarjeve të vlerësimit të cilësisë së softuerit tuaj
Tani është e nevojshme të përcaktoni listën e shërbimeve dhe operacioneve të biznesit. Është e rëndësishme të merrni parasysh ato operacione të përdoruesve që janë kritike për biznesin e shërbimit tuaj. Këtu rekomandoj që të konsultoheni me analistët e biznesit dhe sistemit.
Në vijim, duhet të përcaktoni se cilat metrike dëshironi të përfshini në verifikim për secilën nga nivelet. Për shembull, këto mund të jenë koha e ekzekutimit (me ndarjen në mesatare, median, percentilet etj.), gabimet (logjike, shërbimi, infrastrukturore etj.) dhe metrikat e ndryshme infrastrukturore (memory heap, garbage collector, numri i thread-eve etj.).
Për automatizimin dhe lehtësinë e përdorimit nga ekipi DevOps, shfaqet koncepti "Monitorimi si kod". Çfarë nënkuptoj me këtë – zhvilluesi/testuesi mund të shkruajë një skedar të thjeshtë JSON, i cili përcakton indikatorët e kontrollit të cilësisë së softuerit.
Le të shqyrtojmë një shembull të tillë të skedarit JSON. Si një çift çelës/vlerë përdoren objektet nga API i Dynatrace (përshkrimin e API mund ta shihni këtu ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
Skedari përbën një array definicionesh të serive të kohës (timeseries):
- timeseriesId – metrika që po kontrollohet, për shembull, Koha e Përgjigjes, Numri i Gabimeve, Memoria e Përdorur etj.;
- aggregation — niveli i agregatës së metrikave, në rastin tonë avg, por mund të përdorni çdo nivel që ju nevojitet (avg, min, max, sum, count, percentile);
- tags – etiketa e objektit në sistemin e monitorimit, ose mund të specifikoni një identifikues konkret të objektit;
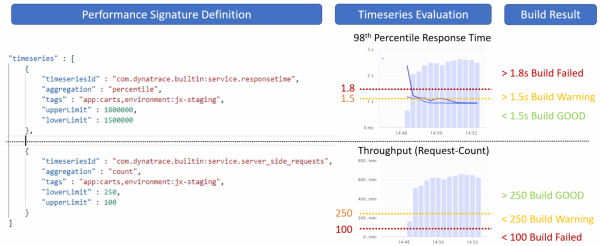
- severe dhe warning – këto tregues rregullojnë vlerat kufitare të metrikave tona, nëse vlera e testeve kalon kufirin severe, atëherë mbledhja jonë shënohet si e pasuksesshme.
Në figurën e mëposhtme paraqitet një shembull i përdorimit të këtyre threshold-eve.
Hapi 3. Gjenerimi i ngarkesës
Pasi të kemi përcaktuar nivelet e cilësisë së shërbimit tonë, është e nevojshme të gjenerojmë një ngarkesë testimi. Mund të përdorni çdo mjet testimi që ju përshtatet, për shembull, Jmeter, Selenium, Neotys, Gatling etj.
Sistemi i monitorimit Dynatrace lejon të kapni metadata të ndryshme nga testet tuaja dhe të njohësh se cili test i përket cilit cikël të lëshimit dhe cilit shërbim. Rekomandohet të shtoni metadatat shtesë në kërkesat HTTP të testeve.
Në figurën e mëposhtme paraqitet një shembull, ku me anë të etiketes shtesë X-Dynatrace-Test shënojmë se ky test i përket testimit të operacionit për shtimin e produktit në karrocë.
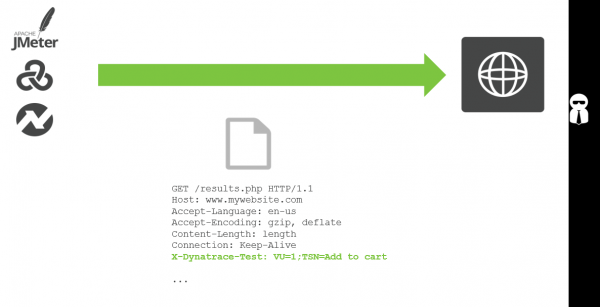
Me çdo test ngarkese që filloni, dërgoni informacion të shtuar kontekstual në Dynatrace nëpërmjet API-së së ngjarjeve nga serveri CI/CD. Në këtë mënyrë, sistemi mund të dallojë teste të ndryshme nga njëra-tjetra.
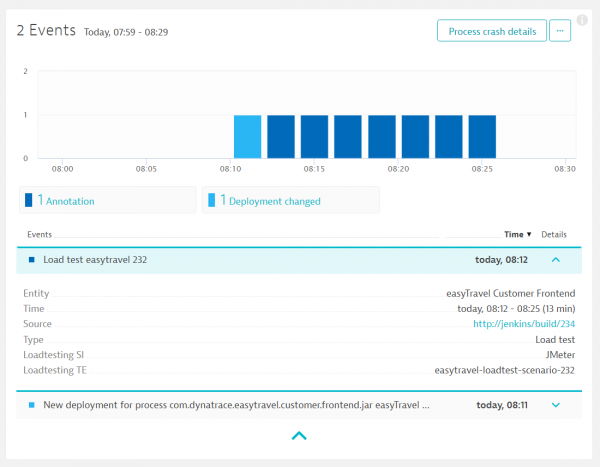 . Ngjarja në sistemin e monitorimit për fillimin e testimit të ngarkesës
Hapi 4-5. Grumbullimi i të dhënave mbi performancën dhe transmetimi i të dhënave në sistemin CI/CD
Së bashku me testin e gjeneruar, në sistemin e monitorimit dërgohet një ngjarje për nevojën e grumbullimit të të dhënave mbi vlerat e cilësisë së shërbimit. Gjithashtu, përcaktohet skedari ynë JSON, në të cilin përcaktohen metrikat kyçe.
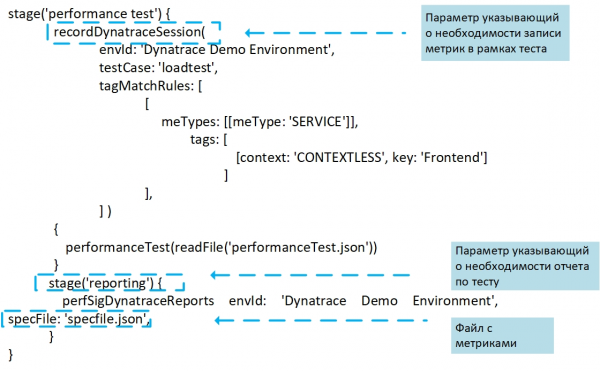 Një ngjarje e nevojes për të kontrolluar cilësinë e software-it që formohet në serverin CI/CD për t'u dërguar në sistemin e monitorimit
Në shembullin tonë, ngjarja e kontrollit të cilësisë quhet perfSigDynatraceReport (Performance_Signature) – është gati për integrim me Jenkins, e zhvilluar nga ekipet e T-Systems Multimedia Solutions. Në çdo ngjarje të nisjes së kontrollit përfshihet informacioni mbi shërbimin, numrin e ndërtimit, kohën e testimit. Shtesa mbledh vlerat e performancës gjatë ndërtimit, i vlerëson ato dhe krahasohet rezultati me ndërtimet e mëparshme dhe kërkesat jo-funksionale.
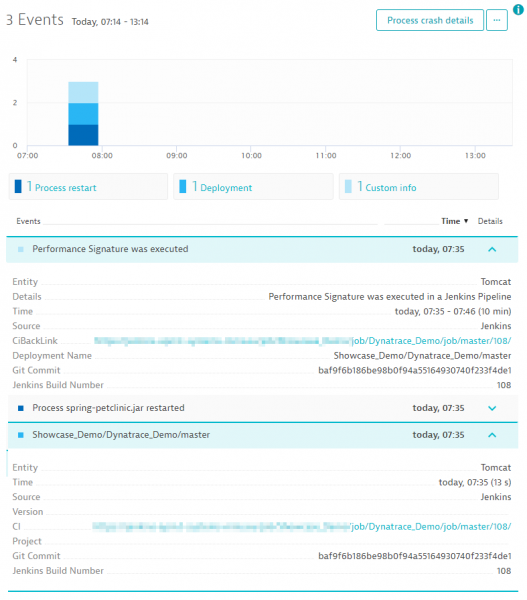 Ngjarja në sistemin e monitorimit për fillimin e kontrollit të cilësisë së ndërtimit.
Pas përfundimit të testit, të gjitha metrikat për vlerësimin e cilësisë së software-it dërgohen përsëri në sistemin e integrimit të vazhdueshëm, për shembull, Jenkins, i cili formon një raport mbi rezultatet.
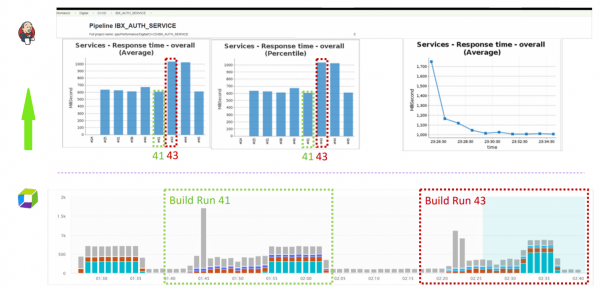 Rezultati i statistikave për ndërtimet në serverin CI/CD.
Për çdo ndërtim të veçantë ne shohim statistikat për secilën metrikë të caktuar prej nesh gjatë realizimit të gjithë testit. Ne gjithashtu shohim nëse ka pasur shkelje në disa vlera pragore (warning dhe severe thresholds). Bazuar në indikatorët e përbashkët, e gjithë ndërtimi shënohet si e qëndrueshme, e paqëndrueshme ose dështake. Gjithashtu, për lehtësinë tuaj, mund të shtoni në raportin e krahasimit të ndërtimit aktual me atë të mëparshmen.
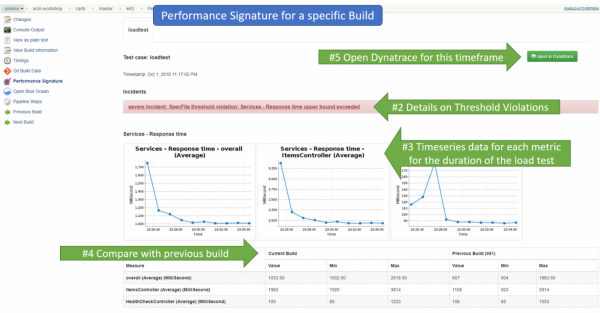 Shikimi i statistikave të detajuara për ndërtimet në serverin CI/CD.
Krahasimi i detajuar i dy ndërtimeve
Nëse është e nevojshme, mund të kaloni në ndërfaqen e Dynatrace dhe atje të shihni më në detaje statistikën për secilën nga ndërtimet tuaja dhe t'i krahasoni ato me njëra-tjetrën.
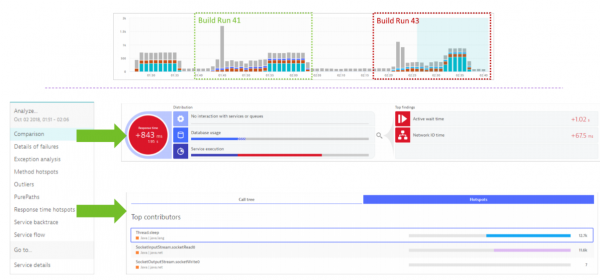 Krahasimi i statistikave për ndërtimet në Dynatrace.
Përfundimet
Në fund, ne marrim shërbimin "monitorim si shërbim", të automatizuar në procesin e integrimit të vazhdueshëm. Zhvilluesi apo testuesi vetëm duhet të përcaktojë listën e metrikave në skedarin JSON, ndërsa gjithçka tjetër ndodh automatikisht. Ne marrim një kontroll të qartë të cilësisë së lëshimeve: të gjitha njoftimet për performancën, konsumimin e burimeve ose regresionet arkitektonike.
Detyra 2. Automatizimi i kontrollit të cilësisë së software-it në ambientin prodhues
Kështu, ne zgjidhëm detyrën si të automatizojmë procesin e monitorimit në fazën e testimit në Pipeline. Kështu minimizojmë përqindjen e ndërtimeve jo cilësore që arrijnë në ambientin prodhues.
Porë, çfarë duhet të bëni nëse softueri i keq ka arritur në prodhim, ose thjesht ndodhin prishje. Në utopi, do të dëshironim që të ishin të pranishme mekanizmat për zbulimin automatik të problemeve dhe, sa më shumë të jetë e mundur, sistemi të rimerrte funksionin e tij, të paktën gjatë natës.
Për këtë, na nevojitet të parashikojmë kontrollime automatike të cilësisë së softuerit në mjedisin e prodhimit dhe të ngremë skenarët për rikuperimin automatik të sistemit.
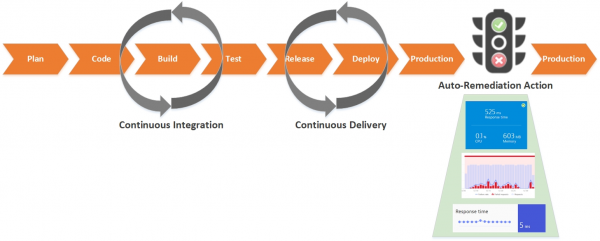
Rikuperimi automatik si kod
Në shumicën e kompanive tashmë ekziston një bazë e akumuluar njohurish për tipet e ndryshme të problemeve të zakonshme dhe lista e veprimeve për zgjidhjen e tyre, për shembull, rihapja e proceseve, pastrimi i burimeve, rikthimi i versioneve, rivendosja e ndryshimeve të gabuara të konfigurimit, rritja ose zvogëlimi i numrit të komponenteve në klaster, kalimi nga skema blu në atë jeshile e të tjera.
Pavarësisht se këto skenarë përdorimi janë të njohur tashmë për shumë ekipe, vetëm pak prej tyre kanë menduar dhe investuar në automatizimin e tyre.
Nëse mendojmë për këtë, nuk ka asgjë jashtëzakonisht të komplikuar në realizimin e proceseve për rikthimin në funksionalitet të aplikacionit; nevojitet të paraqiten skenarët e njohur të punës së administratorëve tuaj në formën e skenarëve të kodit (koncepti 'rikuperimi automatik si kod'), të cilat i keni shkruar paraprakisht për çdo rast specifik. Skenarët e rikuperimit automatik duhet të jenë të orientuar drejt eliminimit të shkakut të problemit. Ju vetë vendosni veprimet e duhura për reagimin ndaj incidentit.
Si një impuls për nisjen e skenarit mund të jetë çdo metrikë nga sistemi juaj i monitorimit; është e rëndësishme që këto metrika të përcaktojnë saktësisht se kur gjërat janë keq, pasi nuk do të dëshironim të kemi alarmime të rreme në ambientin prodhues.
Mund të përdorni çdo sistem apo grup sistemesh: Prometheus, ELK Stack, Zabbix etj. Por do të sjell disa shembuj bazuar në zgjidhjen APM (për shembull, Dynatrace), e cila gjithashtu do të ndihmojë në lehtësimin e jetës suaj.
Së pari, ka gjithçka që lidhet me funksionalitetin nga këndvështrimi i punës së aplikacionit. Zgjidhja ofron qindra metrika në nivele të ndryshme, të cilat mund t'i përdorni si impuls:
- niveli i përdoruesve (shfletues, aplikacione mobile, pajisje IoT, sjellja e përdoruesve, konversioni etj.);
- niveli i shërbimit dhe operacioneve (performanca, disponueshmëria, gabimet etj.);
- niveli i infrastrukturës së aplikacionit (metrika OS të host-it, JMX, MQ, web-server etj.);
- niveli i platformave (virtualizimi, cloud, kontejner etj.).
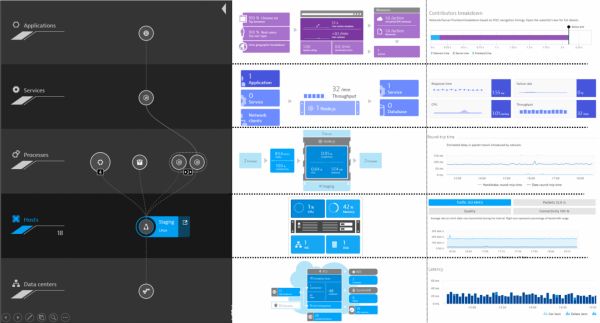 Nivelet e monitorimit në Dynatrace.
Së dyti, siç e thashë më parë, Dynatrace ka një API të hapur që lehtëson shumë integrimin me sisteme të ndryshme të palëve të treta. Për shembull, dërgimi i një njoftimi në sistemin e automatizimit kur tejkalohet parametrat kontrolluese.
Më poshtë është një shembull për ndërveprimin me Ansible.
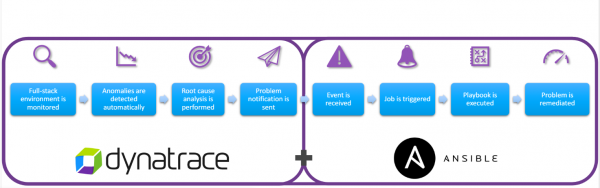
Më poshtë do të jap disa shembuj se cilat automatizime mund të bëhen. Kjo është vetëm një pjesë e rasteve, listën e tyre në mjedisin tuaj mund ta kufizoni vetëm nga imagjinata juaj dhe mundësitë e veglave tuaja të monitorimit.
1. Deploy i dobët – rikthimi i versionit
Edhe nëse ne e kontrollojmë shumë mirë në mjedisin testues, prapë ka një shans që lançimi i ri mund ta shkatërrojë aplikacionin tuaj në mjedisin prodhues. Faktori i njeriut nuk është hequr asnjëherë.
Në figurën pasuese ne shohim se ndodhi një rritje e papritur e kohës së ekzekutimit të operacioneve në shërbim. Fillimi i kësaj rritjeje përkon me kohën e lançimit në aplikacion. Të gjitha këto informacione si ngjarje i dërgojmë në sistemin e automatizimit. Nëse funksionaliteti i shërbimit nuk normalizohet brenda kohës që ne kemi vendosur, automatikisht aktivizohet një skenarë që rikthen versionin në të vjetër.
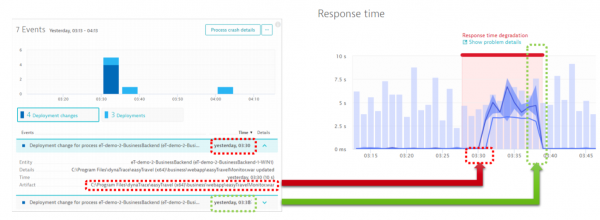 Degredimi i performancës së operacioneve pas lançimit.
2. Ngarkesë e burimeve në 100% – shtimi i një node në rrugëzim
Në shembullin tjetër, sistemi i monitorimit përcakton se një nga komponentët po përjeton ngarkesë CPU në 100%.
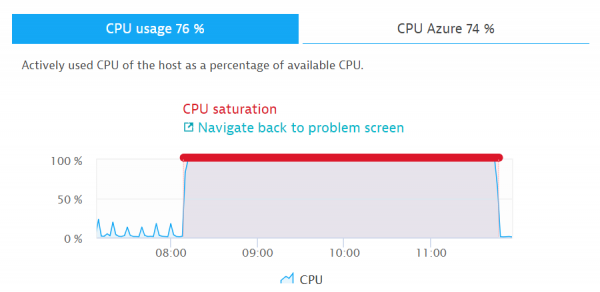 Ngarkesa e CPU 100%
Për këtë ngjarje ka disa skenarë të ndryshëm. Për shembull, sistemi i monitorimit kontrollon për më shumë informacion, nëse mungesa e burimeve është e lidhur me rritjen e ngarkesës në shërbim. Nëse është, atëherë ekzekutohet një skenarë që automatikisht shton një node në rrugëzim, duke rikuperuar kështu funksionalitetin e sistemit në përgjithësi.
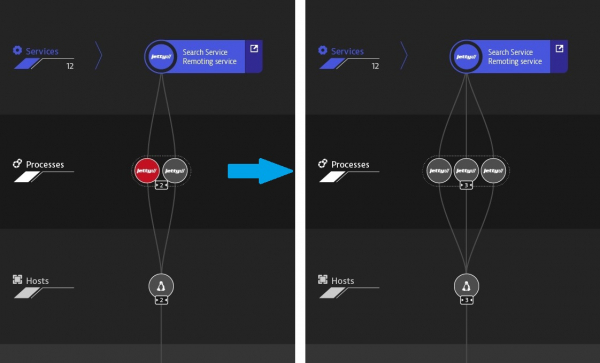 Shkallëzimi pas një incidenti
3. Mungesë e hapësirës në hard disk – pastrimi i diskut
Mendoj se shumë prej këtyre proceseve tashmë janë automatizuar. Me ndihmën e APM, gjithashtu mund të monitoroni hapësirën e lirë në sistemin disk. Në mungesë të hapësirës ose në rast të punës së ngadaltë të diskut, thërrasim skriptin për pastrim ose shtojmë hapësirë.
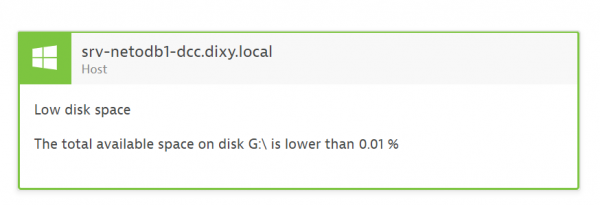
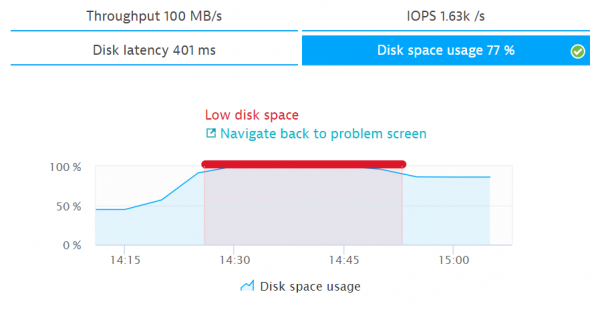 Ngarkesa e diskut 100%
4. Aktivitet i ulët i përdoruesve ose konversion i ulët – kalimi mes degës blu dhe degës jeshile.
Shpesh takoj porositës që përdorin dy kontura (blue-green deploy) për aplikacione në ambientin prodhuese. Kjo lejon kalimin e shpejtë mes degëve gjatë shpërndarjes së versioneve të reja. Shpesh pas depolimit mund të ndodhin ndryshime të mëdha, të cilat nuk i vëren menjëherë. Në këtë rast, degradimi i performancës dhe disponueshmërisë mund të mos vërehet. Për reagime të shpejta ndaj këtyre ndryshimeve, është mirë të përdoren metrika të ndryshme që reflektojnë sjelljen e përdoruesve (numri i sesioneve dhe veprimeve të përdoruesve, konversi, bounce rate). Në figurën e ardhshme tregohet një shembull, ku gjatë rënies së konversisë ndodh kalimi mes degëve të softuerit.
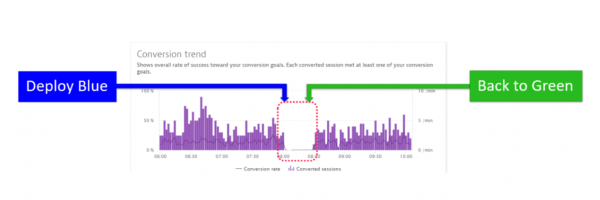 Rënie e konversisë pas kalimit mes degëve të softuerit.
Mekanizmat për identifikimin automatik të problemeve.
Në fund do të jap një shembull tjetër, për të cilin më pëlqen më shumë Dynatrace.
Në pjesën e tregimit tim për automatizimin e verifikimit të cilësisë së ndërtimeve në ambientin testues, të gjitha vlerat kufitare i kemi përcaktuar në mënyrë manuale. Për ambientin testues, kjo është normale, pasi testuesi vetë përcakton treguesit para çdo verifikimi sipas ngarkesës. Në ambientin prodhuese, është e preferueshme që problemet të identifikohen automatikisht në përputhje me mekanizmat e ndryshëm të baseline.
Dynatrace ka mjete interesante të integruara të inteligjencës artificiale, të cilat, duke u bazuar në mekanizmat e identifikimit të metrikave anomale (baselining) dhe ndërtimin e një harta ndërveprimi mes të gjithë komponentëve, duke përputhur dhe koreluar ngjarjet me njëra-tjetrën, identifikojnë anomali në funksionimin e shërbimit tuaj dhe ofrojnë informacione të detajuara për çdo problem dhe shkakun e tij rrënjë.
Duke analizës automatike të varësive midis komponentëve, Dynatrace përcakton jo vetëm nëse shërbimi problematik është një shkak kryesor, por edhe varësinë e tij nga shërbime të tjera. Në shembullin e mëposhtëm, Dynatrace ndjek dhe vlerëson automatikisht funksionimin e çdo shërbimi gjatë realizimit të transaksioneve, duke identifikuar shërbimin Golang si shkakun kryesor.
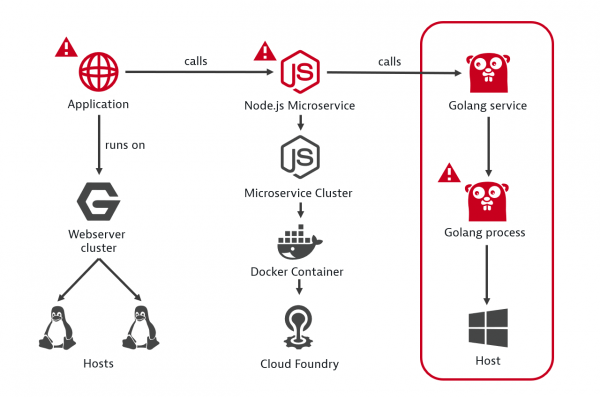 Shembulli i përcaktimit të shkakut kryesor të dështimit.
Në figurën e ardhshme ilustrohet procesi i monitorimit të problemeve me aplikacionin tuaj që nga fillimi i incidentit.
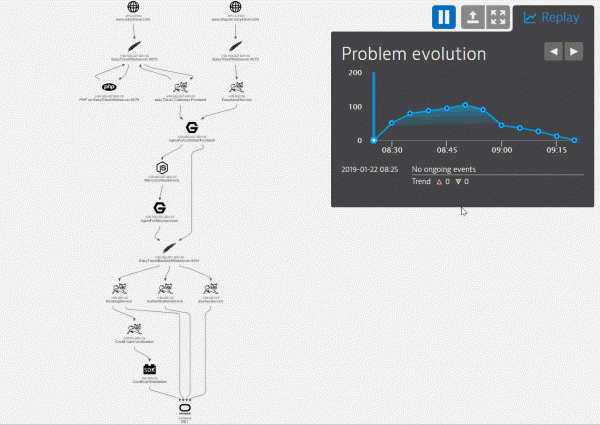 Vizualizimi i problemit në ndodhi me shfaqjen e të gjitha komponentëve dhe ngjarjeve në to.
Sistema i monitorimit ka mbledhur një kronologji të plotë të ngjarjeve rreth problemit të shfaqur. Në dritaren nën grafikun temporal shohim të gjitha ngjarjet kyçe në secilin nga komponentët. Bazuar në këto ngjarje, mund të vendosni procedura për rregullim automatik në formën e skenarëve të kodit.
Për më tepër, rekomandoj integrimin e sistemit të monitorimit me Service Desk ose një bug-tracker. Kur shfaqet një problem, zhvilluesit marrin menjëherë informacionin e plotë për analizën në nivelin e kodit në mjedisin e prodhimit.
Përfundim
Rezultati është një pipeline CI/CD me kontrolle të automatizuara për cilësinë e Softuerit në Pipeline. Ne minimizojmë numrin e grumbujve të keq, rrisim qëndrueshmërinë e sistemit në tërësi dhe, nëse megjithatë ka ndodhur një dështim i sistemit, ne aktivizojmë mekanizmat për rikthimin e tij.
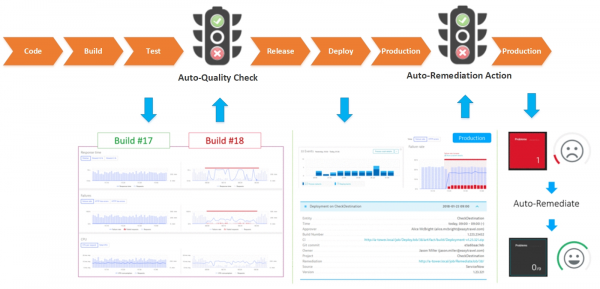
Absolutisht, automatizimi i monitorimit të cilësisë së Softuerit mereton përpjekje; ndonjëherë nuk është një proces i shpejtë, por me kalimin e kohës ai do të sjellë fryte. Rekomandoj që pas zgjidhjes së një incidenti të ri në mjedisin e prodhimit, menjëherë të mendoni për monitorët që do të shtoni për kontrolle në mjedisin e testimit për të shmangur kalimin e një grumbulli të keq në prodhim, si edhe të përgatisni një skenar për rregullimin automatik të këtyre problemeve.
Shpresoj se shembujt e mi do t'ju ndihmojnë në përpjekjet tuaja. Më intereson gjithashtu të shoh shembujt tuaj të metrikeve të përdorura për realizimin e vetë-rikthimit të qëndrueshmërisë së sistemeve.
Burimi: habr.com
