

Në cilat parime ndërtohet Depozita perfekte e të Dhënave?
Konzistenca në vlerën e biznesit dhe analizën në mungesë të kodit boilerplate. Menaxhimi i DWH si një bazë kodi: versionimi, rishikimi, testimi automatik dhe CI. Modulariteti, zgjerueshmëria, kodi i hapur dhe komuniteti. Dokumentacioni miqësor për përdoruesit dhe vizualizimi i varësive (Data Lineage).
Për të gjitha këto më shumë dhe për rolin e DBT në ekosistemin Big Data & Analytics - mirë se vini nën artikull.
Përshëndetje të gjithëve
Këtu është Artemiy Kozyr. Përafërsisht mbi 5 vjet kam punuar me depozitat e të dhënave, merrem me ndërtimin e ETL/ELT, si dhe me analizën e të dhënave dhe vizualizimin. Aktualisht punoj në , jap mësim në OTUS në kursin , dhe sot dua të ndaj me ju një artikull që e kam shkruar në prag të fillimit të grupit të ri në kursin.
Përmbledhje e shkurtër
Korniza DBT - është gjithçka për shkronjën T në akronimin ELT (Extract - Transform - Load).
Me shfaqjen e bazave të dhënash analitike të fuqishme dhe të shkallëzueshme si BigQuery, Redshift, Snowflake, ka humbur çdo kuptim të bësh transformime jashtë Deposites së të Dhënave.
DBT nuk eksporton të dhëna nga burimet, por ofron mundësi të mëdha për të punuar me ato të dhëna që tashmë janë ngarkuar në Depozitë (në Storage të Brendshme ose të Jashtme).
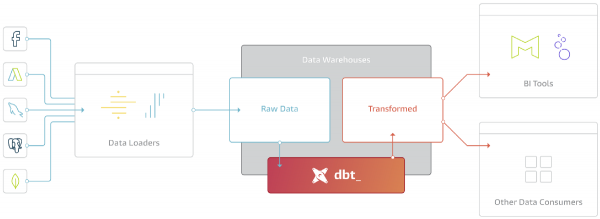
Qëllimi kryesor i DBT është të marrë kodin, ta përgatisë atë në SQL, të ekzekutojë komandat në rendin e duhur në Depozitë.
Struktura e projektit DBT
Projekti përbëhet nga dy lloje drejtorish dhe skedash:
- Modeli (.sql) - njësia e transformimit e shprehur si një pyetje SELECT
- Skeda e konfiguratës (.yml) - parametrat, cilësimet, testet, dokumentacioni
Në nivelin bazik, puna zhvillohet kështu:
- Përdoruesi përgatit kodin e modeleve në çdo IDE të përshtatshme
- Me ndihmën e CLI-së thirret ekzekutimi i modeleve, DBT përgatisin kodin e modeleve në SQL
- Kodi SQL i përgatitur ekzekutohet në Depozitë në rendin e caktuar (graf)
Kështu mund të duket ekzekutimi nga CLI:
E gjitha është SELECT
Kjo është karakteristika kryesore e kornizës Data Build Tool. Në terma të tjerë, DBT abstrahon tërë kodin që lidhet me materializimin e pyetjeve tuaja në Depozitë (variacionet nga komandat CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Çdo model nënkupton shkruajtjen e një pyetje SELECT, e cila përcakton grupin përfundimtar të të dhënave.
Logjika e transformimeve mund të jetë shumënivele dhe të konsolidojë të dhënat nga disa modele të tjera. Një shembull modeli që do të ndërtojë një vitrinë poroshitjesh (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

me porositë si (

	select * from {{ ref('stg_orders') }}

),

pagesat_e_porosisë si (

	select * from {{ ref('order_payments') }}

),

fundi si (

	select
		porositë.order_id,
		porositë.customer_id,
		porositë.order_date,
		porositë.status,
		{% for payment_method in payment_methods -%}
		pagesat_e_porosisë.{{payment_method}}_amount,
		{% endfor -%}
		pagesat_e_porosisë.total_amount as amount
	from porositë
		left join pagesat_e_porosisë using (order_id)

)

select * from fundi
Çfarë interesante mund të shohim këtu?
Së pari: Janë përdorur CTE (Shprehjet e zakonshme të tabelave) — për organizimin dhe kuptimin e kodit, i cili përmban shumë transformime dhe logjikë biznesi
Së dyti: Kodi i modelit — është një përzierje SQL dhe (gjuha e shablloneve).
Në shembull përdoret një cikël për për formimin e shumës për secilën metodë pagese, të cituar në shprehje set. Përdoret gjithashtu funksioni ref — mundësia për të referuar brenda kodit në modele të tjera:
- Gjatë kompilimit ref do të transformohet në një tregues objektiv për një tabelë ose pamje në Depo
- ref mundëson ndërtimin e një grafiku të varësive të modeleve
Pikërisht shton në DBT mundësi pothuajse të pakufizuara. Më të përdorurat prej tyre janë:
- If / else statements — operatorët e degëzimit
- For loops — ciklet
- Variables — variablat
- Macro — krijimi i makro
Materializimi: Tabelë, Pamje, Inkremental
Strategjia e Materializimit — qasja sipas së cilës seti rezultues i të dhënave të modelit do të ruhet në Depo.
Në shqyrtimin bazik kjo është:
- Tabela — tabelë fizike në Depo
- Pamja — pamje, tabelë virtuale në Depo
Ka edhe strategji më të ndërlikuara materializimi:
- Inkremental — ngarkimi inkremental (i tabelave të mëdha të fakteve); rreshtat e rinj shtohen, ato të ndryshuara azhurnohet, të fshirë — hiqen
- Ephemeral — modeli nuk materializohet direkt, por merr pjesë si CTE në modele të tjera
- Çdo strategji tjetër që mund të shtoni vetë
Përveç strategjive të materializimit, hapen mundësi për optimizim sipas depove specifike, për shembull:
- Snowflake: Tabela Transient, Sjellja e Bashkimit, Klustërimi i Tabeleve, Kopjimi i dhuratave, Pamje të Sigurta
- Redshift: Distkey, Sortkey (të ndara, të përbërta), Pamje me lidhje të vonshme
- BigQuery: Ndërprerja e tabelës & klustërimi, Sjellja e Bashkimit, Enkriptimi KMS, Etiketat & Etiketat
- Spark: Formati i skedarëve (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
Aktualisht mbështeten magazitë e mëposhtme:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (pjesërisht)
- Spark (pjesërisht)
- Microsoft SQL Server (adapteri i komunitetit)
Le të përmirësojmë modelin tonë:
- Le ta bëjmë mbushjen e tij inkrementale (Incremental)
- Të shtojmë çelësat e segmentimit dhe renditjes për Redshift
-- Konfigurimi i modelit:
-- Mbushje inkrementale, çelësi unik për përditësimin e regjistrimeve (unique_key)
-- Çelësi i segmentimit (dist), çelësi i renditjes (sort)
{{
  config(
        materialized='incremental',
        unique_key='order_id',
        dist="customer_id",
        sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Ky filtr do të aplikohet vetëm për ekzekutimin inkremental
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Grafiku i varësive të modeleve
Gjithashtu quhet si pemë varësish. Gjithashtu DAG (Grafi Ayklic i Drejtuar — Directed Acyclic Graph).
DBT ndalon ndërtimin e grafikut në bazë të konfigurimit të të gjitha modeleve të projektit, më saktësisht lidhjet ref() brenda modeleve me modele të tjera. Prania e grafikut lejon të bëhen gjërat e mëposhtme:
- Ekzekutimi i modeleve në rendin e duhur
- Paralelizimi i formimit të premi
- Ekzekutimi i një podgrafi të rastësishëm
Shembulli i vizualizimit të grafikut:
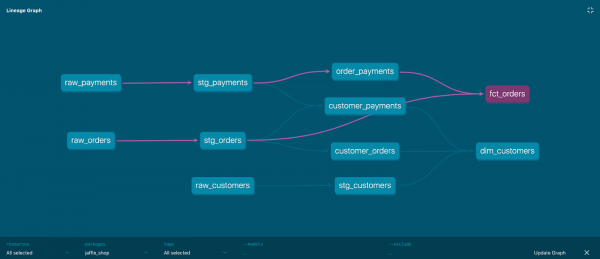
Çdo nyjë e grafikut është një model, drejtimet e grafikut përcaktohen nga shprehja ref.
Cilësia e të dhënave dhe Dokumentacioni
Përveç formimit të modeleve vetë, DBT lejon testimin e disa supozimeve (assertions) mbi setin rezultat, të tilla si:
- Not Null
- Unike
- Integriteti Referencial — integriteti referencial (p.sh., customer_id në tabelën orders përputhet me id në tabelën customers)
- Përputhshmëria me një listë vlerash të lejuara
Është e mundur të shtoni testet tuaja (custom data tests), të tilla si, p.sh., % e deviacionit të të ardhurave ndaj treguesve një ditë, një javë, një muaj më parë. Çdo supozim i formuluar si një pyetje SQL mund të bëhet një test.
Kështu mund të kapim në premi të magazinës devijime dhe gabime të padëshiruara në të dhëna.
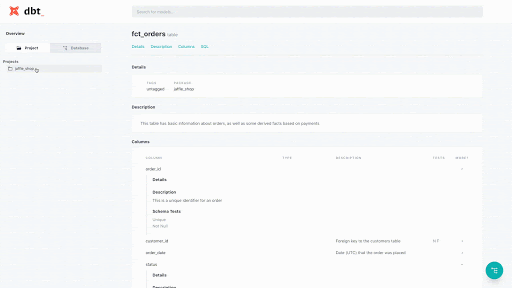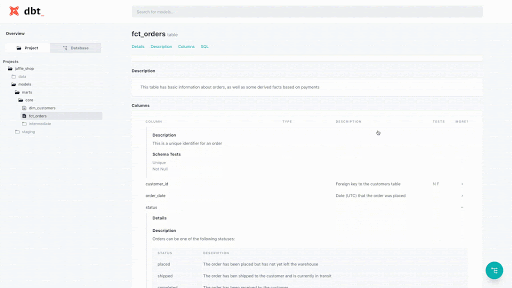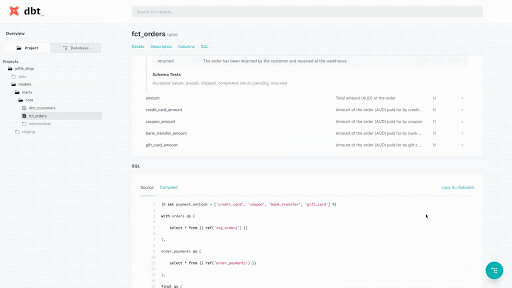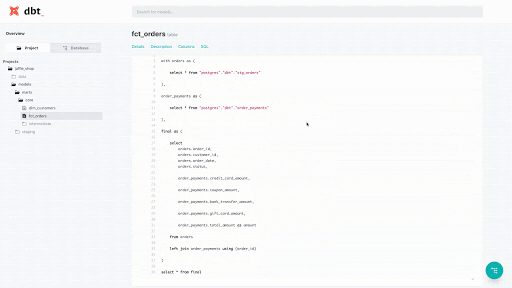
Sa i përket dokumentacionit, DBT ofron mekanizma për shtimin, versionimin dhe shpërndarjen e metadatenëve dhe komenteve në nivelin e modeleve dhe madje edhe të atributeve.
Ja si duket shtimi i testeve dhe dokumentacionit në nivelin e skedarit të konfigurimit:
 - name: fct_orders
   description: Kjo tabelë ka informacion bazik rreth porosive, si dhe disa fakte të nxjerra në bazë të pagesave
   columns:
     - name: order_id
       tests:
         - unique # kontroll për vlera unik
         - not_null # kontroll për prani null
       description: Ky është një identifikues unik për një porosi
     - name: customer_id
       description: Çelësi i huaj për tabelën e klientëve
       tests:
         - not_null
         - relationships: # kontrolli i integritetit referencial
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Data (UTC) kur u vendos porosia
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # kontroll për vlera të pranuara
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Dhe ja si duket ky dokumentacion tashmë në uebsajtin e gjeneruar:
Makro dhe Módul
Qëllimi i DBT nuk është aq shumë të bëhet një set SQL-shkrimesh, por të ofrojë përdoruesve mjete të fuqishme dhe të pasura për ndërtimin e transformimeve të tyre dhe shpërndarjen e këtyre moduleve.
Makrot janë grupe konstruksionesh dhe shprehjesh që mund të thirren si funksione brenda modeleve. Makrot lejojnë ripërdorimin e SQL-it mes modeleve dhe projekteve duke ndjekur parimin inxhinierik DRY (Mos e Përsëris Vetën).
Shembulli i një makro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Dhe përdorimi i saj:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- thirja e makros
from my_table
DBT vjen me një menaxher paketash (packages), i cili lejon përdoruesit të publikojnë dhe ripërdorin module dhe makrot e veçanta.
Kjo do të thotë mundësinë për të shkarkuar dhe përdorur biblioteka si:
- : punë me Data/Time, Çelësa Zëvendësues, Testet e Skemës, Pivot/Unpivot dhe të tjera
- Shabllone të gatshme për vitrina për shërbime si dhe
- Biblioteka për Depozita të Përcaktuara të Dhënash, për shembull
- — Moduli për logimin e punës DBT
Lista e plotë e pakove mund të shikohet në .
Më shumë mundësi
Këtu do të përshkruaj disa veçori dhe realizime të tjera interesante që unë dhe ekipi im përdorim për ndërtimin e Depot të të Dhënave në .
Ndarja e ambienteve të ekzekutimit DEV — TEST — PROD
Madje brenda një klasteri DWH (në kuadër të skemave të ndryshme). Për shembull, me anë të shprehjes së mëposhtme:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Ky kod thotë praktikisht: për ambientet dev, test, ci merr vetëm të dhënat për tri ditët e fundit dhe asnjë më shumë. Kjo do të thotë që ekzekutimi në këto ambiente do të jetë shumë më i shpejtë dhe do të kërkojë më pak burime. Kur ekzekutohet në ambientin prod kushti i filtrit do të injorohet.
Materializimi me kodim alternativ të kolonave
Redshift është një DBMS kolonash që lejon përcaktimin e algoritmeve të kompresimit të të dhënave për secilën kolonë të veçantë. Zgjedhja e algoritmeve optimalë mund të reduktojë hapësirën e krijuar në disk nga 20-50%.
Makro do të ekzekutojë komandën ANALYZE COMPRESSION, do të krijojë një tabelë të re me algoritmet rekomanduese të kodimit të kolonave, të përcaktuara nga çelësat e segmentimit (dist_key) dhe renditjes (sort_key), do të transferojë të dhënat në të dhe, nëse është e nevojshme, do të fshijë kopjen e vjetër.
Nënshkrimi i makrosë:
{{ compress_table(schema, table,
                  drop_backup=False,
                  comprows=none|Integer,
                  sort_style=none|compound|interleaved,
                  sort_keys=none|List,
                  dist_style=none|all|even,
                  dist_key=none|String) }}
Regjistrimi i ekzekutimeve të modeleve
Mund të lidhni haki (hooks) për çdo ekzekutim modeli, të cilat do të ekzekutohen para fillimit ose menjëherë pas përfundimit të krijimit të modelit:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
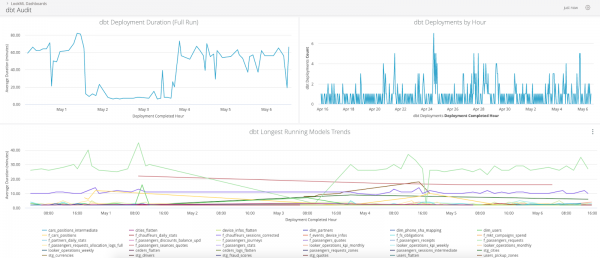
Moduli i regjistrimit do të lejojë që të gjitha metadatat e nevojshme të regjistrohen në një tabelë të veçantë, mbi të cilën më pas mund të kryhet auditimi dhe analiza e vendeve problematike (bottlenecks).
Ja si duket tabela e treguesve në të dhënat e regjistrimit në Looker:
Automatizimi i mirëmbajtjes së Depots
Nëse po përdorni disa zgjerime funksionaliteti të Depot të përdorur, si UDF (Funksione të Përdoruesve), atëherë versionimi i këtyre funksioneve, menaxhimi i aksesit dhe ndihma automatike e rilëshimeve të reja është shumë e lehtë për t'u realizuar në DBT.
Ne përdorim UDF në Python për të llogaritur vlerat hash, domenet e adresave të postës, dekodimin e maskave të bitëve (bitmask).
Shembulli i një makroje që krijon UDF në çdo mjedis ekzekutimi (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
Në Wheely përdorim Amazon Redshift, i cili bazohet në PostgreSQL. Për Redshift, është e rëndësishme të mbledhim rregullisht statistikat për tabelat dhe të lironi hapësirë në disk — komandat ANALYZE dhe VACUUM, përkatësisht.
Për këtë, çdo natë ekzekutohen komandat nga makroja redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " of " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
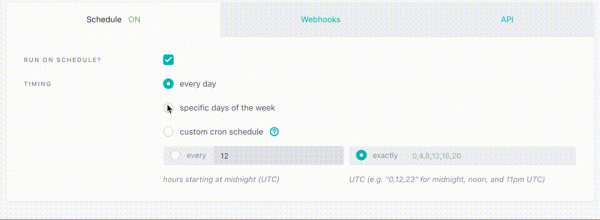
Ka mundësinë të përdorni DBT si një shërbim (Managed Service). Në paketë:
- Web IDE për zhvillimin e projekteve dhe modeleve
- Koncepcioni i punëve dhe vendosja në një orar
- Qasje e thjeshtë dhe e lehtë në loge
- Webfaqja me dokumentacionin e projektit tuaj
- Lidhja CI (Continuous Integration)
Përfundim
Të gatuarit dhe konsumimi i DWH po bëhet po aq i këndshëm dhe i dobishëm, sa edhe pirja e smoothies. DBT përbëhet nga Jinja, zgjerime të personalizuara (module), kompilatori, motorin (executori) dhe menaxheri i pacakot. Duke përmbledhur këto elemente së bashku, ju merrni një ambient të plotë pune për Depozitën tuaj të Dhënash. Të thuash që sot ekziston një mënyrë më të mirë për të menaxhuar transformimet brenda DWH do të ishte e vështirë.
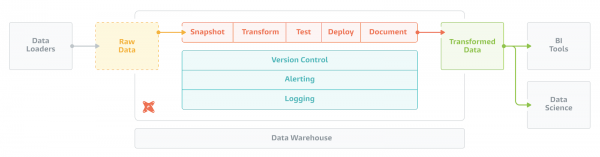
Besimet që ndoqën zhvilluesit e DBT formulohet kështu:
- Kodi, jo GUI, është abstraksioni më i mirë për të shprehur logjikën komplekse analitike.
- Puna me të dhënat duhet të adaptohet pas praktikave më të mira të zhvillimit të softuerit (Software Engineering).
- Infrastruktura më e rëndësishme për punën me të dhënat duhet të kontrollohet nga komuniteti i përdoruesve si softuer me kod të hapur.
- Jo vetëm mjetet analitike, por edhe kodi gjithnjë e më shumë do të bëhet pasuri e komunitetit Open Source.
Këto besime themelore krijuan një produkt që sot përdoret nga më shumë se 850 kompani, dhe ato përbëjnë bazën e shumë zgjerimeve interesante që do të krijohen në të ardhmen.
Për ata që janë të interesuar, ka një regjistrim video të një leksioni të hapur që unë mbajta disa muaj më parë si pjesë e një leksioni të hapur në OTUS — .
Përveç DBT dhe Depozitave të Dhënash, në kuadër të kursit Data Engineer në platformën OTUS, unë dhe kolegët e mi mbajmë seanca mbi një sërë temash të tjera актуale dhe moderne:
- Koncepat arkitekturore të aplikacioneve të Big Data.
- Praktika me Spark dhe Spark Streaming.
- Studimi i metodave dhe mjeteve për ngarkimin e burimeve të dhënash.
- Krijimi i vitrinave analitike në DWH.
- Koncepat NoSQL: HBase, Cassandra, ElasticSearch.
- Parimet e organizimit të monitorimit dhe orkestrimit.
- Projekti përfundimtar: mbledhja e të gjithë aftësive nën mbështetje mentorimi.
Lidhjet:
- — Dokumentacioni zyrtar.
- — Artikulli përmbledhës nga një nga autorët e DBT.
- — YouTube, Regjistrimi i leksionit të hapur OTUS.
- — Leksi i hapur më 15 maj 2020.
- — OTUS.
- — Një shikim mbi të ardhmen e punës me të dhënat dhe analitikë.
- — Evolucioni i analitikës dhe ndikimi i Open Source.
- — Parimet e ndërtimit të CI me përdorimin e DBT.
- — Praktika, Udhëzime hap pas hapi për punë të vetme.
- — Github, kodi i projektit të mësimit
Burimi: habr.com
