

Profesionet Data Scientist dhe Data Engineer shpesh ngatërrohen. Çdo kompani ka specifikën e saj në punën me të dhënat, qëllime të ndryshme të analizës dhe një përfaqësim të ndryshëm se cili specialist duhet të merret me çfarë pune, prandaj, kërkesat që çdo kompani ka janë të ndryshme.
Të kuptojmë se çfarë e ndan këta specialistë, çfarë probleme biznesi ata zgjidhin, çfarë aftësish kanë dhe sa fitojnë. Materiali doli të jetë i gjerë, prandaj e ndamë në dy publikime.
Në artikullin e parë, Elena Gerasimova, drejtore e fakultetit "" në Netology, flet për ndryshimin ndërmjet Data Scientist dhe Data Engineer dhe me cilat mjete ata punojnë.
Si dallohen rolet e inxhinierëve dhe scientistëve
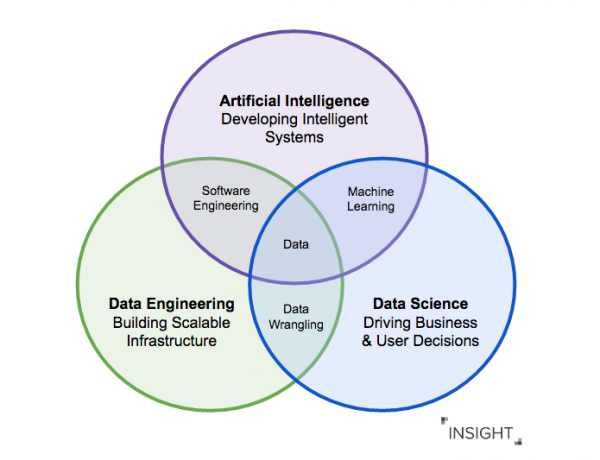
Inxhinieri i të dhënave është specialisti që, nga njëra anë, zhvillon, teston dhe mirëmban infrastrukturën e punës me të dhëna: bazat e të dhënave, depozitimin dhe sistemet e përpunimit masiv. Nga ana tjetër, ai është ai që pastron dhe "përpunon" të dhënat për t'i përdorur nga analistët dhe data scientistët, që do të thotë se krijon linjat e përpunimit të të dhënave.
Data Scientist krijon dhe trajnon modele parashikuese (dhe jo vetëm) përmes algoritmeve të mësimit të makinerisë dhe rrjeteve nervore, duke ndihmuar biznesin të zbulojë shtigje të fshehura, të parashikojë zhvillimin e ngjarjeve dhe të optimizojë proceset kryesore të biznesit.
Kthesa kryesore ndërmjet Data Scientist dhe Data Engineer qëndron në faktin se zakonisht ata kanë qëllime të ndryshme. Të dy punojnë për të siguruar që të dhënat të jenë të disponueshme dhe të cilësisë së lartë. Por Data Scientist gjen përgjigje për pyetjet e tij dhe verifikon hipotezat në ekosistemin e të dhënave (për shembull, mbi bazën Hadoop), ndërsa Data Engineer krijon pipeline për mbështetje të algoritmit të mësimit të makinerisë, i shkruar nga data scientist-i, në klasën Spark brenda të njëjtit ekosistem.
Inxhinieri i të dhënave sjell vlerë për biznesin përmes punës në ekip. Detyra e tij është të luajë një rol kyç midis pjesëmarrësve të ndryshëm: nga zhvilluesit deri tek përdoruesit biznesorë të raporteve, dhe të rrisë produktivitetin e analistëve - nga ata të marketingut dhe produkteve deri te BI.
Data Scientist, nga ana tjetër, merr një pjesëmarrje aktive në strategjinë e kompanisë dhe nxjerrjen e insight-eve, marrjen e vendimeve, implementimin e algoritmeve të automatizimit, modelimit dhe gjenerimin e vlerës nga të dhënat.
Puna me të dhënat i nënshtrohet parimit GIGO (garbage in — garbage out): nëse analistët dhe shkencëtarët e të dhënave punojnë me të dhëna të papërgatitura dhe potencialisht të gabuara, rezultatet, edhe me algoritmet më të avancuar të analizës, do të jenë të gabuara.
Inxhinierët e të dhënave e zgjidhin këtë problem duke ndërtuar pipeline për përpunimin, pastrimin dhe transformimin e të dhënave, duke i lejuar shkencëtarët e të dhënave të punojnë me të dhëna të cilësisë më të lartë.
Në treg ka shumë mjete për punën me të dhënat, të cilat mbulojnë çdo fazë: nga shfaqja e të dhënave deri te paraqitja në dashboard për bordin drejtues. E rëndësishme është që vendimi për përdorimin e tyre të merret nga inxhinieri, — jo sepse është në modë, por sepse vërtet do të ndihmojë në punën e pjesëmarrësve të tjerë në proces.
Kushtimisht: nëse kompanisë i duhet të lidhë BI dhe ETL — ngarkimin e të dhënave dhe përditësimin e raportëve, ja një themel tipik legacy me të cilin do të duhet të merret Data Engineer (mirë është nëse në ekip ka gjithashtu dhe një arkitekt).
Detyrat e Data Engineer
- Zhvillimi, ndërtimi dhe mbështetje e infrastrukturës për punën me të dhënat.
- Përpunimi i gabimeve dhe krijimi i konvejereve të besueshëm për përpunimin e të dhënave.
- Transformimi i të dhënave të pa strukturuara nga burime dinamike të ndryshme në formatin e nevojshëm për analistët.
- Sigurimi i rekomandimeve për përmirësimin e konsistencës dhe cilësisë së të dhënave.
- Sigurimi dhe mbështetje e arkitekturës së të dhënave që përdorin shkencëtarët e të dhënave dhe analistët.
- Përpunimi dhe ruajtja e të dhënave në mënyrë të qëndrueshme dhe efikase në një klaster të shpërndarë me dhjetëra ose qindra serverë.
- Vlerësimi i kompromiseve teknike të mjeteve për krijimin e arkitekturave të thjeshta, por të besueshme, që mund të mbijetojnë dështimet.
- Kontrolli dhe mbështetje e rrjedhave të të dhënave dhe sistemeve të lidhura (konfigurimi i monitorimit dhe alarmeve).
Ekziston një specializim tjetër brenda rrugës së Data Engineer — ML engineer. Nëse e përmbledhim, këta inxhinierë specializohen në sjelljen e modeleve të mësimit të makinerisë deri në implementim dhe përdorim industrial. Shpesh modeli, i marrë nga shkencëtari i të dhënave, është pjesë e një kërkimi dhe mund të mos funksionojë në kushte të fushatës.
Detyrat e Data Scientist
- Ekstraktimi i karakteristikave nga të dhënat për aplikimin e algoritmeve të mësimit të makinerisë.
- Përdorimi i mjeteve të ndryshme të mësimit të makinës për parashikimin dhe klasifikimin e modeleve në të dhëna.
- Rritja e produktivitetit dhe saktësisë së algoritmeve të mësimit të makinës përmes optimizimit dhe konfigurimit të hollësishëm të algoritmeve.
- Formimi i hipotezave "të forta" në përputhje me strategjinë e kompanisë që duhen testuar.
Si Inxhinierët e Të Dhënave, ashtu edhe Shkencëtarët e Të Dhënave kontribuojnë në zhvillimin e një kulture të punës me të dhëna, e cila ndihmon kompaninë të rrisë fitimet ose të ulë shpenzimet.
Me cilat gjuhë dhe mjete punojnë inxhinierët dhe shkencëtarët?
Sot, pritshmëritë ndaj specialistëve të përpunimit të të dhënave kanë ndryshuar. Disa vite më parë, inxhinierët krijonin kërkesat e mëdha SQL, shkruanin manualisht MapReduce dhe përpunonin të dhëna me mjete si Informatica ETL, Pentaho ETL, Talend.
Në 2020, një specialist nuk mund të kalojë pa njohuri të Python dhe mjeteve moderne të llogaritjes (p.sh. Airflow), si dhe një kuptim të parimeve të punës me platforma cloud (duke i përdorur për të kursyer në "harduer", me respektimin e parimeve të sigurisë).
SAP, Oracle, MySQL, Redis janë mjete tradicionale për inxhinierët e të dhënave në kompanitë e mëdha. Janë të mira, por kostoja e licencave është kaq e lartë sa arsyeton të mësosh të punosh me to vetëm në projekte industriale. Megjithatë, ka një alternativë falas si Postgres — është falas dhe i përshtatshëm jo vetëm për mësim.
Historikisht, është shpesh kërkuar Java dhe Scala, megjithatë, me zhvillimin e teknologjive dhe qasjeve, këto gjuhë po kalojnë në plan të dytë.
Megjithatë, BigData të forta: Hadoop, Spark dhe gjithë kafshët e tjera — nuk janë më një kërkesë e domosdoshme për inxhinierët e të dhënave, por një lloj mjeti për zgjidhjen e problemeve që nuk mund të zgjidhen me ETL tradicional.
Në trend janë shërbimet për përdorimin e mjeteve pa pasur nevojë të dish gjuhën në të cilën janë shkruar (p.sh. Hadoop pa ditur Java), si dhe ofrimi i shërbimeve gati për përpunimin e të dhënave në flux (njohja e zërit ose imazheve në video).
Zgjidhjet industriale nga SAS dhe SPSS janë të njohura, ndërsa Tableau, Rapidminer, Stata dhe Julia gjithashtu përdoren gjerësisht nga shkencëtarët e të dhënave për detyra lokale.
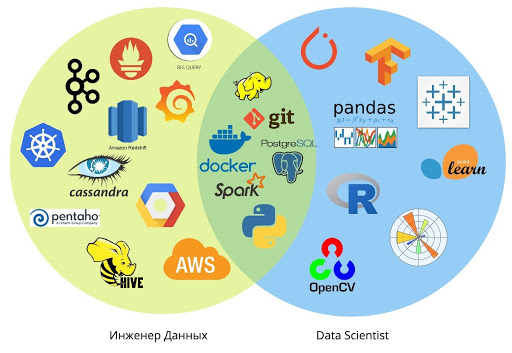
Mundësia për të ndërtuar vetë pipeline-t iu dha analistëve dhe data scientist-ëve vetëm disa vjet më parë: për shembull, tani është e mundur të drejtohen të dhënat në një ruajtje të bazuar në PostgreSQL me skenarë relativisht të thjeshtë.
Zakonisht, përdorimi i konvejereve dhe strukturave të integruara të të dhënave mbetet në duar të inxhinierëve të të dhënave. Por sot, si kurrë më parë, trendi për specialistët T-sh që kanë kompetenca të gjerë në fusha të lidhura është shumë i fortë, pasi mjetet vazhdimisht po thjeshtohen.
Pse Data Engineer dhe Data Scientist duhet të punojnë së bashku
Duke punuar ngushtë me inxhinierët, Data Scientist atëherë mund të përqendrohen në pjesën kërkimore, duke krijuar algorithma të gatshëm për të punuar për mësimin e makinerisë.
Ndërsa inxhinierët përqendrohen në shkallueshmëri, ripërdorimin e të dhënave dhe garantojnë që pipeline-t e hyrjes dhe daljes në çdo projekt specifik përputhen me arkitekturën globale.
Kjo ndarje e detyrave siguron koherencën e veprimeve mes grupeve të specialistëve që punojnë në projekte të ndryshme të mësimit të makinerisë.
Bashkëpunimi ndihmon në krijimin efikas të produkteve të reja. Shpejtësia dhe cilësia arrihen falë balancës midis krijimit të një shërbimi për të gjithë (ruajtja globale ose integrimi i tabelave të kontrollit) dhe realizimit të çdo nevoje ose projekti të veçantë (pipeline i ngushtuar, lidhja e burimeve të jashtme).
Puna e ngushtë me data scientist-et dhe analistët ndihmon inxhinierët të zhvillojnë aftësi analitike dhe kërkimore për të shkruar kod më cilësor. Kështu përmirësohet shkëmbimi i njohurive midis përdoruesve të ruajtjeve dhe liqeneve të të dhënave, duke bërë projektet më fleksibël dhe duke siguruar rezultate më të qëndrueshme afatgjata.
Në kompanitë që kanë si qëllim zhvillimin e kulturës së punës me të dhëna dhe ndërtimin e proceseve të biznesit mbi atë bazë, Data Scientist dhe Data Engineer plotësojnë njëri-tjetrin dhe krijojnë një sistem të plotë të analizës së të dhënave.
Në materialin e ardhshëm do të flasim për arsimimin që duhet të kenë Data Engineer dhe Data Scientist, cilat aftësi duhet të zhvillojnë dhe si është tregu.
Nga redaksia e Netologjisë
Nëse po shqyrtoni profesionin e Data Engineer-it ose Data Scientist-it, ju ftojmë të eksploroni programet e kurseve tona:
- Profesion i «».
- Profesion i «».
Burimi: habr.com
