

SQL — çfarë mund të jetë më e thjeshtë? Secili prej nesh mund të shkruajë një query të thjeshtë — shkruajmë select, rendisim kolonat e nevojshme, pastaj from, emrin e tabelës, pak kushte te ku dhe kaq — të dhënat e dobishme i kemi në xhep, thuajse pavarësisht se cila DBMS fshihet pas skenës në atë moment (madje ndoshta ). Si rezultat, puna pothuajse me çdo burim të dhënash (relacional apo jo fort i tillë) mund të shihet nga këndvështrimi i kodit të zakonshëm (me gjithçka që sjell kjo — version control, code review, analizë statike, autoteste e të tjera). Dhe kjo vlen jo vetëm për vetë të dhënat, skemat dhe migrimet, por në përgjithësi për të gjithë ciklin e jetës së ruajtjes së të dhënave. Në këtë artikull do të flasim për detyrat dhe problemet e përditshme gjatë punës me DB të ndryshme nën prizmin e "database as code".
Dhe do ta nisim pikërisht me . Përplasjet e para të tipit "SQL vs ORM" janë vënë re që në .
Mapimi objekt-relacional
Mbështetësit e ORM tradicionalisht vlerësojnë shpejtësinë dhe thjeshtësinë e zhvillimit, pavarësinë nga DBMS dhe pastërtinë e kodit. Për shumë prej nesh, kodi për punën me DB (dhe shpesh edhe vetë DB)
zakonisht duket afërsisht kështu…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Modeli është i mbushur me anotime inteligjente, ndërsa diku prapa skenës ORM-ja trimërore gjeneron dhe ekzekuton tonelata kodi SQL. Meqë ra fjala, zhvilluesit përpiqen me të gjitha forcat të distancohen nga DB-ja e tyre përmes kilometrash abstraksionesh, gjë që flet për njëfarë .
Në anën tjetër të barrikadës, ithtarët e SQL-së së pastër "handmade" vënë në dukje mundësinë për t’i nxjerrë maksimumin DBMS-së së tyre pa shtresa dhe abstraksione shtesë. Si rezultat lindin projekte "data-centric", ku me bazën merren njerëz të specializuar posaçërisht (të ashtuquajturit "bazistë", "specialistë të bazës" e kështu me radhë), ndërsa zhvilluesve u mbetet vetëm të "thërrasin" view-t e gatshme dhe stored procedure, pa hyrë në hollësi.
Po sikur të marrim më të mirën nga të dy botët? Pikërisht siç është bërë në mjetin e shkëlqyer me emrin optimist . Do të sjell disa rreshta nga koncepti i përgjithshëm në përkthimin tim të lirë, ndërsa me të mund të njiheni më në hollësi .
Clojure është një gjuhë e shkëlqyer për krijimin e DSL-ve, por SQL tashmë është vetë një DSL i shkëlqyer dhe nuk na duhet edhe një tjetër. S-shprehjet janë të mrekullueshme, por këtu nuk sjellin asgjë të re. Në fund marrim thjesht kllapa për hir të kllapave. Nuk jeni dakord? Atëherë prisni momentin kur abstraksioni mbi DB do të fillojë të rrjedhë dhe ju do të nisni betejën me funksionin (raw-sql)
Po çfarë të bëjmë? Le ta lëmë SQL-in të mbetet SQL i zakonshëm — një skedar për një kërkesë:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… dhe më pas lexoni këtë skedar, duke e kthyer në një funksion të zakonshëm Clojure:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; A function with the name `users-by-country` has been created.
;;; Let's use it:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Duke iu përmbajtur parimit "SQL veçmas, Clojure veçmas", ju përfitoni:
- Asnjë surprizë sintaksore. Baza juaj e të dhënave (si çdo tjetër) nuk përputhet 100% me standardin SQL — por për Yesql kjo nuk ka rëndësi. Nuk do të humbni kurrë kohë duke kërkuar funksione me sintaksë ekuivalente me SQL. Nuk do t’ju duhet kurrë të ktheheni te funksioni (raw-sql "some (‘funky’ :: SYNTAX)")).
- Mbështetje më e mirë nga editori. Editori juaj tashmë ka mbështetje të shkëlqyer për SQL. Duke e ruajtur SQL-in si SQL, thjesht mund ta përdorni atë.
- Përputhshmëri më e mirë me ekipin. DBA-të tuaj mund të lexojnë dhe të shkruajnë SQL-in që përdorni në projektin tuaj Clojure.
- Konfigurim më i thjeshtë i performancës. Duhet të ndërtoni planin për një kërkesë problematike? Nuk është problem, kur kërkesa juaj është SQL i zakonshëm.
- Ripërdorim i kërkesave. Merrini këta skedarë SQL dhe përdorini në projekte të tjera, sepse është thjesht SQL i vjetër i mirë — mjafton ta ndani.
Mendoj se ideja është shumë e bukur dhe njëkohësisht shumë e thjeshtë, prandaj projekti ka fituar shumë në gjuhë nga më të ndryshmet. Ndërsa më tej do të përpiqemi të zbatojmë një filozofi të ngjashme të ndarjes së kodit SQL nga gjithçka tjetër, shumë përtej ORM.
IDE & DB-menaxherë
Le të nisim me një detyrë të thjeshtë të përditshme. Shpesh na duhet të kërkojmë objekte të ndryshme në DB, për shembull të gjejmë një tabelë në një skemë dhe të shqyrtojmë strukturën e saj (cilat kolona, çelësa, indekse, constraints dhe elemente të tjera përdoren). Dhe nga çdo IDE grafike ose një DB-manager sado modest, para së gjithash presim pikërisht këto mundësi. Që gjithçka të jetë e shpejtë dhe të mos duhet të presim gjysmë ore derisa të hapet dritarja me informacionin e nevojshëm (sidomos me një lidhje të ngadaltë me DB në distancë), dhe njëkohësisht që informacioni i marrë të jetë i freskët dhe aktual, jo një cache e vjetruar. Madje, sa më komplekse e më e madhe të jetë DB dhe sa më i lartë të jetë numri i tyre, aq më e vështirë bëhet kjo.
Por zakonisht e lë mënjanë miun dhe thjesht shkruaj kod. Supozojmë se duhet të mësojmë se cilat tabela (dhe me çfarë vetish) ndodhen në skemën "HR". Në shumicën e DBMS-ve, rezultati i nevojshëm mund të merret me një query të thjeshtë nga information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Nga një bazë te tjetra, përmbajtja e këtyre tabelave referuese ndryshon në varësi të mundësive të secilit DBMS. Për shembull, në MySQL nga i njëjti katalog mund të merren parametrat e tabelës specifikë për këtë DBMS:
select table_name
     , storage_engine -- "Engine" i përdorur ("MyISAM", "InnoDB" etc)
     , row_format     -- Formati i rreshtit ("Fixed", "Dynamic" etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle nuk e mbështet information_schema, por ka , ndaj nuk lindin probleme të mëdha:
select table_name
     , pct_free       -- Minimumi i hapësirës së lirë në bllokun e të dhënave (%)
     , pct_used       -- Minimumi i hapësirës së përdorur në bllokun e të dhënave (%)
     , last_analyzed  -- Data e mbledhjes së fundit të statistikave
     , ...
  from all_tables
 where owner = 'HR'
As ClickHouse nuk bën përjashtim:
select name
     , engine -- "Engine" i përdorur ("MergeTree", "Dictionary" etc)
     , ...
  from system.tables
 where database = 'HR'
Diçka e ngjashme mund të bëhet edhe në Cassandra (ku ka columnfamilies në vend të tables dhe keyspace në vend të skemave):
select columnfamily_name
     , compaction_strategy_class  -- Strategjia e grumbullimit të mbeturinave
     , gc_grace_seconds           -- Koha e jetës së mbeturinave
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Edhe për shumicën e DB-ve të tjera mund të krijohen query të ngjashme (madje edhe Mongo ka , i cili përmban informacion për të gjitha koleksionet në sistem).
Natyrisht, në këtë mënyrë mund të merrni informacion jo vetëm për tabelat, por në përgjithësi për çdo objekt. Herë pas here, njerëz të mirë ndajnë një kod të tillë për DB të ndryshme, si për shembull në serinë e artikujve në Habr "Funksione për dokumentimin e bazave të të dhënave PostgreSQL" (, , ). Sigurisht, ta mbash në mendje gjithë këtë mal me kërkesa dhe t’i shtypësh vazhdimisht është një "kënaqësi" jo fort e madhe, ndaj në IDE/redaktorin tim të preferuar kam një grup snippets të përgatitura paraprakisht për kërkesat që përdor më shpesh, dhe mbetet vetëm të shkruaj emrat e objekteve në shabllon.
Në fund, kjo mënyrë navigimi dhe kërkimi të objekteve është shumë më fleksibël, kursen shumë kohë dhe ju lejon të merrni pikërisht atë informacion dhe në atë formë që ju nevojitet në atë moment (siç përshkruhet, për shembull, në postimin ).
Veprime me objektet
Pasi kemi gjetur dhe shqyrtuar objektet e nevojshme, është koha të bëjmë me to diçka të dobishme. Natyrisht, pa i hequr duart nga tastiera.
Nuk është sekret që fshirja e thjeshtë e një tabele do të duket pothuajse njësoj në pothuajse të gjitha DB:
drop table hr.personsNdërsa me krijimin e një tabele bëhet më interesante. Praktikisht çdo DBMS (përfshirë edhe shumë NoSQL) në një formë apo në një tjetër mbështet "create table", dhe pjesa kryesore e saj ndryshon shumë pak (emri, lista e kolonave, llojet e të dhënave), por detajet e tjera mund të ndryshojnë rrënjësisht dhe varen nga arkitektura e brendshme dhe mundësitë e DBMS-së konkrete. Shembulli im i preferuar është se në dokumentacionin e Oracle vetëm BNF-të "e zhveshura" për sintaksën e "create table" . DBMS të tjera kanë mundësi më modeste, por secila prej tyre gjithashtu ofron shumë veçori interesante dhe unike për krijimin e tabelave (, , , ). Vështirë se ndonjë "wizard" grafik nga ndonjë IDE tjetër (sidomos universale) do të mund t’i mbulojë plotësisht të gjitha këto mundësi, dhe edhe nëse do të mundej, nuk do të ishte pamje për ata që e kanë zemrën e dobët. Nga ana tjetër, një komandë create table e shkruar saktë dhe në kohën e duhur do t’ju lejojë t’i shfrytëzoni pa vështirësi të gjitha këto, duke e bërë ruajtjen dhe qasjen në të dhënat tuaja të besueshme, optimale dhe sa më komode.
Gjithashtu, në shumë DBMS ka lloje specifike objektesh që mungojnë në DBMS të tjera. Madje mund të kryejmë operacione jo vetëm mbi objektet e bazës së të dhënave, por edhe mbi vetë DBMS-në, për shembull të “vrasim” një proces, të lirojmë një zonë të caktuar të memories, të aktivizojmë gjurmimin, të kalojmë në modalitetin “read only” dhe shumë të tjera.
Dhe tani të vizatojmë pak
Një nga detyrat më të zakonshme është ndërtimi i një diagrami me objektet e bazës së të dhënave, që në një pamje të qartë të shihen objektet dhe lidhjet mes tyre. Këtë e mbështet pothuajse çdo IDE grafike, utilitete të veçanta të “command line”, mjete grafike të specializuara dhe modelues. Ato do t’ju vizatojnë diçka “siç dinë”, ndërsa ndikimi mbi këtë proces zakonisht kufizohet në disa parametra në skedarin e konfigurimit ose disa opsione në ndërfaqe.
Por kjo çështje mund të zgjidhet shumë më thjesht, më fleksibël dhe më elegant, dhe sigurisht me ndihmën e kodit. Për ndërtimin e diagrameve të çdo kompleksiteti kemi disa gjuhë të specializuara markimi (DOT, GraphML etc), si dhe një gamë të tërë aplikacionesh (GraphViz, PlantUML, Mermaid), që dinë të lexojnë këto udhëzime dhe t’i vizualizojnë në formate të ndryshme. Ndërsa informacionin për objektet dhe lidhjet mes tyre tashmë e dimë si ta marrim.
Le të japim një shembull të shkurtër se si mund të dukej kjo, duke përdorur PlantUML dhe (majtas është SQL-kërkesa që gjeneron udhëzimin e nevojshëm për PlantUML, ndërsa djathtas rezultati):
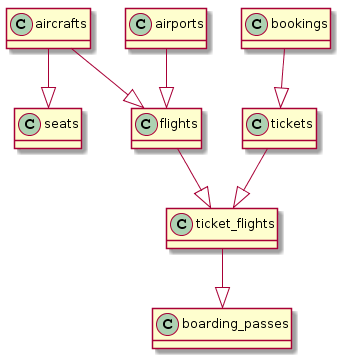
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Dhe nëse bëjmë pak më shumë përpjekje, atëherë mbi bazën e mund të marrim diçka shumë të ngjashme me një diagramë të vërtetë ER:
Një SQL-kërkesë paksa më e ndërlikuar
-- Koka
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabelat
select format('Table(%s, "%s n informacion rreth %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Marrëdhëniet midis tabelave
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Një %s mund të ketë shumë %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Fundi
select '@enduml' 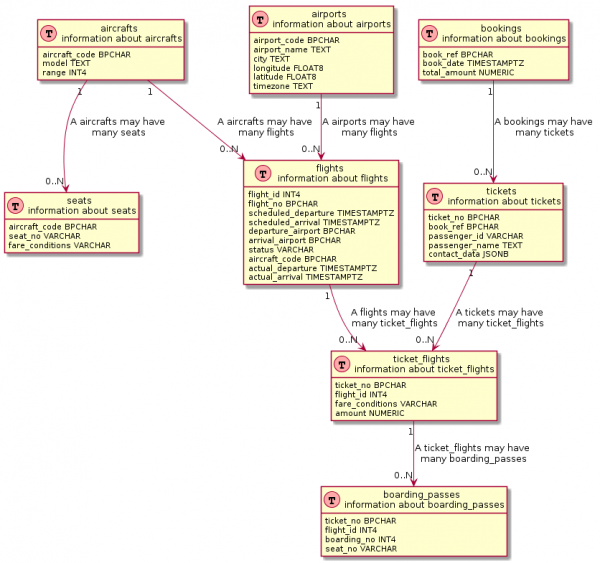
Nëse e shikoni me vëmendje, shumë mjete vizualizimi nën kapak përdorin pikërisht kërkesa të ngjashme. Vërtet, këto kërkesa zakonisht janë thellë , pa folur fare për ndonjë modifikim të tyre.
Metrikat dhe monitorimi
Le të kalojmë te një temë tradicionalisht e vështirë — monitorimi i performancës së DB. Më kujtohet një histori e vogël e vërtetë, që ma tregoi “një miku im”. Në një nga projektet ishte një DBA shumë i fuqishëm dhe pak zhvillues e njihnin personalisht, madje rrallë kush e kishte parë ndonjëherë me sy (edhe pse, sipas thashethemeve, punonte diku në godinën ngjitur). Në orën “X”, kur sistemi production i një retaileri të madh niste sërish “të mos ndihej mirë”, ai dërgonte në heshtje screenshot-e të grafikëve nga Oracle Enterprise Manager, ku me kujdes theksonte me marker të kuq pikat kritike “për qartësi” (që, për ta thënë butë, nuk ndihmonte shumë). Dhe pikërisht sipas kësaj “fotografie” duhej bërë diagnostikimi dhe zgjidhja. Ndërkohë, askush nuk kishte akses te Enterprise Manager-i i çmuar (në të dy kuptimet e fjalës), sepse sistemi është kompleks dhe i shtrenjtë, e “mos vallë zhvilluesit klikojnë ndonjë gjë dhe prishin gjithçka”. Prandaj zhvilluesit, në mënyrë “empirike”, gjenin vendin dhe shkakun e ngadalësimeve dhe publikoni një patch. Nëse letra kërcënuese nga DBA nuk vinte sërish në të ardhmen e afërt, të gjithë merrnin frymë të lehtësuar dhe ktheheshin te detyrat e tyre aktuale (deri te Letra e radhës).
Por procesi i monitorimit mund të duket më i thjeshtë dhe më miqësor, dhe më e rëndësishmja — i arritshëm dhe transparent për të gjithë. Të paktën pjesa e tij bazë, si shtesë ndaj sistemeve kryesore të monitorimit (të cilat, pa dyshim, janë të dobishme dhe në shumë raste të pazëvendësueshme). Çdo DBMS është e gatshme të ndajë lirisht dhe plotësisht falas informacion për gjendjen e saj aktuale dhe performancën. Në të njëjtën Oracle DB “të përgjakshme”, pothuajse çdo informacion për performancën mund të merret nga pamjet sistemore, duke filluar nga proceset dhe sesionet e deri te gjendja e buffer cache (për shembull, , seksioni “Monitoring”). Edhe në Postgresql ekziston një gamë e tërë pamjesh sistemore për , në veçanti ato kaq të pazëvendësueshme në përditshmërinë e çdo DBA-je, si , , . Në MySQL për këtë qëllim ekziston madje një skemë e veçantë . Ndërsa në Mongo, i integruar grumbullon të dhënat e performancës në koleksionin sistemor .
Kështu, duke përdorur një mjet për mbledhjen e metrikave (Telegraf, Metricbeat, Collectd) që mund të ekzekutojë kërkesa SQL të personalizuara, një ruajtje për këto metrika (InfluxDB, Elasticsearch, Timescaledb) dhe një mjet vizualizimi (Grafana, Kibana), mund të krijoni një sistem monitorimi mjaft të lehtë dhe fleksibël, i cili do të integrohet ngushtë me metrika të tjera të përgjithshme të sistemit (të marra, për shembull, nga serveri i aplikacionit, nga OS etj.). Për shembull, si është bërë te pgwatch2, ku përdoret kombinimi InfluxDB + Grafana dhe një grup kërkesash ndaj pamjeve të sistemit, të cilave gjithashtu mund t'u .
Përveç kësaj
Dhe kjo është vetëm një listë e përafërt e asaj që mund të bëhet me bazën tonë të të dhënave përmes kodit të zakonshëm SQL. Jam i sigurt se mund të gjenden edhe shumë përdorime të tjera, shkruani në komente. Ndërsa për mënyrën se si (dhe më e rëndësishmja pse) e gjithë kjo mund të automatizohet dhe të përfshihet në pipeline-in tuaj CI/CD, do të flasim herën tjetër.
Burimi: habr.com
