

DataHub me burim të hapur: platforma për kërkimin dhe zbulimin e metadata-ve nga LinkedIn
Kërkimi i shpejtë i të dhënave të nevojshme është thelbësor për çdo kompani që mbështetet në një sasi të madhe të dhënash për të marrë vendime. Kjo ndikon jo vetëm në produktivitetin e përdoruesve të dhënash (përfshirë analistët, zhvilluesit e mësimit të automatizuar, specialistët e përpunimit të të dhënave dhe inxhinierët e të dhënave), por gjithashtu ka një ndikim të drejtpërdrejtë në produktet finale që varen nga një cikël cilësor i mësimit të automatizuar (ML). Për më tepër, trendi i implementimit ose krijimit tëPlatformave të mësimit të automatizuar natyrshëm ngre pyetjen: cila është metoda juaj për të zbuluar brendshëm tiparet, modelet, metrikat, grupet e të dhënave etj.
Në këtë artikull do të flasim për si e publikuan burimin e të dhënave nën një licencë të hapur në platformën tonë të kërkimit dhe zbulimit të treguesve që nga ditët e para të projektit . LinkedIn mbështet një version të saj të DataHub ndaras nga versioni me kod të hapur. Ne do të fillojmë me shpjegimin e arsyes pse na nevojiten dy ambiente të ndara zhvillimi, pas së cilës do të diskutojmë qasjet e para për përdorimin e WhereHows me kod të hapur dhe do të bëjmë një krahasim të versionit tonë të brendshëm (prodhues) të DataHub me versionin në . Ne gjithashtu do të ndajmë detaje mbi zgjidhjen tonë të re automatizuar për dërgimin dhe marrjen e azhurnimeve me kod të hapur për të sinkronizuar të dy depozitat. Në fund, do t'u japim udhëzime se si të filloni të përdorni DataHub me kod të hapur dhe do të diskutojmë shkurtimisht mbi arkitekturën e tij.
WhereHows tani është DataHub!
Ekipi i treguesve të dhënash në LinkedIn e prezantoi më parë (pasardhësi i WhereHows), platformën për kërkimin dhe zbulimin e treguesve të dhënash nga LinkedIn, dhe ndau planet për ta hapur atë. Pak pasi u shpall kjo, ne lëshuam një version alfa të DataHub dhe e ndamë atë me komunitetin. Që atëherë, ne kemi kontribuar vazhdimisht në depozitë dhe kemi punuar me përdoruesit e interesuar për të shtuar funksionet më të kërkuara dhe për të zgjidhur çështjet. Tani jemi të lumtur të shpallim lëshimin zyrtar të .
Qasjet me kod të hapur
WhereHows, portali origjinal i LinkedIn për kërkimin e të dhënave dhe origjinën e tyre, u hap si një projekt të brendshëm; ekipi i treguesve të dhënash e hapi atë . Që atëherë, ekipi gjithmonë ka mbështetur dy baza të ndryshme kodike - një për burim të hapur, dhe një tjetër për përdorim të brendshëm nga LinkedIn, pasi jo të gjitha funksionalitetet e produktit, të zhvilluara për opsionet e përdorimit të LinkedIn, ishin në përgjithësi të aplikueshme për një audiencë më të gjerë. Për më tepër, WhereHows ka disa varësi të brendshme (infrastrukturë, biblioteka etj.), kodin burimor të cilave nuk e kanë hapur. Gjatë viteve të mëvonshme, WhereHows ka kaluar përmes shumë iteracioneve dhe cikleve të zhvillimit, duke bërë që sinkronizimi i dy bazave të ndryshme të kodit të jetë një sfidë e madhe. Ekipi i metadatatëve ka provuar teknika të ndryshme gjatë viteve, për të përpjekur të sinkronizojë zhvillimin e brendshëm me zhvillimin me burim të hapur.
Përpjekja e parë: "Fillimisht burim i hapur"
Fillimisht, ne ndoqëm modelin e zhvillimit "fillimisht burim i hapur", ku zhvillimi kryesor ndodhte në një depot me burim të hapur, dhe ndryshimet bëheshin për implementimin e brendshëm. Problemi me këtë qasje është se kodi gjithmonë dërgohej në GitHub përpara se të verifikohej plotësisht brenda. Derisa të bëheshin ndryshime nga depot me burim të hapur dhe të bëhej një implementim i ri i brendshëm, ne nuk do të zbulojmë asnjë problem prodhimi. Në rast të një implementimi të dobët, gjithashtu ishte shumë e vështirë të identifikohej fajësia, pasi ndryshimet bëheshin në grupe.
Përveç kësaj, ky model e uli produktivitetin e ekipit në zhvillimin e funksioneve të reja që kërkonin iteracione të shpejta, sepse e detyronte çdo ndryshim që të dërgohej fillimisht në depot me burim të hapur, e më pas në depot e brendshme. Për të shkurtuar kohën e përpunimit, çdo riparim ose ndryshim mund të bëhej fillimisht në depot e brendshme, por ky u bë një problem i madh kur erdhi koha për të bashkuar këto ndryshime përsëri në depot me burim të hapur, sepse dy depot ishin jashtë sinkronizimit.
Ky kjo model është shumë më e thjeshtë për t'u realizuar për platforma të përgjithshme, biblioteka ose projekte infrastrukturore sesa për aplikacione të plota web për përdoruesit. Për më tepër, kjo model është ideale për projektet që fillojnë me kod të hapur që nga dita e parë, por WhereHows është krijuar si një aplikacion web tërësisht të brendshëm. Ishte vërtet e vështirë të abstrohet plotësisht nga të gjitha varësitë e brendshme, prandaj na duhej të ruanim një ndarje të brendshme, por ruajtja e ndarjes së brendshme dhe zhvillimi kryesisht me kod të hapur nuk funksionuan plotësisht.
Përpjekja e dytë: "Fillimisht të brendshëm"
** Si përpjekja e dytë, ne kaluam në modelin e zhvillimit "fillimisht të brendshëm", ku zhvillimi kryesor zhvillohet brenda kompanisë, dhe ndryshimet bëhen në kodin e hapur në një bazë të rregullt. Megjithëse ky model është më i përshtatshëm për rastin tonë të përdorimit, ai ka disa probleme. Dërgimi i drejtpërdrejtë i të gjitha ndryshimeve në depozitën e kodit të hapur dhe më pas përpjekja për të zgjidhur konfliktet e bashkimit më vonë është një mundësi, por e merr shumë kohë. Zhvilluesit në shumicën e rasteve përpiqen ta shmangin këtë me çdo kontroll të kodit. Si rezultat, kjo do të ndodhte shumë më rrallë, në grupe, dhe kështu e bën më të vështirë zgjidhjen e mëvonshme të konflikteve të bashkimit.
Në përpjekjen e tretë, gjithçka shkoi mirë!
Dy përpjekjet e përmendura më sipër çuan në faktin se depozita WhereHows në GitHub mbeti e vjetruar për një kohë të gjatë. Ekipa vazhdoi të përmirësonte funksionalitetet dhe arkitekturën e produktit, prandaj versioni i brendshëm i WhereHows për LinkedIn po bëhej gjithnjë e më i avancuar se versioni me kod të hapur. Ai madje kishte një emër të ri — DataHub. Duke u bazuar në përpjekjet e mëparshme të pasuksesshme, ekipi vendosi të zhvillonte një zgjidhje afatgjatë dhe të shkallëzueshme.
Për çdo projekt të ri me kod të hapur, ekipi i zhvilluesve të kodit të hapur të LinkedIn konsulton dhe mbështet modelin e zhvillimit, ku modulet e projektit zhvillohen plotësisht me kod të hapur. Artefaktet me mbështetje versioni shpërndahen në një depo publik, dhe më pas kthehen në një artefakt të brendshëm të LinkedIn me anë të Ndjekja e këtij modeli zhvillimi nuk është vetëm e mirë për ata që përdorin kod të hapur, por gjithashtu çon në krijimin e një arkitekture më modulare, të zgjerueshme dhe të integrueshme.
Megjithatë, për të arritur këtë gjendje për një aplikacion të brendshëm të pjekur, si DataHub, do të duhen një sasi e konsiderueshme kohore. Kjo gjithashtu përjashton mundësinë e një implementimi funksional të kodit të hapur përpara se të gjitha varësitë e brendshme të jenë plotësisht të abstrahuara. Prandaj, ne kemi zhvilluar mjete që na ndihmojnë të kontribuojmë në kodin e hapur më shpejt dhe me shumë më pak dhimbje. Ky zgjidhje është e favorshme si për ekipin e metadhenave (zhvilluesi i DataHub), ashtu edhe për komunitetin e kodit të hapur. Në seksionet e ardhshme do të diskutohet ky qasje e re.
Automatizimi i publikimit me kod të hapur
Qasja e fundit e grupit të metadhenave ndaj DataHub me kod të hapur është zhvillimi i një instrumenti që sinkronizon automatikisht bazën e kodit të brendshëm dhe depozitën me kod të hapur. Funksionet kryesore të këtij instrumenti përfshijnë:
- Sinkronizimi i kodit nga LinkedIn në / nga kodi i hapur, në mënyrë të ngjashme .
- Krijimi i titujve të licencës, në mënyrë të ngjashme .
- Krijimi automatik i regjistrave të komiteteve të hapura nga regjistrat e brendshëm të komiteteve.
- Parandalimi i ndryshimeve të brendshme që shkelin ndërtimin me kod të hapur përmes .
Në seksionet e ardhshme do të shqyrtohen në detaje funksionet e përmendura më sipër, të cilat përmbajnë probleme interesante.
Sinkronizimi i kodit burimor
Ndryshe nga versioni i DataHub me kod të hapur, i cili përbën një depozitë të vetme në GitHub, versioni i DataHub për LinkedIn është një kombinim i disa depozitave (brenda kompanisë të quajtura ). Interfejsi i DataHub, biblioteka e modeleve të metadhenave, shërbimi i depozitës së metadhenave dhe detyrat e rrjedhës ndodhen në depozita të ndryshme në LinkedIn. Megjithatë, për të lehtësuar punën e përdoruesve me kod të hapur, ne kemi një depo të vetme për versionin e DataHub me kod të hapur.
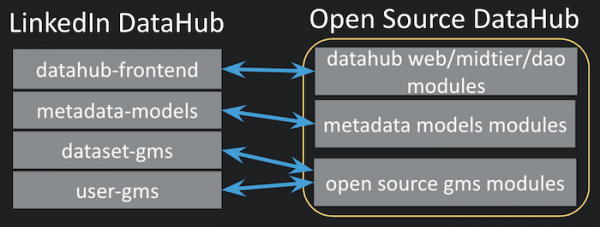
Figura 1: Sinkronizimi midis depozitave LinkedIn DataHub dhe depozitës së vetme DataHub me kod të hapur
Për të mbështetur proceset automatike të ndërtimit, dërgimit dhe nxjerrjes, instrumenti ynë i ri krijon automatikisht një mapim në nivelin e skedarit, përkatësisht për çdo skedar burimi. Megjithatë, për këtë mjet kërkohet një konfigurim fillestar dhe përdoruesit duhet të ofrojnë një pamje të nivelit të lartë të moduleve, siç tregohet më poshtë.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Mapimi në nivelin e modulit është një JSON i thjeshtë, ku çelësat janë modul të synuar në depo me kod të hapur dhe vlerat janë lista e moduleve burimore në depozitë të LinkedIn. Çdo modul i synuar në depo me kod të hapur mund të ushqehet nga çdo numër moduli burimor. Për të treguar emrat e brendshëm të depozitave në modulet burimore përdoret në stilin Bash. Duke përdorur skedarin e mapimit në nivelin e modulit, mjetet krijojnë një skedar mapimi në nivelin e skedarëve duke skanuar të gjithë skedarët në katalogët e lidhur.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
Mapimi në nivelin e skedarëve krijohet automatikisht nga mjetet; megjithatë, ai gjithashtu mund të përditësohet manualisht nga përdoruesi. Ky mapim është 1:1 i skedarit burimor të LinkedIn me një skedar në depozitë me kod të hapur. Ekzistojnë disa rregulla të lidhura me këtë krijim automatik të mapimit të skedarëve:
- Në rastin e disa moduleve burimore për një modul të synuar në kod të hapur, mund të ndodhin konflikte, për shembull, e njëjta , e cila ekziston në më shumë se një modul burimor. Si një strategji për zgjidhjen e konflikteve, mjetet tona përdorin automatikisht opsionin 'fituesi i fundit'.
- "null" do të thotë se skedari burimor nuk është pjesë e depozitës me kod të hapur.
- Pas çdo dërgim në kodin e hapur ose nxjerrje nga ai, kjo përputhje azhurnohet automatikisht dhe krijohet një moment fotografik. Kjo është e nevojshme për të identifikuar shtesat dhe fshirjet në kodin burimor pas veprimit të fundit.
Krijimi i logëve të angazhimeve
Logët e angazhimeve për angazhimet me kod të hapur gjithashtu krijohen automatikisht duke bashkuar logët e angazhimeve të repository-ve të brendshme. Më posht është një shembull i logut të angazhimit për të treguar strukturën e logut të angazhimit të krijuar nga mjeti ynë. Angazhimi tregon qartë se cilat versione të repository-ve burimore janë paketuar në këtë angazhim dhe siguron informacion të përmbledhur për logun e angazhimit. Kontrolloni këtë në një shembull real të logut të angazhimit të krijuar nga mjetet tona.
metadata-models 29.0.0 -> 30.0.0
    Shtuar modeli i aspektit foo
    Rregulluar çështjen bar

dataset-gms 2.3.0 -> 2.3.4
    Shtuar API-në rest.li për të shërbyer aspektin foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testimi i varësisë
LinkedIn ka , e cila ndihmon të sigurojë se ndryshimet në multi-produktin e brendshëm nuk do të dështojnë ndërtimin e multi-produkteve varëse. Repository DataHub me kod të hapur nuk është multi-produkt dhe nuk mund të jetë një varësi e drejtpërdrejtë nga ndonjë multi-produkt, por përmes një shell-i multi-produkti, i cili nxjerr kodin burimor të DataHub me kod të hapur, ne ende mund ta përdorim këtë sistem testimi varësish. Prandaj, çdo ndryshim (i cili ndoshta do të hapet më vonë) në ndonjë nga multi-produktet që ushqejnë repository-n DataHub me kod të hapur, aktivizon një ngjarje ndërtimi në shell-in e multi-produktit. Si rezultat, çdo ndryshim që nuk lejon ndërtimin e shell-it multi-produkt, nuk kalon testet para angazhimit të multi-produktit burimor dhe kthehet.
Ky është një mekanizëm i dobishëm që ndihmon të parandalojë çdo angazhim të brendshëm që prish ndërtimin me kod të hapur dhe e zbulon atë gjatë krijimit të angazhimit. Pa këtë, do të ishte mjaft e vështirë të përcaktohej se cili angazhim i brendshëm çoi në dështimin e ndërtimit të repository-t me kod të hapur, sepse ne vendosim ndryshimet e paketuara të brendshme në repository-n DataHub me kod të hapur.
Dallimet midis DataHub me burim të hapur dhe versionit tonë të prodhimit
Derisa ne kemi diskutuar zgjidhjen tonë për sinkronizimin e dy versioneve të repozitorëve DataHub, deri tani nuk kemi shpjeguar arsyet përse kemi nevojë për dy rrjedha të ndryshme zhvillimi. Në këtë seksion do të përmendim dallimet midis versionit publik të DataHub dhe versionit të prodhimit në serverat LinkedIn, si dhe do të shpjegojmë arsyet e këtyre dallimeve.
Një nga burimet e mosmarrëveshjeve rrjedh nga fakti se versioni ynë i prodhimit ka varësi nga kodet me burim ende të mbyllur, siç është Offspring i LinkedIn (strukturë e brendshme e menaxhimit të varësive të LinkedIn). Offspring përdoret gjerësisht në bazën tonë të brendshme të kodit, sepse është metoda e preferuar për menaxhimin e konfigurimeve dinamike. Por kjo nuk është me burim të hapur; prandaj na nevojitet të gjejmë alternativa me burim të hapur për DataHub me burim të hapur.
Ka edhe arsye të tjera. Ndërsa krijojmë zgjerime të modelit të metadatan për nevojat e LinkedIn, këto zgjerime zakonisht janë shumë specifike për LinkedIn dhe ndoshta nuk mund të aplikohen drejtpërdrejt në mjedise të tjera. Për shembull, ne kemi etiketat shumë specifike për identifikuesit e pjesëmarrësve dhe llojet e tjera të metadatan për përshtatjen. Pra, aktualisht kemi përjashtuar këto zgjerime nga modeli i metadatan të DataHub me burim të hapur. Ndërsa angazhohemi me komunitetin dhe kuptojmë nevojat e tyre, do të punojmë për versionet e përbashkëta të këtyre zgjerimeve me burim të hapur, kur është e nevojshme.
Lehtësia e përdorimit dhe adaptimi më i lehtë për komunitetin me burim të hapur gjithashtu frymëzuan disa dallime midis dy versioneve të DataHub. Dallimet në infrastrukturën e procesimit në kohë reale janë një shembull i mirë. Ndërsa versioni ynë i brendshëm përdor infrastrukturën e procesimit të menaxhuar, ne vendosëm të përdorim procesimin e integruar (autonom) për versionin me burim të hapur, pasi ajo lejon të shmangim krijimin e një varësie tjetër infrastrukturore.
Një shembull tjetër i ndryshimit është prania e një GMS (Sistemi i Menaxhimit të Metadave) në implementimin me burim të hapur, në vend të disa GMS-ve. GMA (Arkitektura e Përgjithshme e Metadave) është emri i arkitekturës së brendshme për DataHub, ndërsa GMS është depoja e metadave në kontekstin e GMA. GMA është një arkitekturë shumë fleksibile që ju lejon të shpërndani çdo ndërtim të dhënash (p.sh. grupe të dhënash, përdorues, etj.) në një depo të vetme metadash, ose të ruani disa ndërtime të dhënash në një depo metadash, për aq kohë sa regjistri që përmban hartimin e strukturës së dhënave në GMS përditësohet. Për thjeshtësi, ne zgjodhëm një shembull GMS që ruan të gjitha ndërtimet e ndryshme të dhënash në DataHub me burim të hapur.
Lista e plotë e ndryshimeve midis dy implementimeve është e dhënë në tabelën më poshtë.
Karakteristikat e Produktit
LinkedIn DataHub
Open Source DataHub
Ndërtimet e Mbështetura të Dhënash
1) Grupa të dhënash 2) Përdorues 3) Metrika 4) Karakteristika ML 5) Grafikë 6) Paneli i Kontrollit
1) Grupa të dhënash 2) Përdorues
Burimet e Metadave të Mbështetura për Grupet e Dhënash
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Përpunimi i Rrymës
I menaxhuar
I inkorporuar (i pavarur)
Injeksioni i Varësive & Konfigurimi Dinamik
Offspring i LinkedIn
Mjetet e Ndërtimit
Ligradle (mjeti interner i Gradle i LinkedIn)
CI/CD
CRT (CI/CD i brendshëm i LinkedIn)
dhe
Depot e Metadave
GMS të distribuuar të shumta: 1) GMS i Grupit të Dhënash 2) GMS i Përdoruesve 3) GMS i Metrikave 4) GMS i Karakteristikave 5) GMS i Grafikëve/Paneleve të Kontrollit
GMS i vetëm për: 1) Grupa të dhënash 2) Përdorues
Mikroshërbimet në kontejnerët Docker
lehtësojnë implementimin dhe shpërndarjen e aplikacioneve duke përdorur Çdo pjesë e shërbimit në DataHub me burim të hapur, duke përfshirë komponentët e infrastrukturës si Kafka, , dhe , ka imazhin e saj Docker. Për orkestrimin e kontejnerëve Docker, ne përdorëm .
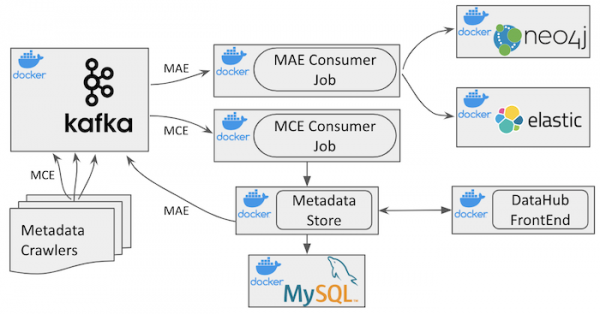
Figura 2: Arkitektura DataHub *me burim të hapur**
Mund të shihni arkitekturën e nivelit të lartë të DataHub në figurën më lart. Përveç komponentëve të infrastrukturës, ajo ka katër kontejnerë të ndryshëm Docker:
datahub-gms: shërbimi i depozitës së metadave
datahub-frontend: aplikacioni , që shërben ndërfaqen e DataHub.
datahub-mce-consumer: aplikacioni , i cili përdor rrjedhën e ngjarjeve të ndryshimit të metadave (MCE) dhe përditëson depozitat e metadave.
datahub-mae-consumer: aplikacioni , i cili përdor rrjedhën e ngjarjeve të auditit të metadave (MAE) dhe krijon një bazë të dhënash për indeksimin e kërkimeve dhe grafit.
Dokumentacioni për repozitorin me burim të hapur dhe përmbajnë më shumë informacion rreth veçorive të shërbimeve të ndryshme.
CI / CD në DataHub me kod burimor të hapur
Repoja e DataHub me kod burimor të hapur përdor për integrimin e vazhdueshëm dhe për shpërndarjen e vazhdueshme. Të dyja kanë një integrim të mirë me GitHub dhe janë të lehta për tu konfiguruar. Për pjesën më të madhe të infrastrukturës me kod burimor të hapur, të zhvilluar nga komuniteti ose kompani private (p.sh., ), janë krijuar imazhe Docker, dhe ato shpërndahen në Docker Hub për të lehtësuar përdorimin nga komuniteti. Çdo imazh Docker i gjetur në Docker Hub mund të përdoret lehtësisht me një komandë të thjeshtë .
Me çdo komit në repo me kod burimor të hapur DataHub, të gjitha imazhet Docker krijohen automatikisht dhe shpërndahen në Docker Hub me tagun "latest". Nëse në Docker Hub është caktuar ndonjë , të gjitha tagët në repo me kod burimor të hapur lëshohen gjithashtu me emra tag-esh përkatës në Docker Hub.
Përdorimi i DataHub
është shumë i thjeshtë dhe përbëhet nga tre hapa të thjeshtë:
- Kloni repo-n me kod burimor të hapur dhe filloni të gjitha kontejnerët Docker duke përdorur docker-compose me skenarin e dhënë docker-compose për një fillim të shpejtë.
- Shkarkoni mostrën e të dhënave, të paraqitura në repo, duke përdorur mjetin e komandës, i cili gjithashtu ofrohet.
- Shikoni DataHub në shfletuesin tuaj.
Një po ashtu është vendosur për pyetje të shpejta. Përdoruesit gjithashtu mund të krijojnë probleme direkt në repo-n GitHub. Më e rëndësishmja, ne mirëpresim dhe vlerësojmë të gjitha feedback dhe sugjerime!
Planet për të ardhmen
Aktualisht, çdo infrastrukturë ose mikroshërbim për DataHub me kod burimor të hapur është ndërtuar si një kontejner Docker, dhe e gjithë sistemi orkestrohet me . Duke marrë parasysh popullaritetin dhe shpërndarjen e gjerë , ne gjithashtu dëshirojmë të ofrojmë një zgjidhje të bazuar në Kubernetes në të ardhmen afatshkurtër.
Ne gjithashtu planifikojmë të ofrojmë një zgjidhje të gatshme për shpërndarjen e DataHub në një shërbim të hapur të cloud, siç është , ose . Duke marrë parasysh njoftimin e fundit mbi migrimin e LinkedIn në Azure, kjo do të përputhet me prioritetet e brendshme të grupit të metadata.
Dhe e fundit, por jo më pak e rëndësishme: falenderime për të gjithë përdoruesit e parë të DataHub në komunitetin e burimeve të hapura, që vlerësuan versionet alfa të DataHub dhe ndihmuan në zbardhjen e problemeve dhe përmirësimin e dokumentacionit.
Burimi: habr.com
