

Si si backend zhvilluesi kupton se SQL pyetja do të funksionojë mirë në 'prod'? Në kompani të mëdha ose me rritje të shpejtë, qasja në 'prod' nuk është e mundur për të gjithë. Dhe madje me qasje, jo të gjitha pyetjet mund të verifikohen pa dhimbje, ndërsa krijimi i një kopjeje të DB shpesh merr orë. Për të zgjidhur këto probleme, krijuam një DBA artificial - Joe. Ai tashmë është implementuar me sukses në disa kompani dhe ndihmon jo vetëm dhjetëra zhvillues.
Video:
Përshëndetje të gjithëve! Më quajnë Anatolij Stansler. Unë punoj në kompaninë . Ne merremi me atë që përshpejtojmë procesin e zhvillimit, duke eliminuar vonesat e lidhura me punën me Postgres, për zhvilluesit, DBA-të dhe QA-në.
Kemi klientë të shkëlqyer dhe sot një pjesë e prezantimit do t’i kushtohet rasteve që kemi hasur në punë me ta. Do flas për mënyrën se si ndihmuam ata të zgjidhnin disa probleme mjaft serioze.
Kur bëjmë zhvillim dhe realizojmë migrime të komplikuara ngarkesash, ne bëjmë pyetje: 'A do të fluturojë kjo migrim?'. Ne përdorim rishikimin, ne përdorim njohuritë e kolegëve më me përvojë, ekspertëve DBA. Dhe ata mund të thonë - do të fluturojë apo jo.
Por, ndoshta do të ishte më mirë nëse mund të testonim vetë këtë në kopje me përmasa të plota. Dhe sot do të flasim saktësisht për se cilët janë tani qasjet për testimin dhe si mund ta bëjmë më mirë dhe me cilat mjete. Po ashtu do të flasim për avantazhet dhe disavantazhet e këtyre qasjeve dhe se çfarë mund të përmirësojmë këtu.
Kush ka bërë ndonjëherë indekse ose ka bërë ndonjë ndryshim direkt në prod? Mjaft e madhe. Dhe sa prej jush përjetuan humbje të të dhënave ose pauza? Atëherë ju e njihni këtë dhembje. Faleminderit Zotit, backup-et ekzistojnë.
Qasja e parë - është testimi në prod. Ose, kur zhvilluesi është në kompjuterin lokal, ka të dhëna testuese, ka ndonjë grup të kufizuar. Dhe ne e nxjerrim atë në prod, dhe kemi një situatë të tillë.
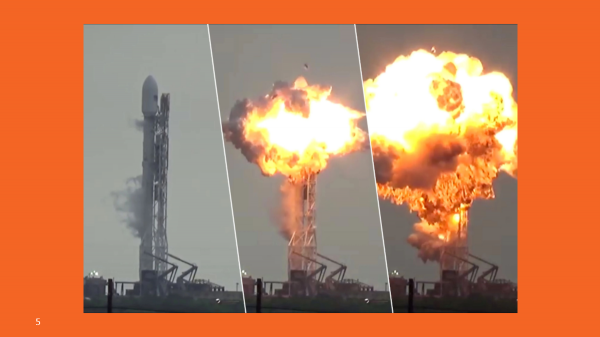
Kjo është e dhimbshme, kjo është e shtrenjtë. Ndoshta, nuk është më mirë ta bësh kështu.
Por si mund ta bëjmë më mirë?
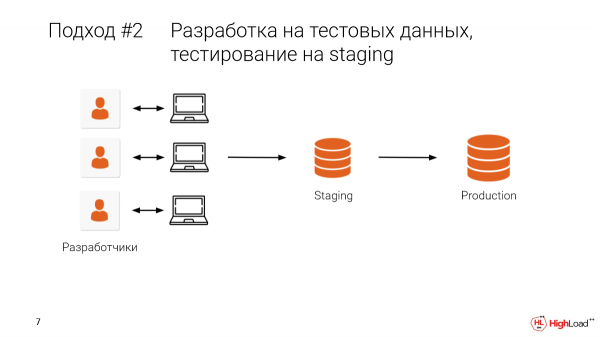
Le të marrim staging dhe t'i rezervojmë atij një pjesë të prod. Ose, në rastin më të mirë, të marrim prodin e vërtetë, të gjitha të dhënat. Dhe pasi të kemi zhvilluar lokal, do të kontrollojmë gjithashtu dhe në staging.
Kjo do të na lejojë të eliminojmë disa gabime, dmth. të mos i lejojmë ato në prod.
Cilat janë problemet?
- Problemi është se këtë staging e ndajmë me kolegët. Dhe shumë shpesh ndodh që bën një ndryshim, bam – dhe nuk ka të dhëna, puna është në ajër. Staging ishte shumë terabajt. Dhe duhet të presim gjatë derisa të ngrihet përsëri. Dhe ne vendosim ta plotësojmë këtë nesër. Tani, zhvillimi ynë është ndalur.
- Dhe, sigurisht, aty punojnë shumë kolegë, shumë ekipe. Dhe duhet të pajtohemi manualisht. Kjo nuk është e përshtatshme.
Dhe duhet thënë se kemi vetëm një përpjekje, një goditje, nëse duam të bëjmë ndonjë ndryshim në bazën e të dhënave, të prekë të dhënat, të ndryshojmë strukturën. Dhe nëse diçka shkon keq, nëse kishte një gabim në migrimin, nuk do të kthehemi shpejt.
Kjo është më mirë se qasja e mëparshme, por prapë ka një probabilitet të madh që ndonjë gabim të shkojë në prodhim.
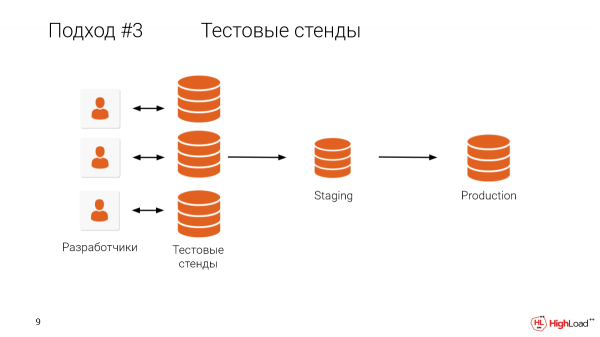
Çfarë na pengon të japim çdo zhvilluesi një test stand, një kopje me përmasa të plota? Mendoj se është e qartë se çfarë na pengon.
Kush ka bazën e të dhënave më të madhe se një terabajt? Më shumë se gjysma e sallës.
Dhe është e qartë se mbajtja e makinave për çdo zhvillues, kur ka një prodhim kaq të madh, është shumë e shtrenjtë, dhe gjithashtu shumë e gjatë.
Kemi klientë që kanë kuptuar se është shumë e rëndësishme të testojnë të gjitha ndryshimet në kopje me përmasa të plota, por ata kanë bazën më të vogël se një terabajt, dhe nuk kanë burime për të mbajtur një test stand për çdo zhvillues. Prandaj, ata janë të detyruar të shkarkojnë dumpet lokal në makinat e tyre dhe të testojnë në këtë mënyrë. Kjo merr shumë kohë.
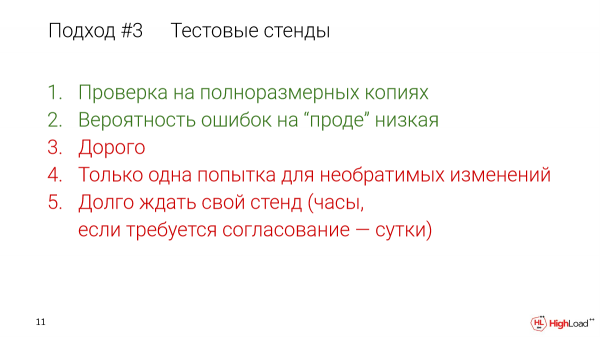
Edhe nëse e bëni brenda infrastrukturës, shkarkimi i një terabajti të dhënash në orë – kjo është shumë mirë. Por ata përdorin dumpet logjike, ata shkarkojnë lokal nga cloud. Për ta, shpejtësia është rreth 200 gigabajt në orë. Dhe duhet gjithashtu kohë për t'u zhvilluar nga dumpi logjik, për të vendosur indekset etj.
Por ata e përdorin këtë qasje, sepse kjo lejon të mbajë prodhimin të besueshëm.
Çfarë mund të bëjmë këtu? Le të bëjmë që testet standet të jenë të lira dhe t'i japim çdo zhvilluesi test standin e tij të vet.
Dhe kjo është e mundur.
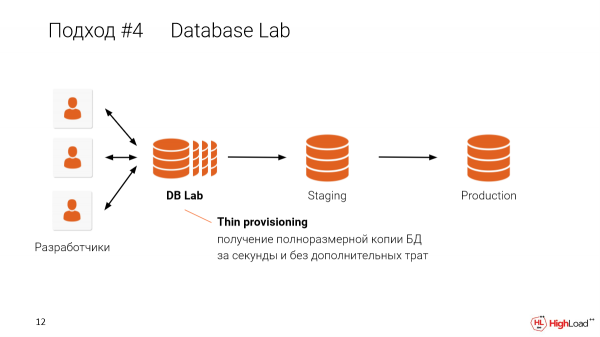
Në këtë qasje, kur krijojmë klone të hollë për secilin zhvillues, mund ta ndajmë këtë në një makinë. Për shembull, nëse keni një bazë prej katër terabajtësh dhe dëshironi t'ua jepni 10 zhvilluesve, nuk keni nevojë për 10 herë katër terabajtë bazash. Mjafton një makinë për të krijuar kopje të izoluara të hollë për secilin zhvillues, duke përdorur një makinë. Si funksionon do ta tregoj pak më vonë.
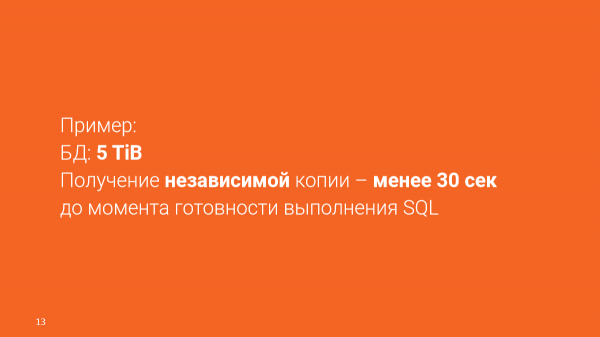
Një shembull real:
Baza e të dhënave – 4.5 terabajt.
Mund të marrë kopje të pavarura për 30 sekonda.
Nuk keni nevojë të prisni për një qëndër testuese dhe të vareni nga madhësia e saj. Mund ta merrni atë për disa sekonda. Kjo do të jetë ambient i plotëisht i izoluar, por që ndajnë të dhënat midis tyre.
Kjo është fantastike. Këtu po flasim për magjinë dhe universin paralel.
Në rastin tonë, ky funksionon me sistemin OpenZFS.
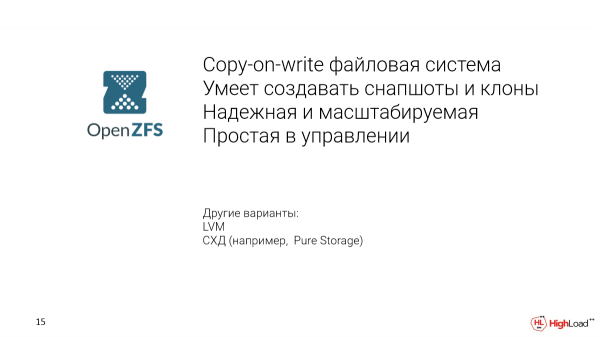
OpenZFS është një sistem skedarësh copy-on-write, që nga norme mbështet snapshotet dhe klonët. Është i besueshëm dhe i shkallëzueshëm. Është shumë e lehtë për ta menaxhuar. Mund ta instaloni me dy komanda.
Ka edhe opsione të tjera:
LVM,
Sistemet e ruajtjes (p.sh., Pure Storage).
Database Lab, për të cilin po flas, është modular. Mund të implementohet duke përdorur këto variante. Por për momentin kemi përqendruar vëmendjen në OpenZFS, sepse konkretisht me LVM kishte probleme.
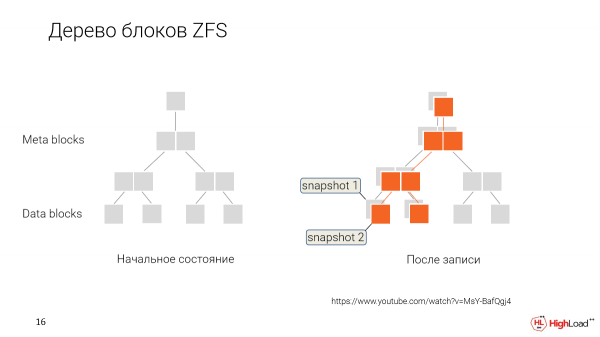
Si funksionon? Në vend që të riparojmë të dhënat çdo herë kur i ndryshojmë, ne i ruajmë duke shënuar se këto të dhëna të reja i përkasin një momenti të ri në kohë, një snapshot të ri.
Dhe më pas, kur duam të rikthehemi ose të bëjmë një klon të ri me një version më të vjetër, thjesht themi: "Ok, na jepni këto blloqe të dhënash që janë të markuara kështu."
Dhe ky përdorues do të punojë me këtë grup të dhënash. Ai do t’i ndryshojë gradualisht, duke bërë snapshotet e tij.
Dhe ne do të kemi një degëzim. Çdo zhvillues në rastin tonë do të ketë mundësinë të ketë klonin e tij, të cilin e redakton, ndërsa të dhënat që janë të përbashkëta do të ndahen mes të gjithëve.
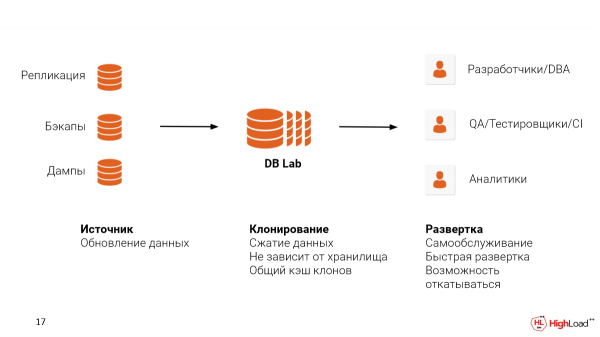
Për të implementuar një sistem të tillë, duhet të zgjidhni dy probleme:
E para, kjo është burimi i të dhënave nga i cili do t’i merrni ato. Mund të vendosni replikimin me prodhimin. Mund të përdorni kopje rezervë që keni të konfigurura, shpresoj. WAL-E, WAL-G ose Barman. Dhe madje, nëse përdorni ndonjë zgjidhje Cloud, si RDS ose Cloud SQL, mund të përdorni dump-a logjike. Por prapë, ne ju rekomandojmë të përdorni kopje rezervë, sepse me këtë qasje do të ruani gjithashtu strukturën fizike të skedarëve, që do të lejojë të jeni më afër atyre metrikeve që do të shihnit në prodhim, për të kapur problemet që ekzistojnë.
E dyta – është vendi ku dëshironi të hostoni Database Lab. Mund të jetë Cloud, mund të jetë On-premise. Këtu është e rëndësishme të themi se ZFS mbështet kompresimin e të dhënave. Dhe e bën këtë mjaft mirë.
Imagjinoni që çdo klon i tillë, në varësi të operacioneve që bëjmë me bazën, do të ketë një dev në rritje. Për këtë dev gjithashtu do të nevojitet hapësirë. Por për shkak se morëm një bazë prej 4.5 terabajtësh, ZFS do ta comprimojë atë në 3.5 terabajtë. Në varësi të cilësimeve, kjo mund të variojë. Dhe ne gjithashtu do të kemi hapësirë të mbetur për dev.
Një sistem të tillë mund ta përdorni për raste të ndryshme.
Këta janë zhvilluesit, DBA për kontrollimin e pyetjeve, për optimizimin.
Kjo mund të përdoret në testimin QA për të kontrolluar një migrim të veçantë para se ta ndajmë atë në prodhim. Gjithashtu mund të krijojmë ambiente të veçanta për QA me të dhëna reale, ku ata mund të testojnë funksionalitetin e ri. Dhe do të marrë disa sekonda në vend të orëve, madje ndoshta edhe ditëve në disa raste ku kopjet e holla nuk përdoren.
Dhe një rast i veçantë. Nëse kompania nuk ka vendosur një sistem analitik, atëherë mund të ndajmë një klon të hollë të bazës së produktit dhe ta japim për kërkesa të gjata ose për indekse të veçanta që mund të përdoren në analizë.
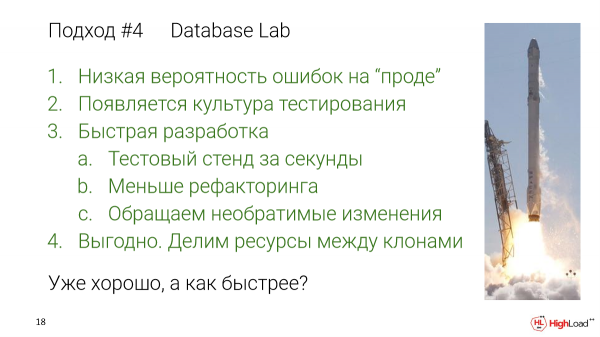
Me këtë qasje:
Probabilitet i ulët për gabime në “prodhim”, sepse të gjitha ndryshimet i kemi testuar mbi të dhëna me përmasat e plota.
Na krijohet një kulturë e testimit, pasi tani nuk është e nevojshme të presim me orë për ambientin tonë.
Dhe nuk ka pengesa, nuk ka pritje midis testeve. Ju vërtet mund të shkoni dhe të kontrolloni. Dhe kështu do të jetë më mirë, pasi do të përshpejtojmë zhvillimin.
Do t’i kemi më pak refaktoring. Më pak defekte do të shkojnë në prodhim. Ne do t’i refaktojmë më pak më vonë.
Ne mund të bëjmë ndryshime të pakthyeshme. Kjo nuk është e zakonshme në qasjet standarde.
- Kjo është e favorshme, sepse ndajmë burimet e testeve.
Ka shumë mirë, çfarë tjetër mund të përshpejtohet?
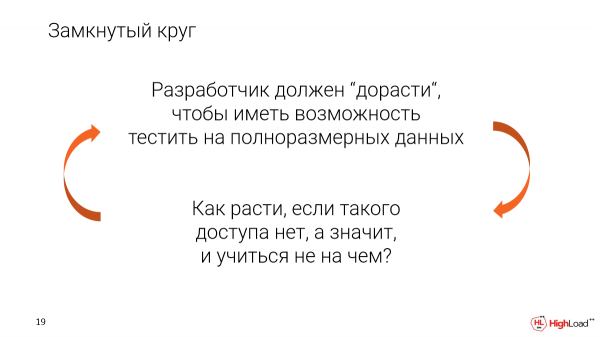
Falë kësaj sisteme, mund të zvogëlojmë ndjeshëm pragun e hyrjes në këtë lloj testimi.
Aktualisht ekziston një qark i mbyllur, kur zhvilluesi, për të pasur qasje në të dhënat reale dhe të plota, duhet të bëhet një ekspert. Ata duhet të besojnë një akses të tillë.
Por si mund të rritemi, nëse nuk ka një të tillë. Çfarë nëse të dhënat testuese që keni janë shumë të pakta? Atëherë nuk do të arrini një eksperiencë reale.
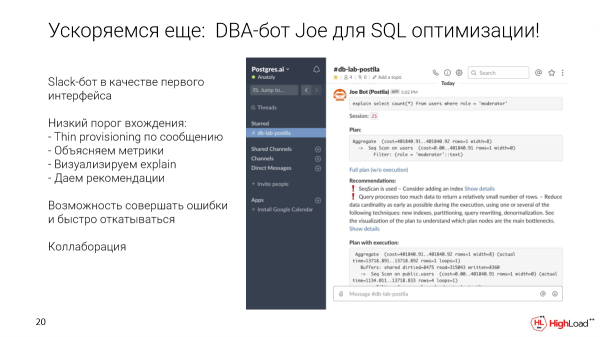
Si të dalim nga ky qark? Si një ndërfaqe e parë, e lehtë për zhvilluesit nga çdo nivel, kemi zgjedhur një bot Slack. Por mund të jetë çdo ndërfaqe tjetër.
Çfarë lejon të bëjmë? Mund të marrim një kërkesë specifike dhe ta dërgojmë atë në një kanal të veçantë për bazën e të dhënave. Ne automatikisht do ta nxjerrim një klon të hollë në sekonda. Do ta ekzekutojmë atë kërkesë. Do të grumbullojmë metrikat dhe rekomandimet. Do ta tregojmë vizualizimin. Dhe më pas, ky klon do të mbetet për optimizimin e kërkesës, për të shtuar indekse, etj.
Dhe gjithashtu Slack na ofron mundësi për bashkëpunim nga kutia. Pasi që është thjesht një kanal, atje mund të nisni diskutimin për një kërkesë të tillë direkt në thread, të kontaktoni kolegët tuaj, DBA të cilët janë brenda kompanisë.
Por, natyrisht, ka edhe probleme. Pasi që kjo është bota reale, dhe ne po përdorim një server që po pret shumë klone, na duhet të kufizojmë sasinë e MEMORIE dhe fuqinë procesorike që klonët kanë akses.
Por për të bërë që këto teste të jenë të besueshme, duhet ta zgjidhim këtë problem në një farë mënyre.
E qartë është se një pikë e rëndësishme janë të dhënat e njëjta. Por ne tashmë i kemi ato. Dhe na pëlqen të arrijmë një konfigurim të njëjtë. Dhe ne mund të ofrojmë një konfigurim praktikisht të njëjtë.
Do të ishte fantastike të kishim harduerin e njëjtë si në prodhim, por ai mund të ndryshojë.
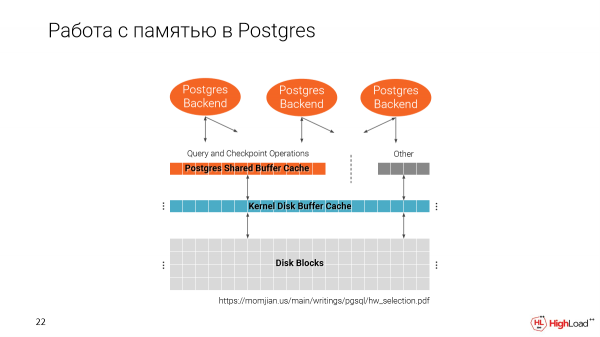
Le të kujtojmë se si funksionon Postgres me memorien. Ne kemi dy cache. Një nga sistemi i skedarëve dhe një nga Postgres vetë, dmth. Shared Buffer Cache.
Është e rëndësishme të theksohet se Shared Buffer Cache aloklohet gjatë fillimit të Postgres në varësi të madhësisë që do të caktosh në konfigurim.
Dhe caches e dyta përdor gjith hapësirën e disponueshme.
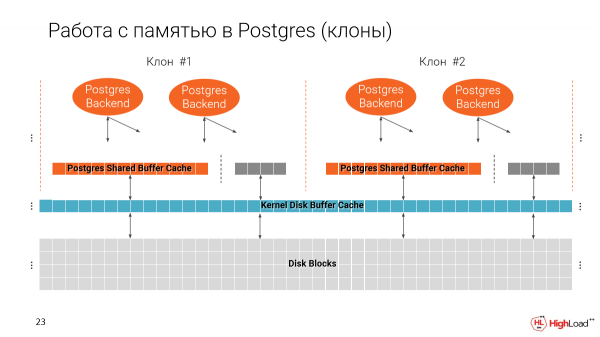
Dhe kur bëjmë disa klone në një makinë, rezulton se ngadalë e mbushim memorien. Në fakt, Shared Buffer Cache është 25% e gjithë memorjes që është e disponueshme në makinën tonë.
Dhe rezulton se nëse nuk e ndryshojmë këtë parametrin, do të mund të nisim vetëm 4 instance në një makinë, pra 4 klone të tilla të holla. Dhe kjo, sigurisht, është e keqe, sepse duam të kemi shumë më tepër.
Por, nga ana tjetër, Buffer Cache përdoret për ekzekutimin e kërkesave, për indeksat, pra plani varet nga madhësia e caches tona. Dhe nëse thjesht e marrim këtë parametrin dhe e paksojmë, atëherë planet tona mund të ndryshojnë ndjeshëm.
Për shembull, nëse në prodhim kemi një cache të madhe, atëherë Postgres do të preferonte të përdorë indeksin. E nëse jo, atëherë do të jetë SeqScan. Dhe çfarë do kishte kuptim, nëse planet tona nuk do të përputheshin?
Por këtu arrijmë në zgjidhjen se në të vërtetë plani në Postgres nuk varet nga madhësia konkretisht e caktuar në Shared Buffer, por varet nga effective_cache_size.
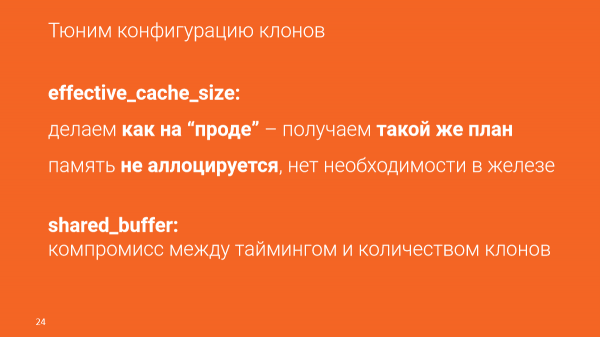
Effective_cache_size është vëllimi i supozuar i caches që kemi në dispozicion, pra në përmbledhje Buffer Cache dhe cache e sistemit të skedarëve. Kjo caktohet me konfigurimin. Dhe kjo memorie nuk alokohet.
Dhe përmes këtij parametri, mund ta mashtrojmë Postgres, duke i thënë se në të vërtetë kemi shumë të dhëna në dispozicion, edhe nëse ato të dhëna nuk i kemi. Dhe kështu, planet do të përputhen plotësisht me prodhimin.
Por kjo mund të ndikojë në kohën përfundimtare. Dhe ne optimizojmë kërkesat sipas kohës, por është e rëndësishme që koha varet nga shumë faktorë:
Varet nga ngarkesa që momentalisht ka në prodhim.
Varet nga karakteristikat e vetë makinës.
Dhe ky është një parametr i tërthor, por në të vërtetë mund të optimizojmë saktësisht sipas sasisë së të dhënave që kjo kërkesë do të lexojë për të marrë rezultatin.
Dhe nëse dëshirojmë që koha e ekzekutimit të jetë e ngjashme me atë që do të shohim në prodhim, ne duhet të marrim pajisje sa më të ngjashme dhe, ndoshta, madje edhe më shumë, që të gjithë klonët të vendosen. Por kjo është një kompromis, domethënë, do të merrni të njëjtat plane, do të shihni sa të dhëna lexon një kërkesë e caktuar dhe do të jeni në gjendje të bëni një përfundim – a është kjo kërkesë e mirë (ose migrimi) apo e keqe, duhet të optimizohet më tej.
Le të shohim se si proçesohet optimizimi konkret me Joe.
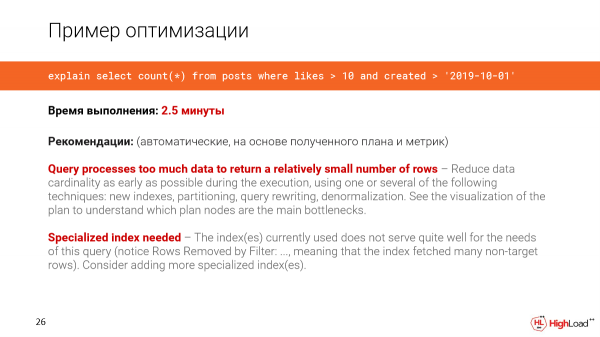
Të marrim një kërkesë nga një sistem real. Në këtë rast, baza e të dhënave ka një terabajt. Dhe ne duam të llogarisim numrin e postimeve të reja, të cilat kishin më shumë se 10 pëlqime.
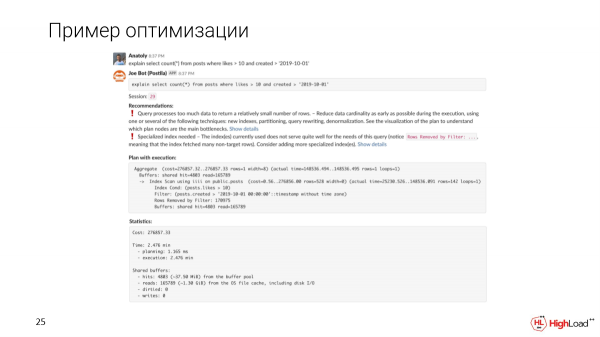
Ne shkruajmë një mesazh në kanal, u krijua për ne një klon. Dhe do të shohim se kjo kërkesë do të ekzekutohet brenda 2.5 minutash. Kjo është e para që do të vëmë re.
Joe do të tregojë rekomandime automatike, të bazuara në planin dhe metrikat.
Ne do të shohim se kërkesa përpunon shumë të dhëna, për të marrë një numër përqindshëm të vogël të rreshtave. Dhe na nevojitet ndonjë indeks i specializuar, për shkak se kemi kuptuar se kërkesa ka shumë rreshta të filtruar.
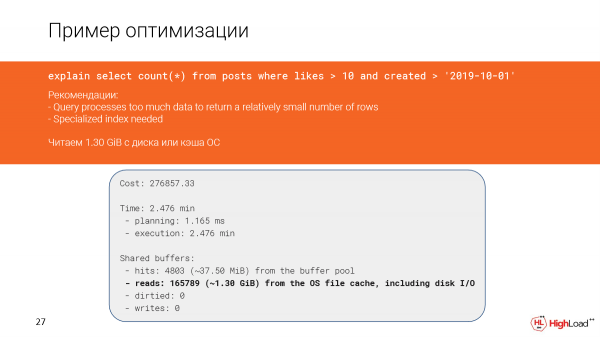
Le të shohim më nga afër se çfarë ndodhi. Vërtet, ne shohim se lexohet pothuajse një e gjysmë gigabajt të dhënash nga cache e skedarëve ose madje edhe nga disku. Dhe kjo nuk është e mirë, pasi kemi marrë vetëm 142 rreshta.
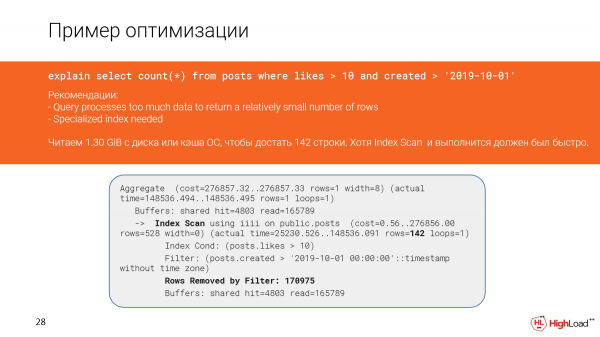
Dhe, siç duket, ne kemi skanim të indeksit dhe duhej të kishte punuar shpejt, por, pasi ne filtruam shumë rreshta (na duhej t'i numëronim), kërkesa punoi ngadalë.
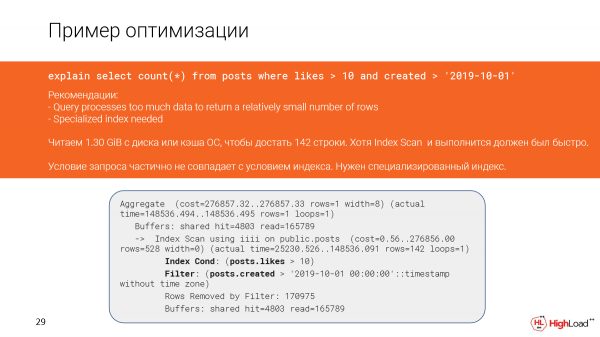
Dhe kjo ndodhi në plan për shkak se kushtet në kërkesë dhe kushtet në indeks nuk përputhen plotësisht.
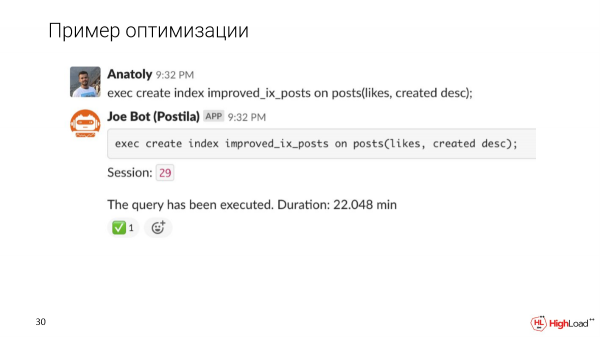
Le të përpiqemi të bëjmë indeksin më të saktë dhe të shohim se si do të ndryshojë ekzekutimi i kërkesës pas kësaj.
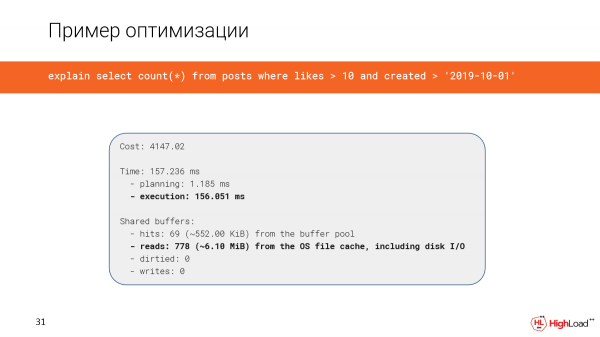
Krijimi i indeksit mori mjaft kohë, por tani ne kontrollojmë kërkesën dhe shohim se koha në vend të 2.5 minutave u reduktua në vetëm 156 milisekonda, që është shumë mirë. Dhe ne lexojmë vetëm 6 megabajt të dhënash.
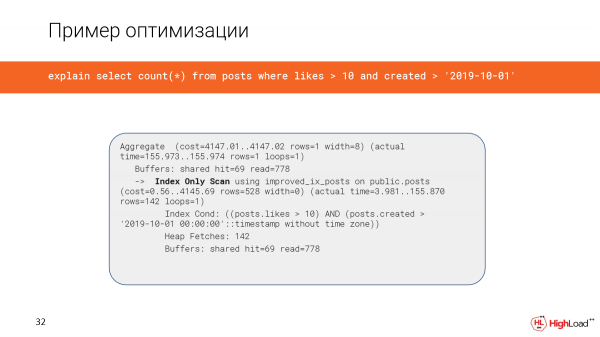
Dhe tani kemi përdorur skanimin e vetëm të indeksit.
Një histori tjetër e rëndësishme është që ne dëshirojmë të paraqesim planin në një mënyrë më të kuptueshme. Ne kemi implementuar vizualizimin me ndihmën e Flame Graphs.
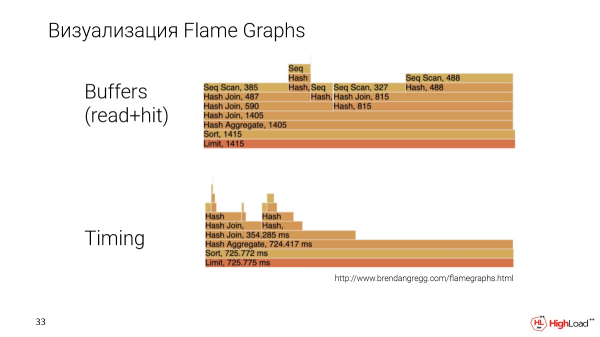
Ky është një kërkesë tjetër, më e ndërlikuar. Dhe ne ndërtojmë Flame Graphs sipas dy parametrave: është sasia e të dhënave që një node specifike në plan e ka lexuar dhe koha e ekzekutimit të nodës.
Këtu mund të krahasojmë konkretisht nodet me njëri-tjetrin. Dhe do të jetë e qartë se cili prej tyre merr më shumë ose më pak, gjë që zakonisht është e vështirë të bëhet me metoda të tjera vizualizimi.
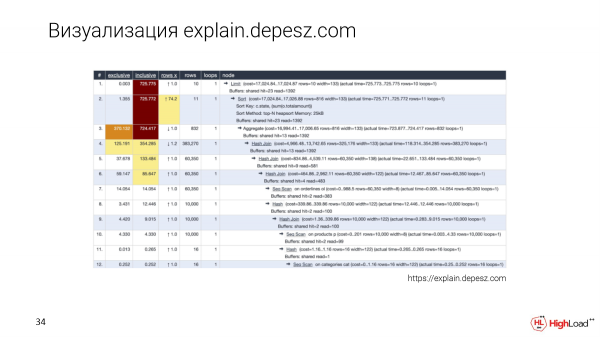
Sigurisht, të gjithë e njohin explain.depesz.com. Një tipar i mirë i kësaj vizualizimi është se ne ruajmë planin tekstual dhe gjithashtu nxjerrim disa parametra kryesorë në tabelë, në mënyrë që të mund të renditim.
Dhe zhvilluesit, të cilët nuk janë thelluar ende në këtë temë, gjithashtu e përdorin explain.depesz.com, sepse për ta është më e lehtë të kuptojnë cilat metrika janë të rëndësishme dhe cilat jo.
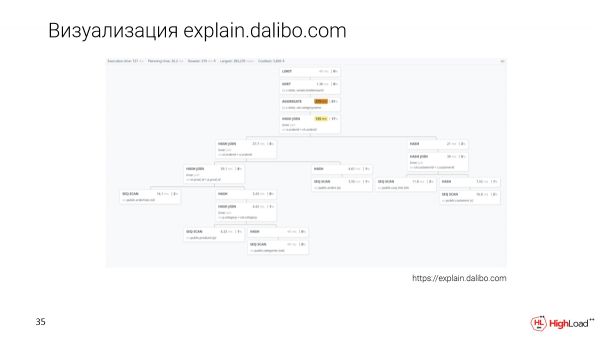
Ka një qasje të re për vizualizimin – kjo është explain.dalibo.com. Ata bëjnë një vizualizim në formë të pemës, por këtu është shumë e vështirë të krahasosh nodet me njëri-tjetrin. Këtu mund të kuptoni mirë strukturën, por nëse ka një pyetje të madhe, do të duhet të skrolloni andej-këndej, por gjithsesi është një variant.
Kolaborimi
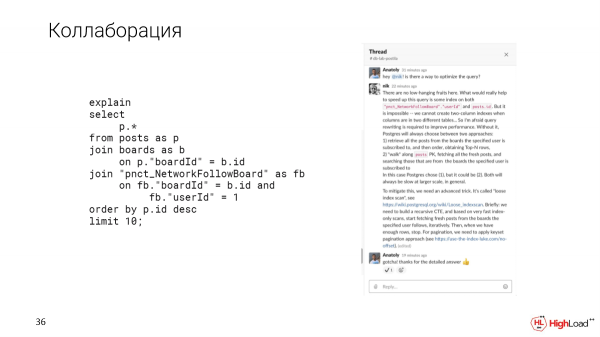
Dhe, siç e përmenda, Slack na ofron mundësinë e kolaborimit. Për shembull, nëse hasim një kërkesë të komplikuar, të cilën nuk e dimë si ta optimizojmë, mund ta sqarojmë këtë pyetje në thread në Slack me kolegët tanë.
Na duket e rëndësishme të testojmë me të dhëna në masë të plotë. Për këtë kemi krijuar mjetin Update Database Lab, i cili është i disponueshëm në open source. Ju gjithashtu mund të përdorni botin Joe. Mund ta merrni atë pikërisht tani dhe ta integrojeni te ju. Të gjitha udhëzimet janë në dispozicion atje.
Është gjithashtu e rëndësishme të theksohet se vetë zgjidhja nuk është ndonjë revolucionare, sepse ekziston Delphix, por kjo është një zgjidhje enterprise. Ajo është plotësisht e mbyllur, kushton shumë shtrenjtë. Ne specializohemi pikërisht në Postgres. Të gjitha këto janë produkte open source. Bashkohuni me ne!
Këtu e përfundoj. Faleminderit!
Pyetje
Përshëndetje! Faleminderit për raportin! Shumë interesante, sidomos për mua, sepse kam zgjidhur një detyrë të ngjashme disa kohë më parë. Prandaj kam një seri pyetjesh. Shpresoj të paktën të bëj disa prej tyre.
Është interesante, si e llogaritni hapësirën për këtë mjedis? Teknologjia nënkupton se, nën rrethana të caktuara, klonët tuaj mund të rriten në madhësinë maksimale. Në thelb, nëse keni një bazë dhjetë tera dhe 10 klonë, është e lehtë të simuloni një situatë në të cilën çdo klon do të peshojë me 10 të dhëna unike. Si e llogaritni këtë hapësirë, pra atë diferencë, për të cilën flisnit, në të cilën do të jetojnë këta klonë?
Një pyetje e mirë. Këtu është e rëndësishme të monitorosh klonat specifike. Dhe nëse ndonjë ndryshim i madh ndodh te një klon, ai fillon të rritet, atëherë mund të japim fillimisht një paralajmërim për përdoruesin rreth kësaj, ose menjëherë të ndalojmë atë klon, për të shmangur një situatë që dështojnë.
Po, kam një pyetje të nënshtrohet. Pra, si siguroheni për ciklin e jetës së këtyre moduleve? Kjo është një problem dhe një histori e tërë për ne. Si ndodh kjo?
Ka një ttl për secilin klon. Në parim, ne kemi një ttl të caktuar.
Cili është, nëse nuk është sekret?
1 orë, pra idle - 1 orë. Nëse nuk përdoret, atëherë ne e shkatërrojmë atë. Por këtu nuk ka asnjë surprizë, për shkak se mund ta ngrisim klonin për sekonda. Dhe nëse na nevojitet përsëri, atëherë - s'ka problem.
Më intereson përzgjedhja e teknologjive gjithashtu, sepse ne, për shembull, përdorim disa mënyra paralelisht për arsye të ndryshme. Pse ZFS saktësisht? Pse nuk keni përdorur LVM? Keni përmendur se patët probleme me LVM. Çfarë probleme ishin? Në mendimin tim, opsioni më optimal është ai me SAN, nga pikëpamja e performancës.
Cila është problemi kryesor me ZFS? Ajo është se duhet ta drejtojnë në një host, pra të gjitha instancat do të jetojnë brenda një operacioni. Ndërsa me SAN, mund të lidhni pajisje të ndryshme. Dhe ngushtica janë vetëm ato blloqe që janë në SAN. Dhe pyetja e zgjedhjes së teknologjive është interesante. Pse jo LVM?
Në lidhje me LVM mund të diskutojmë në takimin. Për SAN - është thjesht e shtrenjtë. Ne mund ta implementojmë sistemin ZFS kudo. Mund ta shtroni atë në makinën tuaj. Thjesht mund ta shkarkoni depozitën dhe ta shtroni atë. ZFS mund të instalohet praktikisht kudo, nëse po flasim për Linux. Pra, ne marrim një zgjidhje shumë fleksibël. Dhe ZFS vetë nga kutia ofron shumë. Mund të ngarkoni aq shumë të dhëna sa dëshironi, të lidhni një numër të madh diskesh, ka snapshot-e. Dhe, siç e thashë, është fare e lehtë për t'u administruar. Pra, ai duket shumë i këndshëm për përdorim. Ai është provuar, ka shumë vjet. Ka një komunitet shumë të madh, që po rritet. ZFS është një zgjidhje shumë e besueshme.
Nikola Samokhvalov: Mund të komentoj edhe unë? Më quajnë Nikola, punoj së bashku me Anatolijn. Jam dakord që SAN është e shkëlqyer. Disa nga klientët tanë kanë Pure Storage e kështu me radhë.
Anatoly aptly noted that we are focused on modularity. In the future, it will be possible to implement a single interface – take a snapshot, make a clone, destroy a clone. It's all easy. And the SCD is great if it exists.
But ZFS is available to everyone. Enough with Delphix, they have 300 clients. Of those, 50 are in the fortune 100, meaning they are targeting NASA, etc. It’s time for everyone to access this technology. That’s why we have the open source Core. We do have part of the interface that isn't open source. This is a platform we will showcase. But we want it to be available to everyone. We aim to make a revolution so that all testers stop guessing on laptops. We must write SELECT and immediately see if it's slow. No more waiting for the DBA to tell us. That is the main goal. And I believe we will all get there. This thing we're creating is meant to be available to all. Hence ZFS, as it will be accessible everywhere. Thank you to the community for solving problems and for having an open source license, etc.
Greetings! Thank you for the presentation! My name is Maxim. We faced similar problems. We solved them on our end. How do you allocate resources between these clones? Each clone can be engaged in its own task at any moment: one is testing one thing, another is testing something else, someone is building an index, and someone has a heavy job running. While CPU can still be divided, how do you divide it in terms of IO? That’s my first question.
My second question is about the dissimilarity of environments. Suppose I have ZFS here and everything is great, but the client's prod environment is using ext4, for example. How do you handle that?
These are very good questions. I briefly mentioned the issue with resource allocation. The solution comes down to this. Imagine you are testing in staging. You might have a situation where one person creates one load while someone else creates another. As a result, you're seeing unclear metrics. The same issue could occur in prod too. When you want to check a query and see that there’s some issue with it – it’s running slowly – in reality, the problem isn’t with the query but rather with some parallel load.
Prandaj, këtu është e rëndësishme të përqendrohemi në atë që do të jetë plani, cilat hapa do të ndjekim dhe sa të dhëna do të ngremë për këtë. Ajo që diskët tanë, për shembull, do të ngarkohen me diçka, do të ndikojë konkretisht në kohën. Por ne mund të vlerësojmë sa i ngarkuar është ky kërkesë në bazë të sasisë së të dhënave. Nuk është aq e rëndësishme që në të njëjtën kohë do të ketë ndonjë ekzekutimin tjetër.
Kam dy pyetje. Kjo është gjëja shumë e bukur. A ka pasur raste kur të dhënat në prodhim janë kritikisht të rëndësishme, për shembull, numra të kartave të kreditit? A ka ndonjë gjë të gatshme tashmë apo është një detyrë e veçantë? Dhe pyetja e dytë - a ka ndonjë gjë të tillë për MySQL?
Për sa i përket të dhënave. Ne do të kryejmë obfuskimin, derisa ne ta bëjmë këtë. Por nëse ju e zhvilloni pikërisht Joe, nëse nuk jepni qasje zhvilluesve, atëherë nuk ka qasje në të dhëna. Pse? Sepse Joe nuk tregon të dhëna. Ai tregon vetëm matjet, planet dhe gjithçka tjetër. Kjo është bërë qëllimisht, pasi është një nga kërkesat e klientit tonë. Ata donin të kishin mundësinë të optimizonin, por pa i dhënë qasje të gjithëve.
Për sa i përket MySQL. Ky sistem mund të përdoret për çdo gjë që ruan gjendjen në disk. Dhe pasiqë ne merremi me Postgres, aktualisht jemi fokusuar kryesisht në automatizimin e plotë për Postgres. Ne dëshirojmë të automatizojmë marrjen e të dhënave nga backup-i. Ne e konfigurimin si duhet Postgres-in. Ne dimë si ta bëjmë që planet të përputhen, etj.
Por pasiqë sistemi është i zgjerueshëm, gjithashtu mund të përdoret për MySQL. Dhe ka shembuj të tillë. Një gjë e ngjashme ka Yandex-i, por ata nuk e publikojnë askund. Ata e përdorin atë brenda Yandex.Metrica. Dhe aty është historia për MySQL. Por teknologjitë janë të njëjta, ZFS.
Faleminderit për prezantimin! Kam edhe disa pyetje. Ju përmendët se klonimi mund të përdoret për analitikë, për shembull, për të ndërtuar indekse shtesë. Mund të na thoni pak më shumë si funksionon kjo?
Dhe pyetja e dytë do ta bëj menjëherë për barazimin e standeve, barazimin e planeve. Plani varet edhe nga statistikat e grumbulluara nga Postgres. Si e zgjidhni këtë problem?
Nuk ka analiza specifike për rastet konkrete, sepse ne nuk e kemi përdorur ende kështu, por ka mundësi të tillë. Nëse flasim për indekset, imagjinoni se po ekzekutohet një kërkesë në një tabelë me qindra miliona regjistrime dhe në një kolonë që zakonisht nuk është e indeksuar në prodhim. Dhe ne duam të llogarisim disa të dhëna. Nëse kjo kërkesë ekzekutohet në prodhim, ka mundësi që në prodhim të ketë ndalesa, sepse kërkesa do të punojë për një minutë.
Ok, le të krijojmë një klon të hollë, i cili nuk është e frikshme ta ndalim për disa minuta. Dhe në mënyrë që të ishte më komfort për të llogaritur analizat, do të shtojmë indekse në ato kolona, në të cilat na interesojnë të dhënat.
A do të krijohet indeksi çdo herë?
Mund të bëhet kështu që ne t'i prekim të dhënat, të bëjmë snapshote, dhe pastaj nga kjo snaphot do të rikuperohemi dhe do të ekzekutojmë kërkesa të reja. Domethënë, mund të bëhet që të mund të ngremë klone të reja me indekse të vendosura tashmë.
Sa i përket pyetjes për statistika, nëse rikuperohemi nga një kopje rezervë, nëse bëjmë replikim, atëherë statistika do të jetë për aq sa është. Sepse ne do të kemi strukturën fizike të të dhënave, domethënë, të dhënat ashtu siç janë me të gjitha metrikat e statistikave që do t'i sjellim gjithashtu.
Këtu ka një tjetër problem. Nëse përdoret një zgjidhje cloud, atëherë janë të disponueshme vetëm dumps logjik, sepse Google, Amazon nuk lejojnë që të merret një kopje fizike. Pra, do të ketë një problem të tillë.
Faleminderit për raportin. Këtu u shfaqën dy pyetje të mira rreth MySQL dhe ndarjes së burimeve. Por, në thelb, gjithçka reduktohet në faktin se kjo temë nuk përkon me DBMS të veçanta, por në përgjithësi me sistemin e skedarëve. Dhe, për pasojë, pyetjet e ndarjes së burimeve gjithashtu duhet të zgjidhen nga aty, jo në fund, se çfarë është Postgres, por në sistemin e skedarëve. server, në instancë.
Pyetja ime është pak tjetër. Ajo është më shumë e afërt me shumë-shtresimin e bazës së të dhënave, ku ka disa shtresa. Ne, për shembull, kemi konfiguruar përditësimin e një imazhi dhjetë terabajtësh, kemi replikim në vijim. Dhe ne konkretisht po e përdorim këtë zgjidhje për bazat e të dhënave. Po zhvillohet replikimi, po ndodh përditësimi i të dhënave. Këtu punojnë paralelisht 100 punonjës që vazhdimisht ekzekutojnë këto pamje të ndryshme. Çfarë duhet bërë? Si të bëjmë që të mos ketë konflikte, që ata të nisin një gjë dhe pastaj sistemi i skedarëve të ndryshojë, dhe këto pamje të dështojnë?
Ata nuk do të shkojnë, sepse kështu funksionon ZFS. Ne mund të mbajmë ndarë në një proces ndryshimet e sistemit të skedarëve, të cilat vijnë falë replikimit. Dhe të mbajmë klonët e të dhënave të vjetra, që zhvilluesit i përdorin. Dhe kjo funksionon për ne, me këtë gjithçka është në rregull.
Pra, ndodhi që përditësimi do të ndodhë si një shtesë, dhe të gjitha pamjet e reja do të shkojnë duke u bazuar në këtë shtesë, apo jo?
Nga shtresat e mëparshme, që ishin nga replikimet e mëparshme.
Shtresat e mëparshme do të zhduken, por ato do të referohen në shtresën e vjetër, dhe imazhet e reja do t'i marrin nga shtresa e fundit, e cila u mor në përditësim?
Në përgjithësi, po.
Atëherë si pasojë do të kemi shumë shtresa. Dhe me kalimin e kohës, do të duhet t'i kompresojmë ato?
Po, gjithçka është e saktë. Ekziston një dritare e caktuar. Ne ruajmë snapshote javorë. Kjo varet nga sa burime keni. Nëse keni mundësi të ruani shumë të dhëna, mund të ruani snapshote për një kohë të gjatë. Ato vetë nuk do të fshihen. Nuk do të ketë ndonjë korrupsion të të dhënave. Nëse snapshotet janë të vjetra, siç mendojmë, pra varet nga politika brenda kompanisë, atëherë ne mund t'i fshijmë ato dhe të lirojmë hapësirë.
Përshëndetje, faleminderit për raportin! Në lidhje me pyetjen e Joe. Ju thatë se klienti nuk donte të jepte qasje gjithkujt në të dhënat. Rigorozisht duke folur, nëse dikush ka rezultatet e Explain Analyze, ai mund të shikojë të dhënat.
Kjo është e vërtetë. Për shembull, ne mund të shkruajmë: «SELECT FROM WHERE email = dikush». Pra, ne nuk do të shohim vetë të dhënat, por disa shenja të tërthorta mund të shohim. Kjo duhet të kuptohet. Por nga ana tjetër, gjithçka është e dukshme. Ne kemi auditen e logëve, ne kemi kontrollin e kolegëve të tjerë, të cilët gjithashtu shohin se çfarë po bëjnë zhvilluesit. Dhe nëse dikush përpiqet të bëjë kështu, atëherë shërbimi i sigurisë do të vijë dhe do të punojë mbi këtë çështje.
Mirëmëngjes! Faleminderit për raportin! Kam një pyetje të shkurtër. Nëse në kompani nuk përdoret Slack, a ka ndonjë lidhje me të tani, apo mund të vendosim instance për zhvilluesit, për të lidhur një aplikacion testues me bazat?
Aktualisht ka lidhje me Slack, domethënë nuk ka asnjë mesazher tjetër, por dëshirojmë shumë të ofrojmë mbështetje për mesazhere të tjera gjithashtu. Çfarë mund të bëni? Mund të zbatoni DB Lab tuaj pa Joe, të përdorni REST API ose platformën tonë për të krijuar klonë dhe të lidhni me PSQL. Por kjo është e mundur vetëm nëse jeni të gatshëm t'u jepni zhvilluesve tuaj qasje në të dhënat, pasi këtu nuk do të ketë më ndonjë ekran.
Nuk më nevojitet kjo ndërfaqe, por një mundësi e tillë më nevojitet.
Atëherë – po, kjo është e mundur.
Burimi: habr.com
