

Më ka interesuar gjithmonë si të organizoj librat e mi në bibliotekën time elektronike. Në fund arrita në një variant që numëron automatikisht faqet dhe ka disa funksione të tjera. Të gjithë të interesuarit mund të shikojnë nën këtë link.
Pjesa 1. Dropbox
Të gjithë librat e mi janë në Dropbox. Unë i kam ndarë në 4 kategori: Libër Shkollor, Referencë, Letërsia, Jo Letërsia. Por nuk i shtoj referencat në tabelë.
Shumica e librave janë .epub, ndërsa të tjerët janë .pdf. Pra, zgjidhja përfundimtare duhet të mbulojë të dyja opsionet.
Rrugët për tek librat janë afërsisht këto:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Nëse libri është letërsi, atëherë kategoria (do të thotë "Dizajn" në rastin e mësipërm) hiqet.
Kam vendosur të mos merrem me API-në e Dropbox-it, falë aplikacionit të tyre që sinkronizon dosjen. Pra, plani është kështu: marrim libra nga dosja, çdo libër e kalojmë nëpër një numërues fjalësh dhe e shtojmë në Notion.
Pjesa 2. Shtimi i një rreshti
Tabela vetë duhet të duket afërsisht kështu. KËSHILLË: emrat e kolonave është më mirë t’i bëni me shkronja latine.
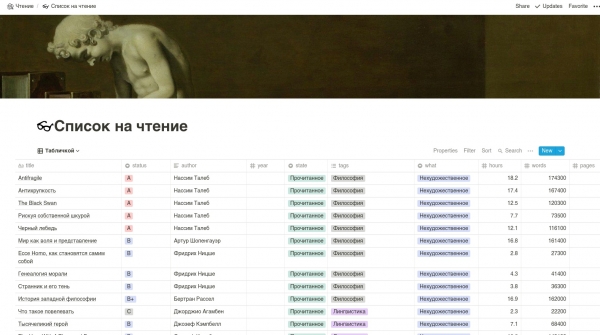
Do të përdorim API-në jozyrtare të Notion, sepse ajo zyrtare ende nuk është sjellë.

Shkoni në Notion, shtypni Ctrl + Shift + J, shkoni në Application -> Cookies, kopjoni token_v2 dhe quajeni TOKEN. Pastaj shkoni në faqen që na nevojitet me tabelën e bibliotekës dhe kopjoni lidhjen. Quajeni NOTION.
Më pas shkruajmë kod për të lidhur me Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Tani do të shkruajmë një funksion për të shtuar një rresht në tabelë.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Letërsia":
            row.author = tags[2]

        elif tags[0] == "Jo Letërsia":
            row.tags = tags[2]

        elif tags[0] == "Libra Shkollor":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Çfarë po ndodh këtu. Ne marrim dhe shtojmë një rresht të ri në tabelë në rreshtin e parë. Më pas ndajmë rrugën tonë me " / " dhe marrim etiketat. Etiketat janë në planin "Letërsia", "Dizajn", kush është autori dhe kështu me radhë. Pastaj caktojmë të gjitha fushat e nevojshme të tabelës.
Pjesa 3. Numërojmë fjalët, orët dhe funksione të tjera të bukura
Kjo është një detyrë më e ndërlikuar. Siç e dimë, kemi dy formate: epub dhe pdf. Nëse me epub është e qartë — aty me siguri ka fjalë, për pdf nuk është aq e qartë: ai mund të përbëhet thjesht nga imazhe të bashkuara.
Prandaj, funksioni për numërimin e fjalëve në pdf do të duket kështu: ne marrim numrin e faqeve dhe e shumëzojmë me një konstantë të caktuar (numri mesatar i fjalëve për faqe).
Ja ai:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Ky është WORDS_PER_PAGE për një faqe A4 i barabartë me rreth 300.
Tani le të shkruajmë një funksion për numërimin e faqeve. Do të përdorim .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Më pas, le të shkruajmë një gjë për numërimin e faqeve në epub. Do të përdorim . Këtu ne marrim librin, e konvertojmë në rreshta dhe për çdo rresht numërojmë fjalët.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Tani do të bëjmë numërimin e kohës. Marrim numrin tonë të preferuar të fjalëve dhe e ndajmë me shpejtësinë tuaj të leximit.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Pjesa 4. Bashkojmë të gjitha pjesët
Na nevojitet të kalojmë të gjitha rrugët e mundshme në dosjen tonë me libra. Të kontrollojmë nëse libri tashmë është në Notion: nëse po — nuk është e nevojshme të krijojmë një rresht.
Më pas na duhet të përcaktojmë tipin e skedarit, në përputhje me të, të numërojmë fjalët. Në fund të shtojmë librin.
Ja ky është kodi që kemi:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Dhe funksioni për të kontrolluar nëse libri është shtuar, duket kështu:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Përfundim
Faleminderit të gjithëve që e lexuat këtë artikull. Shpresoj se do t'ju ndihmojë të lexoni më shumë 🙂
Burimi: habr.com
